Klantenservice-dashboards voor supportmanagers: sjablonen en KPI's
Supportmanagers hebben vaak zes dashboardweergaven nodig: een live operationeel wallboard, een wachtrijweergave voor managers, scorecards voor gebruikers, een CSAT-trenddashboard, een SLA-gezondheidsmonitor en een risicoweergave voor executives. Een praktische implementatie gebruikt twee lagen: een operationele weergave voor gebruikers en teamleiders, plus rolspecifieke drill-downs voor managers en executives.
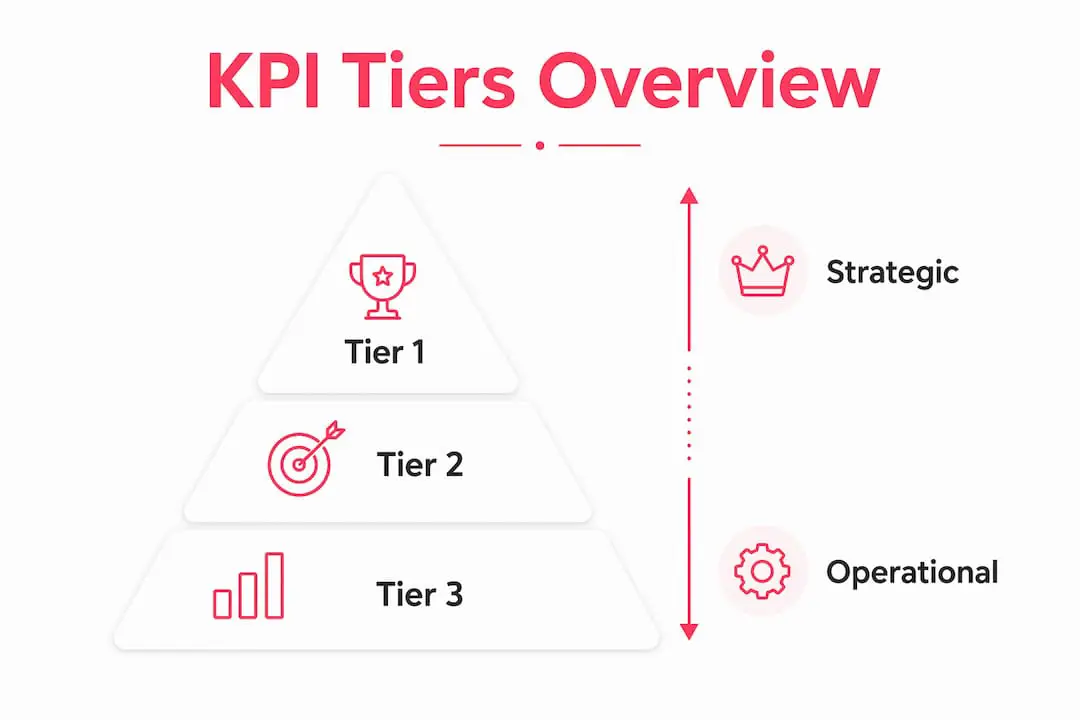
Tier 1-KPI's om te overwegen: First Response Time (FRT), First Contact Resolution (FCR), Customer Satisfaction Score (CSAT), Average Handle Time (AHT) en het SLA-nalevingspercentage.
Tier 2 (operationele gezondheid): omvang van de backlog, escalatiepercentage, tickets per gebruiker.
Tier 3 (impact op het bedrijf): kosten per oplossing, door support beïnvloede omzet, signalen voor churnrisico op basis van ticketpatronen.
Een verstandige route naar productie is om je helpdesk te koppelen, rolspecifieke weergaven te maken, drempelwaarden in te stellen en elke weergave te publiceren op de plek waar het betreffende publiek deze daadwerkelijk zal gebruiken.
De zes onderstaande sjablonen:
- Live operationeel wallboard
- Wachtrij- en werklastweergave voor managers
- Scorecards voor gebruikers
- CSAT- en kwaliteitsdashboard
- SLA- en ticketmonitor voor oude tickets
- Strategisch en productgericht dashboard
Pro-tip: Bouw ze niet alle zes tegelijk. Begin met het wallboard en één managerweergave. Zorg dat die goed werken voordat je de rest toevoegt.
Inhoudsopgave
- Welke typen supportdashboards bestaan er en wanneer gebruik je elk type?
- Welke KPI's horen op je supportdashboards?
- Zes direct bruikbare dashboardsjablonen voor supportteams
- Hoe stel je doelen, drempelwaarden en meldingen in die gedrag daadwerkelijk veranderen?
- Best practices voor ontwerp en data voor nauwkeurige dashboards
- Hoe lang duurt het om supportdashboards te implementeren?
- Hoe Deskhero operationele en rapportageweergaven ondersteunt
- Veelvoorkomende valkuilen in dashboardontwerp die tot verkeerde conclusies leiden
- Belangrijkste conclusies
- Wat ik als supportmanager als eerste zou bouwen
- Begin met de ingebouwde rapportage van Deskhero
- Nuttige bronnen
- Veelgestelde vragen
Welke typen supportdashboards bestaan er en wanneer gebruik je elk type?
Realtime gedeelde wallboards maken operationele statistieken zichtbaar voor het hele team. Maar niet elk dashboard hoeft elke seconde te vernieuwen en niet elk publiek heeft dezelfde weergave nodig.
De vier belangrijkste typen worden ingedeeld op basis van beslissingssnelheid en publiek:
- Operationeel wallboard: Live wachtrijdiepte, actieve tickets, online gebruikers, afteltimers voor SLA's. Bedoeld voor gebruikers en teamleiders die binnen enkele minuten moeten reageren. Vernieuwing: realtime.
- Wachtrij- en personeelsweergave voor managers: Open tickets op leeftijd en prioriteit, beschikbaarheid van gebruikers, percentage SLA-risico, heatmaps van de backlog. Vernieuwing: realtime tot elk uur.
- Persoonlijke scorecard voor gebruikers: Dagelijks gesloten tickets, persoonlijke CSAT, AHT, positie op het klassement. Vernieuwing: realtime of momentopname aan het einde van de dienst.
- Risicodashboard voor executives: SLA-trend, CSAT-trend, escalatiepercentage, churnrisico-indicatoren, kosten per oplossing. Vernieuwing: dagelijks tot wekelijks.
Twee aanvullende typen dienen specifieke functies. Een CSAT- en kwaliteitsdashboard houdt responspercentages van enquêtes, trendlijnen en steekproeven van letterlijke reacties bij. Een SLA- en dashboard voor oude tickets voorspelt overschrijdingen voordat ze plaatsvinden.
| Type dashboard | Primair publiek | Ondersteunde beslissing | Vernieuwingsfrequentie |
|---|---|---|---|
| Live operationeel wallboard | Gebruikers, teamleiders | Nu reageren op pieken in de wachtrij | Realtime |
| Wachtrijweergave voor managers | Supportmanagers | Werklast herverdelen, SLA-risico markeren | Realtime tot elk uur |
| Scorecard voor gebruikers | Individuele gebruikers | Gedrag zelf bijsturen, doelen volgen | Realtime of einde van de dienst |
| CSAT en kwaliteit | QA, managers | Coachingdoelen identificeren | Dagelijks |
| SLA en oude tickets | Managers, operations | Overschrijdingen voorkomen, vroeg escaleren | Realtime tot elk uur |
| Risicoweergave voor executives | Directeuren, VP's | Risico's op bedrijfsniveau signaleren | Dagelijks tot wekelijks |
Het koppelen aan gebruikssituaties is hierbij belangrijk. Een callcenter kan het wallboard en de SLA-monitor de hele dag op een tv laten staan. Een SaaS-helpdesk kan zich richten op CSAT-trends en terugkerende problemen. Een e-commerceteam kan tijdens het hoogseizoen meer tijd besteden aan de wachtrijweergave voor managers. Externe en hybride teams kunnen een operationele weergave in een gedeeld kanaal publiceren als hun rapportagestack dit ondersteunt.
Kies een vernieuwingsfrequentie die past bij de beslissing. Operationele weergaven hebben mogelijk live- of uurgegevens nodig, terwijl trend- en executiveweergaven dagelijks of wekelijks kunnen vernieuwen. Deze referentie voor supportstatistieken biedt aanvullende definities en context.
Pro-tip: Toon dashboards op plekken waar mensen al werken. Een dashboard dat niemand opent, is slechts een rapport.
Welke KPI's horen op je supportdashboards?
Een getrapt statistiekenframework kan tactische signalen waarop gebruikers dagelijks handelen scheiden van metingen die support verbinden met bredere bedrijfsresultaten. Zo kun je ze structureren.
| KPI | Formule / definitie | Tier | Wie ziet deze? |
|---|---|---|---|
| First Response Time (FRT) | Tijd vanaf het aanmaken van een ticket tot het eerste antwoord van een gebruiker | 1 | Gebruikers, managers, executives |
| First Contact Resolution (FCR) | Tickets opgelost bij het eerste contact ÷ totaal aantal tickets | 1 | Managers, executives |
| CSAT | Som van positieve beoordelingen ÷ totaal aantal enquêteantwoorden | 1 | Alle rollen |
| Average Handle Time (AHT) | Totale behandeltijd ÷ aantal behandelde tickets | 1 | Gebruikers, managers |
| SLA-nalevingspercentage | Binnen de SLA opgeloste tickets ÷ totaal aantal tickets | 1 | Managers, executives |
| Backlog / oude tickets | Open tickets die ouder zijn dan X dagen | 2 | Managers |
| Escalatiepercentage | Geëscaleerde tickets ÷ totaal aantal tickets | 2 | Managers |
| Tickets per gebruiker | Totaal aantal tickets ÷ actieve gebruikers | 2 | Managers |
| Kosten per oplossing | Totale supportkosten ÷ opgeloste tickets | 3 | Executives |
| Door support beïnvloede omzet | Omzet uit accounts met opgeloste tickets in de periode | 3 | Executives, CS-leiders |
| Churnrisicosignaal | Accounts met veel tickets + lage CSAT + geen oplossing | 3 | CS-leiders, executives |
Belangrijke klantenservicestatistieken zoals CSAT, Customer Effort Score (CES) en Net Promoter Score (NPS) worden breed bijgehouden, maar dienen verschillende doelen. CSAT meet tevredenheid over een specifieke interactie. CES meet hoe eenvoudig de interactie was. NPS meet algemene loyaliteit. Voor de meeste supportdashboards horen CSAT en CES op de operationele laag; NPS past beter in de executiveweergave.
Enkele opmerkingen over benchmarks: branchegemiddelden voor CSAT verschillen aanzienlijk per sector en tickettype. Jaag in plaats van een universeel getal na te streven je basislijn in de eerste 30 dagen vast en meet vanaf daar de verbetering. Ook FCR-benchmarks hangen af van de complexiteit van je product en je kanaalmix.
Het combineren van ticketgegevens met CRM- en facturatiegegevens verplaatst support van operationele rapportage naar bedrijfsimpact. Wanneer je kunt zien dat een account met veel tickets en dalende CSAT volgende maand ook moet worden verlengd, is dat een Tier 3-signaal dat escalatie verdient.
Gebruikers hebben mogelijk een gerichte subset van Tier 1-statistieken nodig. Managers hebben meestal Tier 1 en Tier 2 nodig. Executives hebben doorgaans trends en signalen met bedrijfsimpact nodig in plaats van ruwe aantallen tickets.
Zes direct bruikbare dashboardsjablonen voor supportteams
Deze blauwdrukken zijn ontworpen om rechtstreeks naar je helpdesk of BI-tool te kopiëren. Elk sjabloon is gekoppeld aan een specifiek publiek, een specifieke beslissing en een specifieke gegevensbron.
| Sjabloon | Primair publiek | Onmisbare statistieken | Gebruikelijke visualisaties | Vernieuwing | Verwachte actie |
|---|---|---|---|---|---|
| Live operationeel wallboard | Gebruikers, teamleiders | Wachtrijdiepte, FRT, SLA-aftelling, online gebruikers | Meterweergaven, wachtrijbalken, waarschuwingsbanners | Realtime | Reageren op pieken, tickets herverdelen |
| Wachtrijweergave voor managers | Supportmanagers | Open tickets op leeftijd/prioriteit, SLA-risico in %, beschikbaarheid van gebruikers | Heatmaps, gestapelde balken | Realtime tot elk uur | Werklast herverdelen, escaleren |
| Scorecards voor gebruikers | Individuele gebruikers | Dagelijks gesloten tickets, CSAT, AHT, positie op het klassement | Voortgangsbalken, microtrends | Realtime of einde van de dienst | Zelf bijsturen, dagelijkse doelen halen |
| CSAT en kwaliteit | QA, managers | CSAT-trend, responspercentage, letterlijke reacties, kwaliteitsscore | Trendlijnen, verdelingsgrafieken | Dagelijks | Coachingdoelen identificeren |
| SLA en oude tickets | Managers, operations | Voorspelling van SLA-overschrijdingen, leeftijdsverdeling, escalatiepercentage | Gestapelde balken, drempelmarkeringen | Realtime tot elk uur | Overschrijdingen voorkomen, vroeg escaleren |
| Strategisch / productgericht | Directeuren, CS-leiders | Probleemclusters, churnrisico-indicatoren, door support beïnvloede omzet | Trendlijnen, cohorttabellen | Dagelijks tot wekelijks | Productverbeteringen prioriteren, verlengingsrisico markeren |
Sjabloon 1: Live operationeel wallboard. Het wallboard is de hartslag van je supportvloer. Toon de wachtrijdiepte per kanaal, FRT voor de afgelopen 60 minuten, een aftelling voor tickets die een SLA-overschrijding naderen en een live aantal online gebruikers. Gebruik grote meterweergaven voor de wachtrijdiepte en kleurgecodeerde waarschuwingsbanners wanneer drempelwaarden worden overschreden. Wallboards voor kantoortv's kunnen snel worden ingesteld en geven het hele team gedeeld situationeel inzicht zonder dat iemand een rapport hoeft te openen.
Sjabloon 2: Wachtrij- en werklastweergave voor managers. Dit is het dashboard dat je vóór een stand-up controleert. Open tickets gesorteerd op leeftijd en prioriteit, beschikbaarheid van gebruikers (beschikbaar versus bezet versus offline), het percentage tickets met SLA-risico en een heatmap die de concentratie van de backlog per segment of productgebied toont. Voor het meeste hiervan is elk uur vernieuwen prima, maar het SLA-risico moet realtime worden bijgewerkt.
Sjabloon 3: Scorecards voor gebruikers. Elke gebruiker ziet zijn of haar eigen cijfers: vandaag gesloten tickets versus het dagelijkse doel, persoonlijke CSAT-score, AHT en positie op het teamklassement. Voortgangsbalken werken hier goed. Een microtrendlijn die CSAT over de afgelopen 7 dagen toont, geeft gebruikers context zonder hen te overladen. Vernieuw aan het einde van de dienst voor een overzichtelijke dagelijkse momentopname, of realtime als je team competitief is over de positie op het klassement.
Sjabloon 4: CSAT- en kwaliteitsdashboard. CSAT-dashboards kunnen responspercentages van enquêtes, trendlijnen en geselecteerde opmerkingen combineren. Toon de CSAT-trend over 30 en 90 dagen, het responspercentage, een steekproef van recente opmerkingen en een uitsplitsing van de kwaliteitsscore per gebruiker of team. Voeg segmentfilters toe voor kanaal, productgebied of klantniveau.
Sjabloon 5: SLA- en ticketmonitor voor oude tickets. Het doel hier is om overschrijdingen te signaleren voordat ze plaatsvinden. Toon een voorspelling van overschrijdingen (tickets die waarschijnlijk binnen de komende 2 uur de SLA overschrijden), een grafiek met de leeftijdsverdeling van open tickets en het escalatiepercentage in de loop van de tijd. Gebruik drempelmarkeringen op staafdiagrammen, zodat het risiconiveau visueel duidelijk is. Realtime SLA-monitoring met drill-downs voor oorzaakanalyse is een standaardfunctie van volwassen dashboards voor contactcenters.
Sjabloon 6: Strategisch en productgericht dashboard. Deze weergave verbindt support met het bedrijf. Toon terugkerende ticketonderwerpen en, waar je gegevens dit ondersteunen, account-risico-indicatoren, door support beïnvloede omzet en funnelimpact. Het combineren van retentiegerichte signalen met accountgegevens kan CS-leiders helpen risico's te onderzoeken vóór een gesprek over verlenging.
Hoe stel je doelen, drempelwaarden en meldingen in die gedrag daadwerkelijk veranderen?
Een dashboard zonder drempelwaarden is slechts een scorebord. Drempelwaarden veranderen statistieken in triggers.
Framework voor het stellen van doelen:
- Stel je basislijn vast (de eerste 30 dagen met schone data).
- Stel vanaf de basislijn een bescheiden, meetbaar verbeteringsdoel vast.
- Definieer operationele drempelwaarden die gekoppeld zijn aan resultaten die je eigen data kan ondersteunen.
Voorbeelden van startdrempelwaarden:
- FRT voor tickets met prioriteit 1: waarschuwen na 30 minuten, escaleren na 60 minuten.
- Percentage SLA-risico: geel bij 15%, rood bij 25%.
- Trigger voor een CSAT-daling: waarschuwen wanneer het voortschrijdende CSAT-gemiddelde over 7 dagen meer dan 5 punten onder het gemiddelde over 30 dagen daalt.
- Groei van de backlog: waarschuwen wanneer het aantal open tickets in één uur met meer dan 20% toeneemt.
Regels voor het routeren van meldingen:
- Elke melding moet context bevatten: het aantal getroffen klanten, 2 tot 3 links naar voorbeeldtickets en het gerelateerde productgebied.
- Stuur meldingen met prioriteit 1 naar zowel de verantwoordelijke lead als het gedeelde meldingskanaal van het team.
- Beperk niet-kritieke meldingen tot één notificatie per 30 minuten om meldingsmoeheid te voorkomen.
- Bundel meldingen met een lage ernst in een dagelijks overzicht.
Coachingsworkflow wanneer een melding wordt geactiveerd:
- Triage: Haal de voorbeeldtickets erbij. Is dit een volumepiek, een kennislacune of een procesfout?
- Voorbeeldbeoordeling: Lees 3 tot 5 tickets van de gemarkeerde gebruiker of wachtrij. Zoek naar patronen.
- Coachen en documenteren: Voer een gesprek van 10 minuten. Spreek één specifieke verandering af. Leg deze vast.
- Opvolgen en afronden: Controleer de statistiek na 48 uur opnieuw. Heeft de verandering standgehouden?
Een kort managerscript voor stap 3: “Ik zag dat je AHT voor facturatietickets deze week met 40% is gestegen. Ik heb drie voorbeelden bekeken en het lijkt erop dat het terugbetalingsproces onduidelijk is. Laten we het samen doornemen en het kennisbankartikel bijwerken.”
Pro-tip: Stel meldingen vóór escalatie vroeg genoeg in, zodat het team kan handelen voordat een SLA wordt overschreden. Test wijzigingen in drempelwaarden eerst als kleine, tijdgebonden experimenten voordat je ze permanent maakt.
Best practices voor ontwerp en data voor nauwkeurige dashboards
Slechte data erin betekent slechte beslissingen eruit. Deze regels voorkomen de meest voorkomende dashboardproblemen.
Checklist voor gegevensbronnen:
- Wijs per statistiek één gezaghebbende bron aan. Als FRT in je helpdesk wordt berekend, mag deze nooit opnieuw in een spreadsheet worden berekend.
- Normaliseer voor teams met meerdere kanalen de tijdstempels van tickets naar één tijdzone voordat je gegevens samenvoegt.
- Aanbevolen koppelingen voor Tier 3-statistieken omvatten ticketgegevens, CRM-accountgegevens, facturatiestatus en relevante productgebeurtenissen.
- Maak ontbrekende gegevens expliciet zichtbaar. Een lege cel is minder gevaarlijk dan een nul die echt lijkt.
Naamgeving en definities:
- Schrijf voor elke statistiek op je dashboard een definitie van één regel. Bewaar deze in een gedeeld statistiekenwoordenboek (een Notion-pagina of wiki-artikel werkt prima).
- Voorzie je definities van versies. Noteer de datum wanneer je de berekening van FCR wijzigt, zodat historische vergelijkingen geldig blijven.
Regels voor visualisatie:
- Gebruik meterweergaven voor statistieken met één waarde en een duidelijk doel (wachtrijdiepte, SLA-naleving).
- Gebruik trendlijnen voor alles wat je in de loop van de tijd wilt zien (CSAT, FRT, ticketvolume).
- Gebruik klassementen voor vergelijkingen op gebruikersniveau, maar alleen wanneer de steekproef groot genoeg is om betekenisvol te zijn.
- Gebruik heatmaps voor de concentratie van de backlog per segment, tijdstip van de dag of productgebied.
- Gebruik nooit gestapelde procentuele balken zonder daarnaast absolute waarden te tonen.
| Gegevensbron | Gezaghebbende statistiek | Aanbevolen vernieuwing |
|---|---|---|
| Helpdesk-/ticketsysteem | FRT, AHT, FCR, ticketvolume, SLA-naleving | Realtime |
| CSAT-enquêtetool | CSAT-score, responspercentage, letterlijke opmerkingen | Dagelijks |
| CRM | Accountniveau, verlengingsdatum, contractwaarde | Dagelijks |
| Facturatiesysteem | MRR, betalingsstatus | Dagelijks |
| Productanalytics | Functiegebruik, frequentie van inloggen | Dagelijks tot wekelijks |
Governance:
- Wijs per weergave één dashboardeigenaar aan. Deze persoon is verantwoordelijk voor nauwkeurigheidscontroles en het bijwerken van definities.
- Voer maandelijks een nauwkeurigheidscontrole uit: selecteer 10 willekeurige tickets en controleer of de dashboardcijfers overeenkomen met de ruwe data.
- Beperk toegang op basis van rollen. Gebruikers zien hun eigen scorecard. Managers zien gegevens op teamniveau. Executives zien geaggregeerde trends.
Pro-tip: Bereken na livegang handmatig één week FRT op basis van onbewerkte ticketexports en vergelijk dit met het dashboard. Onderzoek elke materiële afwijking, inclusief tijdzone-, filter- en instellingen voor kantooruren.
Hoe lang duurt het om supportdashboards te implementeren?
De implementatietijd hangt af van de teamgrootte, datakwaliteit, het aantal bronnen en de vraag of je native rapportage of een BI-tool gebruikt. Beschouw de onderstaande bandbreedtes als planningsramingen, niet als garanties.
| Fase | Klein team (1 tot 10 gebruikers) | Middelgroot team (11 tot 49 gebruikers) | Volwassen team (50+ gebruikers) |
|---|---|---|---|
| Verkenning en datamapping | 1 tot 2 dagen | 3 tot 5 dagen | 1 tot 2 weken |
| Dashboardbouw | 2 tot 3 dagen | 1 tot 2 weken | 2 tot 4 weken |
| QA en pilot | 1 tot 2 dagen | 3 tot 5 dagen | 1 tot 2 weken |
| Uitrol en training | 1 dag | 2 tot 3 dagen | 1 week |
| Totaal | ~1 week | 2 tot 4 weken | 5 weken of meer |
Benodigde rollen:
- Supportmanager: definieert vereisten, valideert statistieken en is eigenaar van de uitrol.
- Data-engineer of BI-analist: bouwt koppelingen en stelt vernieuwingsprocessen in.
- QA-lead: valideert de nauwkeurigheid vóór livegang.
- Changemanager (grotere teams): verzorgt training en adoptie.
Kostenfactoren: De grootste variabele is de benodigde data-engineering. Als je helpdesk vooraf gebouwde koppelingen met je BI-tool heeft, kun je het meeste werk aan de datapijplijn overslaan. Doe-het-zelfoplossingen met native helpdeskritage kosten het minst, maar bieden ook de minste flexibiliteit. Ingebouwde dashboards van leveranciers (die in je helpdeskplatform zijn geïntegreerd) zijn de snelste route naar productie. Licenties voor zelfstandige BI-tools kunnen voor grotere teams snel oplopen.
Checklist voor de uitrol:
- Koppel je helpdeskgegevensbron en controleer de toewijzing van ticketvelden.
- Bouw eerst het live wallboard en publiceer dit op een toegankelijke gedeelde locatie.
- Voeg de wachtrijweergave voor managers toe. Valideer de berekeningen voor SLA-risico.
- Voer twee weken een pilot uit met één team voordat je uitrolt naar alle teams.
- Voer de nauwkeurigheidscontrole uit (zie de bovenstaande governance-sectie).
- Train gebruikers in hun scorecards tijdens een sessie van 15 minuten.
- Plan een evaluatie na 30 dagen om drempelwaarden en filters aan te passen.
Een klein team dat native helpdeskritage gebruikt, kan mogelijk binnen ongeveer een week een wallboard en managerweergave lanceren. Schone ticketvelden en consistente definities vormen de basis voor alles wat volgt.
Hoe Deskhero operationele en rapportageweergaven ondersteunt
Deskhero bevat een operationeel Dashboard, een configureerbare ticketlijst, vaste Statistics-weergaven, SLA-rapportage en een API. Het reproduceert niet elk hierboven beschreven aangepast BI-dashboard, maar dekt veel gebruikelijke rapportagebehoeften van helpdesks zonder een afzonderlijke BI-tool.
Koppeling tussen functies en sjablonen:
- Operational Dashboard: Statusuitsplitsingen, actieve tickets, tickets die wachten op een eerste antwoord, trends in ticketvolume, gemiddelde tijd tot eerste antwoord en gemiddelde oplostijd verschijnen in één live bijgewerkte weergave met een groepsfilter.
- Wachtrijweergave voor managers: De ticketlijst ondersteunt kolommen en filters voor status, prioriteit, groep, toegewezen medewerker, tag, SLA en aangepaste velden. Elke gebruiker kan de eigen kolommen en filters kiezen en ordenen.
- Teamrapportage: De sectie Statistics bevat tabellen per groep en per gebruiker. Het gebruikersklassement maakt bovendien onderscheid tussen werk dat door Deskhero AI is afgehandeld via automatische antwoorden en de chatbot.
- SLA-monitoring: Configureerbare beleidsregels stellen doelen voor eerste antwoorden en oplossingen in. De SLA-weergaven in Dashboard en Statistics tonen het huidige risico en historische prestaties, terwijl meldingen voor risico en overschrijdingen gebruikmaken van meldingen in de app en per e-mail.
- Trend- en onderwerpweergaven: Vaste tabbladen in Statistics behandelen trends, responstijden, kanalen, AI en automatisering en terugkerende onderwerpen. Het Topics-cluster heeft ongeveer 100 tickets nodig en wordt op betaalde abonnementen ongeveer wekelijks opnieuw opgebouwd.
- Externe analyse: De REST API van Deskhero kan ticketgegevens leveren aan een rapportageproces dat deze combineert met CRM- of facturatiegegevens. De API werkt op basis van polling en heeft geen uitgaande webhooks.
Implementatiechecklist voor Deskhero:
- Koppel je Gmail- of Microsoft 365-mailbox (geen migratie, geen nieuw e-mailadres).
- Koppel mailboxen aan groepen en configureer de automatiseringen voor nieuwe tickets die je nodig hebt.
- Voeg gebruikers toe, wijs rollen toe en configureer kolommen en filters voor de ticketlijst.
- Definieer SLA-beleidsregels, inclusief kantooruren en statussen die de oplostijdklok pauzeren.
- Kies de voorkeuren voor meldingen in de app en per e-mail voor elke groep.
- Bekijk eerst het Dashboard en gebruik daarna de vaste Statistics-tabbladen voor diepgaandere analyse en exports.
De conceptvoorstellen van Deskhero kunnen alle kennis uit de werkruimte gebruiken, waaronder beantwoorde tickets, interne kennis, goedgekeurde openbare FAQ-items en gescrapete webpagina's. De klantgerichte chatbot en automatische antwoorden gebruiken uitsluitend de goedgekeurde openbare FAQ. De chatbot kan worden ingeschakeld zodra de werkruimte ten minste 100 goedgekeurde FAQ-items bevat.
Deskhero biedt een gratis proefperiode van 30 dagen waarvoor geen creditcard nodig is. De productinterface ondersteunt 14 talen en gebruikers kunnen tickets en conceptantwoorden binnen de helpdesk vertalen.
Pro-tip: Koppel tijdens de proefperiode een mailbox, configureer de wachtrij en SLA-beleidsregels en gebruik daarna de gegevens uit Dashboard en Statistics om een basislijn vast te stellen voordat je doelen instelt.
Veelvoorkomende valkuilen in dashboardontwerp die tot verkeerde conclusies leiden
De duurste dashboardfout is geen slechte visualisatie. Het is het op de verkeerde manier meten van het juiste.
Publieken mengen op één scherm is de meest voorkomende structurele fout. Wanneer gebruikers en executives hetzelfde dashboard delen, krijg je een weergave die voor gebruikers te druk en voor executives te gedetailleerd is. Geen van beide groepen handelt ernaar.
Te veel nadruk op ruwe ticketvolumes kan drukke teams effectief en efficiënte teams traag laten lijken. Een hoog aantal gesloten tickets met zwakke FCR kan minder gezond zijn dan een lager volume met een betere oplossingskwaliteit. Combineer volumestatistieken met kwaliteitsstatistieken.
De steekproefgrootte van enquêtes voor CSAT negeren leidt tot extreem instabiele scores. Een CSAT van 95% op basis van vier antwoorden is geen signaal. Stel een minimale responsdrempel in voordat je een CSAT-score toont en vermeld altijd het aantal antwoorden naast de score.
Verouderde vernieuwingsintervallen veranderen realtime dashboards in historische rapporten. Als je wallboard elke 15 minuten vernieuwt, is het geen wallboard. Controleer je vernieuwingsinstellingen na livegang.
Valse alarmmeldingen ontstaan wanneer drempelwaarden te krap zijn ingesteld. Te veel meldingen met weinig waarde zorgen ervoor dat mensen ze negeren. Begin met conservatieve drempelwaarden en maak ze pas strenger nadat je hebt bevestigd dat het signaal nuttig is.
Afgeknotte Y-assen op trendlijnen laten kleine veranderingen dramatisch lijken. Een CSAT-daling van 94% naar 92% ziet er catastrofaal uit op een grafiek die bij 90% begint. Laat procentuele assen altijd bij 0 beginnen, tenzij je de schaal expliciet labelt.
Nog één punt: rapporteer nooit een statistiek die je niet kunt uitleggen aan de gebruiker op wie deze betrekking heeft. Als een gebruiker vraagt: “Hoe wordt mijn AHT berekend?” en je kunt niet in één zin antwoorden, is de statistiek nog niet klaar voor een scorecard.
Belangrijkste conclusies
Het framework met zes dashboards werkt omdat het realtime operationele signalen scheidt van strategische weergaven met bedrijfsimpact, zodat elk publiek precies krijgt wat het nodig heeft om te handelen.
| Punt | Details |
|---|---|
| Begin met twee dashboards | Bouw eerst het live wallboard en de wachtrijweergave voor managers; voeg andere weergaven toe zodra de basislijn stabiel is. |
| Deel je KPI's in niveaus in | Kies voor elk publiek een gerichte set Tier 1-statistieken; voor Tier 3-statistieken zijn vaak koppelingen met CRM en facturatie nodig. |
| Meldingen hebben context nodig | Elke melding op basis van een drempelwaarde moet het aantal getroffen klanten, links naar voorbeeldtickets en het gerelateerde productgebied bevatten. |
| Governance voorkomt afwijkingen | Wijs per weergave één dashboardeigenaar aan en voer maandelijks een nauwkeurigheidscontrole uit tegen de onbewerkte ticketgegevens. |
| Rapportage in Deskhero | Deskhero combineert een operationeel Dashboard, vaste Statistics-tabbladen, SLA-weergaven, configureerbare ticketfilters, Excel-exports en een REST API op basis van polling. |
Wat ik als supportmanager als eerste zou bouwen
De verleiding is groot om alles tegelijk te bouwen. Doe dat niet.
Als ik helemaal opnieuw zou beginnen, zou ik eerst een live wallboard en een wachtrijweergave voor managers bouwen. Die twee weergaven beantwoorden de dringendste vragen: groeit de wachtrij sneller dan we aankunnen? Staan we op het punt een SLA te overschrijden?
De eerste 30 dagen draaien om het meten van de basislijn. Stel nog geen doelen in. Kijk alleen. Je zult patronen zien die je niet had verwacht: elke dinsdagmiddag een piek, een productgebied dat een groot deel van de escalaties veroorzaakt, één gebruiker wiens AHT voor een specifiek tickettype drie keer zo hoog is als het teamgemiddelde.
Stel Tier 1-drempelwaarden in op basis van je waarnemingen. Voeg de scorecards voor gebruikers toe. Voer je eerste coachingscyclus uit met behulp van het vierstappenplan uit het bovenstaande gedeelte over meldingen.
Zodra de basislijn stabiel is, voeg je het CSAT-dashboard en de SLA-monitor toe. Gebruik voldoende gegevens om een aanhoudend patroon te onderscheiden van een kortstondige schommeling.
Als de CSAT van een gebruiker bijvoorbeeld daalt, bekijk dan een kleine steekproef van tickets voordat je gaat coachen. Als uit meerdere tickets blijkt dat gesprekken zijn gesloten voordat de klant een oplossing bevestigde, spreek dan een specifieke proceswijziging af en controleer de statistiek opnieuw na een vastgestelde periode.
Dat is het hele doel van een dashboard. Niet de grafiek, maar het gesprek dat de grafiek mogelijk maakt.
Begin met de ingebouwde rapportage van Deskhero
Deskhero zet Gmail-, Google Workspace- en Microsoft 365-mailboxen om in tickets in een gedeelde inbox. Dankzij de ingebouwde secties Dashboard en Statistics kunnen teams operationeel werk en langetermijntrends monitoren zonder eerst een aangepaste rapportagestack te bouwen.
Het Dashboard toont statusuitsplitsingen, werk dat op een eerste antwoord wacht, trends in ticketvolume en respons- en oplostijden. Statistics voegt vaste weergaven toe voor trends, responstijden, SLA-prestaties, teamactiviteit, kanalen, AI en automatisering en terugkerende onderwerpen. SLA-risico kan meldingen in de app en per e-mail genereren. Voor externe analyse biedt het Deskhero-helpdeskplatform ook een REST API die rapportagetools via polling kunnen opvragen.
Begin zonder creditcard met een gratis proefperiode van 30 dagen. Je kunt je bestaande e-mailadres behouden.
Nuttige bronnen
- Customer Support Metrics That Drive Real Impact, SigOS.
- Live customer service dashboards for your whole support team, Geckoboard.
- Customer Support Dashboard for the Office TV, BoardQ.
- 20 Essential Customer Support Metrics to Track, Fullview.
- AI-Powered CSAT Dashboard, Merren.
- Customer Service Metrics: Top 10 to Measure, Qualtrics.
- How to reduce churn in self-service SaaS, Customerscore.io.
Veelgestelde vragen
Wat is een klantenservice-dashboard?
Een klantenservice-dashboard is een realtime of geplande weergave van belangrijke supportstatistieken, zoals wachtrijdiepte, FRT, CSAT en SLA-naleving, waarmee managers en gebruikers prestaties kunnen monitoren en snel op signalen kunnen handelen.
Wat zijn de vier kernstatistieken van klantenservice?
De vier meest bijgehouden klantenservicestatistieken zijn CSAT (klanttevredenheid), FCR (oplossing bij het eerste contact), FRT (tijd tot eerste antwoord) en AHT (gemiddelde behandeltijd). Deze vormen de Tier 1-basis van elk supportdashboard.
Wat is een CSAT-dashboard?
Een CSAT-dashboard volgt de resultaten van klanttevredenheidsenquêtes in de loop van de tijd en toont scoretrends, responspercentages en klantopmerkingen. Dagelijkse vernieuwing kan managers helpen coachingdoelen en kwaliteitsproblemen te identificeren.
Wat zijn de belangrijkste typen supportdashboards?
De belangrijkste typen zijn het live operationele wallboard, de wachtrijweergave voor managers, scorecards voor gebruikers, het CSAT- en kwaliteitsdashboard, de SLA- en ticketmonitor voor oude tickets en het strategische of executive-risicodashboard. Elk type dient een ander publiek en een ander beslissingstempo.
Hoe analyseer je supportgegevens effectief?
Begin met het indelen van je statistieken: Tier 1 voor dagelijkse operationele beslissingen, Tier 2 voor de gezondheid van de werklast en Tier 3 voor signalen met bedrijfsimpact. Combineer ticketgegevens met CRM- en facturatiegegevens om verder te gaan dan ruwe volumes en supportprestaties te verbinden met resultaten op het gebied van retentie en omzet.