AI med mennesket i loopen: Slik fungerer det og når det bør brukes
KI med mennesket i loopen (HITL) er et designmønster som plasserer menneskelig vurdering på bestemte punkter i opplærings-, beslutnings- eller gjennomføringsprosessen til et KI-system. Det er spesielt nyttig når en automatisert handling kan påvirke mennesker eller systemer, når feil er kostbare å reversere, eller når en organisasjon trenger tydelig menneskelig ansvarlighet.
Denne artikkelen forklarer hvordan HITL fungerer, hvor det er nyttig, og hva team må utforme før de tar det i bruk i produksjon.
Innholdsfortegnelse
- Hvordan fungerer egentlig KI med mennesket i loopen?
- Hvorfor HITL er viktig: Nøyaktighet, sikkerhet og tillit
- Hvor brukes HITL: Eksempler fra virkeligheten
- Hvordan utformer du et HITL-system for produksjon?
- HITL versus mennesket på loopen versus mennesket over loopen
- Hva er de reelle utfordringene ved å kjøre HITL i stor skala?
- En praktisk sjekkliste for implementering av HITL-systemer
- Hva sier aktuell forskning om HITLs fremtid?
- Viktigste punkter
- Det de fleste team misforstår om HITL
- Deskhero setter menneskelig kontroll i sentrum for KI-støtte
- Nyttige kilder
- Vanlige spørsmål
Hvordan fungerer egentlig KI med mennesket i loopen?
Loopen er en sekvens med kontrollpunkter der en person tilfører informasjon, vurderer et resultat eller godkjenner en handling. Systemet kan vente på dette innspillet, eller samle det inn for senere evaluering og forbedring av modellen.
Mennesker deltar vanligvis på to stadier:
HITL i opplæringsfasen omfatter merking av rådata, evaluering av modellresultater og innsamling av preferansesignaler. Forsterkende læring fra menneskelige tilbakemeldinger er et kjent eksempel. Mennesker rangerer eller vurderer modellens svar, og disse vurderingene brukes som signaler under opplæringen. Aktiv læring er et annet mønster: En modell identifiserer usikre eksempler slik at menneskelige merkere kan konsentrere seg om tilfellene som kan gi mest nyttig informasjon.
HITL under kjøring legger til vurdering mens et distribuert system er i drift. Et system kan settes på pause før en sensitiv handling, for eksempel å sende en melding eller endre en oppføring, og be en person om å godkjenne, redigere eller avvise den foreslåtte handlingen. LangChains HITL-dokumentasjon beskriver mellomvare som kan avbryte utvalgte verktøykall, bevare tilstanden og fortsette etter at en vurderer har bestemt hva som skal gjøres.
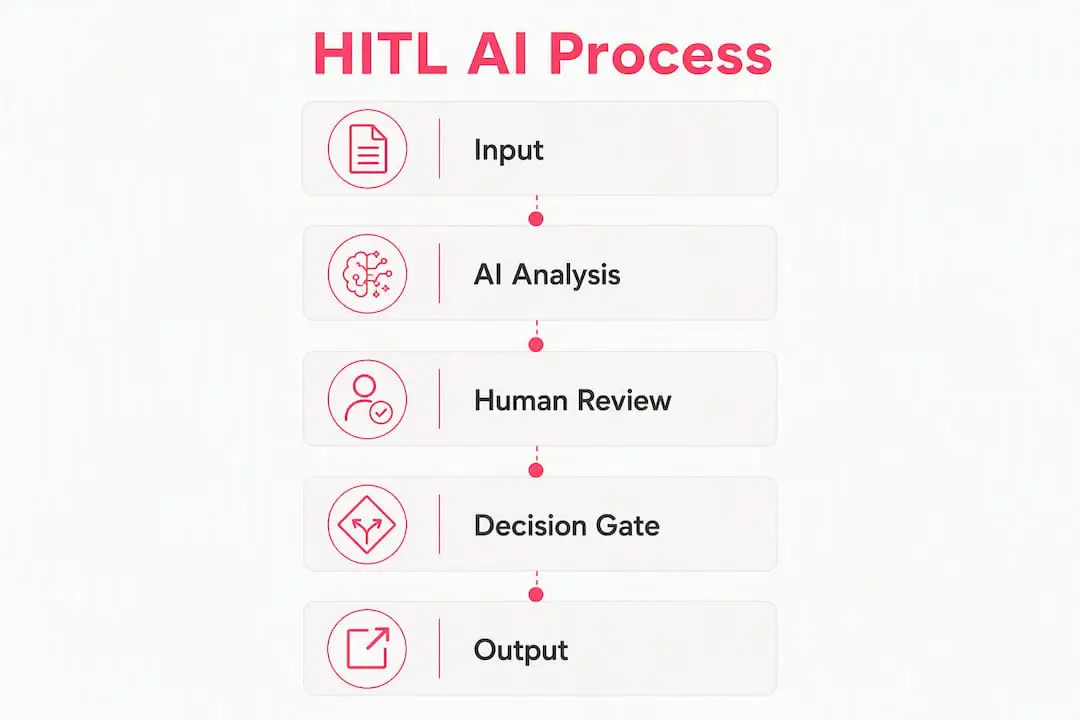
Et nyttig kontrollpunkt under kjøring viser vurdereren hva systemet planlegger å gjøre, gir strukturerte valg, registrerer beslutningen og fortsetter fra lagret tilstand.
En praktisk arbeidsflyt kan omfatte:
- Merk data eller modellresultater med menneskelige etiketter
- Tren eller evaluer en modell ved hjelp av disse vurderte eksemplene
- Distribuer modellen eller KI-arbeidsflyten
- Avbryt før utvalgte handlinger med høy risiko
- Avgjør om handlingen skal godkjennes, redigeres, avvises eller håndteres på annen måte
- Samle inn beslutningen som strukturert operativ tilbakemelding
Synkrone kontrollpunkter stopper den berørte arbeidsflyten til en vurderer handler. Asynkrone utforminger kan la urelatert arbeid fortsette mens beslutningen venter. Uansett trenger langvarige arbeidsflyter varig tilstandslagring. Dokumentasjonen for inference.sh-kjøremiljøet er ett eksempel på et system som beskriver godkjenningspunkter og vedvarende kjøring for dette formålet.
Godkjenningsregler kan være brede eller selektive. Et team kan kreve vurdering hver gang et sensitivt verktøy brukes, eller bare når et beløp, en mottaker, en konfidensskår eller en annen betingelse overskrider en terskel. Selektiv ruting kan redusere unødvendige vurderinger uten å fjerne kontrollen fra handlingene som trenger den.
Hvorfor HITL er viktig: Nøyaktighet, sikkerhet og tillit
Menneskelig kontroll kan forbedre en KI-arbeidsflyt på tre praktiske måter.
Bedre håndtering av særtilfeller. Modeller kan ha problemer med uvanlige inndata eller endrede forhold. En vurderer kan oppdage et unntak og korrigere det foreslåtte resultatet. Hvis korrigeringen samles inn og forvaltes på riktig måte, kan den senere støtte evaluering eller modellforbedring. Korrigeringen forbedrer ikke modellen automatisk; teamet trenger fortsatt en bevisst pipeline for tilbakemeldinger.
Sikrere handlinger. Et KI-system som kan sende meldinger, oppdatere oppføringer eller behandle transaksjoner, kan forårsake skade når det tolker inndata feil. Et kontrollpunkt for vurdering kan redusere denne risikoen ved å stoppe utvalgte handlinger før de skjer. Databricks diskuterer menneskelig vurdering for beslutninger med større konsekvenser og verdien av å føre tilbakemeldinger tilbake til systemet.
Større ansvarlighet. En godt instrumentert HITL-arbeidsflyt kan registrere hvem som vurderte en handling, hva de besluttet og hva som skjedde videre. Disse registreringene hjelper med gjennomgang av hendelser, kvalitetskontroll og etterlevelse. Et overfladisk godkjenningstrinn er ikke nok. Vurderingen må ha tilstrekkelig kontekst, tid og myndighet til å endre utfallet.
Menneskelige tilbakemeldinger er mest nyttige når de behandles som styrte operative data. Team bør definere hvordan beslutninger lagres, hvem som kan få tilgang til dem, hvor lenge de oppbevares, og om de skal brukes til evaluering, ny opplæring eller ingen av delene.
Hvor brukes HITL: Eksempler fra virkeligheten
Mønsteret brukes i mange bransjer, men vurdererens ansvar endres etter fagområdet.
Medisinsk bildebehandling. En kliniker kan vurdere et KI-merket bilde før resultatet brukes i diagnostisering eller behandling. Hvilken kontroll som er riktig, avhenger av enheten, den tiltenkte bruken og gjeldende kliniske og regulatoriske krav. KI-resultater bør ikke beskrives som en erstatning for kvalifisert medisinsk skjønn.
Innholdsmoderering. En klassifikator kan merke innhold som potensielt bryter regler, og sende usikre eller sensitive tilfeller til en menneskelig vurderer. Mennesker håndterer kontekst og klager, mens automatisering bidrar til å håndtere volumet. Konsistente retningslinjer og kalibrering av vurderere er viktig fordi vurderingsbeslutninger senere kan brukes som opplærings- eller evalueringsdata.
Kundestøtte. KI kan utarbeide et svar som en bruker kan vurdere. Systemer med tillatelse til å sende meldinger eller endre kontodata trenger ekstra kontroller rundt disse handlingene. Et team kan kreve godkjenning basert på handlingstypen, konsekvensene og hvor enkelt den kan reverseres. Du finner mer bakgrunn i Deskheros artikkel om KI i kundeservice.
Bedragerietterforskning. En modell kan gi transaksjoner en risikoskår og sende utvalgte saker til en analytiker. Analytikeren vurderer kontekst som kanskje ikke finnes i modellens inndata, og tar beslutningen som kreves av organisasjonens retningslinjer.
Datamerkingsprosesser. Menneskelige merkere eller fageksperter annoterer bilder, tekst eller lyd for veiledet opplæring og evaluering. Kvalitetskontroller, tydelige instruksjoner og mål på enighet er viktig fordi støyende etiketter kan redusere modellkvaliteten.
Profftips: Kartlegg handlingene et system kan utføre før du velger en vurderingspolicy. Konsentrer obligatorisk vurdering om handlinger som har stor påvirkning, er vanskelige å reversere eller omfattes av et spesifikt krav til ansvarlighet.
Hvordan utformer du et HITL-system for produksjon?
Et HITL-design for produksjon trenger mer enn en vurderingsknapp. Det må ta hensyn til lagret tilstand, ruting av vurderere, tidsavbrudd, tilgangskontroll og kvaliteten på tilbakemeldingene.
Varig kjøring og tilstandslagring
En avbrytbar arbeidsflyt bør bevare nok tilstand til å kunne fortsette trygt etter en beslutning. Lagring i minnet kan være tilstrekkelig for en lokal test, men er sårbart når en vurdering kan ta flere timer eller en tjeneste kan startes på nytt. Velg et støttet, varig datalager for kjøremiljøet du bruker, og test gjenoppretting etter feil før lansering.
Mønstre for godkjenningspunkter
| Type kontrollpunkt | Når det bør brukes | Avveining |
|---|---|---|
| Godkjenning per verktøy | Utvalgte sensitive handlinger | Presis kontroll; mer konfigurasjon |
| Global godkjenning | Hver handling i en strengt kontrollert arbeidsflyt | Enkel policy; kan skape en stor vurderingskø |
| Betinget godkjenning | Vurdering basert på beløp, mottaker eller et risikosignal | Selektiv; krever testet regellogikk |
| Sortert vurderingskø | Flere avhengige beslutninger i én kjøring | Bevarer rekkefølgen; kan øke forsinkelsen |
Ruting og eskalering
Definer hvem som vurderer hver beslutningsklasse. Enkelte saker krever en fagekspert, mens andre kan gå til en opplært generell vurderer. Fastsett en ønsket svartid og en trygg reservehåndtering ved manglende vurdering. Avhengig av risikoen kan arbeidsflyten forbli satt på pause, eskaleres til en annen vurderer eller avsluttes uten å utføre handlingen.
Revisjonslogger og brukergrensesnitt for vurderere
Grensesnittet bør hjelpe vurderere med å ta informerte beslutninger. Vis den foreslåtte handlingen, relevant kildeinformasjon, kjent usikkerhet og konsekvensene av godkjenning. Strukturerte valg kan gjøre senere analyse enklere, men vurderere bør også kunne forklare en redigering eller avvisning når denne konteksten er viktig.
Profftips: Se på vurderingsgrensesnittet både som en sikkerhetskontroll og som et verktøy for datakvalitet. Samle bare inn informasjon du har en definert grunn til å bruke.
Ved overføring fra chatbot til menneske bør du bevare samtalekonteksten, registrere hvorfor automatiseringen stoppet og rute den resulterende forespørselen til riktig bruker eller kø.
HITL versus mennesket på loopen versus mennesket over loopen
Disse begrepene brukes ikke konsekvent innen alle fagområder. Skillene nedenfor er et praktisk rammeverk, ikke universelle definisjoner.
| Begrep | Typisk tidspunkt | Menneskets rolle | Blokkerer vanligvis kjøringen? | Vanlig bruk |
|---|---|---|---|---|
| Mennesket i loopen (HITL) | Før eller under en utvalgt beslutning | Tilfører innspill, godkjenner eller korrigerer | Ofte | Beslutninger med høyere risiko og tilbakemeldinger i opplæringen |
| Mennesket på loopen (HOTL) | Under drift | Overvåker og kan gripe inn | Vanligvis ikke | Aktivitet med større volum og som er enklere å reversere |
| Mennesket over loopen | Gjennom hele systemets livssyklus | Fastsetter policy og reviderer resultater | Nei | Styring og kontroll på systemnivå |
Passiv overvåking skiller seg fra et kontrollpunkt som krever godkjenning før en handling. Mange systemer kombinerer flere kontrollnivåer. De kan kreve direkte godkjenning for sensitive skrivehandlinger, overvåke resultater med lavere risiko og bruke periodiske styringsgjennomganger for policyer og systemytelse.
Stanford HAI beskriver et perspektiv der mennesker har kontrollen, og fremhever meningsfull menneskelig kontroll. Dette perspektivet flytter oppmerksomheten mot myndighet, sporbarhet og brukbare vurderingsprosesser i stedet for bare å telle hvor ofte en person berører prosessen.
Spørsmål som kan hjelpe deg med å velge en tilnærming, omfatter:
- Kan handlingen skade noen eller skape en endring som er vanskelig å reversere? Vurder en blokkerende menneskelig beslutning.
- Kan resultatet overvåkes og korrigeres raskt? Overvåking med en eskaleringsvei kan være tilstrekkelig.
- Innebærer dette en regulert beslutning eller en beslutning med tydelig ansvar? Knytt kontrollen til det faktiske kravet, og dokumenter hvem som eier den.
- Er aktiviteten lite risikofylt og godt forstått? Automatisering med overvåking kan være passende etter testing.
Hva er de reelle utfordringene ved å kjøre HITL i stor skala?
HITL introduserer kostnader og feilmåter som bør håndteres under utformingen.
Skalerbarhet. Blokkerende godkjenninger øker forsinkelsen og krever menneskelig kapasitet. Hvis hver handling sendes til den samme køen, kan vurderingen bli flaskehalsen. Risikobasert ruting kan reservere den mest omfattende vurderingen for usikre saker eller saker med stor påvirkning.
Skjevhet og korrelerte feil. En modell som trenes på menneskelige korrigeringer, kan arve menneskelige skjevheter. En vurderer kan også stole for lett på en modell som virker selvsikker. Forskning på samordning og komplementaritet i menneske-KI-team undersøker når en modell bør samsvare med menneskelige preferanser, og når ulike styrker kan forbedre teamets ytelse. Variert vurdering, kalibrering og enighetskontroller kan bidra til å avdekke systematiske forskjeller.
Personvern og datastyring. Vurderere kan se personopplysninger, økonomisk informasjon, helseopplysninger eller konfidensiell informasjon. Begrens tilgangen til det vurdereren trenger, beskytt data under overføring og lagring, og definer retningslinjer for oppbevaring og gjenbruk før du samler inn vurderingsoppføringer.
Menneskelig tretthet og inkonsekvens. Gjentatte vurderinger kan føre til forhastede beslutninger og skiftende standarder. Nyttige kontroller omfatter:
- Fastsett arbeidsmengder som gjenspeiler oppgavens kompleksitet
- Gjennomfør kalibreringsøvelser med de samme eksempelsakene
- Mål enighet når oppgaven har en forsvarlig referansestandard
- Roter arbeidet når dette ikke reduserer fagkompetansen
- Overvåk uvanlige endringer i mønstre for godkjenning, redigering eller avvisning
Kostnad. Menneskelig vurdering krever tid og spesialisert oppmerksomhet. Sammenlign denne kostnaden med den forventede kostnaden og sannsynligheten for feilene kontrollen skal forhindre. Et kontrollpunkt som vurderer alt, kan koste mer samtidig som det gir liten ekstra beskyttelse.
En praktisk sjekkliste for implementering av HITL-systemer
Før du implementerer en HITL-arbeidsflyt, bør du gå gjennom disse spørsmålene i rekkefølge.
- Risikovurdering. List opp handlingene systemet kan utføre. Klassifiser dem etter påvirkning, reverserbarhet og krav til ansvarlighet.
- Definer vurdereren. Identifiser hvem som kan vurdere hver handling, og hvilken informasjon og myndighet de trenger.
- Utforming av grensesnitt. Vis nok kontekst til at det er mulig å ta en reell beslutning. Definer veier for godkjenning, redigering, avvisning og eskalering der det er relevant.
- Strategi for tilstandslagring. Lagre tilstanden som trengs for å fortsette trygt, og test omstarter og dupliserte beslutninger.
- Plan for tilbakemeldinger. Bestem om vurderingsoppføringer skal brukes til revisjon, evaluering, ny opplæring eller en kombinasjon. Ikke anta at de passer til alle formål.
- Styring. Tildel ansvar for vurderingskvalitet, tilgang, oppbevaring, rutingsregler og endringer i kontroller.
Nyttige måleparametere kan omfatte:
- Vurderingsrate: andelen kvalifiserte handlinger som sendes til vurdering
- Tid til beslutning: forsinkelsen fra avbrudd til fullført vurdering
- Fordeling av beslutninger: andelen som godkjennes, redigeres, avvises eller eskaleres
- Feilutfall: problemene som fanges opp av vurderingen, og de som slipper gjennom til tross for den
- Enighet mellom vurderere: konsistens i utvalgte saker der sammenligning er meningsfull
Reduser vurderingen først etter at du har undersøkt reelle resultater. Hvis en kategori konsekvent godkjennes, bør du teste en smalere policy under overvåking. Hvis en kategori konsekvent avvises, bør du forbedre modellen eller forhindre handlingen i stedet for å legge til flere vurderere.
Hva sier aktuell forskning om HITLs fremtid?
Aktuell forskning undersøker i økende grad hvordan menneskelig deltakelse kan gjøres mer nyttig, ikke bare hvordan man kan legge til mer vurdering.
Forskning på samordnede og komplementære modeller tyder på at sterke menneske-KI-team kan trenge begge deler. En modell som speiler en persons vurdering, kan være forutsigbar, mens en modell med andre styrker kan oppdage noe personen overså. Riktig utforming avhenger av oppgaven, tilgjengelig dokumentasjon og hvordan uenighet håndteres.
Perspektivet der mennesker har kontrollen, oppmuntrer også team til å spørre om mennesker har reell myndighet. En vurderer som mangler kontekst, tid eller mulighet til å stoppe en handling, er ikke en effektiv sikkerhetskontroll, selv om arbeidsflyten registrerer en godkjenning.
Mønstre som er verdt å evaluere, omfatter:
- Avbruddsbaserte godkjenninger for utvalgte handlinger med varig kjøring
- Strukturerte vurderingsskjemaer som samler inn beslutninger og nyttige begrunnelser
- Risikobasert ruting som kombinerer modellens signaler med konsekvensene av en handling
- Testing av komplementaritet som måler om en person og en modell sammen presterer bedre enn hver av dem alene
Et nyttig eksperiment er å gruppere vurderingsresultater etter handlingstype og risikokategori. Se på rater for godkjenning, redigering, avvisning, hendelser og forsinkelse. Resultatet kan vise hvor vurderingen fanger opp meningsfulle problemer, og hvor den bare tilfører forsinkelse.
Profftips: Ikke optimaliser bare for godkjenningsraten. En høy godkjenningsrate kan tyde på en pålitelig kategori, svak kontroll eller et kontrollpunkt som er rettet mot feil type arbeid. Sammenlign godkjenninger med feil og resultater lenger ned i prosessen.
Viktigste punkter
KI med mennesket i loopen er mest verdifullt når den menneskelige beslutningen er knyttet til en tydelig risiko, støttes av nyttig kontekst og registreres for et definert formål.
| Punkt | Detaljer |
|---|---|
| HITL kan støtte opplæring og kontroll under kjøring | Menneskelige innspill kan merke data, evaluere resultater eller kontrollere utvalgte handlinger. |
| Risikobasert ruting bidrar til å kontrollere kostnadene | Konsentrer blokkerende vurdering om handlinger der konsekvensene forsvarer forsinkelsen og innsatsen. |
| Varig tilstand støtter pålitelige avbrudd | En arbeidsflyt i produksjon bør tåle omstarter og lange vurderingsforsinkelser. |
| Reell myndighet er viktig | Vurderere trenger kontekst, tid og mulighet til å endre eller stoppe utfallet. |
| Deskhero holder automatiske støttefunksjoner under kontroll | Chatboten og de automatiske KI-svarene bruker godkjent offentlig FAQ-innhold, er valgfrie og sender ubesvarte spørsmål videre til mennesker. |
Det de fleste team misforstår om HITL
Et vurderingstrinn kan se ansvarlig ut uten å gi særlig beskyttelse. Hvis vurderere mangler kontekst, godkjenner av vane eller ikke kan utfordre systemet, har organisasjonen skapt en kø i stedet for meningsfull kontroll.
Kontrollpunktet bør være knyttet til et spesifikt formål. Hvis hensikten er å forhindre skadelige handlinger, måler du hva det fanger opp, og hva som likevel slipper gjennom. Hvis vurderingsdata skal brukes til modellforbedring, bør du registrere hvorfor et resultat ble redigert og vurdere om etikettene er konsistente nok til dette formålet.
Team bør også skille mellom å redusere unødvendig vurdering og å svekke menneskelig myndighet. Modne systemer kan automatisere velkjente kategorier med lav risiko, samtidig som de gir mennesker bedre verktøy og tydeligere eskaleringsmyndighet for beslutningene som gjenstår.
HITL er derfor en organisatorisk kapasitet like mye som en teknisk funksjon. Bemanning, policy, opplæring, grensesnittutforming og datastyring avgjør om loopen fungerer.
Deskhero setter menneskelig kontroll i sentrum for KI-støtte
Deskhero bruker flere prinsipper for menneskelig kontroll i kundestøtten. Det kan utarbeide svar som brukere kan vurdere. Den kundevendte chatboten og de automatiske KI-svarene svarer kun fra arbeidsområdets godkjente offentlige FAQ. Begge de automatiske funksjonene er valgfrie, og automatiske handlinger merkes og loggføres.
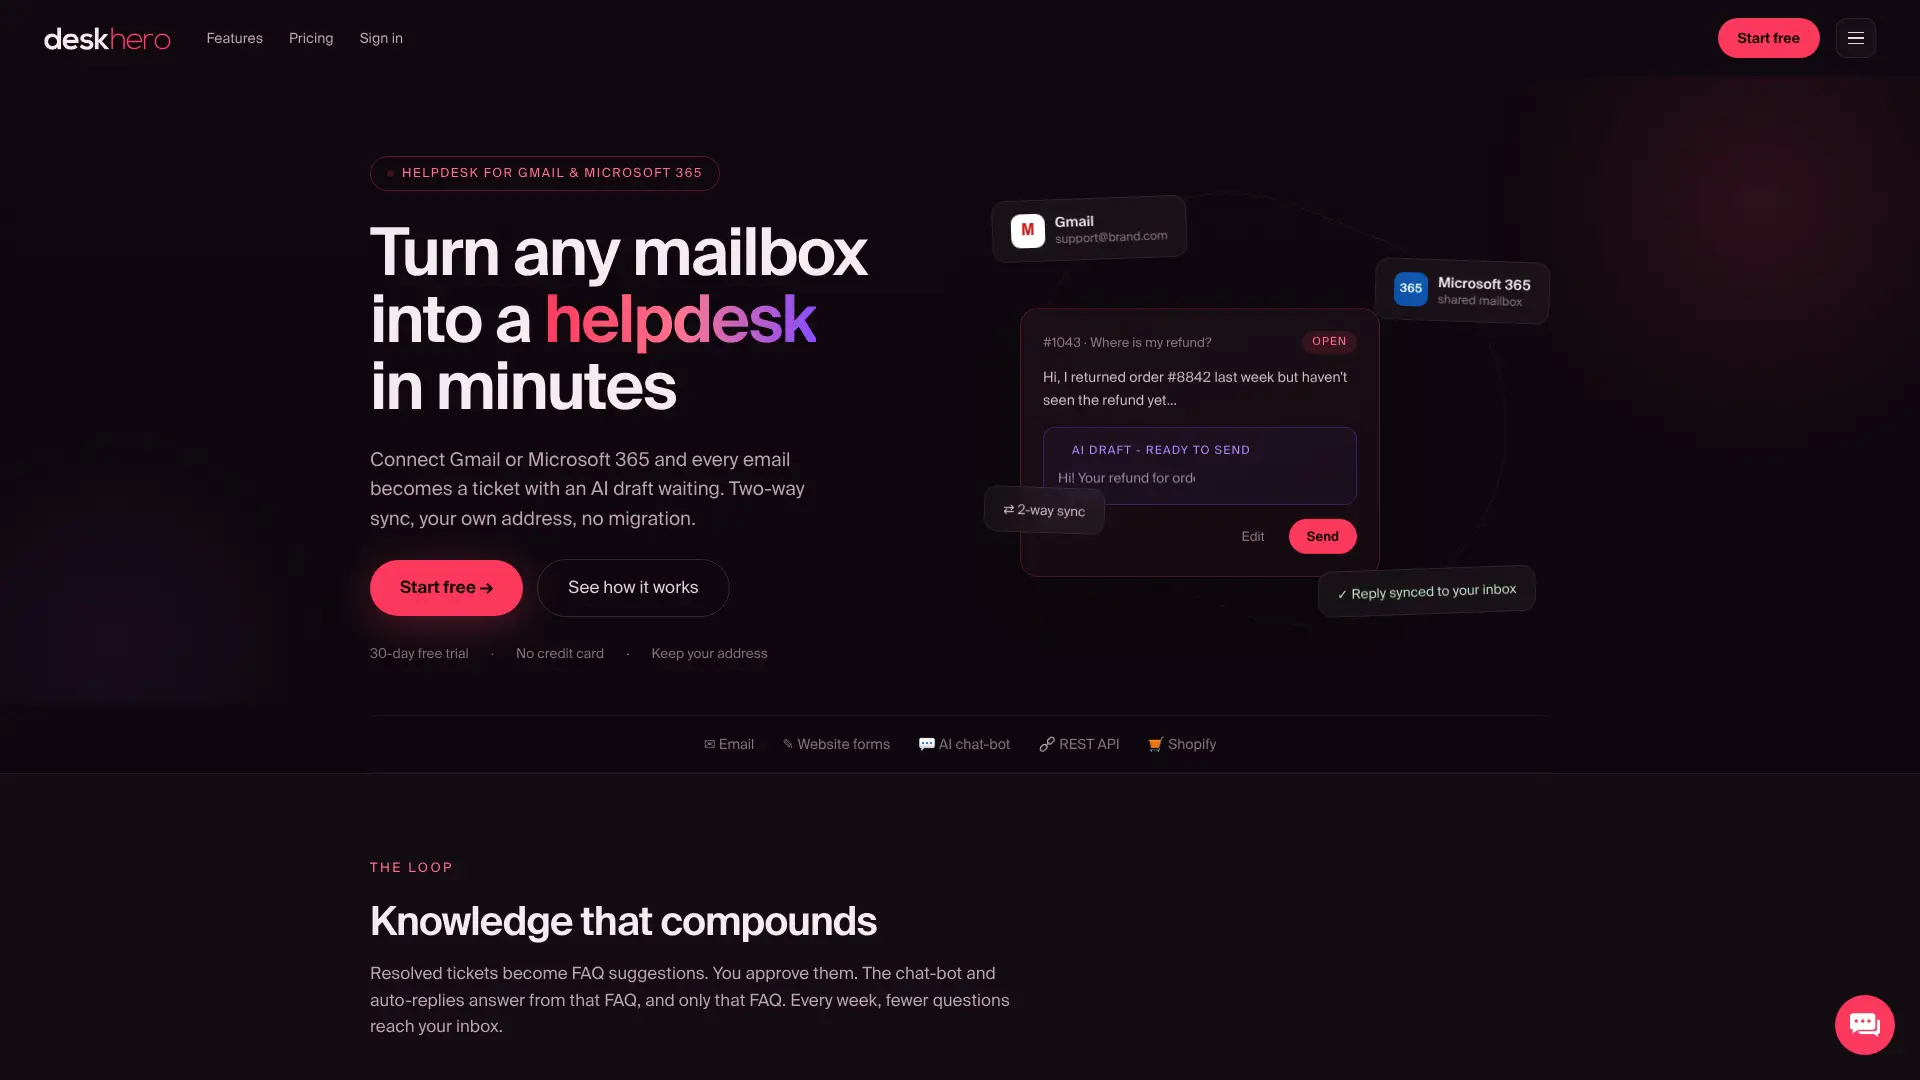
Deskhero foreslår FAQ-oppføringer fra løste saker og skrapede nettsider. En bruker vurderer, redigerer, godkjenner eller avslår hvert forslag før det blir offentlig. Chatboten krever minst 100 godkjente offentlige FAQ-oppføringer. Hvis den ikke kan svare, går den tilbake til et skjema slik at en person kan fortsette samtalen på e-post.
For netthandelsteam bruker Shopify-integrasjonen skrivebeskyttet tilgang for å vise kunde- og ordreopplysninger i saken. Deskhero tilbyr også toveis postkassetilkoblinger for Gmail, Google Workspace og Microsoft 365, slik at team kan beholde den eksisterende e-postadressen sin.
Du kan starte en 30 dagers gratis prøveperiode uten kredittkort.
Nyttige kilder
Disse kildene gir veiledning om implementering og forskningskontekst. Sjekk dokumentasjonen for den nøyaktige versjonen av rammeverket du bruker.
| Kilde | Dette dekker den |
|---|---|
| LangChain HITL-dokumentasjon | Avbrudd, vurderingsbeslutninger, lagring og verktøyspesifikk konfigurasjon av godkjenninger |
| inference.sh HITL-dokumentasjon | Godkjenningspunkter og varig kjøring i kjøremiljøet |
| Databricks om systemer med mennesket i loopen | Menneskelige tilbakemeldinger, ruting og operativ utforming |
| IBM: Hva er mennesket i loopen? | Definisjoner, vanlig bruk og hensyn i virksomheter |
| Stanford HAI: Hva er mennesket i loopen? | Menneskelig kontroll og perspektivet der mennesker har kontrollen |
| Stanford HAI: Humans in the Loop - Design of Interactive AI Systems | Utforming av interaktiv KI og samarbeid mellom mennesker og KI |
| AAAI: Align When They Want, Complement When They Need | Samordning, komplementaritet og ytelse i menneske-KI-team |
| Harvard Data Science Review: Data Science and Engineering With Human in the Loop | Menneskelige roller innen datavitenskap, ingeniørarbeid og kontroll |
| PMC: Human-in-the-loop approaches in clinical AI | Kliniske bruksområder og menneskelig kontroll |
Vanlige spørsmål
Hva betyr mennesket i loopen innen KI?
KI med mennesket i loopen plasserer menneskelige innspill på et definert punkt i en KI-prosess. En person kan merke data, evaluere et resultat, korrigere et resultat eller godkjenne en handling før den skjer.
Hva er forskjellen mellom mennesket i loopen og mennesket på loopen?
I vanlig bruk krever HITL menneskelige innspill for en utvalgt beslutning og setter ofte den berørte arbeidsflyten på pause. Mennesket på loopen beskriver vanligvis et system som kjører mens en person overvåker det og kan gripe inn. Terminologien varierer, så en systembeskrivelse bør angi den faktiske kontrollen i stedet for å basere seg på etiketten alene.
Hva betyr mennesket i loopen for KI-agenter?
For KI-systemer som kan utføre handlinger, betyr HITL ofte at systemet settes på pause før en utvalgt handling, viser forslaget og relevant kontekst til en vurderer, og bare fortsetter etter en tillatt beslutning. Arbeidsflyten bør bevare tilstanden og registrere hva vurdereren valgte.
Hva betyr mennesket på loopen innen KI?
Mennesket på loopen betyr generelt at et KI-system kjører mens en person overvåker resultatene og kan stoppe, korrigere eller overstyre det. Det krever vanligvis ikke godkjenning før hver handling.
Hvordan implementerer Deskhero KI med mennesket i loopen for kundestøtteteam?
Deskhero utarbeider svar som brukere kan vurdere. Chatboten og de automatiske KI-svarene er valgfrie og svarer kun fra den godkjente offentlige FAQ-en. Automatiske handlinger merkes og loggføres, og ubesvarte chatspørsmål går tilbake til et skjema for menneskelig oppfølging på e-post.