Human-in-the-loop-AI: Sådan fungerer det, og hvornår det skal bruges
Human-in-the-loop-AI (HITL) er et designmønster, der placerer menneskelig dømmekraft på definerede punkter i et AI-systems trænings-, beslutnings- eller udførelsesproces. Det er især nyttigt, når en automatiseret handling kan påvirke mennesker eller systemer, når fejl er dyre at omgøre, eller når en organisation har brug for et tydeligt menneskeligt ansvar.
Denne artikel forklarer, hvordan HITL fungerer, hvor det gør en forskel, og hvad teams skal designe, før de tager det i brug i produktion.
Indholdsfortegnelse
- Hvordan fungerer human-in-the-loop-AI egentlig?
- Hvorfor HITL er vigtigt: Nøjagtighed, sikkerhed og tillid
- Hvor anvendes HITL: Eksempler fra den virkelige verden
- Hvordan designer man et HITL-system til produktion?
- HITL vs. human-on-the-loop vs. human-over-the-loop
- Hvad er de reelle udfordringer ved at køre HITL i stor skala?
- En praktisk tjekliste til implementering af HITL-systemer
- Hvad siger den aktuelle forskning om HITL's fremtid?
- Vigtigste pointer
- Det, de fleste teams tager fejl af ved HITL
- Deskhero placerer menneskeligt tilsyn i centrum af AI-support
- Nyttige kilder
- FAQ
Hvordan fungerer human-in-the-loop-AI egentlig?
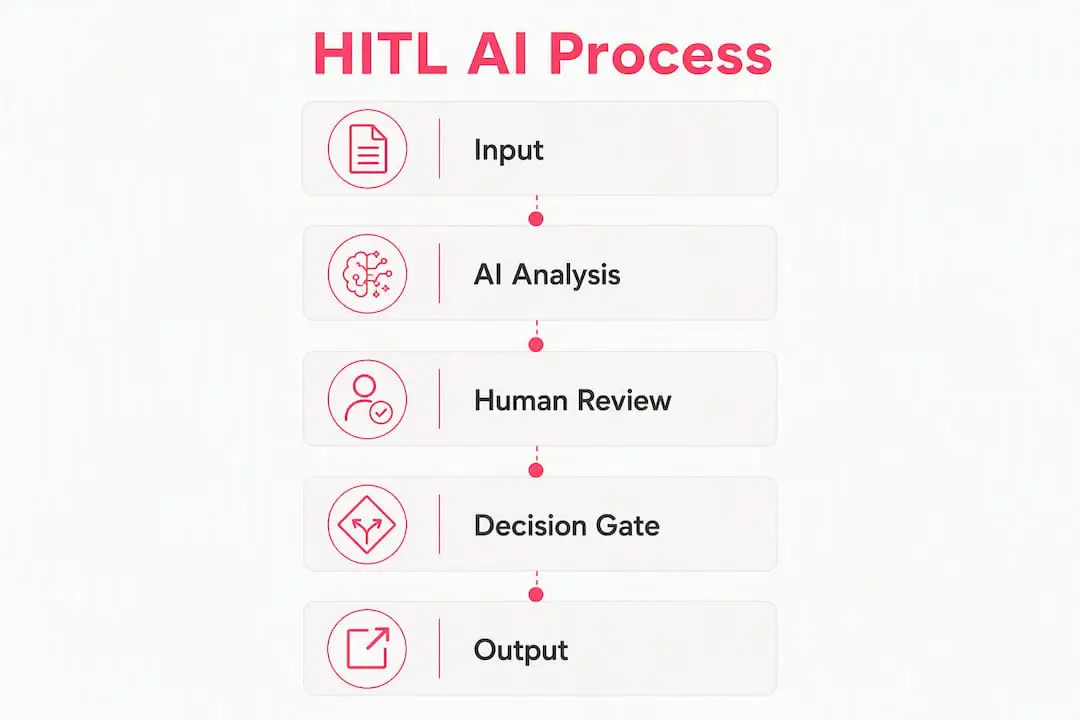
Loopet er en sekvens af kontrolpunkter, hvor en person leverer information, gennemgår et output eller godkender en handling. Systemet kan vente på dette input, eller det kan indsamle inputtet til senere evaluering og model forbedring.
Mennesker deltager typisk på to stadier:
HITL i træningsfasen omfatter mærkning af rådata, evaluering af modeloutput og levering af præferencesignaler. Forstærkende læring fra menneskelig feedback er et velkendt eksempel. Mennesker rangerer eller vurderer modellens svar, og disse vurderinger bruges som signaler under træningen. Aktiv læring er et andet mønster: En model identificerer usikre eksempler, så menneskelige annotatorer kan fokusere på de tilfælde, der kan give den mest nyttige information.
HITL ved kørsel tilføjer gennemgang, mens et implementeret system er i drift. Et system kan sætte på pause før en følsom handling, såsom at sende en besked eller ændre en post, og bede en person om at godkende, redigere eller afvise den foreslåede handling. LangChain HITL-dokumentationen beskriver middleware, der kan afbryde udvalgte kald til værktøjer, bevare tilstanden og genoptage efter en reviewers beslutning om, hvad der skal ske.
En nyttig kontrol ved kørsel viser revieweren, hvad systemet planlægger at gøre, giver strukturerede valgmuligheder, registrerer beslutningen og genoptager fra en gemt tilstand.
Et praktisk flow kan omfatte:
- Annotér data eller modeloutput med menneskelige labels
- Træn eller evaluér en model ved hjælp af disse gennemgåede eksempler
- Implementér modellen eller AI-workflowet
- Afbryd før udvalgte højrisikohandlinger
- Beslut, om handlingen skal godkendes, redigeres, afvises eller på anden måde besvares
- Registrér beslutningen som struktureret operationel feedback
Synkrone kontrolpunkter stopper det berørte workflow, indtil en reviewer handler. Asynkrone designs kan lade uafhængigt arbejde fortsætte, mens beslutningen afventer. Uanset hvad har langvarige workflows brug for en holdbar tilstand. inference.sh's runtime-dokumentation er et eksempel på et system, der beskriver godkendelseskontrolpunkter og vedvarende udførelse til dette formål.
Godkendelsesregler kan være brede eller selektive. Et team kan kræve gennemgang ved enhver brug af et følsomt værktøj eller kun når et beløb, en modtager, en konfidensscore eller en anden betingelse overskrider en tærskel. Selektiv routing kan reducere unødvendige gennemgange uden at fjerne tilsynet med de handlinger, der har brug for det.
Hvorfor HITL er vigtigt: Nøjagtighed, sikkerhed og tillid
Menneskeligt tilsyn kan forbedre et AI-workflow på tre praktiske måder.
Bedre håndtering af særtilfælde. Modeller kan have svært ved usædvanlige input eller ændrede forhold. En reviewer kan genkende en undtagelse og korrigere det foreslåede resultat. Hvis korrektionen registreres og styres korrekt, kan den senere understøtte evaluering eller model forbedring. Korrektionen forbedrer ikke automatisk en model; teamet har stadig brug for en bevidst feedbackpipeline.
Sikrere handlinger. Et AI-system, der kan sende beskeder, opdatere poster eller behandle transaktioner, kan forårsage skade, når det fortolker et input forkert. Et kontrolpunkt til gennemgang kan reducere denne risiko ved at stoppe udvalgte handlinger, før de finder sted. Databricks beskriver menneskelig gennemgang af beslutninger med større konsekvenser og værdien af at føre feedback tilbage ind i systemet.
Stærkere ansvarlighed. Et HITL-workflow med god instrumentering kan registrere, hvem der gennemgik en handling, hvad personen besluttede, og hvad der skete bagefter. Disse registreringer hjælper med hændelsesgennemgang, kvalitetskontrol og compliance. Et overfladisk godkendelsestrin er ikke nok. Gennemgangen skal have tilstrækkelig kontekst, tid og myndighed til at ændre resultatet.
Menneskelig feedback er mest nyttig, når den behandles som styrede operationelle data. Teams bør definere, hvordan beslutninger gemmes, hvem der kan få adgang til dem, hvor længe de opbevares, og om de skal bruges til evaluering, genoptræning eller ingen af delene.
Hvor anvendes HITL: Eksempler fra den virkelige verden
Mønstret optræder i mange brancher, men reviewerens ansvar ændrer sig alt efter domænet.
Medicinsk billeddiagnostik. En kliniker kan gennemgå et AI-markeret billede, før resultatet bruges til diagnosticering eller behandling. Det rette tilsyn afhænger af enheden, dens tilsigtede anvendelse og de gældende kliniske og regulatoriske krav. AI-output bør ikke beskrives som en erstatning for kvalificeret medicinsk dømmekraft.
Indholdsmoderation. En klassifikator kan markere potentielt regelstridigt indhold og sende usikre eller følsomme sager til en menneskelig reviewer. Mennesker håndterer kontekst og klager, mens automatisering hjælper med at håndtere mængden. Konsistente retningslinjer og kalibrering af reviewere er vigtige, fordi beslutninger fra gennemgangen senere kan bruges som trænings- eller evalueringsdata.
Kundesupport. AI kan udarbejde et svar, som en User kan gennemgå. Systemer med tilladelse til at sende beskeder eller ændre kontodata har brug for yderligere kontroller omkring disse handlinger. Et team kan kræve godkendelse baseret på handlingstypen, dens påvirkning og hvor let den kan omgøres. Se Deskhero's artikel om AI i kundeservice for mere baggrund.
Bedrageriefterforskning. En model kan score transaktioner og sende udvalgte sager til en analytiker. Analytikeren tager højde for kontekst, der muligvis ikke er repræsenteret i modellens input, og træffer den beslutning, som organisationens politik kræver.
Datamærkningspipelines. Menneskelige annotatorer eller domæneeksperter annoterer billeder, tekst eller lyd til superviseret træning og evaluering. Kvalitetstjek, tydelige instruktioner og enighedsmål er vigtige, fordi støjende labels kan reducere modellens kvalitet.
Eksperttip: Kortlæg de handlinger, et system kan udføre, før du vælger en reviewpolitik. Fokuser obligatorisk gennemgang på handlinger, der har stor påvirkning, er vanskelige at omgøre eller er underlagt et specifikt ansvarlighedskrav.
Hvordan designer man et HITL-system til produktion?
Et HITL-design til produktion kræver mere end en gennemgangsknap. Det skal tage højde for gemt tilstand, routing af reviewere, timeouts, adgangskontrol og feedbackkvalitet.
Holdbar udførelse og lagring af tilstand
Et workflow, der kan afbrydes, bør bevare tilstrækkelig tilstand til at kunne genoptages sikkert efter en beslutning. Lagring i hukommelsen kan være tilstrækkelig til en lokal test, men er skrøbelig, når en gennemgang kan tage flere timer, eller når en tjeneste kan genstarte. Vælg et understøttet, holdbart lager til den runtime, du bruger, og test gendannelse efter fejl før lancering.
Mønstre for godkendelseskontrolpunkter
| Kontrolpunkttype | Hvornår det bruges | Afvejning |
|---|---|---|
| Godkendelse pr. værktøj | Udvalgte følsomme handlinger | Præcis kontrol; mere konfiguration |
| Global godkendelse | Enhver handling i et stramt kontrolleret workflow | Enkel politik; kan skabe en stor reviewkø |
| Betinget godkendelse | Gennemgang baseret på et beløb, en modtager eller et risikosignal | Selektiv; kræver afprøvet regellogik |
| Prioriteret reviewkø | Flere afhængige beslutninger i én kørsel | Bevarer rækkefølgen; kan øge latenstiden |
Routing og eskalering
Definér, hvem der gennemgår hver type beslutning. Nogle sager kræver en domæneekspert, mens andre kan sendes til en uddannet generalist. Angiv en målsætning for svartiden og en sikker fallback ved manglende gennemgang. Afhængigt af risikoen kan workflowet forblive sat på pause, eskalere til en anden reviewer eller stoppe uden at udføre handlingen.
Auditlogge og reviewer-UI
Grænsefladen bør hjælpe reviewere med at træffe informerede beslutninger. Vis den foreslåede handling, relevante kildeoplysninger, kendt usikkerhed og konsekvenserne af en godkendelse. Strukturerede valg kan gøre senere analyse nemmere, men reviewere bør også have mulighed for at forklare en redigering eller afvisning, når den kontekst er vigtig.
Eksperttip: Se reviewgrænsefladen som både en sikkerhedskontrol og et værktøj til datakvalitet. Indsaml kun de oplysninger, du har en defineret grund til at bruge.
Ved overdragelse fra chatbot til menneske skal du bevare samtalekonteksten, registrere, hvorfor automatiseringen stoppede, og sende den resulterende henvendelse til den rette User eller kø.
HITL vs. human-on-the-loop vs. human-over-the-loop
Disse begreber bruges ikke konsekvent inden for alle fagområder. De følgende skelnen er en praktisk ramme, ikke universelle definitioner.
| Begreb | Typisk tidspunkt | Menneskets rolle | Blokerer det normalt udførelsen? | Typisk anvendelse |
|---|---|---|---|---|
| Human-in-the-loop (HITL) | Før eller under en udvalgt beslutning | Leverer input, godkendelse eller korrektion | Ofte | Beslutninger med højere risiko og feedback til træning |
| Human-on-the-loop (HOTL) | Under drift | Overvåger og kan gribe ind | Normalt ikke | Aktiviteter med større volumen og lettere reversering |
| Human-over-the-loop | På tværs af systemets livscyklus | Fastlægger politik og auditerer resultater | Nej | Governance og tilsyn på systemniveau |
Passiv overvågning adskiller sig fra et kontrolpunkt, der kræver godkendelse før en handling. Mange systemer kombinerer flere niveauer af tilsyn. De kan kræve direkte godkendelse af følsomme skrivninger, overvåge output med lavere risiko og bruge periodiske governancegennemgange af politikker og systemets ydeevne.
Stanford HAI beskriver et perspektiv med mennesker som ansvarlige, der lægger vægt på meningsfuld menneskelig kontrol. Denne tilgang flytter fokus mod myndighed, auditérbarhed og brugbare reviewworkflows i stedet for blot at tælle, hvor ofte en person rører ved processen.
Spørgsmål, der kan hjælpe med at vælge en tilgang, omfatter:
- Kan handlingen skade nogen eller skabe en ændring, der er svær at omgøre? Overvej en blokerende menneskelig beslutning.
- Kan resultatet overvåges og korrigeres hurtigt? Overvågning med en eskaleringsvej kan være tilstrækkelig.
- Er der tale om en reguleret beslutning eller en beslutning med et tydeligt ansvar? Knyt kontrollen til det faktiske krav, og dokumentér, hvem der ejer den.
- Er aktiviteten lavrisiko og velkendt? Automatisering med overvågning kan være passende efter test.
Hvad er de reelle udfordringer ved at køre HITL i stor skala?
HITL introducerer omkostninger og fejlkilder, som bør håndteres under designet.
Skalerbarhed. Blokerende godkendelser øger latenstiden og kræver menneskelig kapacitet. Hvis hver handling sendes til den samme kø, kan gennemgangen blive flaskehalsen. Risikobaseret routing kan reservere den mest omfattende gennemgang til usikre sager eller sager med stor påvirkning.
Bias og korrelerede fejl. En model, der er trænet på menneskelige korrektioner, kan arve menneskelige bias. En reviewer kan også for hurtigt lade sig påvirke af en model, der ser selvsikker ud. Forskning i alignment og komplementaritet i menneske-AI-teams undersøger, hvornår en model bør matche menneskelige præferencer, og hvornår forskellige styrker kan forbedre teamets præstation. Diversificeret gennemgang, kalibrering og enighedstjek kan hjælpe med at synliggøre systematiske forskelle.
Privatliv og datastyring. Reviewere kan se personlige, økonomiske, helbredsmæssige eller fortrolige oplysninger. Begræns adgangen til det, en reviewer har brug for, beskyt data under overførsel og i hvile, og fastlæg politikker for opbevaring og genbrug, før du indsamler reviewregistreringer.
Menneskelig træthed og inkonsekvens. Gentagne gennemgange kan føre til forhastede beslutninger og skiftende standarder. Nyttige kontroller omfatter:
- Fastlæg arbejdsbelastninger, der afspejler opgavens kompleksitet
- Gennemfør kalibreringsøvelser med de samme eksempelsager
- Mål enighed, når opgaven har en forsvarlig referencestandard
- Rotér arbejdet, når det ikke reducerer domæneekspertisen
- Overvåg usædvanlige ændringer i mønstre for godkendelser, redigeringer eller afvisninger
Omkostninger. Menneskelig gennemgang bruger tid og specialistopmærksomhed. Sammenhold denne omkostning med de forventede omkostninger og sandsynligheden for de fejl, som kontrollen skal forhindre. Et kontrolpunkt, der gennemgår alt, kan koste mere, samtidig med at det kun giver begrænset ekstra beskyttelse.
En praktisk tjekliste til implementering af HITL-systemer
Før du implementerer et HITL-workflow, skal du gennemgå disse spørgsmål i rækkefølge.
- Risikovurdering. Oplist de handlinger, systemet kan udføre. Klassificér dem efter påvirkning, reversibilitet og krav til ansvarlighed.
- Definition af reviewer. Identificér, hvem der må gennemgå hver handling, og hvilke oplysninger og hvilken myndighed de har brug for.
- Design af grænsefladen. Vis tilstrækkelig kontekst til en reel beslutning. Definér veje for godkendelse, redigering, afvisning og eskalering, hvor det er relevant.
- Strategi for lagring. Gem den tilstand, der er nødvendig for at genoptage sikkert, og test genstarter og duplikerede beslutninger.
- Feedbackplan. Beslut, om reviewregistreringer skal bruges til audit, evaluering, genoptræning eller en kombination. Antag ikke, at de er egnede til alle formål.
- Governance. Placér ansvaret for reviewkvalitet, adgang, opbevaring, routingregler og ændringer af kontroller.
Nyttige målepunkter kan omfatte:
- Reviewrate: andelen af kvalificerede handlinger, der sendes til gennemgang
- Tid til beslutning: forsinkelsen fra afbrydelsen til en gennemført gennemgang
- Fordeling af beslutninger: andelen, der godkendes, redigeres, afvises eller eskaleres
- Fejlresultater: de problemer, der opdages ved gennemgang, og dem, der slipper igennem trods den
- Enighed blandt reviewere: konsistensen i stikprøvesager, hvor sammenligning giver mening
Reducer først gennemgangen, når du har undersøgt de faktiske resultater. Hvis en kategori konsekvent godkendes, skal du teste en smallere politik under overvågning. Hvis en kategori konsekvent afvises, skal du forbedre modellen eller forhindre handlingen i stedet for at tilføje flere reviewere.
Hvad siger den aktuelle forskning om HITL's fremtid?
Aktuelt arbejde undersøger i stigende grad, hvordan menneskelig deltagelse kan gøres mere nyttig, ikke blot hvordan man tilføjer mere gennemgang.
Forskning i afstemte og komplementære modeller antyder, at stærke menneske-AI-teams kan have brug for begge dele. En model, der afspejler en persons dømmekraft, kan være forudsigelig, mens en model med andre styrker kan opdage noget, personen overså. Det rette design afhænger af opgaven, den tilgængelige dokumentation og hvordan uenigheder løses.
Perspektivet med mennesker som ansvarlige tilskynder også teams til at spørge, om mennesker har reel myndighed. En reviewer, der mangler kontekst, tid eller mulighed for at stoppe en handling, er ikke en effektiv sikkerhedskontrol, selv hvis workflowet registrerer en godkendelse.
Mønstre, der er værd at evaluere, omfatter:
- Afbrydelsesbaserede godkendelser for udvalgte handlinger med holdbar udførelse
- Strukturerede reviewformularer, der registrerer beslutninger og nyttige begrundelser
- Risikobaseret routing, der kombinerer modellens signaler med konsekvenserne af en handling
- Test af komplementaritet, der måler, om en person og en model sammen klarer sig bedre end hver af dem alene
Et nyttigt eksperiment er at gruppere reviewresultater efter handlingstype og risikobånd. Se på rater for godkendelser, redigeringer, afvisninger, hændelser og latenstid. Resultatet kan vise, hvor gennemgangen opdager meningsfulde problemer, og hvor den blot tilføjer forsinkelse.
Eksperttip: Optimér ikke kun efter godkendelsesraten. En høj godkendelsesrate kan være tegn på en pålidelig kategori, svagt tilsyn eller et kontrolpunkt, der er rettet mod det forkerte arbejde. Sammenhold godkendelser med fejl og resultater længere nede i processen.
Vigtigste pointer
Human-in-the-loop-AI er mest værdifuld, når den menneskelige beslutning er knyttet til en klar risiko, understøttes af nyttig kontekst og registreres til et defineret formål.
| Point | Detaljer |
|---|---|
| HITL kan understøtte træning og kontrol ved kørsel | Menneskeligt input kan mærke data, evaluere output eller kontrollere udvalgte handlinger. |
| Risikobaseret routing hjælper med at styre omkostningerne | Fokuser blokerende gennemgang på handlinger, hvis påvirkning retfærdiggør forsinkelsen og indsatsen. |
| Holdbar tilstand understøtter pålidelige afbrydelser | Et workflow i produktion bør kunne overleve genstarter og lange forsinkelser i gennemgangen. |
| Reel myndighed er vigtig | Reviewere har brug for kontekst, tid og mulighed for at ændre eller stoppe resultatet. |
| Deskhero holder automatiske supportfunktioner under kontrol | Deskhero's chatbot og AI-autosvar bruger godkendt offentligt FAQ-indhold, er tilvalgsbaserede og sender ubesvarede spørgsmål videre til mennesker. |
Det, de fleste teams tager fejl af ved HITL
Et reviewtrin kan se ansvarligt ud, samtidig med at det giver begrænset beskyttelse. Hvis reviewere mangler kontekst, godkender af vane eller ikke kan udfordre systemet, har organisationen skabt en kø i stedet for meningsfuldt tilsyn.
Kontrolpunktet bør være knyttet til et specifikt formål. Hvis det skal forhindre skadelige handlinger, skal du måle, hvad det fanger, og hvad der stadig slipper igennem. Hvis reviewdata skal bruges til model forbedring, skal du registrere, hvorfor et output blev redigeret, og vurdere, om labels er tilstrækkeligt konsistente til dette formål.
Teams bør også skelne mellem at reducere unødvendig gennemgang og at svække menneskelig myndighed. Modne systemer kan automatisere velkendte kategorier med lav risiko, samtidig med at de giver mennesker bedre værktøjer og tydeligere eskaleringsbeføjelser til de beslutninger, der er tilbage.
HITL er derfor lige så meget en organisatorisk kapacitet som en teknisk funktion. Bemanding, politik, træning, grænsefladedesign og datastyring afgør, om loopet fungerer.
Deskhero placerer menneskeligt tilsyn i centrum af AI-support
Deskhero anvender flere principper for menneskeligt tilsyn i kundesupport. Det kan udarbejde svar, som Users kan gennemgå. Deskhero's kundevendte chatbot og AI-autosvar besvarer kun spørgsmål ud fra arbejdsområdets godkendte offentlige FAQ. Begge automatiske funktioner er tilvalgsbaserede, og automatiske handlinger mærkes og logges.
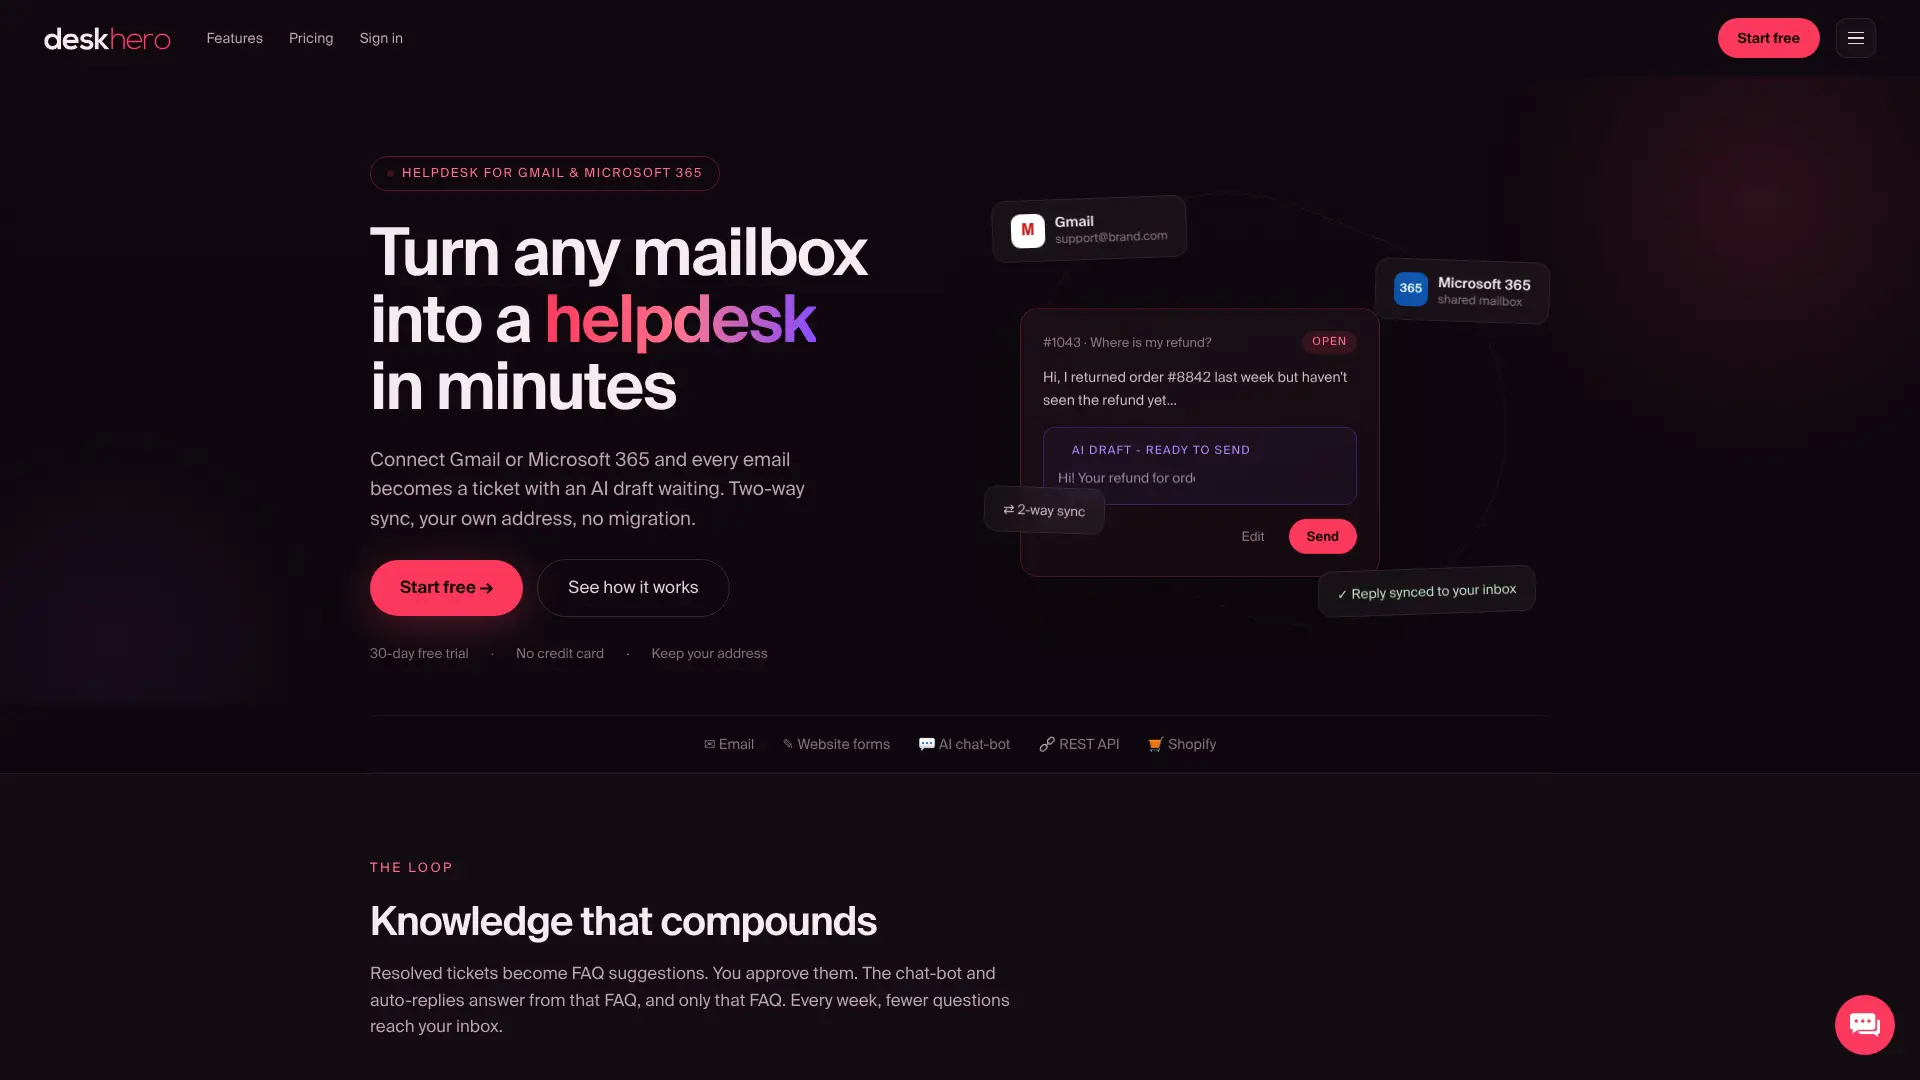
Deskhero foreslår FAQ-poster fra løste tickets og sider hentet fra websites. En User gennemgår, redigerer, godkender eller afviser hvert forslag, før det bliver offentligt. Chatbotten kræver mindst 100 godkendte offentlige FAQ-poster. Hvis den ikke kan svare, falder den tilbage til en formular, så en person kan fortsætte samtalen via e-mail.
For ecommerce-teams bruger Shopify-integrationen skrivebeskyttet adgang til at vise kunde- og ordreoplysninger i ticketen. Deskhero tilbyder også tovejsforbindelser til postkasser for Gmail, Google Workspace og Microsoft 365, så teams kan beholde deres eksisterende e-mailadresse.
Du kan starte en 30-dages gratis prøveperiode uden kreditkort.
Nyttige kilder
Disse kilder giver implementeringsvejledning og forskningskontekst. Tjek dokumentationen for den nøjagtige version af det framework, du bruger.
| Kilde | Hvad den dækker |
|---|---|
| LangChain HITL-dokumentation | Afbrydelser, reviewbeslutninger, lagring og værktøjsspecifik konfiguration af godkendelser |
| inference.sh HITL-dokumentation | Godkendelseskontrolpunkter og holdbar runtime-udførelse |
| Databricks om human-in-the-loop-systemer | Menneskelig feedback, routing og operationelt design |
| IBM: Hvad er human-in-the-loop? | Definitioner, almindelige anvendelser og overvejelser for virksomheder |
| Stanford HAI: Hvad er human-in-the-loop? | Menneskeligt tilsyn og perspektivet med mennesker som ansvarlige |
| Stanford HAI: Humans in the Loop - Design of Interactive AI Systems | Design af interaktiv AI og samarbejde mellem mennesker og AI |
| AAAI: Align When They Want, Complement When They Need | Alignment, komplementaritet og menneske-AI-teamets præstation |
| Harvard Data Science Review: Data Science and Engineering With Human in the Loop | Menneskelige roller inden for datavidenskab, engineering og tilsyn |
| PMC: Human-in-the-loop approaches in clinical AI | Kliniske anvendelser og menneskeligt tilsyn |
FAQ
Hvad betyder human-in-the-loop inden for AI?
Human-in-the-loop-AI placerer menneskeligt input på et defineret punkt i en AI-proces. En person kan mærke data, evaluere et output, korrigere et resultat eller godkende en handling, før den finder sted.
Hvad er forskellen mellem human-in-the-loop og human-on-the-loop?
I almindelig brug kræver HITL menneskeligt input til en udvalgt beslutning og sætter ofte det berørte workflow på pause. Human-on-the-loop beskriver normalt et system, der fungerer, mens en person overvåger det og kan gribe ind. Terminologien varierer, så en systembeskrivelse bør angive den faktiske kontrol i stedet for kun at stole på betegnelsen.
Hvad betyder human-in-the-loop for AI-agenter?
For AI-systemer, der kan udføre handlinger, betyder HITL ofte, at systemet sættes på pause før en udvalgt handling, viser forslaget og den relevante kontekst til en reviewer og først genoptages efter en tilladt beslutning. Workflowet bør bevare tilstanden og registrere, hvad revieweren valgte.
Hvad er human-on-the-loop inden for AI?
Human-on-the-loop betyder generelt, at et AI-system fungerer, mens en person overvåger resultaterne og kan stoppe, korrigere eller tilsidesætte det. Det kræver normalt ikke godkendelse før hver handling.
Hvordan implementerer Deskhero human-in-the-loop-AI til supportteams?
Deskhero udarbejder svar, som Users kan gennemgå. Deskhero's chatbot og AI-autosvar er tilvalgsbaserede og besvarer kun spørgsmål ud fra den godkendte offentlige FAQ. Automatiske handlinger mærkes og logges, og ubesvarede chatspørgsmål falder tilbage til en formular, så et menneske kan følge op via e-mail.