AI med människa i loopen: Så fungerar det och när det passar
AI med människa i loopen (HITL) är ett designmönster som placerar mänskligt omdöme vid definierade punkter i ett AI-systems tränings-, besluts- eller genomförandeprocess. Det är särskilt användbart när en automatiserad åtgärd kan påverka människor eller system, när fel är kostsamma att åtgärda eller när en organisation behöver tydligt mänskligt ansvar.
Den här artikeln förklarar hur HITL fungerar, var det hjälper och vad team behöver utforma innan de använder det i produktion.
Innehållsförteckning
- Hur fungerar AI med människa i loopen i praktiken?
- Varför HITL är viktigt: noggrannhet, säkerhet och förtroende
- Var används HITL? Exempel från verkligheten
- Hur utformar man ett HITL-system för produktion?
- HITL jämfört med människa ovanpå loopen och människa över loopen
- Vilka är de verkliga utmaningarna med att köra HITL i stor skala?
- En praktisk checklista för att driftsätta HITL-system
- Vad säger aktuell forskning om HITL:s framtid?
- Viktiga slutsatser
- Det de flesta team gör fel när det gäller HITL
- Deskhero sätter mänsklig tillsyn i centrum för AI-support
- Användbara källor
- Vanliga frågor
Hur fungerar AI med människa i loopen i praktiken?
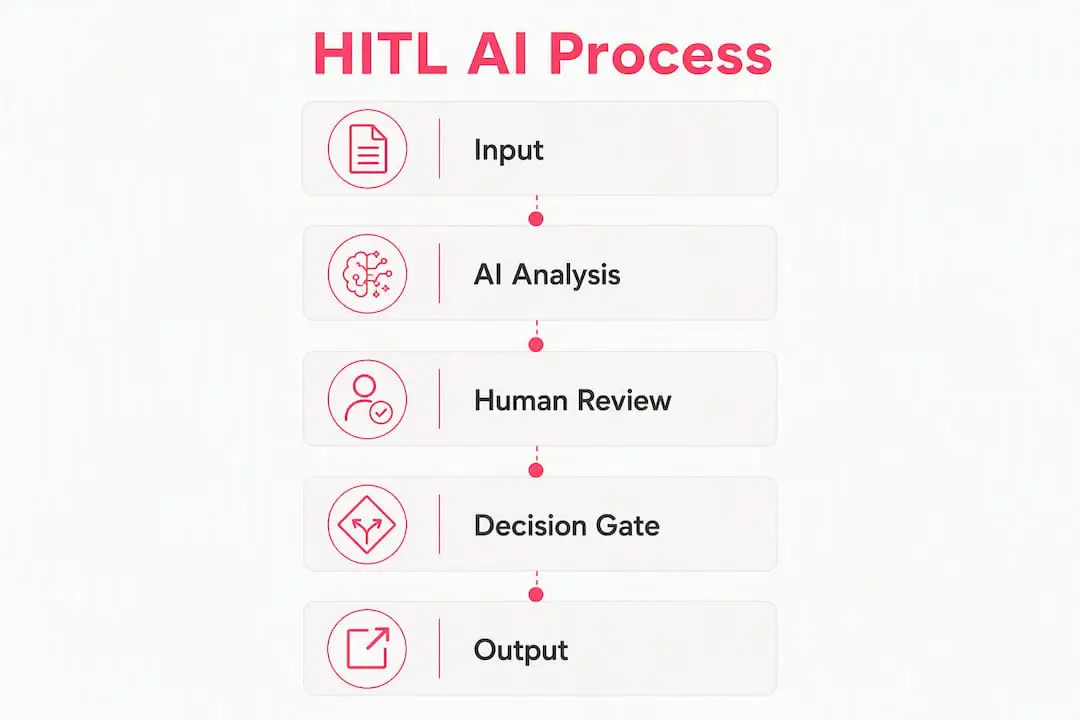
Loopen är en sekvens av kontrollpunkter där en person tillför information, granskar ett resultat eller godkänner en åtgärd. Systemet kan vänta på den inmatningen, eller samla in den för senare utvärdering och förbättring av modellen.
Människor deltar vanligtvis i två steg:
HITL under träningsfasen omfattar märkning av rådata, utvärdering av modellresultat och insamling av preferenssignaler. Förstärkningsinlärning från mänsklig feedback är ett välkänt exempel. Människor rangordnar eller bedömer modellsvar, och dessa bedömningar används som signaler under träningen. Aktiv inlärning är ett annat mönster: en modell identifierar osäkra exempel så att mänskliga annotatörer kan fokusera på de fall som kan ge mest användbar information.
HITL under körning lägger till granskning medan ett driftsatt system är i funktion. Ett system kan pausa före en känslig åtgärd, till exempel att skicka ett meddelande eller ändra en post, och be en person att godkänna, redigera eller avvisa den föreslagna åtgärden. LangChains HITL-dokumentation beskriver middleware som kan avbryta valda verktygsanrop, bevara tillstånd och återuppta körningen efter att en granskare har beslutat vad som ska göras.
En användbar kontrollpunkt under körning visar granskaren vad systemet planerar att göra, erbjuder strukturerade val, registrerar beslutet och återupptar körningen från ett sparat tillstånd.
Ett praktiskt flöde kan innehålla:
- Annotera data eller modellresultat med mänskliga etiketter
- Träna eller utvärdera en modell med hjälp av de granskade exemplen
- Driftsätt modellen eller AI-arbetsflödet
- Avbryt före utvalda åtgärder med hög risk
- Besluta om åtgärden ska godkännas, redigeras, avvisas eller hanteras på annat sätt
- Samla in beslutet som strukturerad operativ feedback
Synkrona kontrollpunkter stoppar det berörda arbetsflödet tills en granskare agerar. Asynkrona konstruktioner kan låta orelaterat arbete fortsätta medan beslutet väntar. Oavsett vilket behöver långvariga arbetsflöden ett varaktigt tillstånd. Dokumentationen för inference.sh runtime är ett exempel på ett system som beskriver godkännandegrindar och beständig körning för detta ändamål.
Reglerna för godkännande kan vara breda eller selektiva. Ett team kan kräva granskning vid varje användning av ett känsligt verktyg, eller endast när ett belopp, en mottagare, en konfidenspoäng eller något annat villkor passerar en tröskel. Selektiv dirigering kan minska onödig granskning utan att ta bort tillsynen från de åtgärder som behöver den.
Varför HITL är viktigt: noggrannhet, säkerhet och förtroende
Mänsklig tillsyn kan förbättra ett AI-arbetsflöde på tre praktiska sätt.
Bättre hantering av specialfall. Modeller kan ha svårt med ovanliga indata eller föränderliga förhållanden. En granskare kan upptäcka ett undantag och korrigera det föreslagna resultatet. Om korrigeringen samlas in och styrs på rätt sätt kan den senare stödja utvärdering eller modellförbättring. Korrigeringen förbättrar inte modellen automatiskt; teamet behöver fortfarande en genomtänkt feedbackpipeline.
Säkrare åtgärder. Ett AI-system som kan skicka meddelanden, uppdatera poster eller behandla transaktioner kan orsaka skada när det misstolkar indata. En granskningskontroll kan minska risken genom att stoppa utvalda åtgärder innan de genomförs. Databricks diskuterar mänsklig granskning för beslut med större påverkan och värdet av att återföra feedback till systemet.
Starkare ansvarsskyldighet. Ett väl instrumenterat HITL-arbetsflöde kan registrera vem som granskade en åtgärd, vad personen beslutade och vad som hände därefter. Dessa uppgifter hjälper vid incidentgranskning, kvalitetskontroll och efterlevnad. Ett ytligt godkännandesteg räcker inte. Granskningen behöver tillräckligt med sammanhang, tid och befogenhet för att kunna ändra resultatet.
Mänsklig feedback är mest användbar när den behandlas som styrd operativ data. Team bör definiera hur beslut lagras, vem som får åtkomst till dem, hur länge de sparas och om de ska användas för utvärdering, omträning eller inget av detta.
Var används HITL? Exempel från verkligheten
Mönstret förekommer i många branscher, men granskarens ansvar förändras beroende på området.
Medicinsk bilddiagnostik. En kliniker kan granska en AI-markerad bild innan resultatet används i diagnostik eller vård. Den lämpliga tillsynen beror på enheten, dess avsedda användning samt tillämpliga kliniska och regulatoriska krav. AI-resultat bör inte beskrivas som ett substitut för kvalificerat medicinskt omdöme.
Innehållsmoderering. En klassificerare kan flagga potentiellt regelbrytande innehåll och skicka osäkra eller känsliga fall till en mänsklig granskare. Människor hanterar sammanhang och överklaganden, medan automatisering hjälper till att hantera volymen. Konsekventa riktlinjer och kalibrering av granskare är viktiga eftersom granskningsbeslut senare kan användas som tränings- eller utvärderingsdata.
Kundsupport. AI kan utforma ett svar som en Användare får granska. System med behörighet att skicka meddelanden eller ändra kontodata behöver ytterligare kontroller kring dessa åtgärder. Ett team kan kräva godkännande baserat på åtgärdens typ, påverkan och hur lätt den kan återställas. Mer bakgrund finns i Deskheroes artikel om AI inom kundservice.
Bedrägeriutredning. En modell kan poängsätta transaktioner och dirigera utvalda fall till en analytiker. Analytikern tar hänsyn till sammanhang som kanske inte finns representerat i modellens indata och fattar det beslut som organisationens policy kräver.
Datamärkningspipelines. Mänskliga annotatörer eller domänexperter annoterar bilder, text eller ljud för övervakad träning och utvärdering. Kvalitetskontroller, tydliga instruktioner och mått på överensstämmelse är viktiga eftersom brusiga etiketter kan försämra modellens kvalitet.
Proffstips: Kartlägg vilka åtgärder ett system kan utföra innan du väljer en granskningspolicy. Fokusera obligatorisk granskning på åtgärder som har stor påverkan, är svåra att återställa eller omfattas av ett specifikt krav på ansvarsskyldighet.
Hur utformar man ett HITL-system för produktion?
En HITL-konstruktion för produktion behöver mer än en granskningsknapp. Den måste ta hänsyn till sparat tillstånd, dirigering av granskare, tidsgränser, åtkomstkontroll och feedbackens kvalitet.
Varaktig körning och beständigt tillstånd
Ett avbrytbart arbetsflöde bör bevara tillräckligt med tillstånd för att kunna återupptas säkert efter ett beslut. Lagring i minnet kan räcka för ett lokalt test, men är sårbart när en granskning kan ta flera timmar eller när en tjänst kan startas om. Välj ett stödd beständigt lagringssystem för den runtime du använder och testa återställning efter fel innan lansering.
Mönster för godkännandegrindar
| Typ av grind | När den används | Avvägning |
|---|---|---|
| Godkännande per verktyg | Utvalda känsliga åtgärder | Exakt kontroll; mer konfiguration |
| Globalt godkännande | Varje åtgärd i ett strikt kontrollerat arbetsflöde | Enkel policy; kan skapa en stor granskningskö |
| Villkorat godkännande | Granskning baserad på belopp, mottagare eller risksignal | Selektivt; kräver testad regellogik |
| Ordnad granskningskö | Flera beroende beslut i samma körning | Bevarar ordningsföljden; kan öka fördröjningen |
Dirigering och eskalering
Definiera vem som granskar varje typ av beslut. Vissa fall kräver en domänexpert, medan andra kan gå till en utbildad allmän granskare. Sätt en måltid för svar och en säker reservlösning vid utebliven granskning. Beroende på risken kan arbetsflödet förbli pausat, eskaleras till en annan granskare eller avslutas utan att åtgärden utförs.
Revisionsloggar och granskargränssnitt
Gränssnittet bör hjälpa granskare att fatta välgrundade beslut. Visa den föreslagna åtgärden, relevant källinformation, känd osäkerhet och konsekvenserna av ett godkännande. Strukturerade val kan underlätta senare analys, men granskare bör också kunna förklara en redigering eller ett avslag när sammanhanget är viktigt.
Proffstips: Behandla granskningsgränssnittet både som en säkerhetskontroll och ett verktyg för datakvalitet. Samla bara in information som du har ett definierat skäl att använda.
Vid överlämning från chatbot till människa ska du bevara samtalskontexten, registrera varför automatiseringen stoppades och dirigera den resulterande förfrågan till rätt Användare eller kö.
HITL jämfört med människa ovanpå loopen och människa över loopen
Dessa termer används inte konsekvent inom alla områden. Följande åtskillnader är ett praktiskt ramverk, inte universella definitioner.
| Term | Typisk tidpunkt | Människans roll | Blockerar vanligtvis körningen? | Vanlig användning |
|---|---|---|---|---|
| Human-in-the-loop (HITL) | Före eller under ett utvalt beslut | Tillför indata, godkännande eller korrigering | Ofta | Beslut med högre risk och feedback under träning |
| Human-on-the-loop (HOTL) | Under körning | Övervakar och kan ingripa | Vanligtvis inte | Aktiviteter med högre volym och bättre möjlighet till återställning |
| Human-over-the-loop | Genom hela systemets livscykel | Fastställer policy och granskar resultat | Nej | Styrning och tillsyn på systemnivå |
Passiv övervakning skiljer sig från en grind som kräver godkännande före en åtgärd. Många system kombinerar flera tillsynsnivåer. De kan kräva direkt godkännande för känsliga skrivningar, övervaka resultat med lägre risk och använda återkommande styrningsgranskningar för policyer och systemprestanda.
Stanford HAI beskriver ett perspektiv där människor har kontrollen och betonar meningsfull mänsklig kontroll. Detta perspektiv flyttar fokus mot befogenhet, spårbarhet och användbara granskningsarbetsflöden i stället för att bara räkna hur ofta en person berör processen.
Frågor som hjälper dig att välja angreppssätt är bland annat:
- Kan åtgärden skada någon eller skapa en förändring som är svår att återställa? Överväg ett blockerande mänskligt beslut.
- Kan resultatet övervakas och korrigeras snabbt? Övervakning med en eskaleringsväg kan vara tillräcklig.
- Är ett reglerat beslut eller ett beslut med tydligt ansvar inblandat? Koppla kontrollen till det faktiska kravet och dokumentera vem som äger den.
- Är aktiviteten lågrisk och välförstådd? Automatisering med övervakning kan vara lämplig efter testning.
Vilka är de verkliga utmaningarna med att köra HITL i stor skala?
HITL medför kostnader och felmoder som bör hanteras under utformningen.
Skalbarhet. Blockerande godkännanden ökar fördröjningen och kräver mänsklig kapacitet. Om varje åtgärd hamnar i samma kö kan granskningen bli flaskhalsen. Riskbaserad dirigering kan reservera den mest omfattande granskningen för osäkra fall eller fall med stor påverkan.
Partiskhet och korrelerade fel. En modell som tränats på mänskliga korrigeringar kan ärva mänskliga fördomar. En granskare kan också förlita sig för lätt på en modell som verkar självsäker. Forskning om anpassning och komplementaritet i team med människor och AI undersöker när en modell bör överensstämma med mänskliga preferenser och när olika styrkor kan förbättra teamets prestation. Mångsidig granskning, kalibrering och kontroller av överensstämmelse kan hjälpa till att synliggöra systematiska skillnader.
Integritet och datastyrning. Granskare kan få se personuppgifter, ekonomisk information, hälsouppgifter eller konfidentiell information. Begränsa åtkomsten till det granskaren behöver, skydda data under överföring och i vila och definiera policyer för lagringstid och återanvändning innan du samlar in granskningsposter.
Mänsklig trötthet och inkonsekvens. Upprepade granskningar kan leda till förhastade beslut och föränderliga standarder. Användbara kontroller omfattar:
- Fastställ arbetsbelastningar som återspeglar uppgiftens komplexitet
- Genomför kalibreringsövningar med samma exempel
- Mät överensstämmelse när uppgiften har en försvarbar referensstandard
- Rotera arbetet när det inte minskar domänexpertisen
- Övervaka ovanliga förändringar i mönster för godkännanden, redigeringar eller avslag
Kostnad. Mänsklig granskning förbrukar tid och specialistuppmärksamhet. Jämför den kostnaden med den förväntade kostnaden och sannolikheten för de fel som kontrollen är avsedd att förhindra. En grind som granskar allt kan kosta mer samtidigt som den ger begränsat skydd.
En praktisk checklista för att driftsätta HITL-system
Gå igenom följande frågor i ordning innan du driftsätter ett HITL-arbetsflöde.
- Riskbedömning. Lista de åtgärder systemet kan utföra. Klassificera dem efter påverkan, möjlighet till återställning och krav på ansvarsskyldighet.
- Definition av granskare. Identifiera vem som får granska varje åtgärd och vilken information och befogenhet personen behöver.
- Gränssnittsdesign. Visa tillräckligt med sammanhang för ett verkligt beslut. Definiera vägar för godkännande, redigering, avslag och eskalering där de är tillämpliga.
- Strategi för beständighet. Lagra det tillstånd som behövs för att återuppta körningen säkert och testa omstarter och dubbla beslut.
- Feedbackplan. Bestäm om granskningsposter ska användas för revision, utvärdering, omträning eller en kombination. Anta inte att de passar för alla ändamål.
- Styrning. Tilldela ansvar för granskningskvalitet, åtkomst, lagringstid, dirigeringsregler och ändringar av kontroller.
Användbara mått kan omfatta:
- Granskningsgrad: andelen kvalificerade åtgärder som skickas för granskning
- Tid till beslut: fördröjningen från avbrott till slutförd granskning
- Beslutsfördelning: andelen som godkänns, redigeras, avvisas eller eskaleras
- Felutfall: problem som upptäcks vid granskning och problem som missas trots granskningen
- Överensstämmelse mellan granskare: konsekvens i stickprov där jämförelse är meningsfull
Minska granskningen först efter att du har undersökt verkliga resultat. Om en kategori konsekvent godkänns kan du testa en smalare policy under övervakning. Om en kategori konsekvent avvisas bör du förbättra modellen eller förhindra den åtgärden i stället för att lägga till fler granskare.
Vad säger aktuell forskning om HITL:s framtid?
Aktuellt arbete undersöker i allt högre grad hur mänskligt deltagande kan göras mer användbart, inte bara hur mer granskning kan läggas till.
Forskning om anpassade och kompletterande modeller antyder att starka team med människor och AI kan behöva båda delarna. En modell som speglar en persons bedömning kan vara förutsägbar, medan en modell med andra styrkor kan upptäcka något som personen missade. Den rätta utformningen beror på uppgiften, tillgängliga bevis och hur meningsskiljaktigheter hanteras.
Perspektivet där människor har kontrollen uppmuntrar också team att fråga om människor har verklig befogenhet. En granskare som saknar sammanhang, tid eller makt att stoppa en åtgärd är inte en effektiv säkerhetskontroll, även om arbetsflödet registrerar ett godkännande.
Mönster som är värda att utvärdera omfattar:
- Avbrottsbaserade godkännanden för utvalda åtgärder med varaktig körning
- Strukturerade granskningsformulär som samlar in beslut och användbara motiveringar
- Riskbaserad dirigering som kombinerar modellens signaler med konsekvenserna av en åtgärd
- Testning av komplementaritet som mäter om en person och en modell tillsammans överträffar var och en för sig
Ett användbart experiment är att gruppera granskningsresultat efter åtgärdstyp och riskintervall. Titta på andelar för godkännande, redigering, avslag, incidenter och fördröjning. Resultatet kan visa var granskningen fångar meningsfulla problem och var den bara skapar mer fördröjning.
Proffstips: Optimera inte enbart för godkännandegrad. En hög godkännandegrad kan tyda på en tillförlitlig kategori, bristande granskning eller en grind som riktats mot fel typ av arbete. Jämför godkännanden med fel och efterföljande resultat.
Viktiga slutsatser
AI med människa i loopen är mest värdefullt när det mänskliga beslutet är kopplat till en tydlig risk, stöds av användbart sammanhang och registreras för ett definierat ändamål.
| Punkt | Detaljer |
|---|---|
| HITL kan stödja träning och kontroll under körning | Mänsklig indata kan märka data, utvärdera resultat eller fungera som grind för utvalda åtgärder. |
| Riskbaserad dirigering hjälper till att kontrollera kostnaden | Fokusera blockerande granskning på åtgärder vars påverkan motiverar fördröjningen och arbetsinsatsen. |
| Beständigt tillstånd möjliggör tillförlitliga avbrott | Ett arbetsflöde i produktion bör klara omstarter och långa granskningsfördröjningar. |
| Verklig befogenhet är viktig | Granskare behöver sammanhang, tid och möjlighet att ändra eller stoppa resultatet. |
| Deskhero håller automatiska supportfunktioner under kontroll | Dess chatbot och AI-autosvar använder godkänt offentligt FAQ-innehåll, är valfria och lämnar obesvarade frågor vidare till människor. |
Det de flesta team gör fel när det gäller HITL
Ett granskningssteg kan se ansvarsfullt ut utan att ge mycket skydd. Om granskare saknar sammanhang, godkänner av vana eller inte kan ifrågasätta systemet har organisationen skapat en kö i stället för meningsfull tillsyn.
Grinden bör vara kopplad till ett specifikt syfte. Om den ska förhindra skadliga åtgärder ska du mäta vad den fångar upp och vad som ändå slinker igenom. Om granskningsdata ska användas för modellförbättring ska du samla in varför ett resultat redigerades och bedöma om etiketterna är tillräckligt konsekventa för detta ändamål.
Team bör också skilja mellan att minska onödig granskning och att försvaga mänsklig befogenhet. Mogna system kan automatisera välförstådda kategorier med låg risk samtidigt som människor får bättre verktyg och tydligare eskaleringsmöjligheter för de beslut som återstår.
HITL är därför en organisatorisk förmåga lika mycket som en teknisk funktion. Bemanning, policy, utbildning, gränssnittsdesign och datastyrning avgör om loopen fungerar.
Deskhero sätter mänsklig tillsyn i centrum för AI-support
Deskhero tillämpar flera principer för mänsklig tillsyn inom kundsupport. Det kan utforma svar som Användare får granska. Dess kundvända chatbot och AI-autosvar besvarar endast frågor utifrån arbetsytans godkända offentliga FAQ. Båda automatiska funktionerna är valfria, och automatiska åtgärder märks och loggas.
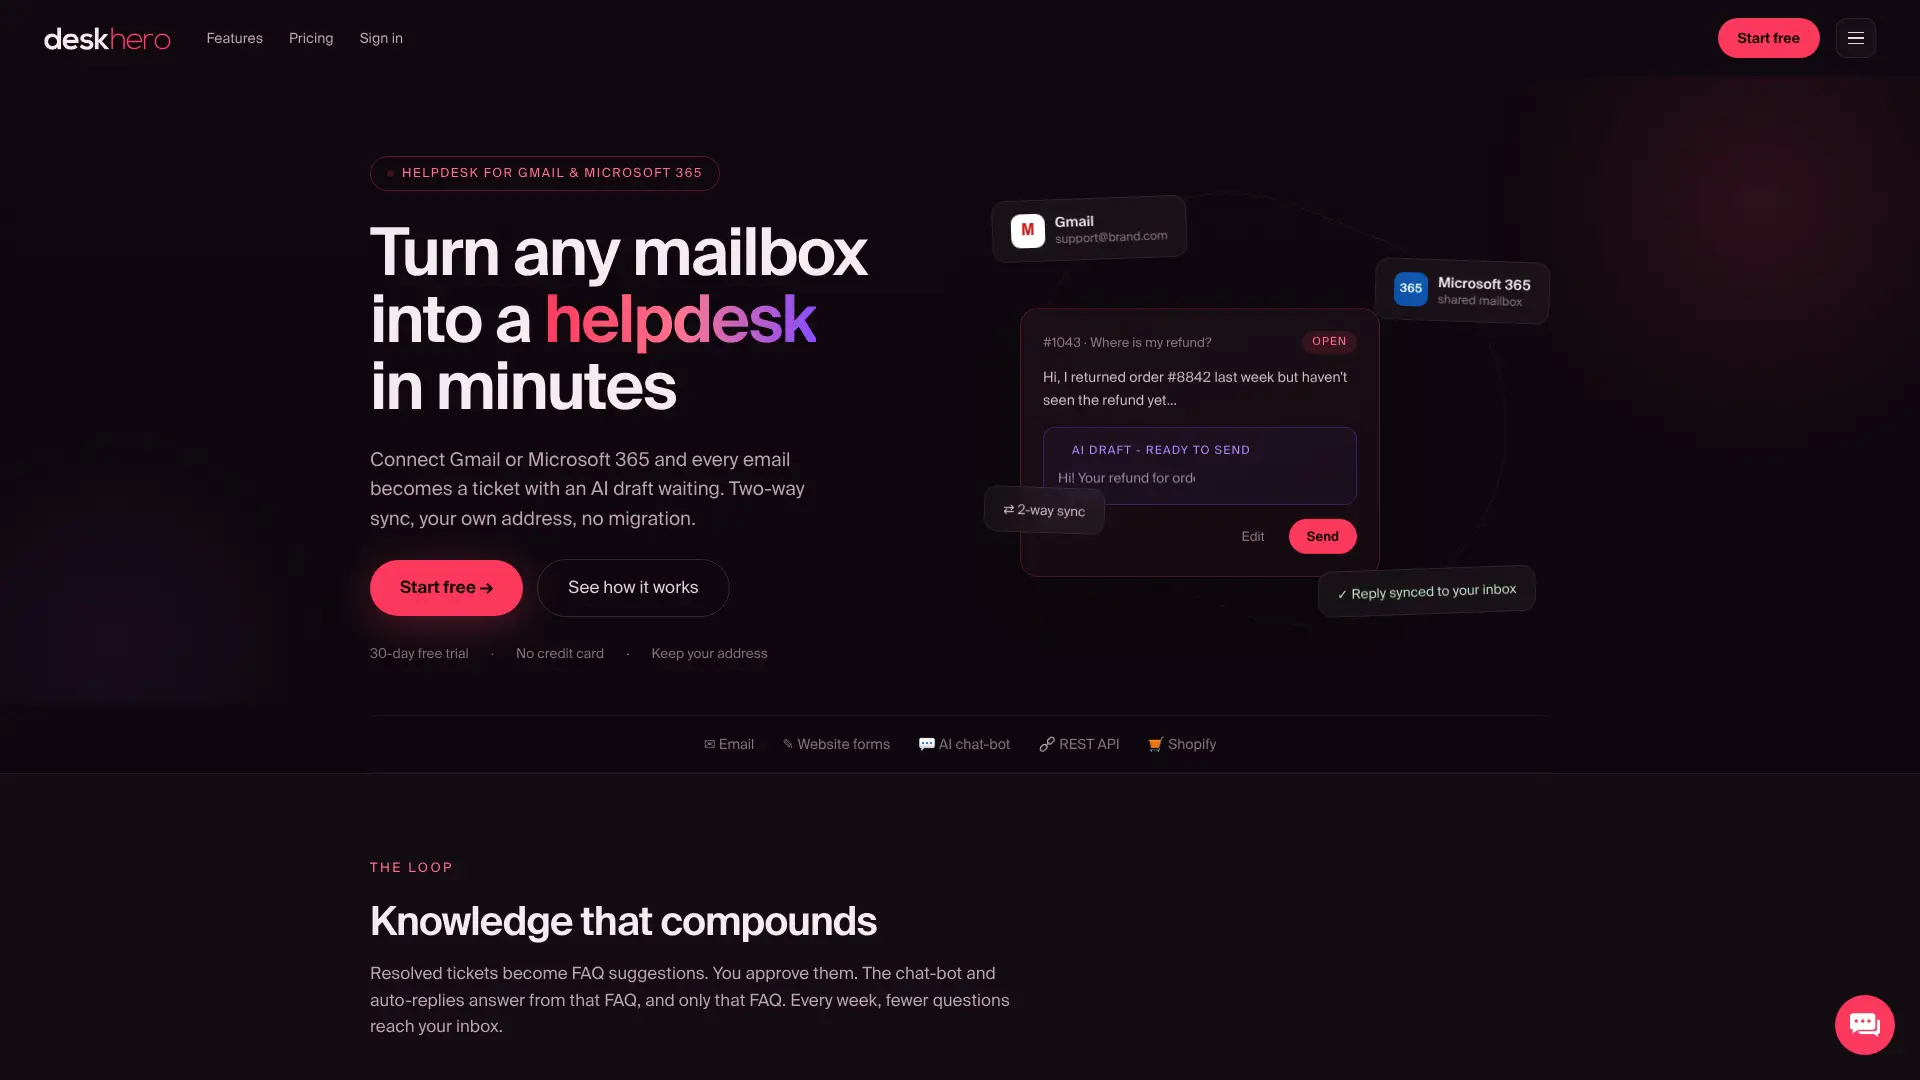
Deskhero föreslår FAQ-poster utifrån lösta ärenden och genomsökta webbsidor. En Användare granskar, redigerar, godkänner eller avstår från varje förslag innan det blir offentligt. Chatboten kräver minst 100 godkända offentliga FAQ-poster. Om den inte kan svara går den över till ett formulär så att en person kan fortsätta konversationen via e-post.
För e-handelsteam använder Shopify-integrationen skrivskyddad åtkomst för att visa kund- och orderinformation i ärendet. Deskhero erbjuder även tvåvägskopplingar till brevlådor för Gmail, Google Workspace och Microsoft 365, så att team kan behålla sin befintliga e-postadress.
Du kan starta en 30 dagars kostnadsfri provperiod utan kreditkort.
Användbara källor
Dessa källor ger vägledning för implementering och forskningssammanhang. Kontrollera dokumentationen för den exakta versionen av det ramverk du använder.
| Källa | Detta behandlas |
|---|---|
| LangChains HITL-dokumentation | Avbrott, granskningsbeslut, beständighet och verktygsspecifik konfiguration av godkännanden |
| inference.sh:s HITL-dokumentation | Godkännandegrindar och varaktig körning i runtime |
| Databricks om system med människa i loopen | Mänsklig feedback, dirigering och operativ utformning |
| IBM: Vad innebär human-in-the-loop? | Definitioner, vanliga användningsområden och överväganden för företag |
| Stanford HAI: Vad innebär human-in-the-loop? | Mänsklig tillsyn och perspektivet där människor har kontrollen |
| Stanford HAI: Humans in the Loop - Design of Interactive AI Systems | Interaktiv AI-design och samarbete mellan människor och AI |
| AAAI: Align When They Want, Complement When They Need | Anpassning, komplementaritet och prestation hos team med människor och AI |
| Harvard Data Science Review: Data Science and Engineering With Human in the Loop | Människans roller inom datavetenskap, teknik och tillsyn |
| PMC: Human-in-the-loop approaches in clinical AI | Kliniska tillämpningar och mänsklig tillsyn |
Vanliga frågor
Vad innebär human-in-the-loop inom AI?
AI med människa i loopen placerar mänsklig indata vid en definierad punkt i en AI-process. En person kan märka data, utvärdera ett resultat, korrigera ett resultat eller godkänna en åtgärd innan den genomförs.
Vad är skillnaden mellan human-in-the-loop och human-on-the-loop?
I vanlig användning kräver HITL mänsklig indata för ett utvalt beslut och pausar ofta det berörda arbetsflödet. Human-on-the-loop beskriver vanligtvis ett system som arbetar medan en person övervakar det och kan ingripa. Terminologin varierar, så en systembeskrivning bör ange den faktiska kontrollen i stället för att enbart förlita sig på benämningen.
Vad innebär human-in-the-loop för AI-agenter?
För AI-system som kan utföra åtgärder innebär HITL ofta att systemet pausar före en utvald åtgärd, visar förslaget och relevant sammanhang för en granskare och endast återupptar körningen efter ett tillåtet beslut. Arbetsflödet bör bevara tillståndet och registrera vad granskaren valde.
Vad innebär human-on-the-loop inom AI?
Human-on-the-loop innebär i allmänhet att ett AI-system arbetar medan en person övervakar resultaten och kan stoppa, korrigera eller åsidosätta det. Det kräver vanligtvis inte godkännande före varje åtgärd.
Hur implementerar Deskhero AI med människa i loopen för supportteam?
Deskhero utformar svar som Användare får granska. Dess chatbot och AI-autosvar är valfria och besvarar endast frågor utifrån den godkända offentliga FAQ:en. Automatiska åtgärder märks och loggas, och obesvarade chattfrågor går över till ett formulär för mänsklig uppföljning via e-post.