Human-in-the-loop-AI: zo werkt het en wanneer je het gebruikt
AI met een mens in de lus (HITL) is een ontwerppatroon waarbij menselijk inzicht op vastgestelde punten wordt ingebouwd in het trainings-, besluitvormings- of uitvoeringsproces van een AI-systeem. Het is vooral nuttig wanneer een geautomatiseerde actie gevolgen kan hebben voor mensen of systemen, wanneer fouten kostbaar zijn om terug te draaien, of wanneer een organisatie duidelijke menselijke verantwoordelijkheid nodig heeft.
In dit artikel leggen we uit hoe HITL werkt, waar het helpt en wat teams moeten ontwerpen voordat ze het in productie gebruiken.
Inhoudsopgave
- Hoe werkt AI met een mens in de lus precies?
- Waarom HITL belangrijk is: nauwkeurigheid, veiligheid en vertrouwen
- Waar wordt HITL toegepast? Voorbeelden uit de praktijk
- Hoe ontwerp je een HITL-systeem voor productie?
- HITL versus Human-on-the-Loop versus Human-over-the-Loop
- Wat zijn de echte uitdagingen van HITL op schaal?
- Een praktische checklist voor het implementeren van HITL-systemen
- Wat zegt recent onderzoek over de toekomst van HITL?
- Belangrijkste punten
- Wat de meeste teams verkeerd begrijpen aan HITL
- Deskhero stelt menselijk toezicht centraal in AI-ondersteuning
- Nuttige bronnen
- Veelgestelde vragen
Hoe werkt AI met een mens in de lus precies?
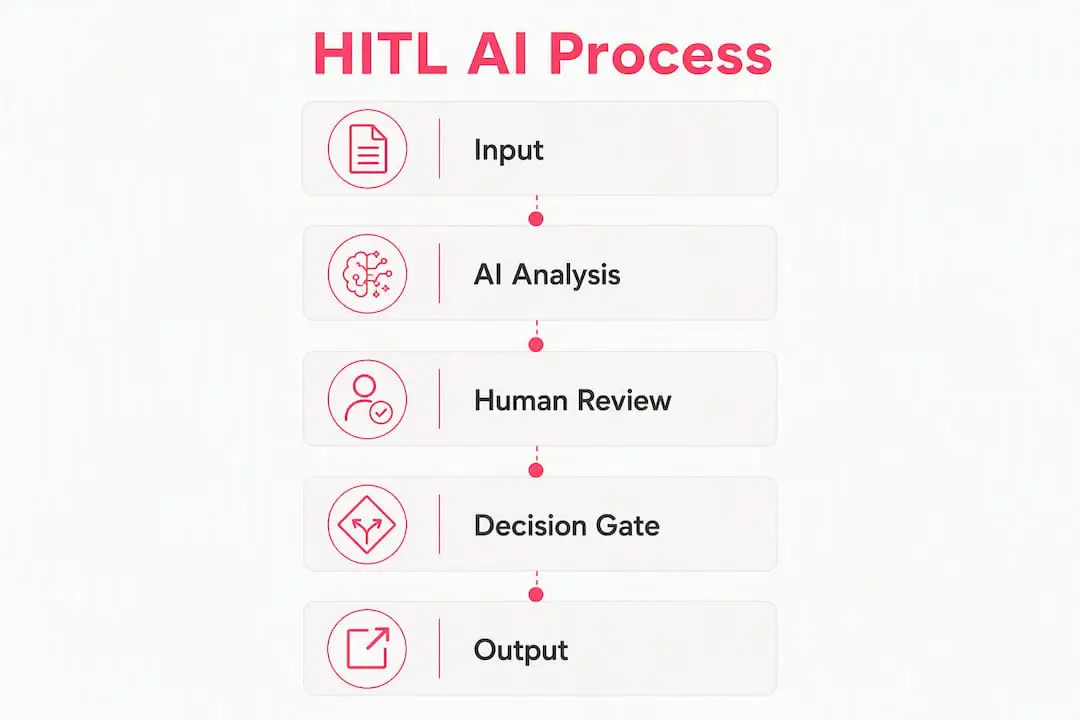
De lus bestaat uit een reeks controlepunten waarop een persoon informatie aanlevert, een uitvoer controleert of een actie autoriseert. Het systeem kan op die invoer wachten, of de invoer verzamelen voor latere evaluatie en modelverbetering.
Mensen nemen doorgaans deel aan twee fasen:
HITL tijdens de trainingsfase omvat het labelen van onbewerkte gegevens, het beoordelen van modeluitvoer en het aanleveren van voorkeurssignalen. Reinforcement learning op basis van menselijke feedback is een bekend voorbeeld. Mensen rangschikken of beoordelen modelreacties, en die beoordelingen worden tijdens de training als signalen gebruikt. Active learning is een ander patroon: een model identificeert onzekere voorbeelden, zodat menselijke labelaars zich kunnen richten op de gevallen die mogelijk de nuttigste informatie opleveren.
HITL tijdens runtime voegt controle toe terwijl een geïmplementeerd systeem actief is. Een systeem kan vóór een gevoelige actie pauzeren, zoals het versturen van een bericht of wijzigen van een record, en iemand vragen de voorgestelde actie goed te keuren, te bewerken of af te wijzen. De LangChain HITL-documentatie beschrijft middleware die geselecteerde toolaanroepen kan onderbreken, de status kan behouden en na een beslissing van een beoordelaar kan hervatten.
Een nuttige runtime-controle laat de beoordelaar zien wat het systeem van plan is te doen, biedt gestructureerde keuzes, legt de beslissing vast en hervat vanuit een opgeslagen status.
Een praktische workflow kan het volgende omvatten:
- Annoteren van gegevens of modeluitvoer met menselijke labels
- Trainen of evalueren van een model met behulp van die beoordeelde voorbeelden
- Implementeren van het model of de AI-workflow
- Onderbreken vóór geselecteerde acties met een hoog risico
- Beslissen of de actie wordt goedgekeurd, bewerkt, afgewezen of op een andere manier behandeld
- Vastleggen van de beslissing als gestructureerde operationele feedback
Synchrone controles stoppen de betreffende workflow totdat een beoordelaar handelt. Asynchrone ontwerpen kunnen ervoor zorgen dat niet-gerelateerd werk doorgaat terwijl de beslissing uitstaat. In beide gevallen hebben langlopende workflows een persistente status nodig. De runtime-documentatie van inference.sh is een voorbeeld van een systeem dat goedkeuringscontroles en persistente uitvoering hiervoor beschrijft.
Goedkeuringsregels kunnen breed of selectief zijn. Een team kan controle verplicht stellen voor elk gebruik van een gevoelige tool, of alleen wanneer een bedrag, ontvanger, betrouwbaarheidsscore of andere voorwaarde een drempel overschrijdt. Selectieve routering kan onnodige controles verminderen zonder het toezicht op acties die dit nodig hebben weg te nemen.
Waarom HITL belangrijk is: nauwkeurigheid, veiligheid en vertrouwen
Menselijk toezicht kan een AI-workflow op drie praktische manieren verbeteren.
Betere omgang met uitzonderlijke gevallen. Modellen kunnen moeite hebben met ongebruikelijke invoer of veranderende omstandigheden. Een beoordelaar kan een uitzondering herkennen en het voorgestelde resultaat corrigeren. Als de correctie op de juiste manier wordt vastgelegd en beheerd, kan deze later bijdragen aan evaluatie of modelverbetering. Een correctie verbetert een model niet automatisch; het team heeft nog steeds een doelgerichte feedbackpipeline nodig.
Veiligere acties. Een AI-systeem dat berichten kan versturen, records kan bijwerken of transacties kan verwerken, kan schade veroorzaken wanneer het invoer verkeerd interpreteert. Een controle kan dat risico verkleinen door geselecteerde acties te stoppen voordat ze plaatsvinden. Databricks bespreekt menselijke controle bij beslissingen met grotere impact en de waarde van het terugvoeren van feedback naar het systeem.
Grotere verantwoordelijkheid. Een goed geïnstrumenteerde HITL-workflow kan vastleggen wie een actie heeft beoordeeld, wat die persoon heeft besloten en wat er daarna gebeurde. Deze registraties helpen bij incidentonderzoek, kwaliteitscontrole en naleving. Een oppervlakkige goedkeuringsstap is niet voldoende. De beoordeling moet genoeg context, tijd en bevoegdheid bieden om de uitkomst te wijzigen.
Menselijke feedback is het nuttigst wanneer deze wordt behandeld als beheerde operationele data. Teams moeten bepalen hoe beslissingen worden opgeslagen, wie er toegang toe heeft, hoe lang ze worden bewaard en of ze worden gebruikt voor evaluatie, hertraining of geen van beide.
Waar wordt HITL toegepast? Voorbeelden uit de praktijk
Dit patroon komt in veel sectoren voor, maar de verantwoordelijkheid van de beoordelaar verandert per domein.
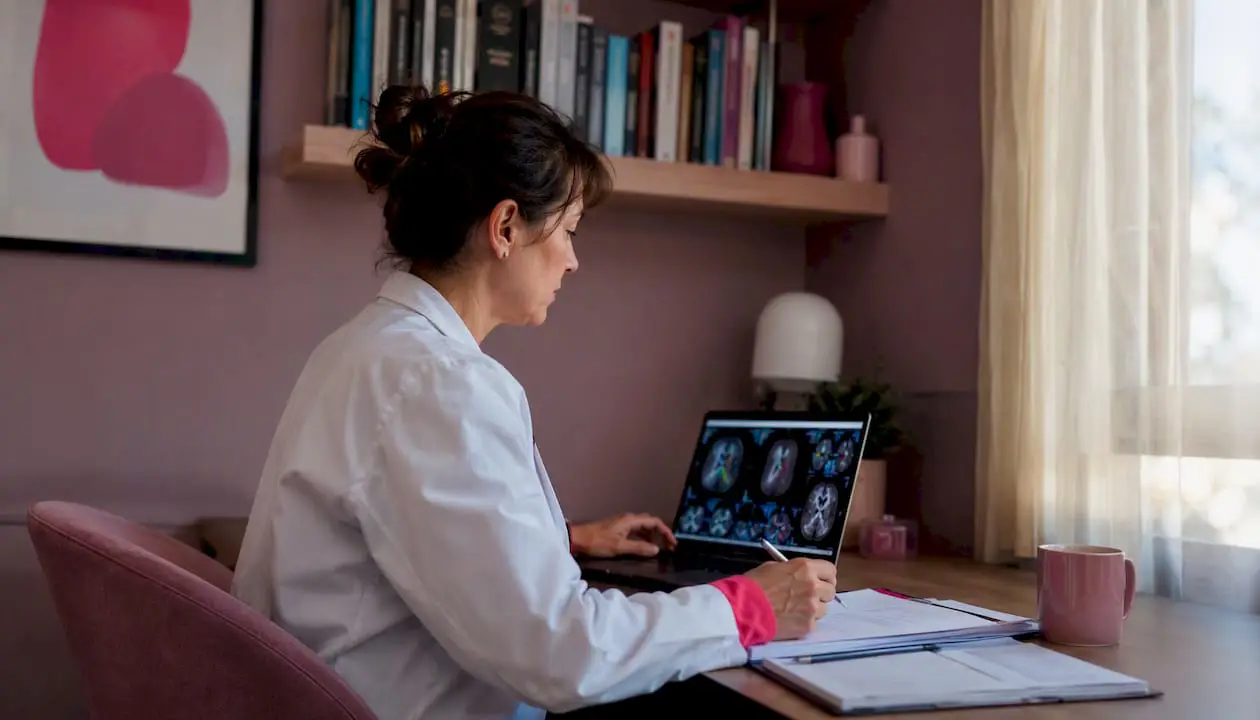
Medische beeldvorming. Een arts kan een door AI gemarkeerd beeld beoordelen voordat het resultaat wordt gebruikt voor diagnose of behandeling. Het juiste toezicht hangt af van het hulpmiddel, het beoogde gebruik en de toepasselijke klinische en wettelijke vereisten. AI-uitvoer mag niet worden omschreven als vervanging van gekwalificeerd medisch oordeel.
Contentmoderatie. Een classifier kan mogelijk overtredende content markeren en onzekere of gevoelige gevallen naar een menselijke beoordelaar sturen. Mensen behandelen context en beroepzaken, terwijl automatisering helpt het volume te beheren. Consistente richtlijnen en kalibratie van beoordelaars zijn belangrijk, omdat beoordelingsbeslissingen later als trainings- of evaluatiegegevens kunnen worden gebruikt.
Klantenservice. AI kan een antwoord opstellen dat een User beoordeelt. Systemen met toestemming om berichten te versturen of accountgegevens te wijzigen, hebben aanvullende controles rond die acties nodig. Een team kan goedkeuring verplicht stellen op basis van het type actie, de impact ervan en hoe eenvoudig deze kan worden teruggedraaid. Zie voor meer achtergrond het artikel van Deskhero over AI in klantenservice.
Fraudeonderzoek. Een model kan transacties een score geven en geselecteerde gevallen naar een analist routeren. De analist houdt rekening met context die mogelijk niet in de modelinvoer is opgenomen en neemt de beslissing die het beleid van de organisatie vereist.
Datapipelines voor labeling. Menselijke labelaars of domeinexperts annoteren afbeeldingen, tekst of audio voor supervised training en evaluatie. Kwaliteitscontroles, duidelijke instructies en overeenstemmingsmetingen zijn belangrijk, omdat onnauwkeurige labels de modelkwaliteit kunnen verminderen.
Pro-tip: Breng de acties die een systeem kan uitvoeren in kaart voordat je een controlebeleid kiest. Richt verplichte controle op acties met een grote impact, acties die moeilijk terug te draaien zijn of acties waarvoor specifieke verantwoordingsvereisten gelden.
Hoe ontwerp je een HITL-systeem voor productie?
Een HITL-ontwerp voor productie heeft meer nodig dan een controleknop. Het moet rekening houden met persistente status, routering naar beoordelaars, time-outs, toegangsbeheer en de kwaliteit van feedback.
Duurzame uitvoering en persistente status
Een onderbreekbare workflow moet voldoende status behouden om na een beslissing veilig te kunnen hervatten. Opslag in het geheugen kan volstaan voor een lokale test, maar is kwetsbaar wanneer een beoordeling uren kan duren of een service opnieuw kan opstarten. Kies een ondersteunde duurzame opslag voor de runtime die je gebruikt en test vóór de lancering het herstel na storingen.
Patronen voor goedkeuringscontroles
| Type controle | Wanneer gebruiken | Afweging |
|---|---|---|
| Goedkeuring per tool | Geselecteerde gevoelige acties | Precieze controle; meer configuratie |
| Globale goedkeuring | Elke actie in een strikt gecontroleerde workflow | Eenvoudig beleid; kan een grote wachtrij voor beoordelingen veroorzaken |
| Voorwaardelijke goedkeuring | Beoordeling op basis van een bedrag, ontvanger of risicosignaal | Selectief; geteste logica voor regels vereist |
| Geordende beoordelingswachtrij | Meerdere afhankelijke beslissingen binnen één uitvoering | Behoudt de volgorde; kan vertraging toevoegen |
Routering en escalatie
Bepaal wie elke categorie beslissingen beoordeelt. Voor sommige gevallen is een domeinexpert nodig, terwijl andere naar een getrainde algemene beoordelaar kunnen gaan. Stel een beoogde responstijd en een veilige terugvaloptie in voor gemiste beoordelingen. Afhankelijk van het risico kan de workflow gepauzeerd blijven, naar een andere beoordelaar worden geëscaleerd of stoppen zonder de actie uit te voeren.
Auditlogs en gebruikersinterface voor beoordelaars
De interface moet beoordelaars helpen geïnformeerde beslissingen te nemen. Toon de voorgestelde actie, relevante broninformatie, bekende onzekerheden en de gevolgen van goedkeuring. Gestructureerde keuzes kunnen latere analyse eenvoudiger maken, maar beoordelaars moeten ook kunnen uitleggen waarom ze iets hebben bewerkt of afgewezen wanneer die context belangrijk is.
Pro-tip: Behandel de beoordelingsinterface zowel als veiligheidscontrole als hulpmiddel voor datakwaliteit. Leg alleen informatie vast waarvoor je een duidelijk omschreven gebruiksdoel hebt.
Voor de overdracht van chatbot naar medewerker moet je de gesprekscontext behouden, vastleggen waarom de automatisering is gestopt en het resulterende verzoek naar de juiste User of wachtrij routeren.
HITL versus Human-on-the-Loop versus Human-over-the-Loop
Deze termen worden niet in elk vakgebied op dezelfde manier gebruikt. De volgende verschillen vormen een praktisch kader, geen universele definities.
| Term | Typische timing | Rol van de mens | Blokkeert dit doorgaans de uitvoering? | Veelvoorkomend gebruik |
|---|---|---|---|---|
| Human-in-the-loop (HITL) | Voor of tijdens een geselecteerde beslissing | Levert invoer, goedkeuring of correctie | Vaak | Beslissingen met een hoger risico en feedback voor training |
| Human-on-the-loop (HOTL) | Tijdens de uitvoering | Monitort en kan ingrijpen | Meestal niet | Activiteiten met een hoger volume die eenvoudiger terug te draaien zijn |
| Human-over-the-loop | Gedurende de gehele levenscyclus van het systeem | Stelt beleid vast en auditeert resultaten | Nee | Governance en toezicht op systeemniveau |
Passieve monitoring verschilt van een controle die goedkeuring vóór een actie vereist. Veel systemen combineren verschillende toezichtsniveaus. Ze kunnen directe goedkeuring vereisen voor gevoelige schrijfacties, uitvoer met een lager risico monitoren en periodieke governancebeoordelingen gebruiken voor beleid en systeemprestaties.
Stanford HAI beschrijft een perspectief waarin mensen de leiding hebben en dat betekenisvolle menselijke controle benadrukt. Deze benadering verschuift de aandacht naar bevoegdheid, controleerbaarheid en bruikbare beoordelingsworkflows, in plaats van alleen te tellen hoe vaak een persoon het proces aanraakt.
Vragen die helpen bij het kiezen van een aanpak zijn:
- Kan de actie iemand schaden of een moeilijk terug te draaien wijziging veroorzaken? Overweeg een blokkerende menselijke beslissing.
- Kan het resultaat worden gemonitord en snel worden gecorrigeerd? Monitoring met een escalatiepad kan voldoende zijn.
- Is er sprake van een gereguleerde beslissing of een beslissing waarvoor verantwoording moet worden afgelegd? Koppel de controle aan de daadwerkelijke vereiste en documenteer wie ervoor verantwoordelijk is.
- Heeft de activiteit een laag risico en is deze goed begrepen? Automatisering met monitoring kan na tests passend zijn.
Wat zijn de echte uitdagingen van HITL op schaal?
HITL introduceert kosten en mogelijke fouten die tijdens het ontwerp moeten worden aangepakt.
Schaalbaarheid. Blokkerende goedkeuringen voegen vertraging toe en vereisen menselijke capaciteit. Als elke actie naar dezelfde wachtrij gaat, kan beoordeling de bottleneck worden. Risicogestuurde routering kan de meest intensieve beoordeling reserveren voor onzekere gevallen of gevallen met een grote impact.
Vooringenomenheid en gecorreleerde fouten. Een model dat op menselijke correcties is getraind, kan menselijke vooroordelen overnemen. Een beoordelaar kan ook te snel meegaan in een model dat zelfverzekerd lijkt. Onderzoek naar afstemming en complementariteit in mens-AI-teams onderzoekt wanneer een model menselijke voorkeuren moet volgen en wanneer verschillende sterke punten de teamprestaties kunnen verbeteren. Diverse beoordelingen, kalibratie en overeenstemmingscontroles kunnen helpen systematische verschillen zichtbaar te maken.
Privacy en datagovernance. Beoordelaars kunnen persoonlijke, financiële, medische of vertrouwelijke informatie zien. Beperk de toegang tot wat een beoordelaar nodig heeft, bescherm gegevens tijdens overdracht en opslag en bepaal beleid voor bewaartermijnen en hergebruik voordat je beoordelingsregistraties verzamelt.
Menselijke vermoeidheid en inconsistentie. Herhaalde beoordelingen kunnen leiden tot overhaaste beslissingen en veranderende normen. Nuttige maatregelen zijn:
- Stel werklasten vast die aansluiten bij de complexiteit van de taak
- Voer kalibratieoefeningen uit met dezelfde voorbeeldgevallen
- Meet overeenstemming wanneer de taak een verdedigbare referentiestandaard heeft
- Wissel werkzaamheden af wanneer dit de domeinexpertise niet vermindert
- Monitor ongebruikelijke veranderingen in patronen van goedkeuring, bewerking of afwijzing
Kosten. Menselijke beoordeling kost tijd en specialistische aandacht. Vergelijk die kosten met de verwachte kosten en waarschijnlijkheid van de fouten die de controle moet voorkomen. Een controle die alles beoordeelt, kan meer kosten terwijl deze weinig extra bescherming biedt.
Een praktische checklist voor het implementeren van HITL-systemen
Loop deze vragen in de onderstaande volgorde door voordat je een HITL-workflow implementeert.
- Risicobeoordeling. Noteer welke acties het systeem kan uitvoeren. Deel ze in op basis van impact, omkeerbaarheid en verantwoordingsvereisten.
- Definitie van beoordelaars. Bepaal wie elke actie mag beoordelen en welke informatie en bevoegdheid daarvoor nodig zijn.
- Interfaceontwerp. Toon voldoende context voor een echte beslissing. Definieer waar relevant paden voor goedkeuring, bewerking, afwijzing en escalatie.
- Strategie voor persistente opslag. Sla de status op die nodig is om veilig te hervatten en test herstarts en dubbele beslissingen.
- Feedbackplan. Bepaal of beoordelingsregistraties bedoeld zijn voor audits, evaluatie, hertraining of een combinatie daarvan. Ga er niet van uit dat ze voor elk doel geschikt zijn.
- Governance. Wijs verantwoordelijkheid toe voor beoordelingskwaliteit, toegang, bewaartermijnen, routeringsregels en wijzigingen in controles.
Nuttige statistieken kunnen zijn:
- Beoordelingspercentage: het aandeel van de in aanmerking komende acties dat ter beoordeling wordt verzonden
- Tijd tot beslissing: de vertraging tussen onderbreking en voltooide beoordeling
- Verdeling van beslissingen: het aandeel dat wordt goedgekeurd, bewerkt, afgewezen of geëscaleerd
- Foutuitkomsten: de problemen die door beoordeling worden onderschept en de problemen die ondanks beoordeling worden gemist
- Overeenstemming tussen beoordelaars: consistentie bij steekproefgevallen waarbij vergelijking zinvol is
Verminder beoordelingen pas nadat je echte uitkomsten hebt onderzocht. Als een categorie consequent wordt goedgekeurd, test dan onder monitoring een nauwer beleid. Als een categorie consequent wordt afgewezen, verbeter dan het model of voorkom die actie in plaats van meer beoordelaars toe te voegen.
Wat zegt recent onderzoek over de toekomst van HITL?
Recent onderzoek richt zich steeds vaker op de vraag hoe menselijke deelname nuttiger kan worden gemaakt, in plaats van simpelweg meer beoordelingen toe te voegen.
Onderzoek naar afgestemde en complementaire modellen suggereert dat sterke mens-AI-teams beide nodig kunnen hebben. Een model dat iemands oordeel weerspiegelt, kan voorspelbaar zijn, terwijl een model met andere sterke punten iets kan signaleren wat de persoon heeft gemist. Het juiste ontwerp hangt af van de taak, het beschikbare bewijs en de manier waarop meningsverschillen worden opgelost.
Het perspectief waarin mensen de leiding hebben, moedigt teams ook aan te vragen of mensen daadwerkelijk betekenisvolle bevoegdheid hebben. Een beoordelaar die context, tijd of de macht om een actie te stoppen mist, is geen effectieve veiligheidscontrole, zelfs niet wanneer de workflow een goedkeuring registreert.
Patronen die het evalueren waard zijn:
- Goedkeuringen op basis van onderbrekingen voor geselecteerde acties met duurzame uitvoering
- Gestructureerde beoordelingsformulieren die beslissingen en nuttige redenen vastleggen
- Risicogestuurde routering die modelsignalen combineert met de gevolgen van een actie
- Complementariteitstests die meten of een persoon en een model samen beter presteren dan ieder afzonderlijk
Een nuttig experiment is om beoordelingsuitkomsten te groeperen op actietype en risicoklasse. Bekijk percentages voor goedkeuring, bewerking, afwijzing, incidenten en vertraging. Het resultaat kan laten zien waar beoordeling betekenisvolle problemen onderschept en waar deze alleen vertraging toevoegt.
Pro-tip: Optimaliseer niet alleen voor het goedkeuringspercentage. Een hoog goedkeuringspercentage kan wijzen op een betrouwbare categorie, gebrekkige controle of een controle die op het verkeerde werk is gericht. Vergelijk goedkeuringen met fouten en uitkomsten verderop in de keten.
Belangrijkste punten
AI met een mens in de lus is het waardevolst wanneer de menselijke beslissing gekoppeld is aan een duidelijk risico, wordt ondersteund door nuttige context en voor een vastgesteld doel wordt vastgelegd.
| Punt | Details |
|---|---|
| HITL kan training en runtimecontrole ondersteunen | Menselijke input kan gegevens labelen, uitvoer evalueren of geselecteerde acties controleren. |
| Risicogestuurde routering helpt kosten beheersen | Richt blokkerende beoordeling op acties waarvan de impact de vertraging en inspanning rechtvaardigt. |
| Duurzame status ondersteunt betrouwbare onderbrekingen | Een workflow voor productie moet herstarts en lange beoordelingsvertragingen kunnen doorstaan. |
| Betekenisvolle bevoegdheid is belangrijk | Beoordelaars hebben context, tijd en de mogelijkheid nodig om de uitkomst te wijzigen of te stoppen. |
| Deskhero houdt automatische supportfuncties onder controle | De chatbot en AI-automatische antwoorden gebruiken goedgekeurde openbare FAQ-content, zijn opt-in en sturen onbeantwoorde vragen door naar mensen. |
Wat de meeste teams verkeerd begrijpen aan HITL
Een beoordelingsstap kan verantwoordelijk lijken en toch weinig bescherming bieden. Als beoordelaars context missen, uit gewoonte goedkeuren of het systeem niet ter discussie kunnen stellen, heeft de organisatie een wachtrij gecreëerd in plaats van betekenisvol toezicht.
De controle moet gekoppeld zijn aan een specifiek doel. Als de controle schadelijke acties moet voorkomen, meet dan wat deze onderschept en wat er toch doorheen komt. Als beoordelingsgegevens voor modelverbetering worden gebruikt, leg dan vast waarom een uitvoer is bewerkt en beoordeel of de labels consistent genoeg zijn voor dat gebruik.
Teams moeten ook onderscheid maken tussen het verminderen van onnodige beoordelingen en het verzwakken van menselijke bevoegdheid. Volwassen systemen kunnen goed begrepen categorieën met een laag risico automatiseren en mensen tegelijkertijd betere hulpmiddelen en duidelijkere escalatiebevoegdheden geven voor de beslissingen die overblijven.
HITL is daarom net zo goed een organisatorische vaardigheid als een technische functie. Bezetting, beleid, training, interfaceontwerp en datagovernance bepalen of de lus werkt.
Deskhero stelt menselijk toezicht centraal in AI-ondersteuning
Deskhero past verschillende principes van menselijk toezicht toe op klantenservice. Het kan antwoorden opstellen die Users kunnen beoordelen. De klantgerichte chatbot en AI-automatische antwoorden beantwoorden uitsluitend vragen op basis van de goedgekeurde openbare FAQ van de workspace. Beide automatische functies zijn opt-in en automatische acties worden gelabeld en geregistreerd.
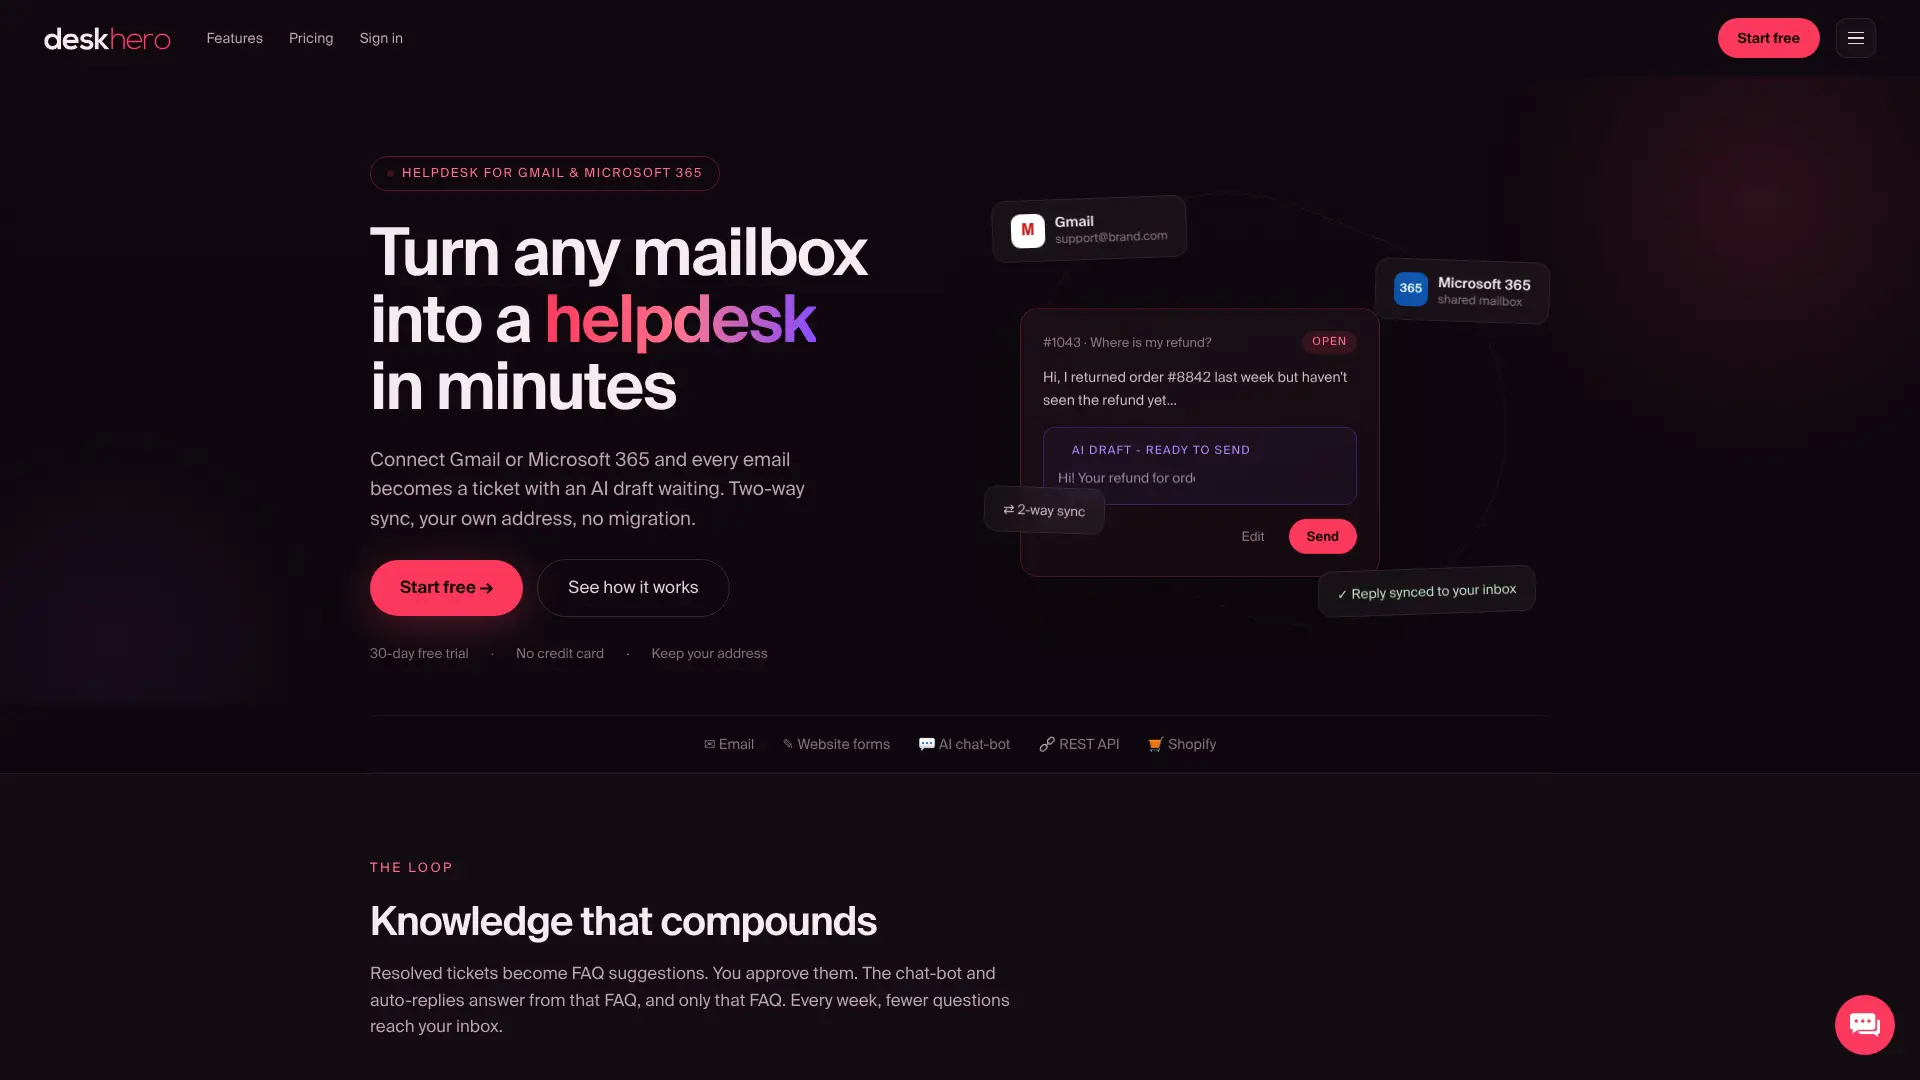
Deskhero stelt FAQ-items voor op basis van opgeloste tickets en gescrapete webpagina's. Een User beoordeelt, bewerkt, keurt goed of weigert elke suggestie voordat deze openbaar wordt. Voor de chatbot zijn minimaal 100 goedgekeurde openbare FAQ-items vereist. Als de chatbot geen antwoord kan geven, valt deze terug op een formulier, zodat een persoon het gesprek per e-mail kan voortzetten.
Voor e-commerce-teams gebruikt de Shopify-integratie alleen-leestoegang om klant- en orderinformatie in het ticket te tonen. Deskhero biedt ook tweerichtingsverbindingen met mailboxen voor Gmail, Google Workspace en Microsoft 365, zodat teams hun bestaande e-mailadres kunnen behouden.
Je kunt zonder creditcard een gratis proefperiode van 30 dagen starten.
Nuttige bronnen
Deze bronnen bieden implementatierichtlijnen en onderzoekscontext. Raadpleeg de documentatie voor de exacte versie van elk framework dat je gebruikt.
| Bron | Wat de bron behandelt |
|---|---|
| LangChain HITL-documentatie | Onderbrekingen, beoordelingsbeslissingen, persistentie en tool-specifieke configuratie van goedkeuringen |
| inference.sh HITL-documentatie | Goedkeuringscontroles en duurzame runtime-uitvoering |
| Databricks over systemen met een mens in de lus | Menselijke feedback, routering en operationeel ontwerp |
| IBM: Wat is human-in-the-loop? | Definities, veelvoorkomende toepassingen en aandachtspunten voor ondernemingen |
| Stanford HAI: Wat is human-in-the-loop? | Menselijk toezicht en het perspectief waarin mensen de leiding hebben |
| Stanford HAI: Humans in the Loop - Design of Interactive AI Systems | Interactief AI-ontwerp en samenwerking tussen mens en AI |
| AAAI: Align When They Want, Complement When They Need | Afstemming, complementariteit en prestaties van mens-AI-teams |
| Harvard Data Science Review: Data Science and Engineering With Human in the Loop | Menselijke rollen in datawetenschap, engineering en toezicht |
| PMC: Human-in-the-loop approaches in clinical AI | Klinische toepassingen en menselijk toezicht |
Veelgestelde vragen
Wat betekent human-in-the-loop in AI?
AI met een mens in de lus plaatst menselijke input op een vastgesteld punt in een AI-proces. Een persoon kan gegevens labelen, uitvoer evalueren, een resultaat corrigeren of een actie goedkeuren voordat deze plaatsvindt.
Wat is het verschil tussen human-in-the-loop en human-on-the-loop?
In het algemeen vereist HITL menselijke input voor een geselecteerde beslissing en wordt de betreffende workflow vaak gepauzeerd. Human-on-the-loop verwijst doorgaans naar een systeem dat actief is terwijl een persoon het monitort en kan ingrijpen. De terminologie verschilt, dus een systeembeschrijving moet de daadwerkelijke controle benoemen in plaats van alleen op het label te vertrouwen.
Wat betekent human-in-the-loop voor AI-agents?
Voor AI-systemen die acties kunnen uitvoeren, betekent HITL vaak dat het systeem vóór een geselecteerde actie pauzeert, het voorstel en de relevante context aan een beoordelaar toont en pas na een toegestane beslissing hervat. De workflow moet de status behouden en vastleggen wat de beoordelaar heeft gekozen.
Wat betekent human-on-the-loop in AI?
Human-on-the-loop betekent doorgaans dat een AI-systeem actief is terwijl een persoon de resultaten monitort en het systeem kan stoppen, corrigeren of overrulen. Meestal is geen goedkeuring vóór elke actie vereist.
Hoe implementeert Deskhero AI met een mens in de lus voor supportteams?
Deskhero stelt antwoorden op die Users kunnen beoordelen. De chatbot en AI-automatische antwoorden zijn opt-in en beantwoorden vragen uitsluitend op basis van de goedgekeurde openbare FAQ. Automatische acties worden gelabeld en geregistreerd, en onbeantwoorde chatvragen vallen terug op een formulier voor menselijke opvolging per e-mail.