Le metriche essenziali dell’helpdesk per i responsabili del supporto
I report più utili dell’helpdesk collegano domanda, velocità, qualità e affidabilità. Inizia con volume dei ticket, tempo di prima risposta, tempo di risoluzione, risoluzione al primo contatto, rispetto degli SLA, anzianità dell’arretrato, tasso di riapertura, tasso di escalation, carico di lavoro per User, mix dei canali e costo per ticket. Aggiungi le metriche di soddisfazione del cliente solo quando disponi di un processo di sondaggio affidabile e di un numero sufficiente di risposte per interpretarle responsabilmente.
Una cadenza pratica per la reportistica è la seguente:
- Volume dei ticket: fotografia giornaliera e andamento settimanale
- Tempo di prima risposta: andamento giornaliero, oltre al monitoraggio SLA in tempo reale dove applicabile
- Tempo di risoluzione: andamento giornaliero e revisione settimanale
- Risoluzione al primo contatto: settimanale
- Rispetto degli SLA: vista operativa giornaliera e riepilogo settimanale
- Anzianità dell’arretrato: giornaliera
- Tassi di riapertura ed escalation: settimanali
- Carico di lavoro per User: giornaliero per bilanciare le code
- Mix dei canali: settimanale
- Costo per ticket: mensile
Non iniziare monitorando tutto. Scegli una scorecard ridotta, verifica che i timestamp e i campi sottostanti siano affidabili e aggiungi dettagli solo quando aiutano qualcuno a prendere una decisione.
Punti chiave
Una reportistica affidabile dell’helpdesk inizia con dati degli eventi puliti, formule definite chiaramente e un processo di revisione che termina con un responsabile e un’azione.
| Punto | Dettagli |
|---|---|
| Separa metriche e KPI | Una metrica descrive un’attività. Un KPI è una metrica con un obiettivo, un responsabile e una decisione associata. |
| Usa le distribuzioni, non solo le medie | Affianca alle medie mediane, percentili o intervalli temporali, così un numero ridotto di ticket lenti non può nascondere l’esperienza tipica. |
| I benchmark hanno bisogno di contesto | Considera la tua baseline, il mix dei canali, la complessità dei ticket, il personale e gli impegni di servizio prima di stabilire gli obiettivi. |
| La qualità dei dati viene prima di tutto | Definisci quali eventi avviano, mettono in pausa e concludono ogni orologio prima di pubblicare un punteggio. |
| Deskhero include viste di reportistica fisse | Deskhero offre una Dashboard operativa e un’area Statistics con nove schede fisse, filtri, viste a grafico e tabella ed esportazione in Excel nella maggior parte delle schede. |
Indice
- Qual è la differenza tra una metrica dell’helpdesk e un KPI?
- Le principali metriche di reportistica dell’helpdesk, raggruppate per obiettivo
- Come stabilire obiettivi e benchmark realistici per il tuo team
- Come progettare dashboard che ogni pubblico utilizzerà davvero
- Come assicurarti che i dati siano corretti prima di elaborarli nei report
- Le insidie della reportistica che rendono fuorvianti le metriche
- Un modello di dashboard pronto per l’uso che puoi copiare oggi
- Dove la reportistica ripaga davvero
- Deskhero ti offre dati pronti per la reportistica fin dal primo giorno
- Fonti
- FAQ
Qual è la differenza tra una metrica dell’helpdesk e un KPI?
Una metrica è qualsiasi valore misurato, come i ticket creati, il tempo mediano di prima risposta o il numero di ticket aperti. Un KPI è una metrica selezionata per rappresentare un risultato importante. Ha una definizione, un obiettivo o un intervallo accettabile, un responsabile e una risposta prevista quando la performance esce da quell’intervallo.
Il volume dei ticket è solitamente una metrica diagnostica. Descrive la domanda, ma non indica se il team ha lavorato bene. Il rispetto dello SLA relativo alla prima risposta può essere un KPI perché misura la performance rispetto a un impegno dichiarato. Anche in questo caso, dovrebbe essere letto insieme ai dati sulla qualità e sul carico di lavoro.
Una distinzione utile è:
- Metriche diagnostiche: volume dei ticket, mix dei canali, mix delle priorità, mix delle categorie e composizione dell’arretrato
- Possibili KPI: tempo di prima risposta, tempo di risoluzione, rispetto degli SLA, risoluzione al primo contatto, tasso di riapertura e soddisfazione del cliente
La classificazione dipende da ciò che l’organizzazione sta cercando di migliorare. Una metrica dei costi può essere centrale per un’attività di supporto e irrilevante per un’altra. Scrivi la decisione prevista accanto a ogni KPI. Se nessuno sa spiegare quale azione dovrebbe innescare un cambiamento, probabilmente la metrica appartiene invece a una vista diagnostica.
Consiglio professionale: Documenta ogni KPI in una frase: formula, popolazione, intervallo temporale, esclusioni, responsabile e obiettivo. In questo modo eviti che due team usino la stessa etichetta per calcoli diversi.
Le principali metriche di reportistica dell’helpdesk, raggruppate per obiettivo
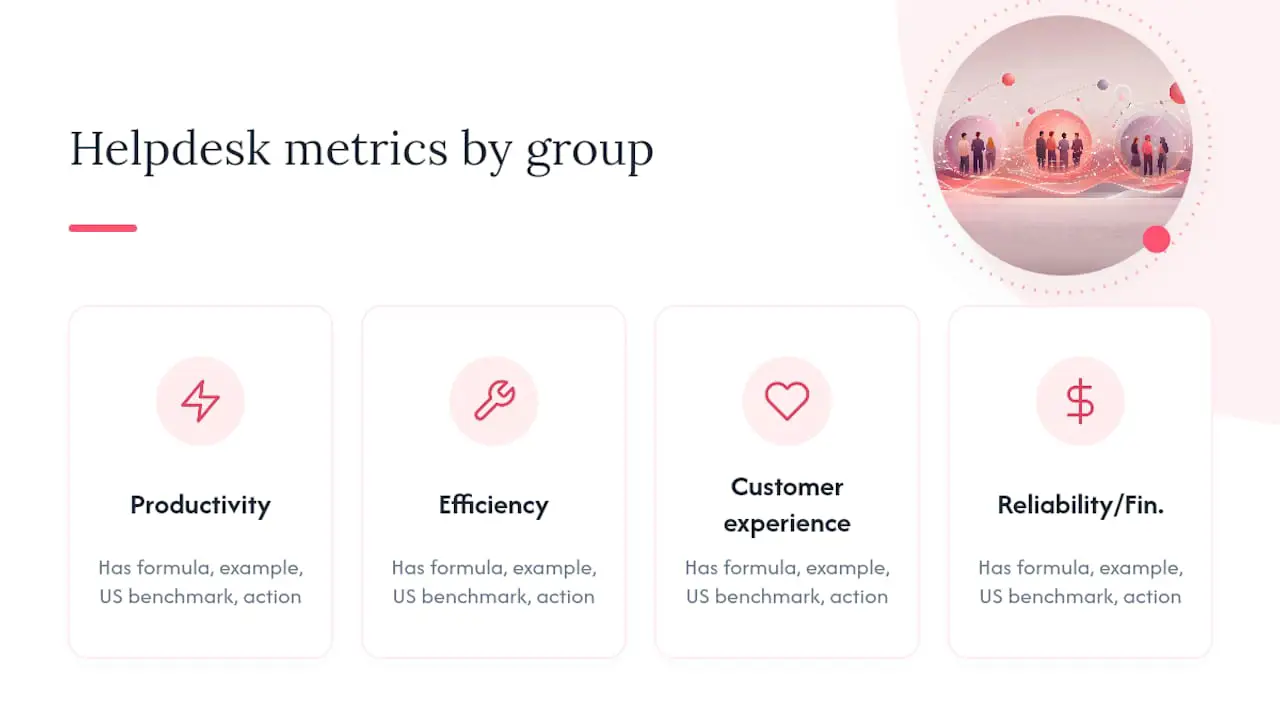
Raggruppa le metriche in base alla domanda a cui rispondono. Le metriche della domanda descrivono ciò che è entrato nella coda. Le metriche dell’efficienza mostrano come è avanzato il lavoro. Le metriche dell’esperienza riflettono il feedback dei clienti. Le metriche dell’affidabilità mostrano se gli impegni sono stati rispettati. Le metriche finanziarie collegano l’attività di supporto ai costi.
Metriche della produttività
Volume dei ticket
Definizione: Ticket creati durante un periodo di reportistica.
Formula: Conta i ticket in base al timestamp di creazione all’interno del periodo selezionato.
Utilizzo: Confronta il volume per giorno, canale, gruppo, priorità e categoria. Analizza i picchi prima di modificare il personale.
Volume risolto
Definizione: Ticket risolti durante il periodo.
Utilizzo: Confronta il volume creato e quello risolto nello stesso intervallo. Se il volume creato supera ripetutamente quello risolto, è probabile che l’arretrato cresca.
Carico di lavoro per User
Definizione: Ticket assegnati, gestiti o risolti da ciascun User, a seconda della domanda.
Utilizzo: Bilancia le code e individua la concentrazione del lavoro. Non trasformare un singolo conteggio del carico di lavoro in una classifica delle performance senza considerare complessità, disponibilità e qualità.
Suddivisione per canale
Definizione: La percentuale di ticket creati attraverso ciascun canale.
Formula: Ticket provenienti da un canale divisi per tutti i ticket del periodo.
Utilizzo: Allinea il personale e gli obiettivi di servizio alla domanda effettiva.
Metriche dell’efficienza
Tempo di prima risposta
Definizione: Tempo dalla creazione del ticket alla prima risposta umana o automatica qualificante, secondo la tua policy di reportistica.
Utilizzo: Riporta mediana, 90° percentile e intervalli temporali. Specifica se l’orologio utilizza il tempo di calendario o le ore lavorative e se le conferme automatiche vengono conteggiate.
Tempo di risoluzione
Definizione: Tempo dalla creazione del ticket alla risoluzione.
Utilizzo: Segmenta per gruppo, priorità, categoria e stato di escalation. Se l’orologio si mette in pausa mentre aspetti il cliente, documenta questa regola.
Risoluzione al primo contatto
Definizione: La percentuale di ticket idonei risolti durante la prima interazione con il supporto, senza un successivo follow-up o una riapertura entro la finestra di osservazione scelta.
Utilizzo: Definisci la finestra di osservazione e i canali idonei prima di confrontare i periodi. Un semplice indicatore di assenza di riaperture non è sempre sufficiente per stabilire la risoluzione al primo contatto.
Risposte fino alla risoluzione
Definizione: Il numero di risposte scambiate prima della risoluzione.
Utilizzo: Individua le categorie che generano scambi evitabili. Un numero basso è utile solo quando il problema è stato effettivamente risolto.
Metriche dell’esperienza del cliente
Soddisfazione del cliente
Definizione: La percentuale o la media delle risposte a un sondaggio post-interazione definito.
Utilizzo: Riporta sempre il numero e il tasso di risposta insieme al punteggio. Esamina i commenti scritti e segmenta con attenzione, soprattutto quando le dimensioni del campione sono ridotte.
Net Promoter Score
Definizione: Percentuale di promotori meno percentuale di detrattori emerse da un sondaggio definito sulla propensione a raccomandare.
Utilizzo: Consideralo una misura più ampia della relazione, non un sostituto diretto della soddisfazione a livello di ticket.
Tasso di riapertura
Definizione: Ticket risolti e riaperti entro un periodo definito divisi per i ticket risolti idonei.
Utilizzo: Esamina categorie, User e procedure di chiusura quando il tasso cambia. Una riapertura può indicare una risoluzione incompleta, ma può anche riflettere l’aggiunta da parte del cliente di un nuovo problema a una conversazione precedente.
Metriche di affidabilità e SLA
Rispetto degli SLA
Definizione: Orologi di risposta o risoluzione completati entro l’obiettivo applicabile divisi per gli orologi completati nella popolazione di reportistica.
Utilizzo: Mantieni separato il rispetto degli SLA dal conteggio in tempo reale dei ticket attualmente a rischio o fuori SLA. Il primo è un giudizio storico, mentre il secondo è una fotografia operativa.
Anzianità dell’arretrato
Definizione: La distribuzione per anzianità dei ticket aperti.
Utilizzo: Mostra gli intervalli di anzianità e i ticket più vecchi. Scegli soglie coerenti con i tuoi impegni di servizio invece di applicare un unico limite universale.
Tasso di escalation
Definizione: Ticket inoltrati a un altro gruppo o specialista divisi per i ticket idonei.
Utilizzo: Segmenta per categoria e priorità. L’escalation può segnalare una lacuna nelle conoscenze, ma può anche essere il percorso corretto per il lavoro complesso.
Metriche finanziarie
Costo per ticket
Definizione: Costi di supporto allocati per un periodo divisi per i ticket idonei gestiti in quel periodo.
Utilizzo: Documenta quali stipendi, software, collaboratori esterni e costi generali sono inclusi. Confronta periodi omogenei e popolazioni di ticket simili.
Costo per canale o categoria
Definizione: Costo allocato per un canale o una categoria diviso per il relativo volume di ticket idonei.
Utilizzo: Usalo solo quando l’allocazione di tempo e costi è abbastanza accurata da sostenere il calcolo. Una falsa precisione è peggiore che lasciare il campo vuoto.
Come stabilire obiettivi e benchmark realistici per il tuo team
I benchmark universali dell’helpdesk raramente sono davvero universali. Un obiettivo dipende dal canale, dagli orari lavorativi, dalla complessità del ticket, dalla priorità, dal personale e dalla promessa fatta ai clienti. Stabilisci prima gli obiettivi in base alla tua attività.
- Definisci la metrica. Annota evento iniziale, evento finale, pause, esclusioni e popolazione idonea.
- Costruisci una baseline. Usa una cronologia sufficiente a coprire la variazione normale. Confronta valori mediani e percentili, non solo le medie.
- Segmenta la baseline. Separa canali, priorità, gruppi e principali categorie di ticket quando i relativi flussi di lavoro differiscono.
- Collega l’obiettivo a un impegno. Gli obiettivi SLA devono corrispondere alla promessa di servizio. Gli obiettivi interni di miglioramento devono essere impegnativi ma plausibili dal punto di vista operativo.
- Rivedi l’obiettivo dopo i cambiamenti di processo. Nuovi instradamenti, personale, automazioni o rilasci di prodotto possono modificare la baseline.
| Metrica | Approccio all’obiettivo | Cadenza suggerita |
|---|---|---|
| Tempo di prima risposta | Stabiliscilo per canale, priorità e impegno di servizio | Giornaliera |
| Tempo di risoluzione | Stabiliscilo per priorità e categoria del ticket | Giornaliera e settimanale |
| Risoluzione al primo contatto | Crea una baseline per categoria e definisci una finestra di osservazione | Settimanale |
| Soddisfazione del cliente | Stabiliscila solo dopo aver compreso il volume e i bias delle risposte | Settimanale o mensile |
| Rispetto degli SLA | Allinealo all’impegno pubblicato o contrattuale | Giornaliera e settimanale |
| Anzianità dell’arretrato | Usa soglie legate alla priorità e alla policy di servizio | Giornaliera |
| Tasso di riapertura | Crea una baseline per categoria e policy di chiusura | Settimanale |
| Costo per ticket | Monitora un andamento interno definito in modo coerente | Mensile |
Usa finestre mobili quando una metrica ha un campione ridotto o una forte variazione giornaliera. Usa i confronti tra periodi quando devi individuare cambiamenti operativi. In entrambi i casi, mostra il numero di ticket idonei, così i lettori possono valutare quanto sia stabile il risultato.
Come progettare dashboard che ogni pubblico utilizzerà davvero
Una dashboard funziona quando ogni scheda risponde a una domanda del suo pubblico. Le viste operative dovrebbero aiutare le persone ad agire subito. Le viste manageriali dovrebbero spiegare tendenze ed eccezioni. Le viste per i dirigenti dovrebbero collegare i risultati del supporto a servizio, rischio e costi.
Corrispondenza tra pubblico e metriche
Gli User hanno bisogno del proprio lavoro aperto, dei ticket in attesa della prima risposta, degli orologi SLA in scadenza o fuori SLA e di un contesto sufficiente sulla coda per scegliere il ticket successivo.
I team leader hanno bisogno del volume creato rispetto a quello risolto, dell’anzianità dell’arretrato, della distribuzione dei tempi di risposta, del rischio SLA e del carico di lavoro per User. Hanno inoltre bisogno di link di approfondimento ai ticket alla base di un numero.
I responsabili del supporto hanno bisogno di tendenze per gruppo, priorità, canale e categoria, oltre a definizioni chiare per ogni KPI. Una scorecard di sintesi dovrebbe condurre a una tabella o a un grafico che spieghi il cambiamento.
I dirigenti hanno generalmente bisogno di un insieme ridotto di indicatori di servizio, qualità, rischio e costi. Mostra obiettivo, valore attuale, direzione e una breve spiegazione dei cambiamenti rilevanti.
Widget consigliati
- Ticket creati rispetto a quelli risolti: linee di tendenza che utilizzano lo stesso intervallo
- Distribuzione della prima risposta: mediana, 90° percentile e intervalli temporali
- Andamento delle risoluzioni: segmentato per priorità o categoria
- SLA in questo momento: orologi attualmente fuori SLA, in scadenza a breve e in pausa
- Rispetto degli SLA: orologi completati che hanno raggiunto gli obiettivi nel periodo selezionato
- Arretrato per anzianità: conteggio dei ticket aperti in intervalli di anzianità utili
- Tabella del carico di lavoro: attività per gruppo e User con il contesto pertinente
- Suddivisioni per canale e argomento: mix della domanda e temi ricorrenti
Cadenza dei report
- Vista operativa in tempo reale: ticket aperti, in attesa della prima risposta e rischio SLA attuale
- Revisione giornaliera: volume, anzianità dell’arretrato, prima risposta, tempo di risoluzione e violazioni
- Revisione settimanale: tendenze, eccezioni, tasso di riapertura, tasso di escalation e azioni di miglioramento
- Revisione mensile: risultati del servizio, costi, capacità e modifiche agli obiettivi
Collega ogni riunione alle decisioni. Una revisione settimanale dovrebbe terminare con un responsabile nominato, una scadenza e la metrica che mostrerà se il cambiamento ha funzionato.
Come assicurarti che i dati siano corretti prima di elaborarli nei report
Le metriche sono affidabili solo quanto lo sono le definizioni degli eventi. Prima di creare una dashboard, verifica che il sistema di ticket registri in modo coerente gli eventi di creazione, risposta, stato, assegnazione e risoluzione.
Schema minimo dei ticket
Un’esportazione per la reportistica spesso necessita di campi come questi:
ticket_id: identificatore stabile del ticketcreated_at: timestamp di creazione del ticketfirst_qualifying_response_at: timestamp utilizzato dalla definizione della prima rispostaresolved_at: timestamp di risoluzioneassignee_id: User assegnatario attuale o al momento dell’evento, indicato chiaramentegroup_id: gruppo responsabilechannel: canale di originepriority: valore di priorità controllatostatus: valore di stato controllatotags: categorie controllate, ove possibilesla_policy_id: policy applicabile, quando presentereopened_count: numero di eventi di riapertura
Non tutte le piattaforme espongono lo stesso schema. Considerali concetti di reportistica, non un’indicazione dei nomi esatti dei campi. Se un valore può cambiare, stabilisci se il report necessita del valore attuale o di quello presente al momento dell’evento.
Tag e tassonomia
Usa una tassonomia controllata per le categorie che guidano il personale, l’instradamento o le attività di miglioramento. Mantieni l’elenco abbastanza ridotto da poterlo utilizzare in modo coerente. Controlla i ticket non categorizzati e le etichette quasi duplicate prima di affidarti alle tendenze delle categorie.
L’automazione può aiutare ad assegnare i campi, ma anche la classificazione automatica richiede una revisione. Monitora i risultati sconosciuti o a bassa affidabilità invece di forzare ogni ticket in una categoria fuorviante.
Checklist della strumentazione
- [ ] Tutti i timestamp utilizzano un unico standard temporale memorizzato e un fuso orario di visualizzazione documentato
- [ ] La definizione della prima risposta specifica se le risposte automatiche vengono conteggiate
- [ ] Gli orologi delle ore lavorative e quelli delle ore di calendario non sono mescolati
- [ ] Gli stati in pausa sono documentati per gli orologi di risoluzione
- [ ] Gli eventi di riapertura ed escalation hanno definizioni esplicite
- [ ] L’assegnatario attuale non viene confuso con l’assegnatario al momento della risoluzione
- [ ] I ticket eliminati, uniti, spam, di test e importati hanno una policy di inclusione dichiarata
- [ ] Ogni punteggio mostra il conteggio dei ticket idonei
Consiglio professionale: Ricalcola manualmente un piccolo campione. Se il risultato della dashboard non può essere riprodotto a partire dagli eventi dei ticket, correggi la definizione o i dati prima di stabilire un obiettivo.
Le insidie della reportistica che rendono fuorvianti le metriche
-
Trattare il conteggio dei ticket come una misura della performance. Il volume misura la domanda. Affiancalo ad arretrato, velocità e qualità prima di trarre conclusioni sulla performance.
-
Riportare una media senza una distribuzione. Le medie possono nascondere attese lunghe. Aggiungi una mediana, un percentile o una vista per intervalli temporali.
-
Classificare gli User solo in base ai ticket chiusi. Complessità dei ticket, orari di lavoro, riassegnazioni e qualità influenzano tutti i conteggi. Usa le tabelle del carico di lavoro per bilanciare il lavoro, non come punteggio autonomo della performance.
-
Mescolare popolazioni di ticket non omogenee. Priorità, canali e categorie diversi spesso richiedono obiettivi diversi. Segmenta prima di confrontare.
-
Confondere lo stato SLA in tempo reale con il rispetto storico. Un ticket attualmente fuori SLA è un problema operativo. Un orologio completato che non ha raggiunto l’obiettivo rientra nel tasso di rispetto. Non combinare le due popolazioni.
-
Ignorare i cambiamenti del denominatore. Una percentuale può cambiare perché è cambiata la popolazione idonea. Mostra sempre il conteggio alla base.
-
Inventare una precisione inesistente. Se il tempo di gestione, l’allocazione dei costi o la copertura del sondaggio sono incompleti, indica il limite o ometti la metrica.
Un modello di dashboard pronto per l’uso che puoi copiare oggi
Il modello seguente è indipendente dalla piattaforma. Adatta i nomi dei campi e le formule al tuo modello di dati, quindi documenta ogni modifica.
Schema e formule del foglio di calcolo
| Nome della colonna | Formula o origine | Note |
|---|---|---|
ticket_id |
Sistema di ticket | Chiave stabile |
created_at |
Evento del ticket | Memorizza utilizzando un unico standard temporale |
first_response_at |
Evento della prima risposta qualificante | Documenta il trattamento delle risposte automatiche |
resolved_at |
Evento di risoluzione | Documenta la gestione delle riaperture |
frt_minutes |
Differenza tra creazione e prima risposta | Minuti di calendario o lavorativi |
resolution_minutes |
Differenza tra creazione e risoluzione | Sottrai le pause documentate, se applicabile |
reopened_count |
Conteggio degli eventi di riapertura | Scegli una finestra di osservazione |
sla_first_reply_met |
Esito dell’orologio SLA | Null se non esiste un orologio completato applicabile |
sla_resolution_met |
Esito dell’orologio SLA | Null se non esiste un orologio completato applicabile |
channel |
Origine del ticket | Valore controllato |
priority |
Campo del ticket | Valore controllato |
group_id |
Campo del ticket o cronologia degli eventi | Indica se è attuale o relativo al momento dell’evento |
Esempi di query SQL
Prima risposta in tempo di calendario in MySQL:
SELECT ticket_id,
       TIMESTAMPDIFF(MINUTE, created_at, first_response_at) AS frt_minutes
FROM tickets
WHERE first_response_at IS NOT NULL;
Ticket creati per assegnatario attuale e giorno:
SELECT assignee_id,
       DATE(created_at) AS ticket_date,
       COUNT(*) AS tickets_created
FROM tickets
GROUP BY assignee_id, DATE(created_at)
ORDER BY ticket_date DESC, tickets_created DESC;
Rispetto dello SLA per la prima risposta completato:
SELECT
  AVG(CASE WHEN sla_first_reply_met = 1 THEN 1.0 ELSE 0.0 END) * 100 AS attainment_pct
FROM tickets
WHERE sla_first_reply_met IS NOT NULL
  AND created_at >= :period_start
  AND created_at < :period_end;
Questi esempi utilizzano campi semplificati e il tempo di calendario. La reportistica in produzione deve applicare le stesse regole di idoneità, ore lavorative, pause, unione ed eliminazione del sistema di origine.
Struttura delle schede della dashboard
- Scheda operativa: coda aperta, in attesa della prima risposta, rischio SLA attuale e ticket più vecchi
- Scheda manageriale: andamento dei ticket creati rispetto a quelli risolti, distribuzione delle risposte, andamento delle risoluzioni, rispetto degli SLA, anzianità dell’arretrato e tabelle del carico di lavoro
- Scheda dirigenziale: KPI selezionati di servizio, qualità, rischio e costi con obiettivi e brevi commenti
Consiglio professionale: Tieni un dizionario delle metriche accanto alla dashboard. Crea versioni delle modifiche a formule e obiettivi, così gli scostamenti storici resteranno spiegabili.
Dove la reportistica ripaga davvero
La reportistica ripaga quando modifica la gestione delle code, il personale, l’instradamento, la documentazione o il lavoro sul prodotto. Un grafico sofisticato che non produce alcuna decisione è meno utile di una semplice vista dell’arretrato che aiuta il team a chiudere i ticket vecchi.
Inizia con una misura della domanda, una della velocità, una dell’affidabilità o della qualità e l’anzianità dell’arretrato. Esaminale insieme. Se il volume aumenta mentre il tempo di risposta resta stabile, il team potrebbe avere capacità disponibile. Se il volume risolto è inferiore a quello creato e l’arretrato invecchia, il problema è visibile prima che una singola media di sintesi diventi allarmante.
Usa gli approfondimenti per passare da un andamento ai ticket che lo determinano. La domanda migliore durante una revisione non è semplicemente: “Perché è cambiato il numero?”. È: “Quali ticket hanno causato il cambiamento, cosa hanno in comune e cosa faremo diversamente?”.
Deskhero ti offre dati pronti per la reportistica fin dal primo giorno
Deskhero trasforma le caselle Gmail, Google Workspace e Microsoft 365 collegate in code di ticket condivise. Accetta inoltre ticket da moduli integrati e dal suo chatbot AI basato sulle FAQ.
Deskhero include una Dashboard operativa con viste dello stato dei ticket, ticket in attesa della prima risposta, tendenze del volume dei ticket, tempo medio di prima risposta, tempo medio di risoluzione e tempo medio per stato. L’area Statistics dispone di nove schede fisse dedicate a panoramica, tendenze, tempi di risposta, SLA, team, AI e automazione, canali, statistiche degli argomenti e cluster degli argomenti.
Le statistiche possono essere filtrate per data e gruppo, con un filtro aggiuntivo per la policy nella scheda SLA. Le schede dei grafici possono passare dalla vista a grafico a quella tabellare e la maggior parte delle schede può essere esportata in Excel. I dati sono limitati ai gruppi a cui lo User autenticato può accedere e generalmente vengono memorizzati nella cache per circa cinque minuti. La barra SLA in tempo reale è separata dal rispetto storico.
Deskhero non include un generatore di report personalizzato. Anche le viste degli argomenti hanno requisiti sui dati: il clustering degli argomenti richiede circa 100 ticket e viene ricostruito periodicamente. È disponibile una prova gratuita di 30 giorni senza carta di credito.
Fonti
Questa guida utilizza il comportamento della reportistica documentato nell’implementazione del prodotto Deskhero. Le guide Deskhero correlate riportate di seguito offrono ulteriore contesto su dashboard e acquisizione dei ticket.
- Dashboard del supporto clienti per i responsabili del supporto: modelli e KPI
- Da email a ticket: la guida completa per i team di supporto
FAQ
Quali sono le metriche principali per la reportistica del service desk?
Inizia con volume dei ticket, volume creato rispetto a quello risolto, tempo di prima risposta, tempo di risoluzione, rispetto degli SLA, anzianità dell’arretrato, tasso di riapertura, tasso di escalation, carico di lavoro per User e mix dei canali. Aggiungi metriche di soddisfazione e costi quando i dati di origine sono affidabili.
Quali sono buoni KPI per un helpdesk IT?
Prima risposta, risoluzione, rispetto degli SLA, risoluzione al primo contatto, tasso di riapertura e soddisfazione del cliente possono essere tutti KPI utili. Scegli solo le metriche collegate a un risultato importante, a un obiettivo chiaro e a un’azione che il team può intraprendere.
Con quale frequenza dovresti inviare i sondaggi CSAT?
Scegli un’attivazione coerente con il percorso del cliente, ad esempio dopo la risoluzione di un ticket idoneo. Mantieni breve il sondaggio, evita richieste ripetute allo stesso cliente e riporta il numero e il tasso di risposta insieme al punteggio.
Qual è un buon tasso di risoluzione al primo contatto?
Non esiste un tasso universale utile per ogni team. Definisci cosa conta come primo contatto, stabilisci una finestra di osservazione per follow-up o riaperture, crea una baseline del tasso per categoria e canale e miglioralo senza incoraggiare chiusure premature.
Come si calcola il costo per ticket?
Dividi i costi di supporto allocati in modo coerente per un periodo per i ticket idonei gestiti in quel periodo. Documenta quali costi di personale, software, collaboratori esterni e spese generali sono inclusi, quindi confronta periodi e popolazioni di ticket omogenei.