Les indicateurs essentiels du helpdesk pour les responsables support
Les rapports de helpdesk les plus utiles relient la demande, la rapidité, la qualité et la fiabilité. Commencez par le volume de tickets, le délai de première réponse, le délai de résolution, la résolution au premier contact, le respect des SLA, l’ancienneté du backlog, le taux de réouverture, le taux d’escalade, la charge de travail par Utilisateur, la répartition par canal et le coût par ticket. Ajoutez des indicateurs de satisfaction client uniquement lorsque vous disposez d’un processus d’enquête fiable et d’un nombre de réponses suffisant pour les interpréter de manière responsable.
Une cadence de reporting pratique peut se présenter ainsi :
- Volume de tickets : instantané quotidien et tendance hebdomadaire
- Délai de première réponse : tendance quotidienne, avec suivi en direct des SLA lorsque cela s’applique
- Délai de résolution : tendance quotidienne et revue hebdomadaire
- Résolution au premier contact : chaque semaine
- Respect des SLA : vue opérationnelle quotidienne et synthèse hebdomadaire
- Ancienneté du backlog : chaque jour
- Taux de réouverture et d’escalade : chaque semaine
- Charge de travail par Utilisateur : chaque jour pour équilibrer les files
- Répartition par canal : chaque semaine
- Coût par ticket : chaque mois
Ne commencez pas par tout suivre. Choisissez un petit tableau de bord d’indicateurs, vérifiez que les horodatages et les champs sous-jacents sont fiables, puis ajoutez des détails uniquement lorsqu’ils aident quelqu’un à prendre une décision.
Points clés à retenir
Un reporting de helpdesk fiable commence par des données d’événements propres, des formules clairement définies et un processus de revue qui se termine par la désignation d’un responsable et d’une action.
| Point | Détails |
|---|---|
| Distinguez les métriques des KPI | Une métrique décrit une activité. Un KPI est une métrique associée à un objectif, à un responsable désigné et à une décision. |
| Utilisez les distributions, pas uniquement les moyennes | Associez les moyennes aux médianes, aux percentiles ou à des tranches de temps afin qu’un petit nombre de tickets lents ne puisse pas masquer l’expérience habituelle. |
| Les benchmarks nécessitent du contexte | Utilisez votre propre référence, la répartition par canal, la complexité des tickets, les effectifs et vos engagements de service avant de fixer des objectifs. |
| La qualité des données passe en premier | Définissez quels événements démarrent, mettent en pause et terminent chaque compteur avant de publier un score. |
| Deskhero inclut des vues de reporting fixes | Deskhero fournit un Tableau de bord opérationnel et une section Statistiques composée de neuf onglets fixes, avec des filtres, des vues en graphiques et en tableaux, ainsi qu’une exportation Excel dans la plupart des onglets. |
Table des matières
- Quelle est la différence entre une métrique de helpdesk et un KPI ?
- Les principales métriques de reporting de helpdesk, regroupées par objectif
- Comment définir des objectifs et des benchmarks réalistes pour votre équipe
- Comment concevoir des tableaux de bord que chaque public utilisera réellement
- Mettre vos données en ordre avant de les intégrer à vos rapports
- Les pièges du reporting qui rendent vos métriques trompeuses
- Un modèle de tableau de bord prêt à l’emploi que vous pouvez copier dès aujourd’hui
- Les domaines où le reporting est réellement rentable
- Deskhero vous fournit des données prêtes pour le reporting dès le premier jour
- Sources
- FAQ
Quelle est la différence entre une métrique de helpdesk et un KPI ?
Une métrique est toute valeur mesurée, comme le nombre de tickets créés, le délai médian de première réponse ou le nombre de tickets ouverts. Un KPI est une métrique choisie pour représenter un résultat important. Il possède une définition, un objectif ou une plage acceptable, un responsable et une réponse à appliquer lorsque les performances sortent de cette plage.
Le volume de tickets est généralement une métrique diagnostique. Il décrit la demande, mais n’indique pas si l’équipe a bien travaillé. Le respect du SLA de première réponse peut être un KPI, car il mesure les performances par rapport à un engagement défini. Même dans ce cas, il doit être interprété avec les données de qualité et de charge de travail.
Une distinction utile est la suivante :
- Métriques diagnostiques : volume de tickets, répartition par canal, répartition par priorité, répartition par catégorie et composition du backlog
- KPI possibles : délai de première réponse, délai de résolution, respect des SLA, résolution au premier contact, taux de réouverture et satisfaction client
La classification dépend de ce que l’organisation cherche à améliorer. Une métrique de coût peut être centrale pour une activité de support et sans intérêt pour une autre. Notez la décision attendue à côté de chaque KPI. Si personne ne peut expliquer quelle action un changement devrait déclencher, la métrique devrait probablement figurer dans une vue diagnostique plutôt que dans un KPI.
Conseil de pro : Documentez chaque KPI en une phrase : formule, population, période, exclusions, responsable et objectif. Cela évite que deux équipes utilisent le même intitulé pour des calculs différents.
Les principales métriques de reporting de helpdesk, regroupées par objectif
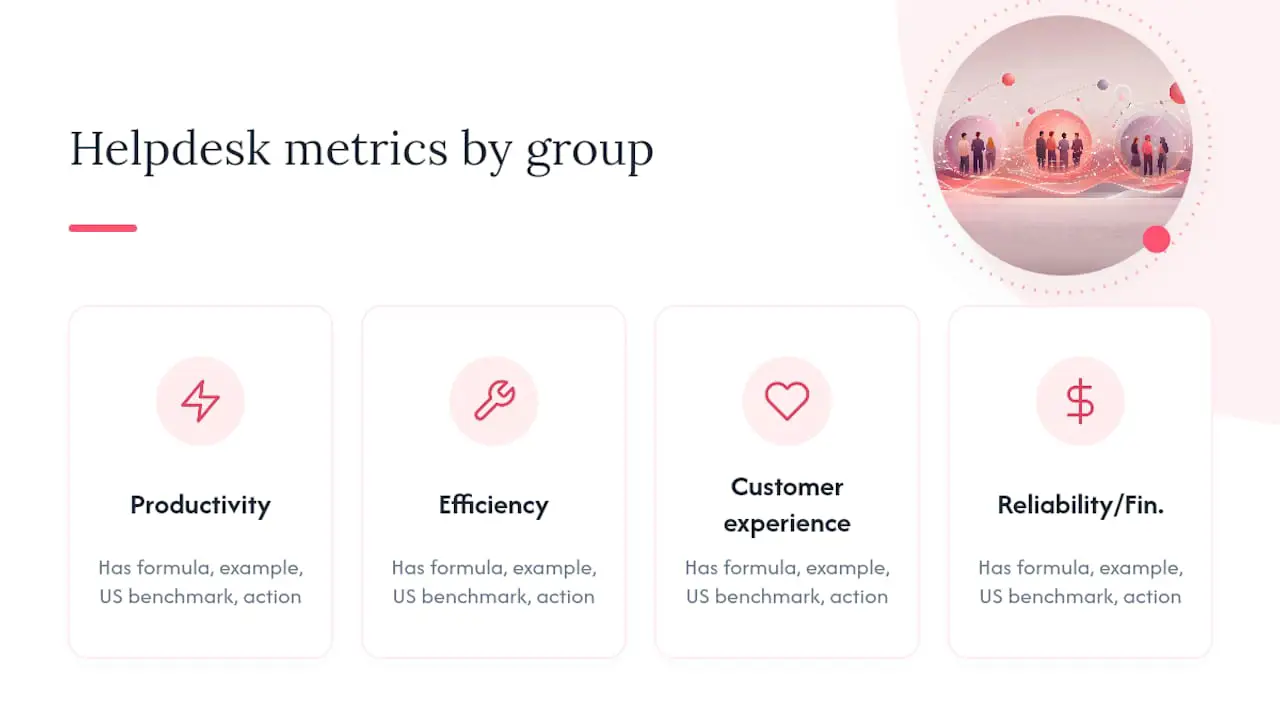
Regroupez les métriques selon la question à laquelle elles répondent. Les métriques de demande décrivent ce qui est entré dans la file. Les métriques d’efficacité montrent comment le travail a progressé. Les métriques d’expérience reflètent les retours des clients. Les métriques de fiabilité indiquent si les engagements ont été respectés. Les métriques financières relient l’activité du support aux coûts.
Métriques de productivité
Volume de tickets
Définition : Tickets créés au cours d’une période de reporting.
Formule : Compter les tickets selon leur horodatage de création dans la période sélectionnée.
Utilisation : Comparer le volume par jour, canal, groupe, priorité et catégorie. Rechercher la cause des pics avant de modifier les effectifs.
Volume de tickets résolus
Définition : Tickets résolus au cours de la période.
Utilisation : Comparer les volumes créés et résolus sur le même intervalle. Si le volume créé dépasse régulièrement le volume résolu, le backlog risque de croître.
Charge de travail par Utilisateur
Définition : Tickets attribués, traités ou résolus par chaque Utilisateur, selon la question posée.
Utilisation : Équilibrer les files et identifier la concentration du travail. Ne transformez pas un simple volume de charge en classement de performance sans tenir compte de la complexité, de la disponibilité et de la qualité.
Répartition par canal
Définition : Part des tickets créés via chaque canal.
Formule : Tickets provenant d’un canal divisés par l’ensemble des tickets de la période.
Utilisation : Adapter les effectifs et les objectifs de service à la demande réelle.
Métriques d’efficacité
Délai de première réponse
Définition : Temps écoulé entre la création du ticket et la première réponse humaine ou automatisée admissible, conformément à votre politique de reporting.
Utilisation : Présenter la médiane, le 90e percentile et des tranches de temps. Préciser si le compteur utilise le temps calendaire ou les heures ouvrées, et si les accusés de réception automatiques sont comptabilisés.
Délai de résolution
Définition : Temps écoulé entre la création du ticket et sa résolution.
Utilisation : Segmenter par groupe, priorité, catégorie et statut d’escalade. Si le compteur est mis en pause pendant l’attente d’une réponse du client, documenter cette règle.
Résolution au premier contact
Définition : Part des tickets éligibles résolus lors de la première interaction avec le support, sans suivi ultérieur ni réouverture pendant la période d’observation choisie.
Utilisation : Définir la période d’observation et les canaux éligibles avant de comparer les périodes. Un simple indicateur d’absence de réouverture ne suffit pas toujours à établir une résolution au premier contact.
Nombre de réponses jusqu’à la résolution
Définition : Nombre de réponses échangées avant la résolution.
Utilisation : Rechercher les catégories qui génèrent des échanges aller-retour évitables. Un faible nombre n’est utile que si le problème a réellement été résolu.
Métriques d’expérience client
Satisfaction client
Définition : Part ou moyenne des réponses à une enquête définie après interaction.
Utilisation : Toujours présenter le nombre de réponses et le taux de réponse avec le score. Examiner les commentaires écrits et segmenter soigneusement, en particulier lorsque les échantillons sont réduits.
Net Promoter Score
Définition : Pourcentage de promoteurs moins le pourcentage de détracteurs issus d’une enquête définie sur la recommandation.
Utilisation : Le considérer comme une mesure plus globale de la relation, et non comme un substitut direct à la satisfaction au niveau du ticket.
Taux de réouverture
Définition : Tickets résolus rouverts pendant une période définie, divisés par les tickets résolus éligibles.
Utilisation : Examiner les catégories, les Utilisateurs et les pratiques de clôture lorsque le taux évolue. Une réouverture peut signaler une résolution incomplète, mais aussi le fait qu’un client ajoute un nouveau problème à une ancienne conversation.
Métriques de fiabilité et de SLA
Respect des SLA
Définition : Compteurs de réponse ou de résolution terminés dans les délais impartis, divisés par l’ensemble des compteurs terminés de la population étudiée.
Utilisation : Distinguer le respect des SLA du nombre actuel de tickets à risque ou en dépassement. Le premier est un verdict historique, tandis que le second est un instantané opérationnel.
Ancienneté du backlog
Définition : Répartition par ancienneté des tickets ouverts.
Utilisation : Afficher des tranches d’ancienneté ainsi que les tickets les plus anciens. Choisir des seuils correspondant à vos engagements de service plutôt qu’une limite universelle.
Taux d’escalade
Définition : Tickets escaladés vers un autre groupe ou un spécialiste, divisés par les tickets éligibles.
Utilisation : Segmenter par catégorie et priorité. Une escalade peut révéler une lacune de connaissances, mais elle peut aussi être la voie appropriée pour un travail complexe.
Métriques financières
Coût par ticket
Définition : Coûts de support imputés sur une période, divisés par les tickets éligibles traités pendant cette période.
Utilisation : Documenter les salaires, logiciels, prestataires et frais généraux inclus. Comparer des périodes et des populations de tickets similaires.
Coût par canal ou catégorie
Définition : Coût imputé à un canal ou à une catégorie, divisé par son volume de tickets éligibles.
Utilisation : Utiliser cette métrique uniquement lorsque l’allocation du temps et des coûts est suffisamment fiable pour justifier le calcul. Une fausse précision vaut moins que l’absence de valeur.
Comment définir des objectifs et des benchmarks réalistes pour votre équipe
Les benchmarks universels du helpdesk sont rarement universels. Un objectif dépend du canal, des heures ouvrées, de la complexité des tickets, de la priorité, des effectifs et de la promesse faite aux clients. Commencez par définir vos objectifs à partir de votre propre activité.
- Définissez la métrique. Notez l’événement de début, l’événement de fin, les pauses, les exclusions et la population éligible.
- Établissez une référence. Utilisez suffisamment d’historique pour couvrir les variations normales. Comparez les valeurs médianes et en percentile, et pas seulement les moyennes.
- Segmentez la référence. Séparez les canaux, priorités, groupes et principales catégories de tickets lorsque leurs flux de travail diffèrent.
- Reliez l’objectif à un engagement. Les objectifs de SLA doivent correspondre à la promesse de service. Les objectifs d’amélioration internes doivent être ambitieux, mais réalistes sur le plan opérationnel.
- Réévaluez l’objectif après chaque changement de processus. Un nouveau routage, de nouveaux effectifs, une automatisation ou une mise à jour produit peut modifier la référence.
| Métrique | Approche pour définir l’objectif | Cadence suggérée |
|---|---|---|
| Délai de première réponse | Définir selon le canal, la priorité et l’engagement de service | Quotidienne |
| Délai de résolution | Définir selon la priorité et la catégorie du ticket | Quotidienne et hebdomadaire |
| Résolution au premier contact | Établir une référence par catégorie et définir une période d’observation | Hebdomadaire |
| Satisfaction client | Définir uniquement après avoir compris le volume et les biais des réponses | Hebdomadaire ou mensuelle |
| Respect des SLA | Correspondre à l’engagement publié ou contractuel | Quotidienne et hebdomadaire |
| Ancienneté du backlog | Utiliser des seuils liés à la priorité et à la politique de service | Quotidienne |
| Taux de réouverture | Établir une référence par catégorie et politique de clôture | Hebdomadaire |
| Coût par ticket | Suivre une tendance interne définie de manière cohérente | Mensuelle |
Utilisez des fenêtres glissantes lorsqu’une métrique repose sur un petit échantillon ou présente de fortes variations quotidiennes. Utilisez des comparaisons entre périodes lorsque vous devez identifier des changements opérationnels. Dans les deux cas, affichez le nombre de tickets éligibles afin que les lecteurs puissent juger de la stabilité du résultat.
Comment concevoir des tableaux de bord que chaque public utilisera réellement
Un tableau de bord est efficace lorsque chaque carte répond à une question de son public. Les vues opérationnelles doivent aider les équipes à agir immédiatement. Les vues de management doivent expliquer les tendances et les exceptions. Les vues destinées aux dirigeants doivent relier les résultats du support au service, aux risques et aux coûts.
Correspondance entre publics et métriques
Les Utilisateurs ont besoin de voir leur travail ouvert, les tickets en attente d’une première réponse, les compteurs de SLA arrivant à échéance ou dépassés, ainsi que suffisamment de contexte sur la file pour choisir le prochain ticket.
Les responsables d’équipe ont besoin des volumes créés et résolus, de l’ancienneté du backlog, de la distribution des délais de réponse, des risques liés aux SLA et de la charge de travail par Utilisateur. Ils ont également besoin de liens d’exploration vers les tickets à l’origine d’un chiffre.
Les responsables du support ont besoin de tendances par groupe, priorité, canal et catégorie, ainsi que de définitions claires pour chaque KPI. Un tableau de bord synthétique doit mener à un tableau ou à un graphique qui explique l’évolution.
Les dirigeants ont généralement besoin d’un petit ensemble d’indicateurs de service, de qualité, de risque et de coût. Affichez l’objectif, la valeur actuelle, la direction de l’évolution et une courte explication des changements importants.
Widgets recommandés
- Tickets créés par rapport aux tickets résolus : courbes de tendance utilisant le même intervalle
- Distribution des premières réponses : médiane, 90e percentile et tranches de temps
- Tendance des résolutions : segmentée par priorité ou catégorie
- SLA à l’instant présent : compteurs actuellement dépassés, arrivant bientôt à échéance et en pause
- Respect des SLA : compteurs terminés ayant atteint leurs objectifs pendant la période sélectionnée
- Backlog par ancienneté : nombre de tickets ouverts répartis dans des tranches d’ancienneté utiles
- Tableau de charge de travail : activité par groupe et par Utilisateur avec le contexte pertinent
- Répartitions par canal et par sujet : composition de la demande et thèmes récurrents
Cadence des rapports
- Vue opérationnelle en direct : tickets ouverts, attente de première réponse et risque actuel lié aux SLA
- Revue quotidienne : volume, ancienneté du backlog, première réponse, délai de résolution et dépassements
- Revue hebdomadaire : tendances, exceptions, taux de réouverture, taux d’escalade et actions d’amélioration
- Revue mensuelle : résultats de service, coûts, capacité et évolution des objectifs
Reliez chaque réunion à des décisions. Une revue hebdomadaire doit se terminer par la désignation d’un responsable, une date d’échéance et la métrique qui montrera si le changement a fonctionné.
Mettre vos données en ordre avant de les intégrer à vos rapports
La fiabilité des métriques dépend de la fiabilité des définitions d’événements. Avant de créer un tableau de bord, vérifiez que le système de tickets enregistre de manière cohérente les événements de création, de réponse, de changement de statut, d’attribution et de résolution.
Schéma minimal d’un ticket
Un export destiné au reporting nécessite souvent des champs tels que ceux-ci :
ticket_id: identifiant stable du ticketcreated_at: horodatage de création du ticketfirst_qualifying_response_at: horodatage utilisé par la définition de la première réponseresolved_at: horodatage de résolutionassignee_id: responsable actuel ou responsable au moment de l’événement, à indiquer clairementgroup_id: groupe responsablechannel: canal d’originepriority: valeur de priorité contrôléestatus: valeur de statut contrôléetags: catégories contrôlées dans la mesure du possiblesla_policy_id: politique applicable, lorsqu’elle existereopened_count: nombre d’événements de réouverture
Toutes les plateformes n’exposent pas le même schéma. Considérez ces éléments comme des concepts de reporting, et non comme une affirmation concernant des noms de champs exacts. Si une valeur peut changer, déterminez si le rapport doit utiliser la valeur actuelle ou la valeur au moment de l’événement.
Étiquetage et taxonomie
Utilisez une taxonomie contrôlée pour les catégories qui influencent les effectifs, le routage ou les travaux d’amélioration. Gardez une liste suffisamment courte pour être utilisée de manière cohérente. Contrôlez les tickets non catégorisés et les intitulés presque identiques avant de faire confiance aux tendances par catégorie.
L’automatisation peut aider à attribuer des champs, mais la classification automatisée doit tout de même être contrôlée. Suivez les résultats inconnus ou peu fiables au lieu de forcer chaque ticket dans une catégorie trompeuse.
Liste de contrôle de l’instrumentation
- [ ] Tous les horodatages utilisent une même référence temporelle stockée et un fuseau horaire d’affichage documenté
- [ ] La définition de la première réponse précise si les réponses automatisées sont comptabilisées
- [ ] Les compteurs en heures ouvrées et en heures calendaires ne sont pas mélangés
- [ ] Les statuts en pause sont documentés pour les compteurs de résolution
- [ ] Les événements de réouverture et d’escalade possèdent des définitions explicites
- [ ] Le responsable actuel n’est pas confondu avec le responsable au moment de la résolution
- [ ] Les tickets supprimés, fusionnés, indésirables, de test et importés font l’objet d’une politique d’inclusion définie
- [ ] Chaque score affiche le nombre de tickets éligibles
Conseil de pro : Recalculez manuellement un petit échantillon. Si le résultat du tableau de bord ne peut pas être reproduit à partir des événements des tickets, corrigez la définition ou les données avant de fixer un objectif.
Les pièges du reporting qui rendent vos métriques trompeuses
-
Prendre le nombre de tickets pour une mesure de performance. Le volume mesure la demande. Associez-le au backlog, à la rapidité et à la qualité avant de tirer des conclusions sur les performances.
-
Présenter une moyenne sans distribution. Les moyennes peuvent masquer de longues attentes. Ajoutez une médiane, un percentile ou une vue par tranches de temps.
-
Classer les Utilisateurs uniquement selon le nombre de tickets clôturés. La complexité des tickets, les horaires de travail, les réaffectations et la qualité influencent tous les volumes. Utilisez les tableaux de charge de travail pour équilibrer le travail, et non comme score de performance autonome.
-
Mélanger des populations de tickets différentes. Les priorités, canaux et catégories distincts nécessitent souvent des objectifs différents. Segmentez avant de comparer.
-
Confondre l’état actuel des SLA avec le respect historique des SLA. Un ticket actuellement en dépassement est un problème opérationnel. Un compteur terminé qui n’a pas atteint son objectif appartient au taux de respect des SLA. Ne mélangez pas ces deux populations.
-
Ignorer les changements de dénominateur. Un pourcentage peut évoluer parce que la population éligible a changé. Affichez toujours le nombre qui le sous-tend.
-
Inventer une précision. Si le temps de traitement, l’allocation des coûts ou la couverture des enquêtes est incomplet, indiquez cette limite ou omettez la métrique.
Un modèle de tableau de bord prêt à l’emploi que vous pouvez copier dès aujourd’hui
Le modèle ci-dessous est indépendant de toute plateforme. Adaptez les noms de champs et les formules à votre modèle de données, puis documentez chaque modification.
Schéma et formules du tableur
| Nom de colonne | Formule ou source | Notes |
|---|---|---|
ticket_id |
Système de tickets | Clé stable |
created_at |
Événement du ticket | Stocker selon une même référence temporelle |
first_response_at |
Événement de première réponse admissible | Documenter le traitement des réponses automatiques |
resolved_at |
Événement de résolution | Documenter le traitement des réouvertures |
frt_minutes |
Différence entre la création et la première réponse | Minutes calendaires ou ouvrées |
resolution_minutes |
Différence entre la création et la résolution | Soustraire les pauses documentées le cas échéant |
reopened_count |
Nombre d’événements de réouverture | Choisir une période d’observation |
sla_first_reply_met |
Verdict du compteur SLA | Null si aucun compteur terminé applicable |
sla_resolution_met |
Verdict du compteur SLA | Null si aucun compteur terminé applicable |
channel |
Source du ticket | Valeur contrôlée |
priority |
Champ du ticket | Valeur contrôlée |
group_id |
Champ du ticket ou historique des événements | Préciser s’il s’agit de la valeur actuelle ou de celle au moment de l’événement |
Exemples d’extraits SQL
Première réponse en temps calendaire dans MySQL :
SELECT ticket_id,
       TIMESTAMPDIFF(MINUTE, created_at, first_response_at) AS frt_minutes
FROM tickets
WHERE first_response_at IS NOT NULL;
Tickets créés par responsable actuel et par jour :
SELECT assignee_id,
       DATE(created_at) AS ticket_date,
       COUNT(*) AS tickets_created
FROM tickets
GROUP BY assignee_id, DATE(created_at)
ORDER BY ticket_date DESC, tickets_created DESC;
Respect du SLA de première réponse pour les tickets terminés :
SELECT
  AVG(CASE WHEN sla_first_reply_met = 1 THEN 1.0 ELSE 0.0 END) * 100 AS attainment_pct
FROM tickets
WHERE sla_first_reply_met IS NOT NULL
  AND created_at >= :period_start
  AND created_at < :period_end;
Ces exemples utilisent des champs simplifiés et le temps calendaire. Le reporting en production doit appliquer les mêmes règles d’éligibilité, d’heures ouvrées, de pause, de fusion et de suppression que le système source.
Organisation des onglets du tableau de bord
- Onglet opérationnel : file ouverte, attente de première réponse, risque actuel lié aux SLA et tickets les plus anciens
- Onglet management : tendance des tickets créés par rapport aux tickets résolus, distribution des réponses, tendance des résolutions, respect des SLA, ancienneté du backlog et tableaux de charge de travail
- Onglet direction : KPI sélectionnés de service, de qualité, de risque et de coût, avec objectifs et commentaires succincts
Conseil de pro : Conservez un dictionnaire des métriques à côté du tableau de bord. Versionnez les changements apportés aux formules et aux objectifs afin que les évolutions historiques restent explicables.
Les domaines où le reporting est réellement rentable
Le reporting est rentable lorsqu’il modifie la gestion des files, les effectifs, le routage, la documentation ou le travail produit. Un graphique sophistiqué qui ne débouche sur aucune décision est moins utile qu’une simple vue du backlog qui aide l’équipe à traiter les anciens tickets.
Commencez par une mesure de la demande, une mesure de la rapidité, une mesure de la fiabilité ou de la qualité et l’ancienneté du backlog. Examinez-les ensemble. Si le volume augmente tandis que le délai de réponse reste stable, l’équipe dispose peut-être encore de capacité. Si le volume résolu est inférieur au volume créé et que le backlog vieillit, le problème est visible avant même qu’une moyenne globale ne devienne alarmante.
Utilisez les fonctions d’exploration pour passer d’un schéma aux tickets qui en sont à l’origine. La meilleure question lors d’une revue n’est pas simplement : « Pourquoi le chiffre a-t-il changé ? » C’est : « Quels tickets ont provoqué ce changement, qu’ont-ils en commun et que ferons-nous différemment ? »
Deskhero vous fournit des données prêtes pour le reporting dès le premier jour
Deskhero transforme les boîtes mail Gmail, Google Workspace et Microsoft 365 connectées en files de tickets partagées. Il accepte également les tickets provenant de formulaires intégrés et de son chatbot IA basé sur la FAQ.
Deskhero inclut un Tableau de bord opérationnel avec des vues du statut des tickets, les tickets en attente d’une première réponse, les tendances du volume de tickets, le délai moyen de première réponse, le délai moyen de résolution et le temps moyen passé dans chaque statut. Sa section Statistiques comporte neuf onglets fixes couvrant la vue d’ensemble, les tendances, les délais de réponse, les SLA, l’équipe, l’IA et l’automatisation, les canaux, les statistiques par sujet et un regroupement par sujets.
Les statistiques peuvent être filtrées par date et par groupe, avec un filtre de politique supplémentaire dans l’onglet SLA. Les cartes de graphiques peuvent basculer entre une vue graphique et une vue tabulaire, et la plupart des onglets peuvent être exportés vers Excel. Les chiffres concernent les groupes auxquels l’Utilisateur connecté peut accéder et sont généralement mis en cache pendant environ cinq minutes. La bande SLA en direct est distincte du respect historique des SLA.
Deskhero n’inclut pas de générateur de rapports personnalisés. Les vues par sujet sont également soumises à des conditions de disponibilité des données : le regroupement par sujets nécessite environ 100 tickets et est reconstruit périodiquement. Un essai gratuit de 30 jours est disponible sans carte bancaire.
Sources
Ce guide s’appuie sur le fonctionnement du reporting documenté dans l’implémentation produit de Deskhero. Les guides Deskhero associés ci-dessous fournissent davantage de contexte sur les tableaux de bord et la réception des tickets.
- Tableaux de bord du support client pour les responsables du support : modèles et KPI
- De l’e-mail au ticket : le guide complet pour les équipes de support
FAQ
Quelles sont les principales métriques du reporting de service desk ?
Commencez par le volume de tickets, le volume créé par rapport au volume résolu, le délai de première réponse, le délai de résolution, le respect des SLA, l’ancienneté du backlog, le taux de réouverture, le taux d’escalade, la charge de travail par Utilisateur et la répartition par canal. Ajoutez les métriques de satisfaction et de coût lorsque leurs données sources sont fiables.
Quels sont les bons KPI pour un helpdesk informatique ?
La première réponse, la résolution, le respect des SLA, la résolution au premier contact, le taux de réouverture et la satisfaction client peuvent tous être des KPI utiles. Choisissez uniquement les métriques liées à un résultat important, à un objectif clair et à une action que l’équipe peut entreprendre.
À quelle fréquence devez-vous envoyer des enquêtes CSAT ?
Choisissez un déclencheur cohérent qui correspond au parcours client, par exemple après la résolution d’un ticket éligible. Faites court, évitez les demandes répétées au même client et indiquez le nombre de réponses et le taux de réponse avec le score.
Quel est un bon taux de résolution au premier contact ?
Il n’existe pas de taux universel pertinent pour toutes les équipes. Définissez ce qui compte comme un premier contact, fixez une période d’observation pour les suivis ou les réouvertures, établissez une référence par catégorie et par canal, puis améliorez ce taux sans encourager les clôtures prématurées.
Comment calcule-t-on le coût par ticket ?
Divisez les coûts de support imputés de manière cohérente sur une période par le nombre de tickets éligibles traités pendant cette période. Documentez les coûts de main-d’œuvre, de logiciels, de prestataires et les frais généraux inclus, puis comparez des périodes et des populations de tickets similaires.