Kā uzturēt tērzēšanas robota zināšanu bāzi: praktisks ceļvedis
Uzturiet tērzēšanas robota zināšanas kā regulāru, uz lomām balstītu procesu: auditēt → atjaunināt → validēt → publicēt → arhivēt. Šis piecu soļu cikls, kas tiek īstenots paredzamā ritmā ar skaidri noteiktu atbildību katrā posmā, atšķir tērzēšanas robotu, kas iemanto klientu uzticību, no tāda, kas to nemanāmi grauj.
Šeit ir īsais kontrolsaraksts, kas jūsu komandai nepieciešams vispirms:
- Avotu kvalitāte: Noņemiet novecojušus, dublētus vai pretrunīgus dokumentus, pirms tie nonāk indeksā.
- Sadalīšana un indeksēšana: Sāciet ar 500–1 000 rakstzīmju fragmentiem, pēc tam pielāgojiet izmēru, pamatojoties uz izgūšanas testiem.
- Izgūšanas iestatījumu pielāgošana: Reizi ceturksnī testējiet un pielāgojiet līdzības sliekšņus, lai precizitāte saglabātos augsta, pieaugot zināšanu bāzei.
- Apstiprināšanas darbplūsma: Katram jaunam vai rediģētam rakstam nepieciešams apstiprinājums, pirms tas kļūst pieejams tērzēšanas robotā.
- Pārraudzības rādītāji: Regulāri sekojiet atbilžu kvalitātei, neatrisinātajiem jautājumiem un pāradresācijām.
- Atgriešana un versiju pārvaldība: Uzturiet izmaiņu žurnālu, lai jebkuru neveiksmīgu atjauninājumu varētu atcelt dažu minūšu laikā.
Kas par ko atbild: Satura īpašnieki veido un atjaunina rakstus. Zināšanu pārzinis nodrošina standartu ievērošanu un veic auditēšanu. Tehniskais īpašnieks rūpējas par sadalīšanu, iegulumiem un izgūšanas iestatījumiem, ja komanda pārvalda šos komponentus. Pārskatītājs pirms katras publicēšanas pārbauda testkopas. Atbilstības speciālisti pārskata saturu, kas attiecas uz regulētām tēmām.
Galvenie secinājumi
Tērzēšanas robota zināšanu uzturēšanai nepieciešams atkārtojams cikls no auditēšanas līdz arhivēšanai, skaidri noteikta atbildība un regulāra pārraudzība, lai novērstu nepilnības, pirms tās pamana klienti.
| Princips | Detalizēta informācija |
|---|---|
| Izmantojiet ciklu no auditēšanas līdz arhivēšanai | Īstenojiet auditēšanu → atjaunināšanu → validēšanu → publicēšanu → arhivēšanu iknedēļas, ikmēneša vai ceturkšņa ritmā, lai novērstu zināšanu bāzes novecošanu. |
| Testējiet fragmentu izmēru | Sāciet izgūšanas fragmentus ar 500–1 000 rakstzīmēm un pielāgojiet tos, pamatojoties uz testu rezultātiem. |
| Uzraugiet lietderīgus kvalitātes signālus | Pārraugiet atbilžu precizitāti, neatrisinātos jautājumus, pāradresācijas un apstiprināti nepareizas atbildes, pēc tam definējiet jūsu pakalpojumam piemērotus sliekšņus. |
| Norīkojiet zināšanu pārzini | Piešķiriet vienai personai skaidru atbildību par redakcionāro kalendāru, pārskatīšanas rindu un uzturēšanas ritmu. |
| Deskhero nodrošina apstiprinātu zināšanu izmantošanu atbildēs | Deskhero tērzēšanas robots atbild tikai no apstiprināta publisko FAQ satura un iesaka FAQ kandidātus, izmantojot atrisinātos pieteikumus un no tīmekļa vietnes iegūtās lapas. |
Satura rādītājs
- Kas ir tērzēšanas robota zināšanu bāze, un kā tā nodrošina atbildes?
- Kāpēc nepārtraukta uzturēšana ir svarīga tērzēšanas robota precizitātei?
- Soli pa solim: praktiska rokasgrāmata tērzēšanas robota zināšanu uzturēšanai
- Standarti, veidnes un pārvaldība uzticamu atbilžu nodrošināšanai
- Ko mērīt un kā rīkoties, reaģējot uz signāliem?
- Rīku izmantošanas modeļi un integrācijas kontrolsaraksts
- Kā Deskhero atbilst šai uzturēšanas rokasgrāmatai
- Uzturēšanas ritms, personāls un izmaksu apsvērumi
- Kā validēt jaunus zināšanu avotus pirms integrācijas?
- Kā izmantot lietotāju atsauksmes, lai uzlabotu tērzēšanas robota zināšanas?
- Ko atbalsta komandas faktiski iemācās, izmantojot šo risinājumu produkcijas vidē?
- Deskhero padara uzturēšanas rokasgrāmatu praktiski izmantojamu jau no pirmās dienas
- Avoti
- BUJ
Kas ir tērzēšanas robota zināšanu bāze, un kā tā nodrošina atbildes?
Tērzēšanas robota zināšanu bāze (KB) nav tikai palīdzības rakstu mape. Tā ir pārvaldīta plūsma: avota dokumenti iziet cauri sadalīšanas posmam, katrs fragments tiek pārveidots skaitliskā vektorā (iegulumā), šie vektori tiek saglabāti vektoru datubāzē, bet izgūšanas sistēma vaicājuma laikā atlasa visatbilstošākos fragmentus. Pēc tam valodas modelis sintezē atbildi no izgūtajiem fragmentiem, balstoties uz jūsu faktisko saturu, nevis uz saviem sākotnējiem apmācības datiem.
Daudzi AI zināšanu tērzēšanas roboti izmanto izgūšanas plūsmu ar fragmentiem, iegulumiem, vektoru datubāzi, izgūšanas sistēmu un valodas modeli. Sistēmas, kas saglabā atsauces uz avotiem, atvieglo atbildes pārbaudi un izsekošanu līdz izmantotajam materiālam.
Labi izveidotas zināšanu bāzes plūsmas galvenie komponenti:
- Avota dokumenti: Zināšanu bāzes raksti, atrisinātie pieteikumi, PDF faili, tīmekļa vietņu lapas, politiku dokumenti.
- Metadati: Atzīmes par tēmu, produkta jomu, auditoriju, pēdējās atjaunināšanas datumu un autoru.
- Iegulumi: Katra fragmenta blīvi vektoru attēlojumi, ko ģenerē iegulumu modelis.
- Vektoru datubāze: Saglabā un indeksē iegulumus ātrai semantiskajai meklēšanai (Pinecone, Weaviate, pgvector un līdzīgi rīki).
- Izgūšanas sistēma: Nosūta vaicājumu vektoru DB un atgriež N visatbilstošākos fragmentus.
- LLM un sistēmas uzvednes: Sintezē izgūtos fragmentus dabiskas valodas atbildē, ievērojot jūsu norādījumus.
- Atsauču slānis: Pievieno katrai atbildei atsauces uz avotiem, lai lietotāji un klienti varētu tās pārbaudīt.
Profesionāļa padoms: Katram rakstam veltiet vienu skaidru tēmu. Sadaliet dokumentus, kas atbild uz vairākiem savstarpēji nesaistītiem jautājumiem. Svarīgs ir arī fragmentu izmērs: sāciet ar 500–1 000 rakstzīmēm un pielāgojiet to, balstoties uz testu rezultātiem. Pārāk mazi fragmenti var zaudēt kontekstu, savukārt pārāk lieli fragmenti var paslēpt svarīgo teikumu.
Kāpēc nepārtraukta uzturēšana ir svarīga tērzēšanas robota precizitātei?
Tērzēšanas robots, kas apmācīts vienreiz un pēc tam atstāts bez uzraudzības, pasliktinās. Produkti mainās, politikas tiek atjauninātas, cenas mainās, un zināšanu bāze nemanāmi atpaliek. Tērzēšanas robots turpina atbildēt, izmantojot novecojušus datus, un klienti to pamana ātrāk nekā jūsu komanda.
Zināšanu bāzes uzturēšana aktuālā stāvoklī var uzlabot atbilžu kvalitāti un palīdzēt lielākam skaitam klientu atrisināt ikdienišķus jautājumus bez pāradresācijas. Konsekvents tonis un apstiprināts formulējums var arī samazināt novēršamas kļūdas. Ja zināšanu bāze tiek uzskatīta par galveno avotu, jaunajiem lietotājiem ir skaidrāks atskaites punkts. Rezultāti joprojām ir atkarīgi no satura kvalitātes, ieviešanas tvēruma un tērzēšanas robota konfigurācijas.
Nevērības riski ir tikpat skaidri:
- Novecojušas atbildes: Tērzēšanas robots, kas atsaucas uz pārtrauktu produktu vai vecu atgriešanas politiku, nekavējoties kaitē uzticamībai.
- Pretrunīgs saturs: Divi raksti, kas uz vienu jautājumu sniedz atšķirīgas atbildes, mulsina izgūšanas sistēmu un rada nekonsekventas atbildes.
- Halucināciju risks: Ja izgūšanas sistēma neatrod neko atbilstošu, slikti konfigurēta sistēma izdomā atbildi. Labi uzturēta zināšanu bāze šo nepilnību samazina.
- Atbilstības riski: Regulētās nozarēs novecojusi atbilde par politiku var radīt nopietnas pārbaudes un atbilstības problēmas.
- Zūdoša uzticība: Klienti, kas divreiz saņem nepareizu atbildi, reti dod robotam trešo iespēju.
Soli pa solim: praktiska rokasgrāmata tērzēšanas robota zināšanu uzturēšanai
Šī ir atkārtojama darbplūsma, ko jūsu komanda var pielāgot iekšējai standarta darbības procedūrai. Nosakiet praktisku ritmu žurnālu pārskatīšanai, satura atjaunināšanai un izgūšanas testēšanai, pēc tam pielāgojiet to tam, cik bieži mainās jūsu produkti un politikas.
-
Ieplānojiet auditu. Iegūstiet iepriekšējā perioda sarunu žurnālus. Atzīmējiet vaicājumus ar zemiem ticamības rādītājiem, eskalācijām un “Es nezinu” rezerves atbildēm. Tās ir jūsu augstākās prioritātes nepilnības.
-
Nosakiet trūkstošo un novecojušo saturu. Salīdziniet atzīmētos vaicājumus ar esošajiem zināšanu bāzes rakstiem. Atzīmējiet rakstus, kuros minētas novecojušas funkcijas, vecas cenas vai beigušās akcijas, lai tos nekavējoties atjauninātu vai arhivētu.
-
Izveidojiet vai atjauniniet kanoniskās atbildes. Katram tematam uzrakstiet vienu rakstu. Izmantojiet klientiem saprotamu valodu, nevis iekšējo žargonu. Obligātie lauki: tēmas nosaukums, tvērums (uz kuru produktu/plānu tas attiecas), paredzētā auditorija, autors, pēdējās atjaunināšanas datums un apstiprinājuma statuss.
-
Sadaliet un izveidojiet iegulumus. Sāciet ar atjaunināto rakstu sadalīšanu 500–1 000 rakstzīmju fragmentos. Pievienojiet metadatu atzīmes (tēma, produkts, valoda, auditorija). Nosūtiet fragmentus caur savu iegulumu modeli un ielādējiet tos vektoru datubāzē testēšanas vidē, nevis produkcijas vidē.
-
Veiciet pakāpeniskas validācijas pārbaudes. Izmantojiet 20–30 reālu vaicājumu testkopu, kas iegūta no žurnāliem. Pārbaudiet, vai katram vaicājumam tiek izgūts pareizais fragments un vai ģenerētā atbilde atbilst kanoniskajai atbildei. Pirms pārejas uz produkcijas vidi nosakiet izgūšanas precizitātes nokārtošanas slieksni.
-
Publicējiet produkcijas vidē ar apstiprināšanas vārtiem. Norīkotais apstiprinātājs (zināšanu pārzinis vai komandas vadītājs) pārskata testa rezultātus un apstiprina publicēšanu. Reģistrējiet publicēšanas notikumu ar laika zīmogu, autora vārdu un versijas numuru.
-
Pārraugiet pēc publicēšanas. Pēc jebkura būtiska atjauninājuma rūpīgi sekojiet atbilžu kvalitātei un pāradresācijām. Ja rādītājs samazinās vai pārbaudes atklāj nepareizas atbildes, atceliet izmaiņas, izmantojot versiju vēsturi.
-
Arhivējiet novecojušo saturu. Arhivējiet, nevis dzēsiet to, lai saglabātu neskartu versiju vēsturi. Atjauniniet visus rakstus, kuros bija atsauces uz arhivēto saturu.
Profesionāļa padoms: Ja platforma to atbalsta, pieprasiet faktu atbildēm atsauces uz avotiem. Apvienojiet to ar skaidru rezerves norādi: ja izgūšanas sistēma neatgriež pietiekami atbilstošu saturu, tērzēšanas robotam jāpasaka, ka tas nevar atbildēt, un jāpiedāvā pāradresācija cilvēkam, nevis jāmin.
Profesionāļa padoms: Katrā posmā kvalitāte ir svarīgāka par daudzumu. Pieci līdz desmit labi uzrakstīti, koncentrēti dokumenti veido spējīgāku asistentu nekā piecdesmit vāji strukturēti dokumenti. Pirms indeksēšanas rūpīgi izsijājiet saturu.
Standarti, veidnes un pārvaldība uzticamu atbilžu nodrošināšanai
Laba pārvaldība nav birokrātija birokrātijas dēļ. Uz cilvēku orientēta pieeja AI sākas ar sistēmas ietekmēto cilvēku vajadzībām un labklājību. Klientiem paredzētā tērzēšanas robotā dokumentēti apstiprinājumi, versiju vēsture un izmaiņu piezīmes padara pārskatīšanu un atbildību praktiski īstenojamu.
Redakcionālie standarti, kuriem jāatbilst katram rakstam
- Viena tēma, viena atbilde. Neviens raksts neaptver vairāk nekā vienu atsevišķu jautājumu.
- Klientiem saprotama valoda. Rakstiet tā, kā jautātu klients, nevis tā, kā dokumentētu inženieris.
- Obligātie lauki: Tēmas nosaukums, tvērums, auditorija, autors, pēdējās atjaunināšanas datums, apstiprinājuma statuss, versijas numurs un īsa izmaiņu piezīme.
- Nav dublētu datu. Ja ievades plūsma jau iegūst aktuālās cenas no jūsu galvenās sistēmas, neierakstiet šo cenu statiski zināšanu bāzes rakstā. Tā novecos.
- Proaktīva žurnālu pārskatīšana. Pārskatiet sarunu žurnālus noteiktā ritmā, lai atrastu nepilnības, pirms par tām ziņo klienti.
Pārvaldības lomas
- Satura īpašnieks: Jomas eksperts, kas savā jomā veido un atjaunina rakstus.
- Zināšanu pārzinis: Nodrošina standartu ievērošanu, veic auditēšanu, pārvalda rakstu dzīves ciklu un atbild par redakcionāro kalendāru.
- Apstiprinātājs: Komandas vadītājs vai vadītājs, kas apstiprina katru rakstu pirms tā publicēšanas.
- ML īpašnieks: Rūpējas par sadalīšanas parametriem, iegulumu modeļa atjauninājumiem, izgūšanas konfigurāciju un testkopas uzturēšanu.
- Atbilstības pārskatītājs: Nepieciešams apstiprinājums rakstiem, kas skar regulētas tēmas (cenas, juridiskos noteikumus, datu privātumu).
Uzticības signāli, ko ieviest nekavējoties
- Auditācijas žurnāli, kuros ar laika zīmogu un lietotāja ID tiek reģistrēta katra izveides, rediģēšanas, apstiprināšanas un arhivēšanas darbība.
- Versiju vēsture ar izmaiņu salīdzināšanas skatiem, lai katru izmaiņu varētu pārskatīt.
- Katram rakstam pievienoti izmaiņu žurnāli, kuros norādīts, kas un kāpēc mainīts.
- Apstiprinājuma zīmogi, kas redzami zināšanu bāzes administrēšanas vidē, lai komanda varētu redzēt, kas ir un kas nav apstiprināts izmantošanai tērzēšanas robotā.
- Avotu citāti, kas tiek parādīti katrā tērzēšanas robota atbildē.
Ko mērīt un kā rīkoties, reaģējot uz signāliem?
Pārraudzība ir vieta, kur tiek pieņemti lēmumi par uzturēšanu. Bez rādītājiem jūs tikai minat, kuri raksti jāatjaunina. Ar tiem jums katru nedēļu ir prioritizēta darbu rinda.
Galvenie uzraugāmie rādītāji:
- Atbilžu precizitāte / pareizība: To tērzēšanas robota atbilžu procentuālā daļa, kas atbilst kanoniskajai atbildei atlasītā testkopā.
- Balstīšanās uz avotiem: To atbilžu procentuālā daļa, kurās norādīts konkrēts avota fragments. Kritums šajā rādītājā liecina par izgūšanas sistēmas novirzi vai trūkstošu saturu.
- Novirzīšanas īpatsvars: To sarunu procentuālā daļa, kas atrisinātas bez lietotāja iesaistes. Pieaugošas eskalācijas bieži ir saistītas ar konkrētu zināšanu bāzes nepilnību.
- Eskalāciju īpatsvars: Novirzīšanas īpatsvara pretstats; sekojiet tam pa tēmu kategorijām, lai precīzi noteiktu, kurām satura jomām jāpievērš uzmanība.
- Laiks līdz atjaunināšanai: Cik ilgs laiks paiet no nepilnības noteikšanas līdz pārbaudīta labojuma publicēšanai.
- CSAT robotam: Klientu apmierinātības rādītājs tieši tām sarunām, kuras apstrādājis tērzēšanas robots.
- Halucināciju gadījumi: Apstiprināto gadījumu skaits, kad robots sniedzis faktoloģiski nepareizu atbildi, kas nav balstīta nevienā avotā.
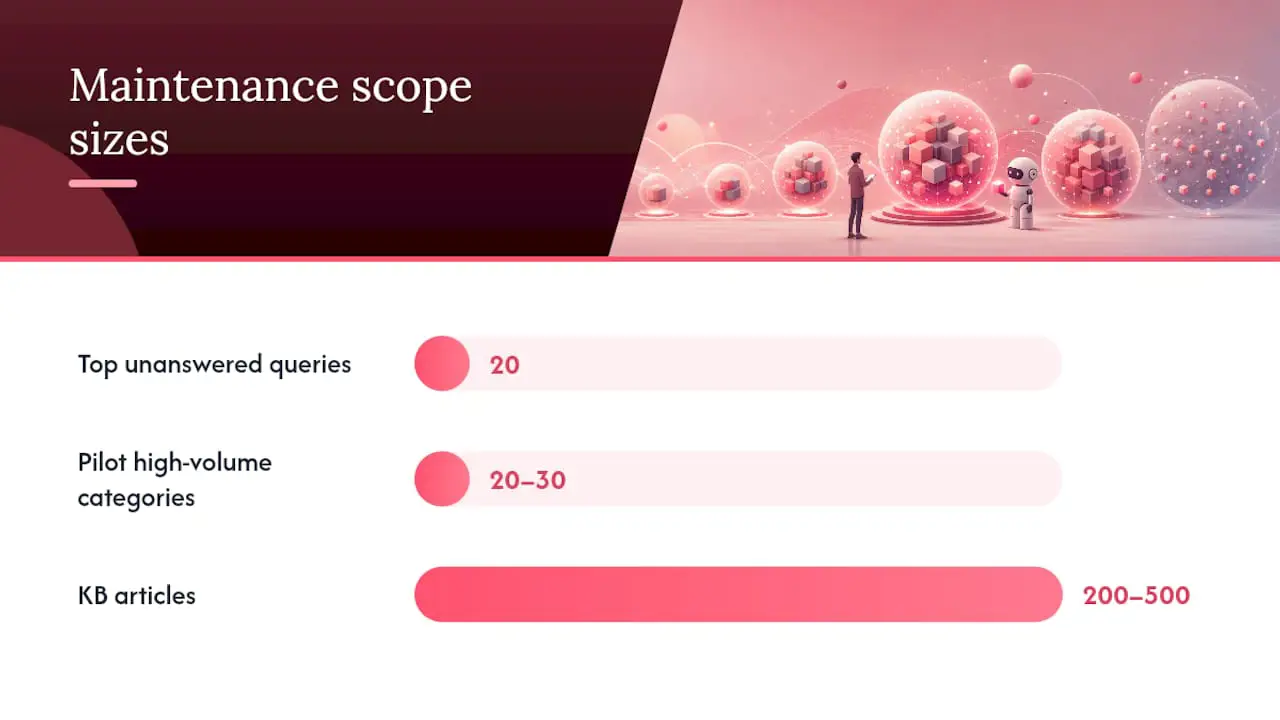
Vispraktiskākais žurnālu izmantošanas veids ir katru nedēļu izveidot 20 visbiežāk neatbildēto vaicājumu sarakstu. Sakārtojiet tos pēc biežuma, piešķiriet katru satura īpašniekam un sekojiet laikam līdz atrisināšanai. Šis saraksts kļūst par jūsu uzturēšanas darbu uzkrājumu.
Rīku izmantošanas modeļi un integrācijas kontrolsaraksts
Piemēroti rīki padara iepriekš aprakstīto rokasgrāmatu atkārtojamu bez varonīgas manuālas piepūles. Izvērtējot platformas un integrācijas modeļus, piešķiriet prioritāti šīm iespējām:
- Inkrementāla indeksēšana: Sistēma var atjaunināt atsevišķus fragmentus, nepārindeksējot visu zināšanu bāzi. Tas ir būtiski lielām zināšanu bāzēm, kur pilna pārindeksēšana ir lēna un dārga.
- Iegulumu atjaunošana: Iespēja no jauna ģenerēt atjaunināto rakstu iegulumus, neietekmējot nemainīto saturu.
- Izcelsmes un citēšanas atbalsts: Katram izgūtajam fragmentam ir avota atsauce, kas tiek parādīta atbildē.
- Lomu piekļuves kontrole: Satura īpašniekiem, apstiprinātājiem un ML inženieriem ir atšķirīgas atļaujas. Platformai tas jānodrošina.
- Auditācijas žurnāli: Katrs indeksēšanas notikums, satura izmaiņa un apstiprinājums tiek reģistrēts ar laika zīmogu un lietotāju.
- Tīmekļa aizķeres pieteikumu sistēmai: Kad pieteikums ir atrisināts, tīmekļa aizķere var aktivizēt zināšanu bāzes pārskatīšanu vai automātiski izveidot raksta kandidāta melnrakstu. Tas noslēdz saikni starp atbalsta darbībām un zināšanu uzturēšanu.
- SSO: Google un Microsoft SSO samazina berzi komandām, kas jau darbojas šajās ekosistēmās.
Integrācijas modeļi, kas darbojas produkcijas vidē
Tiešā zināšanu bāzes sinhronizācija: Zināšanu bāzes platforma pēc grafika vai publicēšanas brīdī nosūta atjauninātos rakstus uz vektoru DB. Tas ir vienkāršs un uzticams risinājums, ar ko būtu jāsāk lielākajai daļai komandu.
Pakāpeniska indeksēšana smilškastes vidē: Jauns vai atjaunināts saturs vispirms tiek indeksēts testēšanas vidē. Testu kopa tiek izpildīta testēšanas vidē, pirms jebkuras izmaiņas nonāk produkcijas vidē. Tas ir zināšanu saturam līdzvērtīgs CI konveijeram.
CI līdzīgas validācijas plūsmas: Izturieties pret zināšanu bāzes izmaiņām kā pret koda izmaiņām. Satura atjauninājums aktivizē automatizētu testa izpildi, izmantojot jūsu 20–30 vaicājumu testkopu. Kļūmes aptur publicēšanu. Veiksmīgi testi tiek nodoti apstiprinātājam galīgai apstiprināšanai.
Galvenie kompromisi, kas jāizprot
RAG ir piemērotākā arhitektūra lielākajai daļai atbalsta komandu ar bieži mainīgām zināšanām. Jūs atjaunināt dokumentus, nevis modeļa svarus, tādējādi saglabājot izmaksas pārvaldāmas un atjaunināšanas ciklus īsus. Precīza pielāgošana ir lietderīga statiskām, ļoti specializētām jomām, kurās vārdu krājums un spriešanas modeļi ir stabili. Darbības izmaksu atšķirība ir būtiska: RAG atjauninājums ir dokumenta rediģēšana un atkārtota indeksēšana; precīzas pielāgošanas ciklam nepieciešami marķēti dati, skaitļošanas laiks un pilna modeļa novērtēšana pirms ieviešanas.
Runājot par latentumu un aktualitāti, biežāka iegulumu atjaunošana saglabā atbildes aktuālas, taču palielina skaitļošanas izmaksas. Izvēlieties atjaunošanas grafiku, ņemot vērā avota materiāla izmaiņu biežumu, un pēc svarīgiem atjauninājumiem veiciet validāciju.
Kā Deskhero atbilst šai uzturēšanas rokasgrāmatai
Deskhero ir veidots, balstoties uz principu, ka tērzēšanas robotam jāatbild tikai no zināšanām, kuras esat skaidri apstiprinājuši. Tas tieši atbilst šajā rokasgrāmatā aprakstītajiem pārvaldības un validācijas posmiem.
Lūk, kā konkrētie rokasgrāmatas posmi ir saistīti ar Deskhero funkcijām:
- Atbildes tikai no apstiprinātām zināšanām: Deskhero AI tērzēšanas robots atbild, izmantojot apstiprinātu publisko FAQ saturu. Citas darbvietas zināšanas netiek izmantotas klientiem paredzētajās tērzēšanas robota atbildēs. Lai iespējotu tērzēšanas robotu, nepieciešami vismaz 100 apstiprināti publiskā FAQ ieraksti.
- FAQ ieteikumi no atrisinātiem pieteikumiem: Atrisinātos pieteikumus un no tīmekļa vietnes iegūtās lapas var pārveidot par FAQ ierakstu kandidātiem. Lietotājs pārskata un apstiprina ierakstu, pirms tas kļūst pieejams tērzēšanas robotam.
- Atsevišķi zināšanu tvērumi: Iekšējā zināšanu bāze var sniegt informāciju AI atbilžu ieteikumiem lietotājiem. Klientiem paredzētajās tērzēšanas robota atbildēs tiek izmantots tikai apstiprinātais publiskais FAQ.
- Divvirzienu e-pasta sinhronizācija: Klientu jautājumi tiek saņemti pa e-pastu, veidlapā vai tērzēšanas robotā un kļūst par pieteikumiem koplietotā iesūtnē. Atbildes var nosūtīt no uzņēmuma pievienotās adreses.
- Marķētas automātiskās darbības: Automātiskās darbības tiek marķētas un reģistrētas, bet pilnībā automātiska nosūtīšana ir aktivizējama pēc izvēles.
- REST API: Deskhero nodrošina REST API pieteikumu un darbvietas darbībām. Tas nenodrošina izejošās tīmekļa aizķeres.
- Daudzvalodu saskarne: Deskhero saskarne ir pieejama 14 atbalstītās valodās, un tērzēšanas robota izgūšanas sistēma var saskaņot publiskā FAQ saturu dažādās valodās.
Deskhero savieno Gmail, Google Workspace vai Microsoft 365 pastkastes ar koplietojamu palīdzības dienestu, ļaujot komandai saglabāt esošās e-pasta adreses. Klientiem paredzētais AI atbild, izmantojot apstiprinātu publisko FAQ saturu, un pāradresē neatrisinātos jautājumus cilvēkam. FAQ ieteikumus var sagatavot no atrisinātiem pieteikumiem un no tīmekļa vietnes iegūtām lapām, taču lietotājam tie ir jāpārskata pirms apstiprināšanas. Automātiskās darbības tiek marķētas un reģistrētas. Platformā ir arī iekšējā zināšanu bāze, pieteikumu ieskati, 14 saskarnes valodas, Shopify integrācija, Google un Microsoft SSO, kā arī REST API. Darbu var sākt ar 30 dienu bezmaksas izmēģinājumu, kredītkarte nav nepieciešama.
Tā kā Deskhero tērzēšanas robots ir ierobežots līdz apstiprinātajam publiskajam FAQ, uzturēšanas uzdevums ir konkrēts: pārskatiet neatrisinātos jautājumus, uzlabojiet vai pievienojiet FAQ ierakstus, apstipriniet tos un pārbaudiet, vai atjauninātās zināšanas atbild uz paredzētajiem jautājumiem.
Lai padziļināti uzzinātu, kā AI tērzēšanas roboti šāda veida darbplūsmā apstrādā eskalāciju un pāradresāciju cilvēkam, tērzēšanas robota pāradresācijas cilvēkam rokasgrāmatā detalizēti aplūkoti darbības modeļi.
Uzturēšanas ritms, personāls un izmaksu apsvērumi
Plānojot cilvēkus un laiku, kas nepieciešams tērzēšanas robota zināšanu pārvaldībai, lielākā daļa komandu nenovērtē darba apjomu. Labā ziņa: neliela komanda ar skaidri noteiktu ritmu var uzturēt produkcijas zināšanu bāzi bez īpaši šim nolūkam paredzēta darbinieka.
Ieteicamais ritms:
- Katru nedēļu: Pārskatiet sarunu žurnālus, izveidojiet 20 visbiežāk neatbildēto vaicājumu sarakstu, atzīmējiet steidzamas satura nepilnības un nosūtiet augstas prioritātes labojumus apstiprināšanai.
- Katru mēnesi: Veiciet pilnu satura atjaunināšanas ciklu. Veidojiet jaunus rakstus, atjauniniet mainītās politikas vai produktus, arhivējiet novecojušo saturu un izpildiet pilno testu kopu.
- Katru ceturksni: Veiciet politiku un produktu izmaiņu pārskatīšanu, izgūšanas iestatījumu pielāgošanu, iegulumu modeļa novērtēšanu un pārvaldības auditu (vai visi raksti ir pienācīgi apstiprināti un aprīkoti ar versijām?).
Minimālais personāla modelis mazām komandām:
- Zināšanu pārzinis: Atbild par redakcionāro kalendāru, veic auditēšanu, nodrošina standartu ievērošanu un pārvalda apstiprināšanas rindu. Nepieciešamais laiks ir atkarīgs no satura apjoma un izmaiņu biežuma.
- Tehniskais atbalsts: Rūpējas par sadalīšanas parametriem, iegulumu atjaunošanu, izgūšanas konfigurāciju un testu kopas uzturēšanu, ja komanda pati pārvalda izgūšanas steku.
- Mainīgi jomas eksperti: Katrai produkta vai politikas jomai ir norīkots satura īpašnieks, kas pārskata un apstiprina savas jomas rakstus. Parasti tas ir nepilna laika pienākums, kas tiek pievienots esošajai lomai.
Novērtējamie izmaksu faktori:
- Vektoru datubāzes glabāšanas un vaicājumu izmaksas pieaug līdz ar zināšanu bāzes izmēru un vaicājumu skaitu.
- Iegulumu atjaunošanas biežums ietekmē skaitļošanas izmaksas, tāpēc, ja platforma atbalsta inkrementālus atjauninājumus, atjaunojiet mainīto saturu.
- Cilvēku pārskatīšanas laiks var būt būtiska izmaksu pozīcija, īpaši tad, ja produkti vai politikas mainās bieži.
- Rīku abonementu izmaksas dažādās platformās atšķiras. Platformas, kas zināšanu bāzes pārvaldību, pieteikumu apstrādi un tērzēšanas robotu apvieno vienā abonementā (nevis pieprasa atsevišķu vektoru DB, LLM API un palīdzības dienesta rīku izmantošanu), samazina gan izmaksas, gan integrācijas sarežģītību.
Pētījumos par ģeneratīvo AI klientu atbalstā ir konstatēti produktivitātes ieguvumi reālā atbalsta vidē. Uztveriet šos secinājumus kā kontekstu, nevis personāla plānošanas formulu, jo zināšanu uzturēšanas izmaksas un ieguvumi ir atkarīgi no komandas, satura un rīkiem.
Izmēģinājums ar nelielu tvērumu: Sāciet ar 20–30 biežākajām jautājumu kategorijām. Vispirms izveidojiet un uzturiet šo kategoriju rakstus. Pirms zināšanu bāzes paplašināšanas pārbaudiet, vai atbilžu kvalitāte uzlabojas. Tas saglabā sākotnējo uzturēšanas slogu nelielu un vairo iekšējo pārliecību par procesu.
Kā validēt jaunus zināšanu avotus pirms integrācijas?
Ne katrs noderīgs izskatīgs dokuments pieder tērzēšanas robota indeksam. Nekvalitatīva vai neprecīza avota integrēšana pasliktina visas zināšanu bāzes darbību, jo izgūšanas sistēma nespēj atšķirt labi pamatotu rakstu no slikti uzrakstīta.
Pirms indeksēšanas pārbaudiet katru kandidāta avotu:
Precizitātes pārbaude: Vai saturs atspoguļo pašreizējo produkta darbību, politiku vai cenas? Salīdziniet to ar galveno sistēmu (jūsu CRM, produkta dokumentāciju vai juridiskās komandas apstiprinātajiem politiku dokumentiem). Ja apgalvojumu nevarat pārbaudīt primārajā avotā, neindeksējiet to.
Tvēruma pārbaude: Vai saturs attiecas uz jautājumiem, uz kuriem jūsu tērzēšanas robotam jāatbild? Plašā nozares publikācijā var būt precīza informācija, taču tā var radīt neatbilstošu izgūšanas troksni. Stingri pielāgojiet dokumentu tvērumu savam izmantošanas gadījumam.
Dublēšanās pārbaude: Vai šis saturs būtiski pārklājas ar esošu zināšanu bāzes rakstu? Dublēts saturs rada izgūšanas neskaidrību. Pirms indeksēšanas apvienojiet vai konsolidējiet to.
Formāta un struktūras pārbaude: Vai dokuments ir strukturēts tā, lai sadalīšana radītu sakarīgus, patstāvīgus fragmentus? Dokuments ar daudzām savstarpējām atsaucēm (“detalizētu informāciju skatiet 4.2. sadaļā”) tiek slikti sadalīts, jo atsevišķi fragmenti zaudē kontekstu. Pirms indeksēšanas pārrakstiet vai pārstrukturējiet to.
Izcelsmes pārbaude: Vai varat izsekot saturam līdz autoritatīvam iekšējam vai ārējam avotam? Regulētām tēmām skaidri norādiet avotu raksta metadatos.
Testēšana: Indeksējiet jauno avotu testēšanas vidē un izpildiet standarta 20–30 vaicājumu testkopu. Pārbaudiet, vai jaunais saturs uzlabo, pasliktina vai neietekmē izgūšanas precizitāti. Uz produkcijas vidi pārvietojiet tikai avotus, kas precizitāti uzlabo vai saglabā.
Kā izmantot lietotāju atsauksmes, lai uzlabotu tērzēšanas robota zināšanas?
Lietotāju atsauksmes ir vistiešākais signāls par to, kur zināšanu bāze nedarbojas. Sarežģītākais ir tās sistemātiski apkopot, nevis reaģēt uz skaļākajām sūdzībām.
Īkšķis uz augšu/uz leju pie tērzēšanas robota atbildēm ir vienkāršākais atsauksmju mehānisms. Katrai tērzēšanas robota atbildei jābūt pieejamai binārai vērtējuma opcijai. Apkopojiet šos datus katru nedēļu. Atbilde ar lielu negatīvo vērtējumu īpatsvaru ir tiešs signāls zināšanu bāzes pārskatīšanai neatkarīgi no tā, vai autora komandai atbilde šķita pareiza.
Pēc sarunas veiktās CSAT aptaujas sniedz plašāku signālu. Zemi vērtējumi sarunām, ko apstrādājis robots, filtrējot pēc tēmas kategorijas, parāda, kurām satura jomām nepieciešama vislielākā uzmanība. Apvienojiet CSAT datus ar eskalāciju žurnāliem, lai noskaidrotu, vai problēma ir zināšanu bāzes nepilnība vai izgūšanas konfigurācijas problēma.
Atgriezeniskās saites cikli ar atbalsta komandu ir vērtīgi. Lietotāji, kas apstrādā eskalācijas, bieži zina, kāpēc robots kļūdījās. Vienkārša marķēšanas sistēma pieteikumu rīkā, piemēram, “nepareiza atbilde”, “trūkst atbildes” vai “novecojusi politika”, var pārvērst šo pieredzi strukturētā uzturēšanas signālā.
Skaidri “Es nezinu” žurnāli ir zelta raktuves. Ikreiz, kad tērzēšanas robots pāradresē sarunu, jo nav atradis atbilstošu saturu, reģistrējiet vaicājumu. Katru nedēļu sakārtojiet tos pēc biežuma. Šī saraksta biežākie vaicājumi ir jūsu augstākās prioritātes satura veidošanas uzdevumi.
Periodiskas lietotāju aptaujas par zināšanu bāzes kvalitāti (nosūtītas klientiem, kas pēdējo 30 dienu laikā mijiedarbojušies ar tērzēšanas robotu) atklāj sistēmiskas problēmas, ko atsevišķu sarunu vērtējumi neparāda. Ierobežojiet aptauju līdz diviem vai trim jautājumiem un sasaistiet atbildes ar sarunu ID, lai atsauksmes varētu izsekot konkrētiem rakstiem.
Atsauksmju cikls noslēdzas, kad atzīmēts vaicājums kļūst par zināšanu bāzes rakstu, raksts iziet apstiprināšanas darbplūsmu un tērzēšanas robota atbilde uz šo vaicājumu uzlabojas. Šī cikla laika uzskaite (no signāla līdz labojumam) ir viens no noderīgākajiem darbības rādītājiem, par ko var atbildēt zināšanu pārzinis.
Ko atbalsta komandas faktiski iemācās, izmantojot šo risinājumu produkcijas vidē?
Iepriekš aprakstītā rokasgrāmata teorijā ir pareiza. Lūk, kas praksē nedarbojas un kā to ātri novērst.
Sāciet ar mazu apjomu un pirms mērogošanas pierādiet vērtību. Visu pieejamo dokumentu indeksēšana uzreiz var radīt uzpūstu zināšanu bāzi un apgrūtināt noderīga kvalitātes sākuma līmeņa noteikšanu. Izvēlieties 20–30 biežākās jautājumu kategorijas, izveidojiet tām kvalitatīvus rakstus un darbiniet tērzēšanas robotu šaurā tvērumā. Paplašiniet to pēc tam, kad testi parāda, ka atbildes ir precīzas un noderīgas.
Skaidri pārvaldiet laika ziņā ierobežotu saturu. Akcijas, sezonas politikas un ierobežota laika piedāvājumi var viegli novecot. Izveidojiet atsevišķu metadatu atzīmi laika ziņā ierobežotam saturam un satura izveides brīdī nosakiet obligātu derīguma pārskatīšanas datumu.
Regulāri reģistrējiet un uzraugiet nezināmās atbildes. Bieža “Es nezinu” žurnāla pārskatīšana palīdz komandām pamanīt atkārtotas nepilnības, pirms tās uzkrājas. Izmantojiet vaicājumu biežumu un ietekmi uz klientiem, lai prioritizētu labojumus.
Profesionāļa padoms: Atrisinātie pieteikumi ir noderīgs kanonisko atbilžu avota materiāls, jo tie parāda, kā komanda rīkojusies ar reāliem jautājumiem. Deskhero periodiski izmanto atrisinātos pieteikumus kā avota materiālu FAQ ieteikumiem. Lietotājs var pārskatīt, rediģēt, apstiprināt vai noraidīt katru ieteikumu, pirms apstiprinātais saturs kļūst pieejams tērzēšanas robotam.
Ātri uzlabojumi komandām, kas tikai sāk darbu:
- Jau pirmajā dienā ieviesiet rakstu nosaukumu veidošanas standartu (Produkta joma: tēma: auditorija). 200 rakstu pārdēvēšana ar atpakaļejošu datumu ir sāpīgs process.
- Izveidojiet metadatu veidni ar obligātajiem laukiem un ielīmējiet to katrā jaunā rakstā pirms rakstīšanas.
- Izveidojiet 20–30 reālu vaicājumu testkopu no sākotnējiem sarunu žurnāliem un izpildiet to pirms katras publicēšanas produkcijas vidē.
Deskhero padara uzturēšanas rokasgrāmatu praktiski izmantojamu jau no pirmās dienas
Šīs rokasgrāmatas īstenošana, izmantojot savstarpēji nesaistītus rīkus, var radīt papildu koordinācijas darbu. Deskhero vienā palīdzības dienestā apvieno publiskā FAQ pārskatīšanas darbplūsmu, FAQ ieteikumus un klientu sarunas.
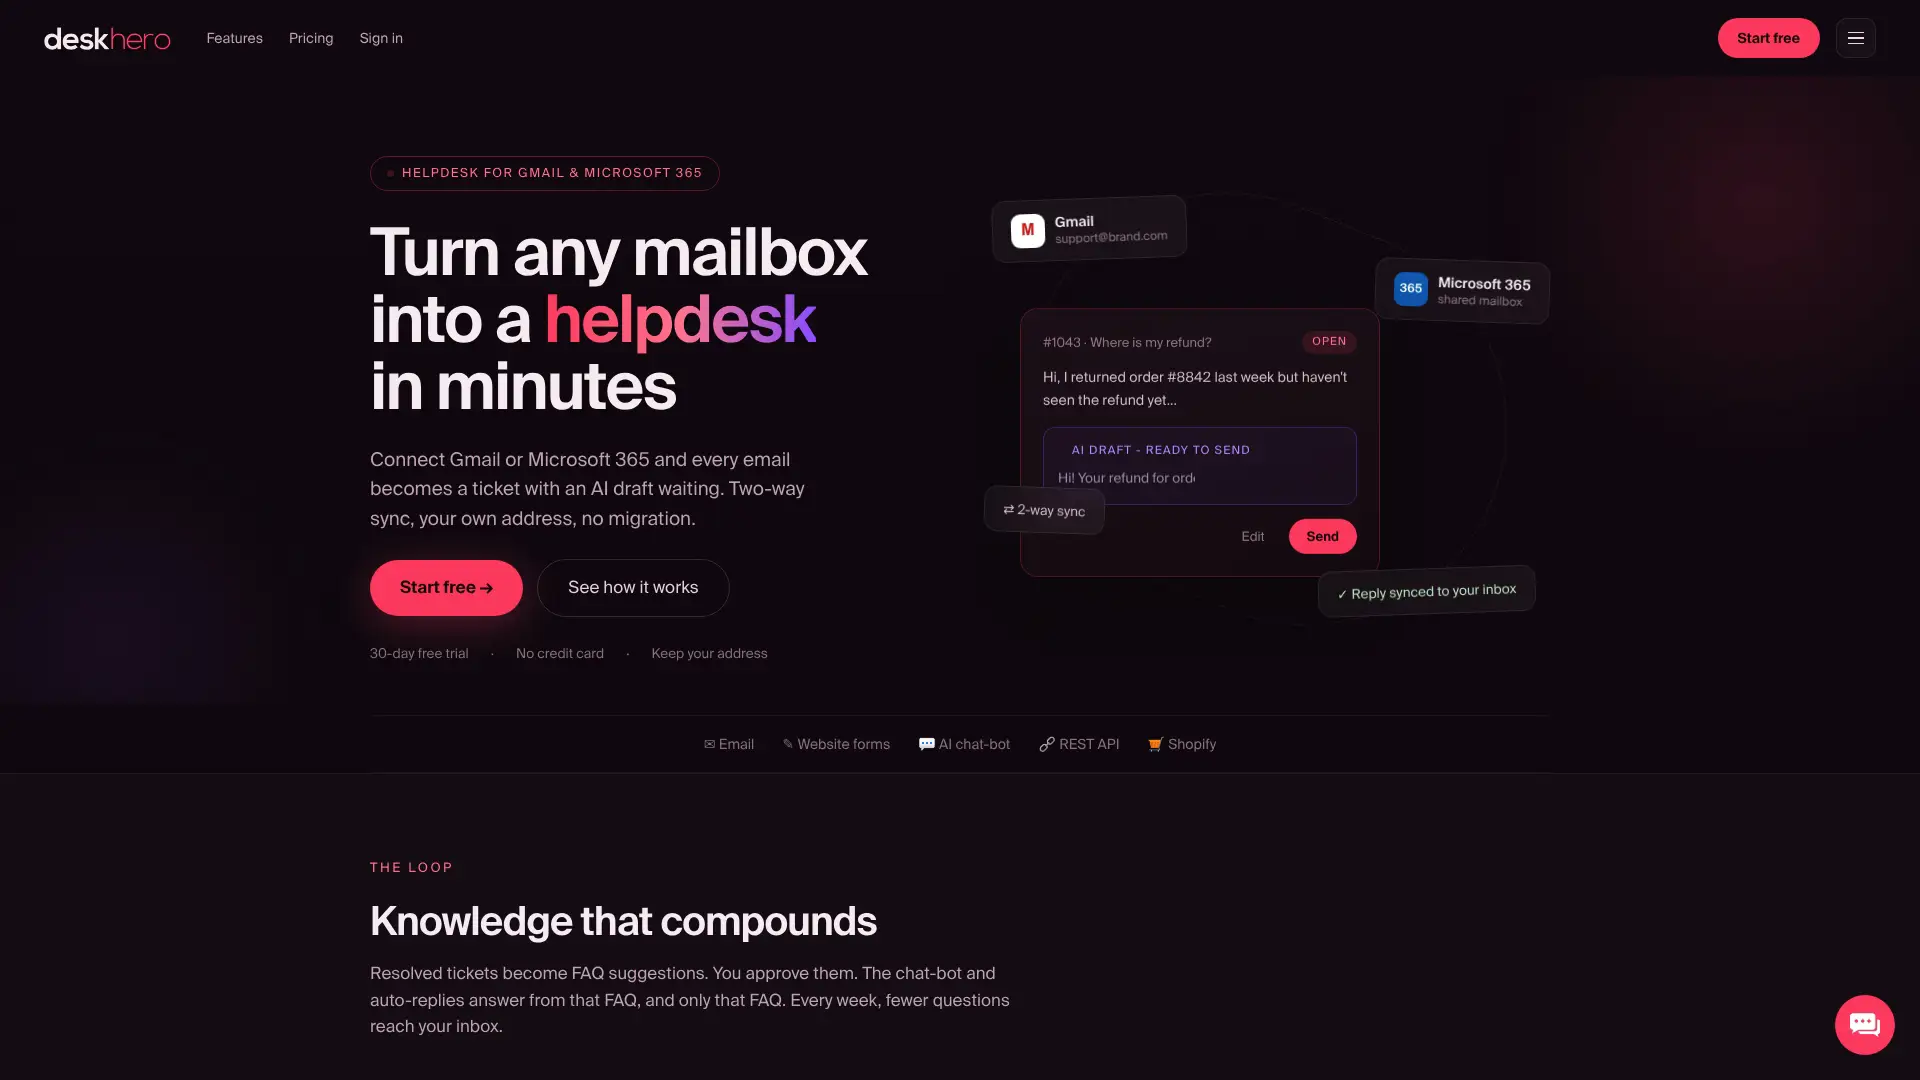
Tērzēšanas robots atbild tikai no apstiprināta publiskā FAQ satura, savukārt AI atbilžu ieteikumi lietotājiem var izmantot plašākas darbvietas zināšanas. FAQ ieteikumi no atrisinātiem pieteikumiem un no tīmekļa vietnes iegūtām lapām samazina darbu, kas nepieciešams satura izveidei no nulles, taču tiem joprojām nepieciešama cilvēka pārskatīšana. Divvirzienu pastkastes integrācija saglabā pieteikumu un atbilžu saikni ar komandas esošo adresi.
Komandām, kas vēlas šo darbplūsmu ieviest, neveidojot pielāgotu izgūšanas steku, Deskhero apvieno koplietojamo iesūtni, publisko FAQ, tērzēšanas robotu un pāradresāciju cilvēkam. Sāciet 30 dienu bezmaksas izmēģinājumu vietnē Deskhero, kredītkarte nav nepieciešama.
Avoti
Izmantojiet tos kā ieviešanas atsauces, pieņemot tehniskus lēmumus par sadalīšanas stratēģiju, apmācības pieeju, pārvaldības politiku un mērījumu iestatījumiem.
BUJ
Kas ir tērzēšanas robota zināšanu bāze?
Tērzēšanas robota zināšanu bāze ir pārvaldīts avota dokumentu kopums, kas sadalīts fragmentos, pārveidots vektoru iegulumos un saglabāts vektoru datubāzē, lai izgūšanas sistēma vaicājuma laikā varētu atlasīt visatbilstošāko saturu un balstīt tērzēšanas robota atbildes jūsu faktiskajā saturā.
Kā laika gaitā uzturēt tērzēšanas robotu?
Īstenojiet atkārtojamu ciklu: auditējiet sarunu žurnālus, lai atrastu nepilnības, atjauniniet vai izveidojiet kanoniskos rakstus, sadaliet un izveidojiet iegulumus testēšanas vidē, validējiet tos, izmantojot 20–30 vaicājumu testkopu, saņemiet apstiprinātāja piekrišanu, publicējiet produkcijas vidē un pārraugiet atbilžu kvalitāti un pāradresācijas, lai konstatētu regresijas.
Ko nekad nevajadzētu ievadīt tērzēšanas robotā?
Neievadiet sensitīvus personas datus (sociālās apdrošināšanas numurus, paroles, finanšu kontu informāciju) nevienā tērzēšanas robota saskarnē, jo ievadītā informācija var tikt reģistrēta vai izmantota modeļa apmācībā atkarībā no platformas datu apstrādes politikas. Iekšējās zināšanu bāzes satura veidošanā nekad neierakstiet statiskus aktuālos datus (cenas, krājumus), kurus ievades plūsma var iegūt tieši no galvenās sistēmas.
Cik maksā tērzēšanas robota uzturēšana?
Galvenās izmaksas veido pārskatīšanas laiks, izgūšanas un iegulumu aprēķinu izmaksas, ja šie komponenti tiek pārvaldīti tieši, kā arī palīdzības dienesta vai zināšanu platformas abonements. Aprēķiniet tās, ņemot vērā satura apjomu, vaicājumu skaitu, atjaunināšanas biežumu un nepieciešamo cilvēku pārskatīšanas apjomu.