Chatbotkennis onderhouden: een praktisch stappenplan
Onderhoud chatbotkennis als een terugkerend, rolgebaseerd proces: auditen → bijwerken → valideren → publiceren → uitfaseren. Die cyclus van vijf stappen, uitgevoerd volgens een voorspelbaar ritme met duidelijk eigenaarschap bij elke controle, maakt het verschil tussen een chatbot die het vertrouwen van klanten wint en een chatbot die dat vertrouwen stilletjes afbreekt.
Hier is de korte checklist die je team nodig heeft voordat je iets anders doet:
- Bronhygiëne: Verwijder verouderde, dubbele of tegenstrijdige documenten voordat ze de index bereiken.
- Chunking en indexering: Begin met chunks van 500 tot 1.000 tekens en pas de omvang vervolgens aan op basis van retrievaltests.
- Retriever-afstemming: Test en pas de similaritydrempels elk kwartaal aan, zodat de precisie hoog blijft naarmate de KB groeit.
- Goedkeuringsworkflow: Elk nieuw of bewerkt artikel heeft goedkeuring nodig voordat het live gaat in de chatbot.
- Monitoringstatistieken: Houd antwoordkwaliteit, onopgeloste vragen en overdrachten volgens een vast schema bij.
- Rollback en versiebeheer: Houd een changelog bij, zodat elke slechte update binnen enkele minuten kan worden teruggedraaid.
Wie is waarvoor verantwoordelijk: Content owners schrijven en actualiseren artikelen. Een knowledge steward bewaakt de standaarden en voert audits uit. Een technische eigenaar beheert chunking, embeddings en retrievalinstellingen wanneer het team die onderdelen beheert. Een reviewer voert testsets uit vóór elke publicatie. Compliance-specialisten beoordelen content over gereguleerde onderwerpen.
Belangrijkste punten
Het onderhouden van chatbotkennis vereist een herhaalbare cyclus van audit tot uitfasering, duidelijk eigenaarschap en regelmatige monitoring om hiaten op te sporen voordat klanten dat doen.
| Punt | Details |
|---|---|
| Gebruik de cyclus van audit tot uitfasering | Voer audit → bijwerken → valideren → publiceren → uitfaseren wekelijks/maandelijks/per kwartaal uit om KB-drift te voorkomen. |
| Test de chunkgrootte | Begin met retrievalchunks van 500 tot 1.000 tekens en pas ze aan op basis van testresultaten. |
| Houd nuttige kwaliteitssignalen bij | Monitor antwoordnauwkeurigheid, onopgeloste vragen, overdrachten en bevestigde onjuiste antwoorden en definieer vervolgens drempelwaarden die bij je service passen. |
| Wijs een knowledge steward aan | Geef één persoon duidelijke verantwoordelijkheid voor de redactionele kalender, beoordelingswachtrij en onderhoudsfrequentie. |
| Deskhero dwingt antwoorden op basis van goedgekeurde kennis af | De chatbot van Deskhero beantwoordt vragen alleen op basis van goedgekeurde openbare FAQ-content en stelt FAQ-kandidaten voor uit opgeloste tickets en gescrapete webpagina’s. |
Inhoudsopgave
- Wat is een chatbot-knowledgebase en hoe levert die antwoorden?
- Waarom continu onderhoud belangrijk is voor de nauwkeurigheid van chatbots
- Stapsgewijs operationeel draaiboek voor het onderhouden van chatbotkennis
- Standaarden, sjablonen en governance die antwoorden betrouwbaar houden
- Wat je moet meten en hoe je op de signalen handelt
- Toolingpatronen en integratiechecklist
- Hoe Deskhero aansluit op dit onderhoudsdraaiboek
- Onderhoudsfrequentie, personeelsbezetting en kostenoverwegingen
- Nieuwe kennisbronnen valideren vóór integratie
- Gebruikersfeedback gebruiken om chatbotkennis te verfijnen
- Wat supportteams in de praktijk leren bij gebruik in productie
- Deskhero maakt het onderhoudsdraaiboek vanaf dag één operationeel
- Bronnen
- FAQ
Wat is een chatbot-knowledgebase en hoe levert die antwoorden?
Een chatbot-knowledgebase (KB) is niet zomaar een map met helpartikelen. Het is een gecureerde pipeline: brondocumenten gaan door een chunkingstap, elke chunk wordt omgezet in een numerieke vector (een embedding), die vectoren worden opgeslagen in een vectordatabase en een retriever haalt op het moment van de vraag de meest relevante chunks op. Het taalmodel stelt vervolgens een antwoord samen op basis van die opgehaalde chunks, gebaseerd op je daadwerkelijke content in plaats van op de oorspronkelijke trainingsdata.
Veel AI-knowledgechatbots gebruiken een retrievalpipeline met chunks, embeddings, een vectordatabase, een retriever en een taalmodel. Systemen die bronverwijzingen bewaren, maken het eenvoudiger om een antwoord te controleren en terug te leiden naar het gebruikte materiaal.
De kerncomponenten van een goed opgebouwde KB-pipeline:
- Brondocumenten: KB-artikelen, opgeloste tickets, pdf’s, webpagina’s en beleidsdocumenten.
- Metadata: Tags voor onderwerp, productgebied, doelgroep, datum van laatste update en auteur.
- Embeddings: Dense vectorrepresentaties van elke chunk, gegenereerd door een embeddingmodel.
- Vectordatabase: Slaat embeddings op en indexeert ze voor snelle semantische zoekopdrachten (Pinecone, Weaviate, pgvector en vergelijkbare tools).
- Retriever: Voert zoekopdrachten uit op de vector-DB en retourneert de top-N meest relevante chunks.
- LLM plus systeemprompts: Stelt de opgehaalde chunks samen tot een antwoord in natuurlijke taal, beperkt door je instructies.
- Citatielaag: Voegt bronverwijzingen toe aan elk antwoord, zodat Users en klanten dit kunnen verifiëren.
Pro-tip: Houd elk artikel gericht op één duidelijk onderwerp. Splits documenten die meerdere, niet-gerelateerde vragen beantwoorden. Ook de chunkgrootte is belangrijk: begin met 500 tot 1.000 tekens en pas aan op basis van testresultaten. Te kleine chunks kunnen context verliezen, terwijl te grote chunks de relevante zin kunnen verbergen.
Waarom continu onderhoud belangrijk is voor de nauwkeurigheid van chatbots
Een chatbot die één keer wordt getraind en daarna met rust wordt gelaten, gaat achteruit. Producten veranderen, beleid wordt bijgewerkt, prijzen verschuiven en de KB raakt ongemerkt achterop. De chatbot blijft antwoorden geven op basis van verouderde gegevens, en klanten merken dat eerder dan je team.
Door de KB actueel te houden, kan de antwoordkwaliteit verbeteren en kunnen meer klanten routinevragen oplossen zonder overdracht. Een consistente toon en goedgekeurde formuleringen kunnen ook vermijdbare fouten verminderen. Nieuwe Users hebben een duidelijker referentiepunt wanneer de KB als canonieke bron wordt behandeld. Resultaten blijven afhankelijk van contentkwaliteit, implementatiescope en de manier waarop de chatbot is geconfigureerd.
De risico’s van verwaarlozing zijn al net zo duidelijk:
- Verouderde antwoorden: Een chatbot die een stopgezet product of oud retourbeleid aanhaalt, beschadigt onmiddellijk de geloofwaardigheid.
- Tegenstrijdige content: Twee artikelen die verschillende antwoorden op dezelfde vraag geven, brengen de retriever in verwarring en leiden tot inconsistente reacties.
- Hallucinaties: Wanneer de retriever niets relevants vindt, verzint een slecht geconfigureerd systeem een antwoord. Een goed onderhouden KB verkleint die leemte.
- Complianceblootstelling: In gereguleerde sectoren kan een verouderd antwoord over beleid ernstige beoordelings- en complianceproblemen veroorzaken.
- Afnemend vertrouwen: Klanten die twee keer een verkeerd antwoord krijgen, geven de bot zelden een derde kans.
Stapsgewijs operationeel draaiboek voor het onderhouden van chatbotkennis
Dit is een herhaalbare workflow die je team kan vertalen naar een interne SOP. Stel een praktische frequentie vast voor logbeoordeling, contentupdates en retrievaltests en pas die vervolgens aan aan de snelheid waarmee je producten en beleid veranderen.
-
Plan de audit. Haal de gesprekslogs van de vorige periode op. Markeer vragen met lage vertrouwensscores, escalaties en fallback-antwoorden zoals ‘Ik weet het niet’. Dit zijn je belangrijkste hiaten.
-
Identificeer ontbrekende en verouderde content. Vergelijk gemarkeerde vragen met bestaande KB-artikelen. Markeer artikelen die verwijzen naar verouderde functies, oude prijzen of verlopen promoties voor onmiddellijke update of uitfasering.
-
Schrijf of actualiseer canonieke antwoorden. Schrijf één artikel per onderwerp. Gebruik taal die op klanten is gericht, geen intern jargon. Vereiste velden: onderwerptitel, scope (op welk product/plan het van toepassing is), beoogde doelgroep, auteur, datum van laatste update en goedkeuringsstatus.
-
Voer chunking en embedding uit. Begin met het opdelen van bijgewerkte artikelen in chunks van 500 tot 1.000 tekens. Voeg metadatatags toe (onderwerp, product, taal, doelgroep). Verwerk de chunks via je embeddingmodel en laad ze in een stagingomgeving in de vectordatabase, niet in productie.
-
Voer gefaseerde validatietests uit. Gebruik een testset van 20 tot 30 echte vragen uit de logs. Controleer of elke vraag de juiste chunk ophaalt en of het gegenereerde antwoord overeenkomt met het canonieke antwoord. Stel een slaagdrempel voor retrievalnauwkeurigheid vast voordat je naar productie promoveert.
-
Publiceer naar productie met een goedkeuringsmoment. Een aangewezen goedkeurder (knowledge steward of teamlead) beoordeelt de testresultaten en geeft goedkeuring. Leg de publicatie vast met een tijdstempel, auteur en versienummer.
-
Monitor na publicatie. Houd antwoordkwaliteit en overdrachten nauwlettend in de gaten na elke belangrijke update. Als een statistiek daalt of beoordelingen onjuiste antwoorden aan het licht brengen, draai de wijziging dan terug met behulp van de versiegeschiedenis.
-
Faseer verouderde content uit. Archiveer content in plaats van deze te verwijderen, zodat de versiegeschiedenis intact blijft. Werk artikelen bij die naar de uitgefaseerde content verwezen.
Pro-tip: Als het platform dit ondersteunt, verplicht dan bronverwijzingen voor feitelijke antwoorden. Combineer dit met een expliciete fallbackinstructie: als retrieval geen voldoende relevante content oplevert, moet de chatbot aangeven dat hij geen antwoord kan geven en een overdracht naar een medewerker aanbieden in plaats van te gokken.
Pro-tip: Kwaliteit gaat in elke fase boven kwantiteit. Vijf tot tien goed geschreven, gerichte documenten leveren een capabelere assistent op dan vijftig losjes gestructureerde documenten. Snoei grondig voordat je indexeert.
Standaarden, sjablonen en governance die antwoorden betrouwbaar houden
Goede governance is geen bureaucratie om de bureaucratie. Een mensgerichte benadering van AI begint bij de behoeften en het welzijn van de mensen die door het systeem worden beïnvloed. Voor een chatbot die op klanten is gericht, maken gedocumenteerde goedkeuringen, versiegeschiedenis en wijzigingsnotities beoordeling en verantwoording praktisch.
Redactionele standaarden waaraan elk artikel moet voldoen
- Eén onderwerp, één antwoord. Geen enkel artikel behandelt meer dan één afzonderlijke vraag.
- Kl antvriendelijke taal. Schrijf zoals een klant zou vragen, niet zoals een engineer zou documenteren.
- Vereiste velden: Onderwerptitel, scope, doelgroep, auteur, datum van laatste update, goedkeuringsstatus, versienummer en een korte wijzigingsnotitie.
- Geen dubbele gegevens. Als een ingestpipeline al live prijzen uit je bronsysteem ophaalt, leg die prijs dan niet hard vast in een KB-artikel. De informatie raakt verouderd.
- Proactieve logbeoordeling. Beoordeel gesprekslogs volgens een vast ritme om hiaten te vinden voordat klanten ze melden.
Governancerollen
- Content owner: Vakinhoudelijk expert die artikelen binnen het eigen domein schrijft en actualiseert.
- Knowledge steward: Bewaakt standaarden, voert audits uit, beheert de levenscyclus van artikelen en is verantwoordelijk voor de redactionele kalender.
- Goedkeurder: Teamlead of manager die goedkeuring geeft voordat een artikel live gaat.
- ML-eigenaar: Beheert chunkingparameters, updates van het embeddingmodel, retrieverconfiguratie en onderhoud van de testset.
- Compliance-reviewer: Vereiste goedkeuring voor artikelen over gereguleerde onderwerpen (prijzen, juridische voorwaarden en gegevensprivacy).
Vertrouwenssignalen om nu te implementeren
- Auditlogs die elke actie voor aanmaken, bewerken, goedkeuren en uitfaseren vastleggen met een tijdstempel en gebruikers-ID.
- Versiegeschiedenis met diffweergaven, zodat elke wijziging kan worden beoordeeld.
- Changelogs die aan elk artikel zijn gekoppeld en tonen wat er is gewijzigd en waarom.
- Goedkeuringsstempels die zichtbaar zijn in het KB-beheer, zodat het team kan zien wat wel en niet is vrijgegeven voor chatbotgebruik.
- Broncitaten die in elk chatbotantwoord worden weergegeven.
Wat je moet meten en hoe je op de signalen handelt
Monitoring is waar onderhoudsbeslissingen worden genomen. Zonder statistieken gok je welke artikelen moeten worden bijgewerkt. Met statistieken beschik je elke week over een geprioriteerde werkvoorraad.
Belangrijke statistieken om bij te houden:
- Antwoordnauwkeurigheid/correctheid: Percentage chatbotreacties dat overeenkomt met het canonieke antwoord in een steekproef van de testset.
- Groundingpercentage: Percentage reacties dat een specifieke bronchunk citeert. Een daling hiervan wijst op retriever-drift of ontbrekende content.
- Deflectiepercentage: Percentage gesprekken dat zonder betrokkenheid van een User wordt opgelost. Toenemende escalaties zijn vaak terug te voeren op een specifiek KB-hiaat.
- Escalatiepercentage: Het omgekeerde van deflectie; houd dit per onderwerpcategorie bij om vast te stellen welke contentgebieden aandacht nodig hebben.
- Doorlooptijd tot update: Hoe lang het duurt om van het identificeren van een hiaat naar het publiceren van een geverifieerde oplossing te gaan.
- CSAT voor de bot: Klanttevredenheidsscore specifiek voor gesprekken die door de chatbot zijn afgehandeld.
- Hallucinatie-incidenten: Het aantal bevestigde gevallen waarin de bot een feitelijk onjuist antwoord gaf dat niet op een bron was gebaseerd.
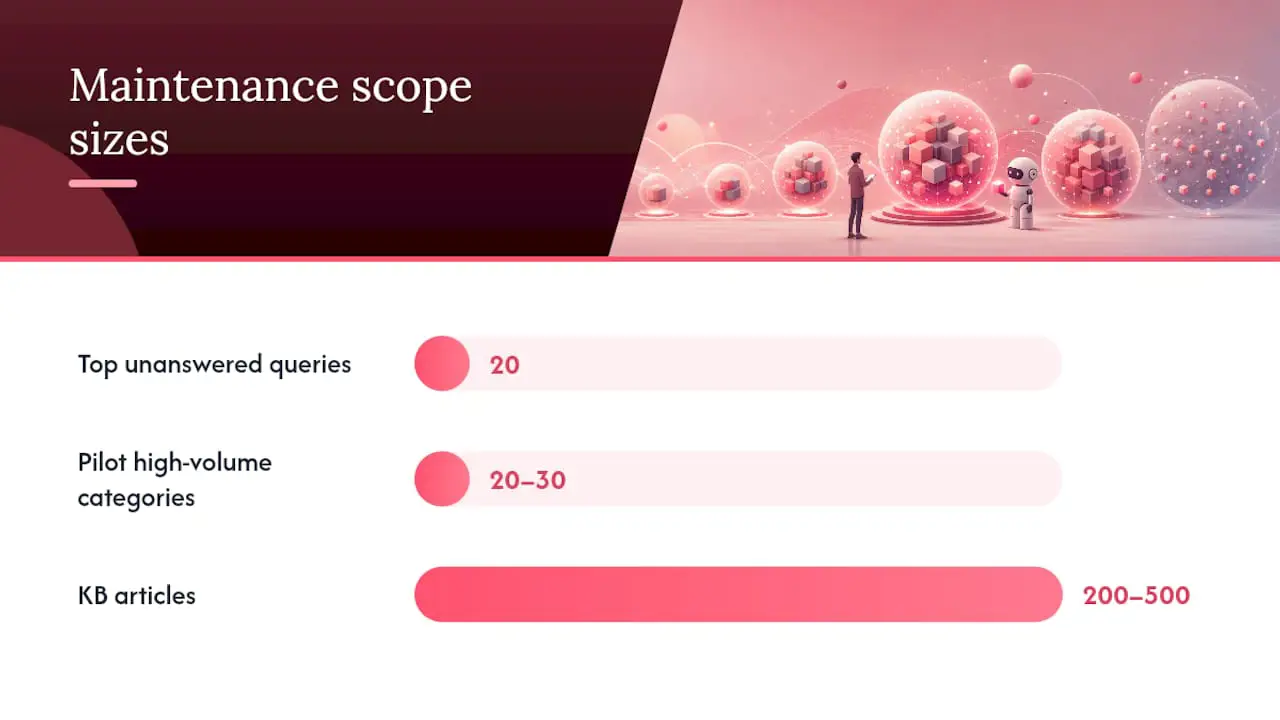
Het meest praktische gebruik van logs is elke week een lijst met de 20 meestgestelde onbeantwoorde vragen genereren. Sorteer op volume, wijs elke vraag toe aan een content owner en houd de doorlooptijd tot oplossing bij. Die lijst wordt je onderhoudsbacklog.
Toolingpatronen en integratiechecklist
De juiste tooling maakt het bovenstaande draaiboek herhaalbaar zonder heroïsche handmatige inspanning. Geef bij het beoordelen van platforms en integratiepatronen prioriteit aan deze mogelijkheden:
- Incrementele indexering: Het systeem kan afzonderlijke chunks bijwerken zonder de volledige KB opnieuw te indexeren. Dit is cruciaal voor grote KB’s, waarbij volledige herindexering traag en duur is.
- Embeddingvernieuwing: De mogelijkheid om embeddings voor bijgewerkte artikelen opnieuw te genereren zonder ongewijzigde content aan te raken.
- Herkomst- en citatieondersteuning: Elke opgehaalde chunk bevat een bronverwijzing die in het antwoord wordt weergegeven.
- Rolgebaseerde toegangscontrole: Content owners, goedkeurders en ML-engineers hebben verschillende rechten. Het platform moet dit afdwingen.
- Auditlogs: Elke indexeringsgebeurtenis, contentwijziging en goedkeuring wordt vastgelegd met een tijdstempel en gebruiker.
- Webhooks voor tickets: Wanneer een ticket is opgelost, kan een webhook een KB-beoordeling starten of automatisch een conceptartikel opstellen. Zo wordt de verbinding tussen supportactiviteiten en kennisbeheer gesloten.
- SSO: Google- en Microsoft-SSO verminderen frictie voor teams die al binnen die ecosystemen werken.
Integratiepatronen die in productie werken
Directe KB-synchronisatie: Het KB-platform stuurt bijgewerkte artikelen volgens een schema of bij publicatie naar de vectordatabase. Eenvoudig, betrouwbaar en het juiste startpunt voor de meeste teams.
Gefaseerde indexering in een sandbox: Nieuwe of bijgewerkte content wordt eerst in een stagingomgeving geïndexeerd. De testsuite draait tegen staging voordat een wijziging productie bereikt. Dit is het equivalent van een CI-pipeline voor kenniscontent.
CI-achtige validatiepipelines: Behandel KB-wijzigingen als codewijzigingen. Een contentupdate activeert een geautomatiseerde testrun tegen je testset van 20 tot 30 vragen. Mislukkingen blokkeren de publicatie. Geslaagde tests gaan naar de goedkeurder voor de definitieve goedkeuring.
Belangrijke afwegingen om te begrijpen
RAG is voor de meeste supportteams met vaak veranderende kennis de juiste architectuur. Je werkt documenten bij in plaats van modelgewichten, waardoor de kosten beheersbaar en updatecycli kort blijven. Fine-tuning is zinvol voor statische, zeer gespecialiseerde domeinen waarin de woordenschat en redeneerpatronen stabiel zijn. Het verschil in operationele kosten is aanzienlijk: een RAG-update is een documentbewerking en herindexering; een fine-tuningcyclus vereist gelabelde data, rekentijd en een volledige modelevaluatie vóór implementatie.
Wat betreft de afweging tussen latency en actualiteit: frequentere embeddingvernieuwingen houden antwoorden actueel, maar brengen extra rekenkosten met zich mee. Kies een vernieuwingsschema op basis van hoe vaak het bronmateriaal verandert en voer na belangrijke updates validatie uit.
Hoe Deskhero aansluit op dit onderhoudsdraaiboek
Deskhero is gebouwd rond het principe dat een chatbot alleen antwoord moet geven op basis van kennis die je expliciet hebt goedgekeurd. Dat sluit rechtstreeks aan op de governance- en validatiestappen in dit draaiboek.
Zo sluiten specifieke stappen uit het draaiboek aan op functies van Deskhero:
- Antwoorden uitsluitend op basis van goedgekeurde kennis: De AI-chatbot van Deskhero antwoordt vanuit goedgekeurde openbare FAQ-content. Andere kennis uit de workspace wordt niet gebruikt voor klantgerichte chatbotantwoorden. Om de chatbot in te schakelen zijn minimaal 100 goedgekeurde openbare FAQ-items nodig.
- FAQ-suggesties uit opgeloste tickets: Opgeloste tickets en gescrapete webpagina’s kunnen worden omgezet in kandidaat-FAQ-items. Een User beoordeelt en keurt een item goed voordat het beschikbaar wordt voor de chatbot.
- Gescheiden kennisscopes: De interne knowledgebase kan AI-antwoordssuggesties voor Users ondersteunen. Klantgerichte chatbotantwoorden gebruiken uitsluitend de goedgekeurde openbare FAQ.
- Tweerichtings-e-mailsynchronisatie: Vragen van klanten komen binnen via e-mail, formulier of chatbot en worden tickets in een gedeelde inbox. Antwoorden kunnen worden verzonden vanaf het gekoppelde adres van het bedrijf.
- Gelabelde automatische acties: Automatische acties worden gelabeld en gelogd en volledig automatisch verzenden is opt-in.
- REST API: Deskhero biedt een REST API voor ticket- en workspacebewerkingen. Het biedt geen uitgaande webhooks.
- Meertalige interface: De interface van Deskhero is beschikbaar in 14 ondersteunde talen en chatbotretrieval kan openbare FAQ-content in verschillende talen matchen.
Deskhero koppelt Gmail-, Google Workspace- of Microsoft 365-mailboxen aan een gedeelde helpdesk, terwijl het team de bestaande e-mailadressen kan behouden. De klantgerichte AI antwoordt vanuit goedgekeurde openbare FAQ-content en draagt onopgeloste vragen over aan een medewerker. FAQ-suggesties kunnen worden opgesteld uit opgeloste tickets en gescrapete webpagina’s, maar een User moet ze beoordelen voordat ze worden goedgekeurd. Automatische acties worden gelabeld en gelogd. Het platform omvat ook een interne knowledgebase, ticketinzichten, 14 interfacetalen, Shopify-integratie, Google- en Microsoft-SSO en een REST API. Het begint met een gratis proefperiode van 30 dagen, zonder dat een creditcard nodig is.
Omdat de chatbot van Deskhero beperkt is tot de goedgekeurde openbare FAQ, is de onderhoudstaak concreet: beoordeel onopgeloste vragen, verbeter of voeg FAQ-items toe, keur ze goed en controleer of de bijgewerkte kennis de bedoelde vragen beantwoordt.
Voor een diepere kijk op hoe AI-chatbots omgaan met escalatie en overdracht naar medewerkers binnen dit soort workflow, behandelt de gids voor overdracht van chatbot naar medewerker de operationele patronen in detail.
Onderhoudsfrequentie, personeelsbezetting en kostenoverwegingen
Bij het plannen van de mensen en tijd achter chatbotkennisbeheer onderschatten de meeste teams de hoeveelheid werk. Het goede nieuws: een klein team met een duidelijk ritme kan een productie-KB onderhouden zonder speciaal daarvoor aangeworven personeel.
Aanbevolen frequenties:
- Wekelijks: Beoordeel gesprekslogs, haal de lijst met de 20 meestgestelde onbeantwoorde vragen op, markeer urgente hiaten in de content en stuur oplossingen met hoge prioriteit door de goedkeuringsstap.
- Maandelijks: Voer een volledige contentupdatecyclus uit. Schrijf nieuwe artikelen, werk gewijzigd beleid of gewijzigde producten bij, faseer verouderde content uit en voer de volledige testsuite uit.
- Per kwartaal: Beoordeling van beleids- en productwijzigingen, retriever-afstemming, evaluatie van het embeddingmodel en een governance-audit (zijn alle artikelen correct goedgekeurd en voorzien van versiebeheer?).
Minimaal personeelsmodel voor kleine teams:
- Knowledge steward: Is verantwoordelijk voor de redactionele kalender, voert audits uit, bewaakt standaarden en beheert de goedkeuringswachtrij. De benodigde tijd hangt af van het contentvolume en de wijzigingsfrequentie.
- Technische ondersteuning: Beheert chunkingparameters, embeddingvernieuwingen, retrievalconfiguratie en onderhoud van de testsuite wanneer het team de eigen retrievalstack beheert.
- Wisselende vakinhoudelijke experts: Elk product- of beleidsdomein heeft een aangewezen content owner die artikelen binnen dat gebied beoordeelt en goedkeurt. Dit is doorgaans een parttimeverantwoordelijkheid naast een bestaande functie.
Te ramen kostenfactoren:
- De kosten voor opslag en zoekopdrachten in de vectordatabase schalen mee met de omvang van de KB en het aantal zoekopdrachten.
- De frequentie van embeddingvernieuwing beïnvloedt de rekenkosten. Vernieuw daarom gewijzigde content wanneer het platform incrementele updates ondersteunt.
- De tijd voor menselijke beoordeling kan een aanzienlijke kostenpost vormen, vooral wanneer producten of beleid vaak veranderen.
- De abonnementskosten voor tooling verschillen per platform. Platforms die KB-beheer, ticketing en chatbot combineren in één abonnement (in plaats van afzonderlijke tools voor vectordatabase, LLM API en helpdesk te vereisen) verlagen zowel de kosten als de integratiecomplexiteit.
Onderzoek naar generatieve AI in klantenondersteuning heeft productiviteitswinst aangetoond in een echte supportsituatie. Beschouw die bevindingen als context en niet als personeelsformule, omdat de kosten en voordelen van kennisbeheer afhangen van het team, de content en de tools.
Beginnen met een scope tegen lage kosten: Start met 20 tot 30 vraagcategorieën met een hoog volume. Bouw en onderhoud eerst de artikelen voor die categorieën. Controleer of de antwoordkwaliteit verbetert voordat je de KB uitbreidt. Zo blijft de initiële onderhoudslast klein en groeit het interne vertrouwen in het proces.
Nieuwe kennisbronnen valideren vóór integratie
Niet elk document dat nuttig lijkt, hoort in de index van de chatbot. De integratie van een bron van lage kwaliteit of met onjuiste informatie verslechtert de hele KB, omdat de retriever geen onderscheid kan maken tussen een goed onderbouwd artikel en een slecht geschreven artikel.
Voer elke kandidaatbron vóór indexering door deze controles:
Nauwkeurigheidscontrole: Weerspiegelt de content het huidige productgedrag, beleid of de actuele prijzen? Vergelijk de informatie met het bronsysteem (je CRM, productdocumentatie of door het juridische team goedgekeurde beleidsdocumenten). Als je een bewering niet aan de hand van een primaire bron kunt verifiëren, indexeer haar dan niet.
Scopecontrole: Is de content relevant voor de vragen die je chatbot moet beantwoorden? Een brede whitepaper over de sector kan accurate informatie bevatten, maar ook ruis in de retrieval introduceren. Beperk documenten strikt tot je use case.
Duplicatiecontrole: Overlapt deze content aanzienlijk met een bestaand KB-artikel? Dubbele content zorgt voor ambiguïteit bij retrieval. Voeg de content samen of consolideer haar vóór indexering.
Controle van formaat en structuur: Is het document zo gestructureerd dat chunking samenhangende, zelfstandige passages oplevert? Een document met veel kruisverwijzingen (‘zie sectie 4.2 voor details’) wordt slecht in chunks verdeeld, omdat afzonderlijke chunks context verliezen. Herschrijf of herstructureer het document vóór indexering.
Herkomstcontrole: Kun je de content herleiden tot een gezaghebbende interne of externe bron? Leg voor gereguleerde onderwerpen de bron expliciet vast in de metadata van het artikel.
Stagingtest: Indexeer de nieuwe bron in een stagingomgeving en voer je standaardtestset van 20 tot 30 vragen uit. Controleer of de nieuwe content de retrievalnauwkeurigheid verbetert, verslechtert of niet beïnvloedt. Promoveer alleen bronnen die de nauwkeurigheid verbeteren of op peil houden.
Gebruikersfeedback gebruiken om chatbotkennis te verfijnen
Gebruikersfeedback is het meest directe signaal dat je hebt over waar de KB tekortschiet. De uitdaging is om feedback systematisch vast te leggen in plaats van te reageren op de luidste klachten.
Duimpje omhoog/omlaag bij chatbotreacties is het eenvoudigste feedbackmechanisme. Elke chatbotreactie moet een optie voor een binaire beoordeling bevatten. Verzamel deze beoordelingen wekelijks. Een reactie met veel negatieve beoordelingen is een directe aanleiding voor KB-beoordeling, ongeacht of het antwoord er voor het schrijvende team correct uitzag.
CSAT-enquêtes na het gesprek geven een breder signaal. Lage scores voor door de bot afgehandelde gesprekken, gefilterd op onderwerpcategorie, laten zien welke contentgebieden de meeste aandacht nodig hebben. Combineer CSAT-gegevens met escalatielogs om te bevestigen of het probleem een KB-hiaat of een retrieverconfiguratieprobleem is.
Feedbacklussen van het supportteam zijn waardevol. Users die escalaties behandelen, weten vaak waarom de bot faalde. Een eenvoudig tagsysteem in je ticketingtool, zoals ‘verkeerd antwoord’, ‘ontbrekend antwoord’ of ‘verouderd beleid’, kan die ervaring omzetten in een gestructureerd onderhoudssignaal.
Expliciete logs met ‘Ik weet het niet’ zijn een goudmijn. Leg elke keer dat de chatbot escaleert omdat hij geen relevante content heeft gevonden de vraag vast. Sorteer wekelijks op volume. De bovenste vragen op die lijst zijn je taken met de hoogste prioriteit.
Periodieke gebruikersenquêtes over KB-kwaliteit (verzonden naar klanten die de afgelopen 30 dagen met de chatbot hebben geïnteracteerd) brengen systemische problemen aan het licht die individuele gespreksbeoordelingen missen. Beperk de enquête tot twee of drie vragen en koppel antwoorden aan gespreks-ID’s, zodat je feedback kunt herleiden tot specifieke artikelen.
De feedbacklus is gesloten wanneer een gemarkeerde vraag een KB-artikel wordt, het artikel de goedkeuringsworkflow doorloopt en het antwoord van de chatbot op die vraag verbetert. Het bijhouden van die cyclustijd (van markering tot oplossing) is een van de nuttigste operationele statistieken waarvoor een knowledge steward verantwoordelijkheid kan nemen.
Wat supportteams in de praktijk leren bij gebruik in productie
Het bovenstaande draaiboek klopt in theorie. Hier lees je wat er in de praktijk misgaat en hoe je dat snel oplost.
Begin klein en bewijs de waarde voordat je opschaalt. Alle beschikbare documenten tegelijk indexeren kan een opgeblazen KB creëren en het moeilijk maken om een bruikbare kwaliteitsbasis vast te stellen. Kies 20 tot 30 vraagcategorieën met een hoog volume, maak daarvoor schone artikelen en laat de chatbot binnen die beperkte scope werken. Breid pas uit nadat tests aantonen dat de antwoorden nauwkeurig en nuttig zijn.
Behandel tijdgebonden content expliciet. Promoties, seizoensgebonden beleid en tijdelijke aanbiedingen kunnen snel verouderd raken. Maak een afzonderlijke metadatatag voor tijdgebonden content en stel bij het schrijven een verplichte beoordelingsdatum voor het verlopen ervan in.
Log en volg onbekende antwoorden regelmatig. Door de log met ‘Ik weet het niet’ regelmatig te beoordelen, kunnen teams herhaalde hiaten opsporen voordat ze zich opstapelen. Gebruik vraagvolume en klantimpact om oplossingen te prioriteren.
Pro-tip: Opgeloste tickets zijn nuttig bronmateriaal voor canonieke antwoorden, omdat ze laten zien hoe het team echte vragen heeft afgehandeld. Deskhero gebruikt opgeloste tickets periodiek als bronmateriaal voor FAQ-suggesties. Een User kan elke suggestie beoordelen, bewerken, goedkeuren of afwijzen voordat goedgekeurde content beschikbaar wordt voor de chatbot.
Snelle oplossingen voor teams die net beginnen:
- Stel vanaf dag één een naamgevingsconventie voor artikelen vast (Productgebied: Onderwerp: Doelgroep). Het achteraf hernoemen van 200 artikelen is pijnlijk.
- Maak een metadatasjabloon met verplichte velden en plak dit vóór het schrijven in elk nieuw artikel.
- Bouw een testsuite van 20 tot 30 echte vragen uit vroege gesprekslogs en voer die uit vóór elke push naar productie.
Deskhero maakt het onderhoudsdraaiboek vanaf dag één operationeel
Dit draaiboek uitvoeren met losse tools kan extra coördinatiewerk opleveren. Deskhero brengt de beoordelingsworkflow voor openbare FAQ’s, FAQ-suggesties en klantgesprekken samen in dezelfde helpdesk.
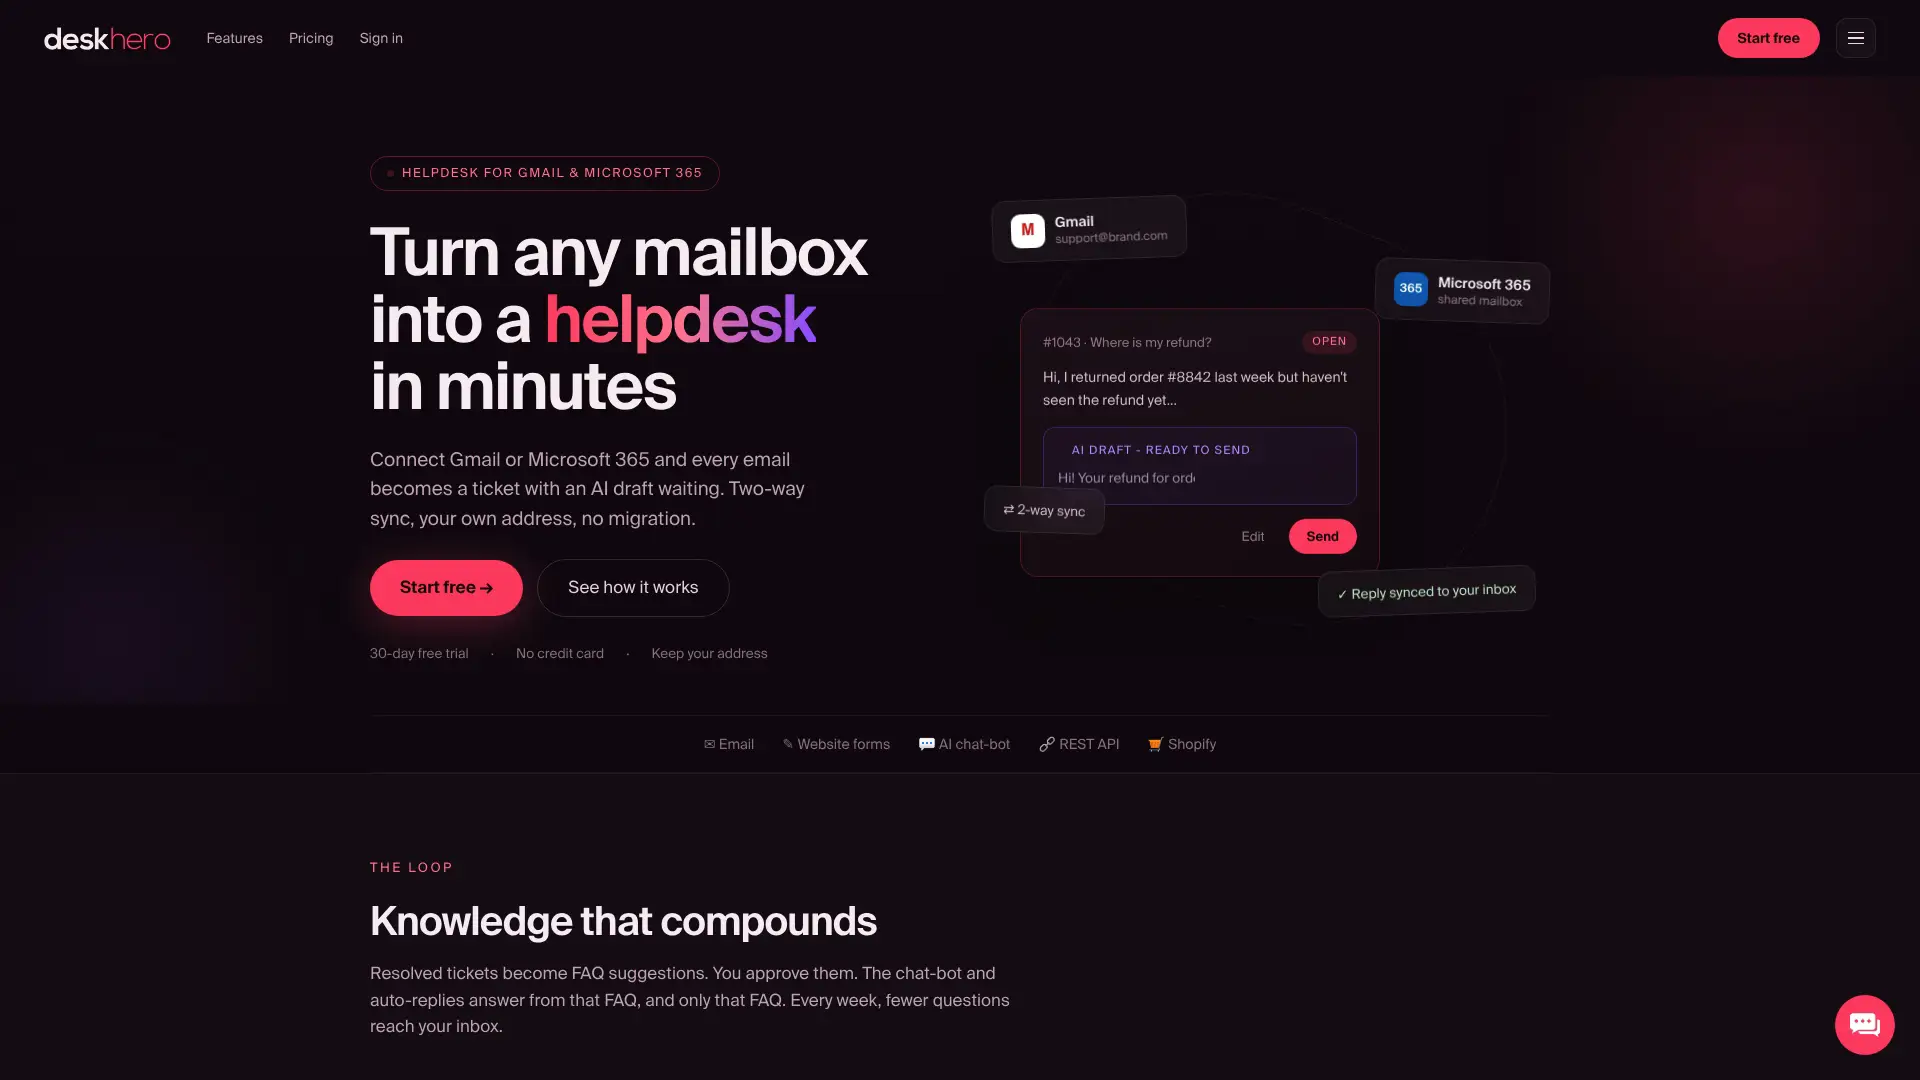
De chatbot antwoordt uitsluitend vanuit goedgekeurde openbare FAQ-content, terwijl AI-antwoordssuggesties voor Users kunnen putten uit bredere workspacekennis. FAQ-suggesties uit opgeloste tickets en gescrapete webpagina’s verminderen het werk om content vanaf nul op te stellen, maar vereisen nog steeds menselijke beoordeling. Dankzij de tweerichtingsintegratie van mailboxen blijven tickets en antwoorden verbonden met het bestaande adres van het team.
Voor teams die deze workflow willen gebruiken zonder zelf een aangepaste retrievalstack samen te stellen, combineert Deskhero de gedeelde inbox, openbare FAQ, chatbot en overdracht naar een medewerker. Start een gratis proefperiode van 30 dagen bij Deskhero, zonder creditcard.
Bronnen
Gebruik deze bronnen als implementatiereferenties bij technische keuzes over chunkingstrategie, trainingsaanpak, governancebeleid en de inrichting van metingen.
FAQ
Wat is een chatbot-knowledgebase?
Een chatbot-knowledgebase is een gecureerde verzameling brondocumenten die in passages is opgedeeld, is omgezet in vector-embeddings en is opgeslagen in een vectordatabase, zodat een retriever tijdens een vraag de meest relevante content kan ophalen en de antwoorden van de chatbot kan baseren op je daadwerkelijke content.
Hoe onderhoud je een chatbot in de loop der tijd?
Voer een herhaalbare cyclus uit: controleer gesprekslogs om hiaten te vinden, actualiseer of schrijf canonieke artikelen, voer chunking en embedding uit in een stagingomgeving, valideer tegen een testset van 20 tot 30 vragen, verkrijg goedkeuring, publiceer naar productie en monitor antwoordkwaliteit en overdrachten op terugval.
Wat mag je een chatbot nooit vertellen?
Vermijd het invoeren van gevoelige persoonsgegevens (Social Security-nummers, wachtwoorden en financiële accountgegevens) in een chatbotinterface, omdat invoer afhankelijk van het beleid voor gegevensverwerking van het platform kan worden gelogd of gebruikt voor modeltraining. Leg bij het schrijven van interne KB-content nooit live gegevens (prijzen, voorraad) hard vast als een ingestpipeline deze rechtstreeks uit het bronsysteem kan ophalen.
Hoeveel kost het om een chatbot te onderhouden?
De belangrijkste kosten zijn beoordelingstijd, rekenkosten voor retrieval en embeddings wanneer die componenten rechtstreeks worden beheerd, en eventuele abonnementen voor een helpdesk of kennisplatform. Ramen deze kosten op basis van contentvolume, vraagvolume, updatefrequentie en de hoeveelheid benodigde menselijke beoordeling.