Cómo mantener el conocimiento de un chatbot: guía práctica
Mantén el conocimiento del chatbot como un proceso recurrente y basado en roles: auditar → actualizar → validar → publicar → retirar. Este ciclo de cinco pasos, ejecutado con una periodicidad predecible y con responsables claros en cada etapa, es lo que distingue a un chatbot que se gana la confianza de los clientes de uno que la erosiona silenciosamente.
Esta es la breve lista de comprobación que tu equipo necesita antes que nada:
- Higiene de las fuentes: Elimina los documentos obsoletos, duplicados o contradictorios antes de que lleguen al índice.
- Fragmentación e indexación: Empieza con fragmentos de 500 a 1.000 caracteres y ajusta después el tamaño según las pruebas de recuperación.
- Ajuste del recuperador: Prueba y ajusta trimestralmente los umbrales de similitud para mantener una alta precisión a medida que crece la KB.
- Flujo de aprobación: Cada artículo nuevo o editado necesita una aprobación antes de publicarse en el chatbot.
- Métricas de supervisión: Realiza un seguimiento periódico de la calidad de las respuestas, las preguntas sin resolver y las transferencias.
- Reversión y control de versiones: Mantén un registro de cambios para poder revertir cualquier actualización incorrecta en cuestión de minutos.
Quién se encarga de qué: Los responsables de contenido redactan y actualizan los artículos. Un responsable de conocimiento aplica los estándares y realiza las auditorías. Un responsable técnico gestiona la fragmentación, los embeddings y la configuración de recuperación cuando el equipo administra esos componentes. Un revisor ejecuta conjuntos de pruebas antes de cada publicación. Los especialistas en cumplimiento revisan el contenido que aborda temas regulados.
Conclusiones clave
Mantener el conocimiento de un chatbot requiere un ciclo repetible de auditoría a retirada, responsabilidades claras y supervisión periódica para detectar las carencias antes que los clientes.
| Punto | Detalles |
|---|---|
| Usa el ciclo de auditoría a retirada | Ejecuta auditoría → actualización → validación → publicación → retirada con una periodicidad semanal/mensual/trimestral para evitar la deriva de la KB. |
| Prueba el tamaño de los fragmentos | Comienza la recuperación con fragmentos de 500 a 1.000 caracteres y ajústalos según los resultados de las pruebas. |
| Realiza un seguimiento de señales de calidad útiles | Supervisa la precisión de las respuestas, las preguntas sin resolver, las transferencias y las respuestas incorrectas confirmadas; después, define umbrales adecuados para tu servicio. |
| Asigna un responsable de conocimiento | Asigna a una persona la responsabilidad clara del calendario editorial, la cola de revisión y la periodicidad de mantenimiento. |
| Deskhero aplica respuestas basadas en conocimiento aprobado | El chatbot de Deskhero responde únicamente a partir del contenido público aprobado de las FAQ y sugiere candidatos para las FAQ a partir de tickets resueltos y páginas web rastreadas. |
Tabla de contenidos
- ¿Qué es una base de conocimiento para chatbots y cómo impulsa las respuestas?
- Por qué el mantenimiento continuo es importante para la precisión del chatbot
- Manual operativo paso a paso para mantener el conocimiento del chatbot
- Estándares, plantillas y gobernanza que mantienen la fiabilidad de las respuestas
- Qué medir y cómo actuar a partir de las señales
- Patrones de herramientas y lista de comprobación de integración
- Cómo encaja Deskhero en este manual de mantenimiento
- Periodicidad del mantenimiento, personal y consideraciones de costes
- Cómo validar nuevas fuentes de conocimiento antes de integrarlas
- Cómo usar los comentarios de los usuarios para perfeccionar el conocimiento del chatbot
- Lo que los equipos de soporte realmente aprenden al ejecutar esto en producción
- Deskhero hace operativo el manual de mantenimiento desde el primer día
- Fuentes
- Preguntas frecuentes
¿Qué es una base de conocimiento para chatbots y cómo impulsa las respuestas?
Una base de conocimiento para chatbots (KB) no es simplemente una carpeta de artículos de ayuda. Es una canalización seleccionada: los documentos fuente pasan por un paso de fragmentación, cada fragmento se convierte en un vector numérico (un embedding), esos vectores se almacenan en una base de datos vectorial y un recuperador extrae los fragmentos más relevantes en el momento de la consulta. A continuación, el modelo de lenguaje sintetiza una respuesta a partir de esos fragmentos recuperados, fundamentada en tu contenido real en lugar de en sus datos de entrenamiento base.
Muchos chatbots de conocimiento basados en IA utilizan una canalización de recuperación con fragmentos, embeddings, una base de datos vectorial, un recuperador y un modelo de lenguaje. Los sistemas que conservan referencias a las fuentes facilitan la inspección de una respuesta y su rastreo hasta el material utilizado.
Los componentes principales de una canalización de KB bien construida:
- Documentos fuente: Artículos de la KB, tickets resueltos, archivos PDF, páginas web y documentos de políticas.
- Metadatos: Etiquetas para el tema, el área del producto, la audiencia, la fecha de la última actualización y el autor.
- Embeddings: Representaciones vectoriales densas de cada fragmento, generadas por un modelo de embeddings.
- Base de datos vectorial: Almacena e indexa embeddings para realizar búsquedas semánticas rápidas (Pinecone, Weaviate, pgvector y herramientas similares).
- Recuperador: Consulta la base de datos vectorial y devuelve los N fragmentos más relevantes.
- LLM más prompts del sistema: Sintetiza los fragmentos recuperados en una respuesta en lenguaje natural, limitada por tus instrucciones.
- Capa de citas: Adjunta referencias a las fuentes en cada respuesta para que los usuarios y clientes puedan verificarlas.
Consejo profesional: Mantén cada artículo centrado en un único tema claro. Divide los documentos que responden a varias preguntas no relacionadas. El tamaño de los fragmentos también importa: empieza con 500 a 1.000 caracteres y ajústalo según los resultados de las pruebas. Los fragmentos demasiado pequeños pueden perder contexto, mientras que los demasiado grandes pueden ocultar la frase relevante.
Por qué el mantenimiento continuo es importante para la precisión del chatbot
Un chatbot entrenado una vez y dejado sin supervisión se degrada. Los productos cambian, las políticas se actualizan, los precios varían y la KB queda rezagada silenciosamente. El chatbot continúa respondiendo a partir de datos obsoletos, y los clientes lo notan antes que tu equipo.
Mantener actualizada la KB puede mejorar la calidad de las respuestas y ayudar a más clientes a resolver preguntas rutinarias sin una transferencia. Un tono coherente y una redacción aprobada también pueden reducir errores evitables. Los nuevos usuarios disponen de un punto de referencia más claro cuando la KB se trata como la fuente autorizada. Los resultados siguen dependiendo de la calidad del contenido, el alcance del despliegue y la configuración del chatbot.
Los riesgos de descuidarla son igual de evidentes:
- Respuestas obsoletas: Un chatbot que cita un producto descatalogado o una política de devoluciones antigua pierde credibilidad de inmediato.
- Contenido contradictorio: Dos artículos que ofrecen respuestas diferentes a la misma pregunta confunden al recuperador y producen respuestas incoherentes.
- Riesgo de alucinación: Cuando el recuperador no encuentra nada relevante, un sistema mal configurado inventa una respuesta. Una KB bien mantenida reduce esa brecha.
- Exposición al incumplimiento: En sectores regulados, una respuesta obsoleta sobre una política puede generar serios problemas de revisión y cumplimiento.
- Pérdida de confianza: Los clientes que reciben dos veces una respuesta incorrecta rara vez dan al bot una tercera oportunidad.
Manual operativo paso a paso para mantener el conocimiento del chatbot
Este es un flujo de trabajo repetible que tu equipo puede convertir en un procedimiento operativo estándar interno. Establece una periodicidad práctica para revisar los registros, actualizar el contenido y probar la recuperación; después, ajústala a la frecuencia con la que cambian tus productos y políticas.
-
Programa la auditoría. Extrae los registros de conversaciones del periodo anterior. Marca las consultas con puntuaciones de confianza bajas, las escalaciones y las respuestas alternativas de tipo «No lo sé». Estas son tus carencias prioritarias.
-
Identifica el contenido ausente y obsoleto. Contrasta las consultas marcadas con los artículos existentes de la KB. Marca para su actualización o retirada inmediata los artículos que hagan referencia a funciones obsoletas, precios antiguos o promociones caducadas.
-
Redacta o actualiza respuestas autorizadas. Escribe un artículo por tema. Utiliza un lenguaje dirigido al cliente, no jerga interna. Campos obligatorios: título del tema, alcance (a qué producto o plan se aplica), audiencia prevista, autor, fecha de última actualización y estado de aprobación.
-
Fragmenta y genera embeddings. Empieza dividiendo los artículos actualizados en fragmentos de 500 a 1.000 caracteres. Añade etiquetas de metadatos (tema, producto, idioma y audiencia). Pasa los fragmentos por tu modelo de embeddings y cárgalos en la base de datos vectorial en un entorno de pruebas, no en producción.
-
Ejecuta pruebas de validación por etapas. Usa un conjunto de pruebas de 20 a 30 consultas reales extraídas de los registros. Comprueba que cada consulta recupera el fragmento correcto y que la respuesta generada coincide con la respuesta autorizada. Establece un umbral de aprobación para la precisión de recuperación antes de promover el cambio a producción.
-
Publica en producción con una etapa de aprobación. Un aprobador designado (el responsable de conocimiento o el líder del equipo) revisa los resultados de las pruebas y da su aprobación. Registra el evento de publicación con una marca de tiempo, el autor y el número de versión.
-
Supervisa después de publicar. Observa atentamente la calidad de las respuestas y las transferencias después de cualquier actualización importante. Si una métrica disminuye o las revisiones detectan respuestas incorrectas, revierte el cambio mediante el historial de versiones.
-
Retira el contenido obsoleto. Archívalo en lugar de eliminarlo para conservar intacto el historial de versiones. Actualiza cualquier artículo que hiciera referencia al contenido retirado.
Consejo profesional: Cuando la plataforma lo permita, exige referencias a las fuentes para las respuestas fácticas. Combínalo con una instrucción explícita de fallback: si la recuperación no devuelve contenido suficientemente relevante, el chatbot debe decir que no puede responder y ofrecer una transferencia a una persona, en lugar de adivinar.
Consejo profesional: La calidad supera a la cantidad en cada etapa. Entre cinco y diez documentos bien redactados y centrados producen un asistente más capaz que cincuenta documentos estructurados de forma imprecisa. Depura de manera agresiva antes de indexar.
Estándares, plantillas y gobernanza que mantienen la fiabilidad de las respuestas
Una buena gobernanza no es burocracia por sí misma. Un enfoque de la IA centrado en las personas comienza con las necesidades y el bienestar de quienes se ven afectados por el sistema. En un chatbot dirigido al cliente, las aprobaciones documentadas, el historial de versiones y las notas de cambios hacen que la revisión y la rendición de cuentas sean prácticas.
Estándares editoriales que debe cumplir cada artículo
- Un tema, una respuesta. Ningún artículo debe abarcar más de una pregunta concreta.
- Lenguaje fácil para el cliente. Escribe como preguntaría un cliente, no como documentaría un ingeniero.
- Campos obligatorios: Título del tema, alcance, audiencia, autor, fecha de última actualización, estado de aprobación, número de versión y una breve nota de cambios.
- Sin datos duplicados. Si una canalización de ingesta ya extrae los precios actuales de tu sistema de referencia, no escribas ese precio de forma fija en un artículo de la KB. Quedará obsoleto.
- Revisión proactiva de registros. Revisa los registros de conversaciones con una periodicidad establecida para encontrar carencias antes de que los clientes las notifiquen.
Funciones de gobernanza
- Responsable de contenido: Experto en la materia que redacta y actualiza artículos de su área.
- Responsable de conocimiento: Aplica los estándares, realiza auditorías, gestiona el ciclo de vida de los artículos y es responsable del calendario editorial.
- Aprobador: Líder o responsable del equipo que da su aprobación antes de que un artículo se publique.
- Responsable de ML: Gestiona los parámetros de fragmentación, las actualizaciones del modelo de embeddings, la configuración del recuperador y el mantenimiento del conjunto de pruebas.
- Revisor de cumplimiento: Aprobación obligatoria para los artículos que traten temas regulados (precios, condiciones legales y privacidad de datos).
Señales de confianza que debes implementar ahora
- Registros de auditoría que registren cada acción de creación, edición, aprobación y retirada con una marca de tiempo y el ID del usuario.
- Historial de versiones con vistas de diferencias para que cualquier cambio pueda revisarse.
- Registros de cambios adjuntos a cada artículo que muestren qué cambió y por qué.
- Sellos de aprobación visibles en el administrador de la KB para que el equipo pueda ver qué contenido está autorizado y cuál no para su uso en el chatbot.
- Referencias a las fuentes visibles en cada respuesta del chatbot.
Qué medir y cómo actuar a partir de las señales
La supervisión es el punto en el que se toman las decisiones de mantenimiento. Sin métricas, estás adivinando qué artículos actualizar. Con ellas, tienes una cola de trabajo priorizada cada semana.
Métricas clave que debes seguir:
- Precisión/corrección de las respuestas: Porcentaje de respuestas del chatbot que coinciden con la respuesta autorizada en un conjunto de pruebas muestreado.
- Tasa de fundamentación: Porcentaje de respuestas que citan un fragmento de fuente concreto. Una disminución aquí indica una deriva del recuperador o contenido ausente.
- Tasa de resolución automática: Porcentaje de conversaciones resueltas sin intervención del usuario. El aumento de las escalaciones suele deberse a una carencia específica de la KB.
- Tasa de escalación: Inversa de la resolución automática; mídela por categoría temática para identificar qué áreas de contenido necesitan atención.
- Tiempo hasta la actualización: Cuánto se tarda desde la identificación de una carencia hasta la publicación de una solución verificada.
- CSAT del bot: Puntuación de satisfacción del cliente específicamente para las conversaciones gestionadas por el chatbot.
- Incidentes de alucinación: Número de casos confirmados en los que el bot produjo una respuesta objetivamente incorrecta que no estaba fundamentada en ninguna fuente.
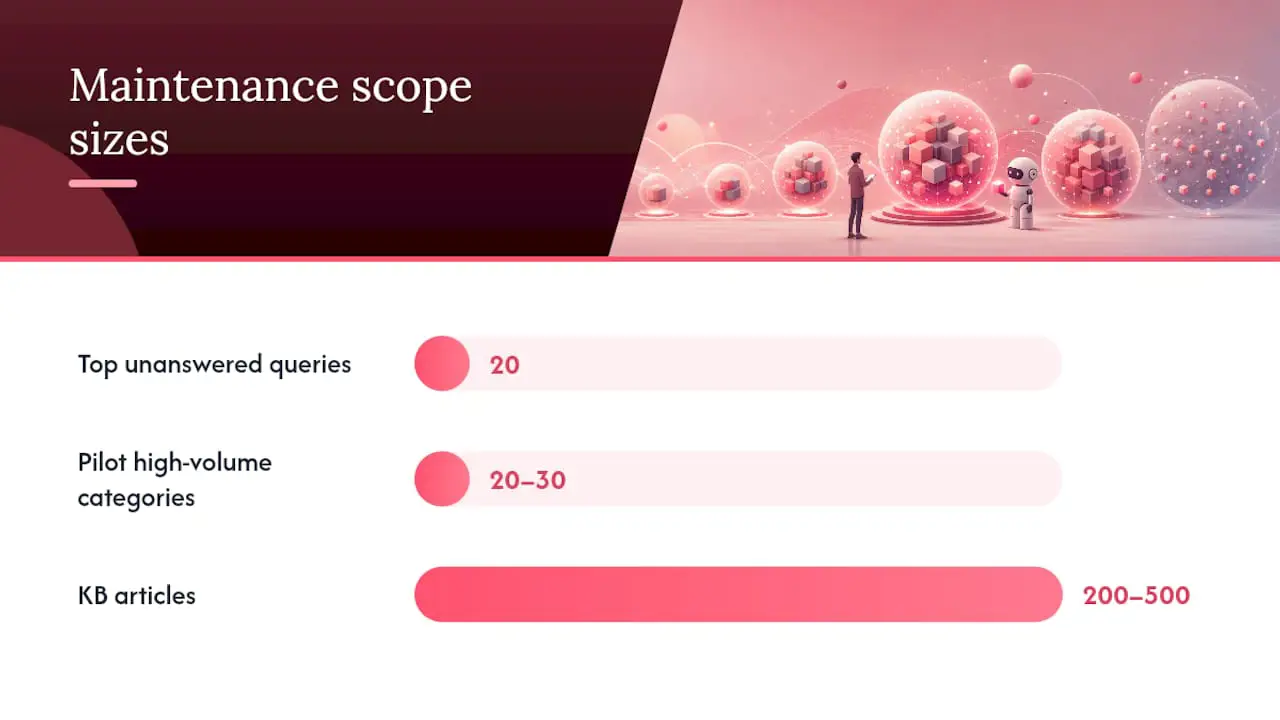
El uso más práctico de los registros es generar cada semana una lista de las 20 consultas sin respuesta principales. Ordénalas por volumen, asigna cada una a un responsable de contenido y realiza un seguimiento del tiempo hasta su cierre. Esa lista se convierte en tu cartera de mantenimiento.
Patrones de herramientas y lista de comprobación de integración
Las herramientas adecuadas hacen que el manual anterior sea repetible sin un esfuerzo manual extraordinario. Al evaluar plataformas y patrones de integración, prioriza estas capacidades:
- Indexación incremental: El sistema puede actualizar fragmentos individuales sin volver a indexar toda la KB. Es fundamental para KB grandes, en las que la reindexación completa es lenta y costosa.
- Actualización de embeddings: Capacidad para volver a generar embeddings de los artículos actualizados sin modificar el contenido que no ha cambiado.
- Procedencia y compatibilidad con citas: Cada fragmento recuperado incluye una referencia a la fuente que aparece en la respuesta.
- Control de acceso basado en roles: Los responsables de contenido, aprobadores e ingenieros de ML tienen permisos diferentes. La plataforma debe aplicarlo.
- Registros de auditoría: Cada evento de indexación, cambio de contenido y aprobación queda registrado con una marca de tiempo y el usuario.
- Webhooks para la gestión de tickets: Cuando se resuelve un ticket, un webhook puede activar una revisión de la KB o redactar automáticamente un artículo candidato. Esto cierra el ciclo entre las operaciones de soporte y el mantenimiento del conocimiento.
- SSO: El SSO de Google y Microsoft reduce la fricción para los equipos que ya trabajan en esos ecosistemas.
Patrones de integración que funcionan en producción
Sincronización directa con la KB: La plataforma de KB envía los artículos actualizados a la base de datos vectorial según un calendario o al publicar. Es sencillo, fiable y el punto de partida adecuado para la mayoría de los equipos.
Indexación en un entorno aislado de pruebas: El contenido nuevo o actualizado se indexa primero en un entorno de pruebas. El conjunto de pruebas se ejecuta contra ese entorno antes de que cualquier cambio llegue a producción. Es el equivalente a una canalización de CI para el contenido de conocimiento.
Canalizaciones de validación similares a CI: Trata los cambios de la KB como cambios de código. Una actualización de contenido activa una ejecución de pruebas automatizada contra tu conjunto de pruebas de 20 a 30 consultas. Los fallos bloquean la publicación. Los resultados satisfactorios se envían al aprobador para la aprobación final.
Principales compensaciones que debes comprender
RAG es la arquitectura adecuada para la mayoría de los equipos de soporte cuyo conocimiento cambia con frecuencia. Actualizas documentos, no los pesos del modelo, lo que mantiene los costes bajo control y los ciclos de actualización breves. El fine-tuning tiene sentido para dominios estáticos y muy especializados en los que el vocabulario y los patrones de razonamiento son estables. La diferencia en el coste operativo es significativa: una actualización de RAG consiste en editar un documento y volver a indexarlo; un ciclo de fine-tuning requiere datos etiquetados, tiempo de computación y una evaluación completa del modelo antes del despliegue.
En cuanto al equilibrio entre latencia y actualidad, las actualizaciones más frecuentes de embeddings mantienen las respuestas al día, pero añaden costes de computación. Elige un calendario de actualización basándote en la frecuencia con la que cambia el material fuente y ejecuta una validación después de las actualizaciones importantes.
Cómo encaja Deskhero en este manual de mantenimiento
Deskhero se basa en el principio de que un chatbot debe responder únicamente a partir del conocimiento que hayas aprobado explícitamente, lo que encaja directamente con los pasos de gobernanza y validación de este manual.
Así se conectan determinados pasos del manual con las funciones de Deskhero:
- Respuestas basadas únicamente en conocimiento aprobado: El chatbot de IA de Deskhero responde a partir del contenido público aprobado de las FAQ. El resto del conocimiento del espacio de trabajo no se utiliza en las respuestas del chatbot dirigidas a clientes. Para activar el chatbot se necesitan al menos 100 elementos públicos aprobados de las FAQ.
- Sugerencias de FAQ a partir de tickets resueltos: Los tickets resueltos y las páginas web rastreadas pueden convertirse en posibles entradas de FAQ. Un usuario revisa y aprueba una entrada antes de que pueda estar disponible para el chatbot.
- Ámbitos de conocimiento separados: La base de conocimiento interna puede proporcionar sugerencias de respuestas de IA para los usuarios. Las respuestas del chatbot dirigidas a clientes utilizan únicamente las FAQ públicas aprobadas.
- Sincronización bidireccional del correo electrónico: Las preguntas de los clientes llegan por correo electrónico, formulario o chatbot y se convierten en tickets en una bandeja de entrada compartida. Las respuestas pueden enviarse desde la dirección conectada de la empresa.
- Acciones automáticas etiquetadas: Las acciones automáticas están etiquetadas y registradas, y el envío totalmente automático requiere activación voluntaria.
- API REST: Deskhero proporciona una API REST para las operaciones de tickets y espacios de trabajo. No proporciona webhooks salientes.
- Interfaz multilingüe: La interfaz de Deskhero está disponible en 14 idiomas compatibles, y la recuperación del chatbot puede encontrar contenido público de las FAQ en distintos idiomas.
Deskhero conecta buzones de Gmail, Google Workspace o Microsoft 365 con un servicio de asistencia compartido, al tiempo que permite al equipo conservar sus direcciones de correo electrónico actuales. Su IA orientada al cliente responde a partir del contenido público aprobado de las FAQ y transfiere las preguntas sin resolver a una persona. Las sugerencias de FAQ pueden redactarse a partir de tickets resueltos y páginas web rastreadas, pero un usuario debe revisarlas antes de aprobarlas. Las acciones automáticas están etiquetadas y registradas. La plataforma también incluye una base de conocimiento interna, análisis de tickets, 14 idiomas de interfaz, integración con Shopify, SSO de Google y Microsoft y una API REST. Comienza con una prueba gratuita de 30 días, sin necesidad de tarjeta de crédito.
Como el chatbot de Deskhero está limitado a las FAQ públicas aprobadas, la tarea de mantenimiento es concreta: revisar las preguntas sin resolver, mejorar o añadir entradas de FAQ, aprobarlas y comprobar si el conocimiento actualizado responde a las preguntas previstas.
Para profundizar en cómo los chatbots de IA gestionan la escalación y la transferencia a una persona dentro de este tipo de flujo de trabajo, la guía sobre transferencia del chatbot a una persona explica detalladamente los patrones operativos.
Periodicidad del mantenimiento, personal y consideraciones de costes
Planificar las personas y el tiempo necesarios para gestionar el conocimiento del chatbot es el punto en el que la mayoría de los equipos subestima el trabajo. La buena noticia es que un equipo pequeño con una periodicidad clara puede mantener una KB en producción sin contar con personal dedicado.
Periodicidades recomendadas:
- Semanal: Revisa los registros de conversaciones, extrae la lista de las 20 consultas sin respuesta principales, marca las carencias urgentes de contenido y envía las correcciones prioritarias a través de la etapa de aprobación.
- Mensual: Ejecuta un ciclo completo de actualización de contenido. Redacta artículos nuevos, actualiza las políticas o productos modificados, retira el contenido obsoleto y ejecuta el conjunto completo de pruebas.
- Trimestral: Revisa los cambios en las políticas y los productos, ajusta el recuperador, evalúa el modelo de embeddings y realiza una auditoría de gobernanza (¿están todos los artículos correctamente aprobados y versionados?).
Modelo mínimo de personal para equipos pequeños:
- Responsable de conocimiento: Se encarga del calendario editorial, realiza auditorías, aplica los estándares y gestiona la cola de aprobación. El tiempo necesario depende del volumen de contenido y de la frecuencia de los cambios.
- Soporte técnico: Gestiona los parámetros de fragmentación, las actualizaciones de embeddings, la configuración de recuperación y el mantenimiento del conjunto de pruebas cuando el equipo administra su propia pila de recuperación.
- Expertos en la materia rotativos: Cada dominio de producto o política tiene un responsable de contenido designado que revisa y aprueba los artículos de su área. Normalmente es una responsabilidad parcial añadida a una función existente.
Factores de coste que debes estimar:
- Los costes de almacenamiento y consulta de la base de datos vectorial aumentan según el tamaño de la KB y el volumen de consultas.
- La frecuencia de actualización de embeddings afecta al coste de computación, por lo que conviene actualizar el contenido modificado cuando la plataforma admite actualizaciones incrementales.
- El tiempo de revisión humana puede representar un coste considerable, especialmente cuando los productos o las políticas cambian con frecuencia.
- Los costes de suscripción a las herramientas varían según la plataforma. Las plataformas que combinan la gestión de la KB, la gestión de tickets y el chatbot en una sola suscripción (en lugar de exigir una base de datos vectorial, una API de LLM y herramientas de asistencia independientes) reducen tanto el coste como la complejidad de integración.
Las investigaciones sobre IA generativa en el soporte al cliente han observado aumentos de productividad en un entorno real de soporte. Considera esos resultados como contexto y no como una fórmula de personal, ya que el coste y el beneficio del mantenimiento del conocimiento dependen del equipo, el contenido y las herramientas.
Prueba piloto con un alcance de bajo coste: Empieza con entre 20 y 30 categorías de preguntas de gran volumen. Crea y mantén primero esos artículos. Verifica que la calidad de las respuestas mejora antes de ampliar la KB. Esto mantiene reducido el esfuerzo inicial de mantenimiento y aumenta la confianza interna en el proceso.
Cómo validar nuevas fuentes de conocimiento antes de integrarlas
No todos los documentos que parecen útiles pertenecen al índice del chatbot. Integrar una fuente de baja calidad o inexacta degrada toda la KB, porque el recuperador no puede distinguir un artículo bien fundamentado de uno mal redactado.
Somete cada fuente candidata a estas comprobaciones antes de indexarla:
Comprobación de precisión: ¿El contenido refleja el comportamiento, la política o los precios actuales del producto? Contrástalo con el sistema de referencia (tu CRM, la documentación del producto o los documentos de políticas aprobados por el equipo jurídico). Si no puedes verificar una afirmación frente a una fuente primaria, no la indexes.
Comprobación del alcance: ¿El contenido es relevante para las preguntas que se espera que responda tu chatbot? Un informe técnico general del sector puede contener información precisa, pero introducir ruido de recuperación fuera de tema. Limita estrictamente el alcance de los documentos a tu caso de uso.
Comprobación de duplicación: ¿Este contenido se solapa significativamente con un artículo existente de la KB? El contenido duplicado crea ambigüedad en la recuperación. Fusiónalo o consolídalo antes de indexarlo.
Comprobación de formato y estructura: ¿El documento está estructurado de forma que la fragmentación produzca pasajes coherentes y autónomos? Un documento con muchas referencias cruzadas («consulta la sección 4.2 para obtener más detalles») se fragmenta mal porque los fragmentos individuales pierden contexto. Reescríbelo o reestructúralo antes de indexarlo.
Comprobación de procedencia: ¿Puedes rastrear el contenido hasta una fuente interna o externa autorizada? En temas regulados, documenta explícitamente la fuente en los metadatos del artículo.
Prueba en entorno aislado: Indexa la nueva fuente en un entorno de pruebas y ejecuta tu conjunto estándar de 20 a 30 consultas. Comprueba si el nuevo contenido mejora, empeora o no afecta a la precisión de recuperación. Promueve únicamente las fuentes que mejoren o mantengan la precisión.
Cómo usar los comentarios de los usuarios para perfeccionar el conocimiento del chatbot
Los comentarios de los usuarios son la señal más directa que tienes sobre los puntos en los que falla la KB. El reto consiste en capturarlos de forma sistemática, en lugar de reaccionar ante las quejas más llamativas.
Los pulgares arriba/abajo en las respuestas del chatbot son el mecanismo de comentarios más sencillo. Cada respuesta del chatbot debería incluir una opción de valoración binaria. Agrupa estas valoraciones semanalmente. Una respuesta con una tasa elevada de pulgares abajo es una señal directa para revisar la KB, independientemente de que al equipo encargado de redactarla le pareciera correcta.
Las encuestas CSAT posteriores a la conversación proporcionan una señal más amplia. Las puntuaciones bajas en conversaciones gestionadas por el bot, filtradas por categoría temática, indican qué áreas de contenido necesitan más atención. Combina los datos de CSAT con los registros de escalación para confirmar si el problema es una carencia de la KB o un problema de configuración del recuperador.
Los ciclos de comentarios del equipo de soporte son valiosos. Los usuarios que gestionan escalaciones suelen saber por qué falló el bot. Un sistema sencillo de etiquetado en tu herramienta de gestión de tickets, con etiquetas como «respuesta incorrecta», «respuesta ausente» o «política obsoleta», puede convertir esa experiencia en una señal de mantenimiento estructurada.
Los registros explícitos de «No lo sé» son una mina de oro. Cada vez que el chatbot escala una conversación porque no encontró contenido relevante, registra la consulta. Ordénalas semanalmente por volumen. Las consultas principales de esa lista son tus tareas de redacción prioritarias.
Las encuestas periódicas a los usuarios sobre la calidad de la KB (enviadas a clientes que interactuaron con el chatbot durante los últimos 30 días) ponen de manifiesto problemas sistémicos que las valoraciones de conversaciones individuales no detectan. Limita la encuesta a dos o tres preguntas y vincula las respuestas a los ID de conversación para poder rastrear los comentarios hasta artículos concretos.
El ciclo de comentarios se cierra cuando una consulta marcada se convierte en un artículo de la KB, el artículo pasa por el flujo de aprobación y mejora la respuesta del chatbot a esa consulta. Medir el tiempo de ese ciclo (desde la identificación hasta la solución) es una de las métricas operativas más útiles que puede gestionar un responsable de conocimiento.
Lo que los equipos de soporte realmente aprenden al ejecutar esto en producción
El manual anterior es correcto en teoría. Esto es lo que falla en la práctica y cómo solucionarlo rápidamente.
Empieza poco a poco y demuestra el valor antes de ampliar. Indexar todos los documentos disponibles de una vez puede crear una KB abultada y dificultar el establecimiento de una línea de referencia de calidad útil. Elige entre 20 y 30 categorías de preguntas de gran volumen, crea artículos claros para ellas y ejecuta el chatbot con ese alcance limitado. Amplía después de que las pruebas demuestren que las respuestas son precisas y útiles.
Gestiona explícitamente el contenido limitado en el tiempo. Las promociones, las políticas estacionales y las ofertas por tiempo limitado pueden quedar obsoletas con facilidad. Crea una etiqueta de metadatos independiente para el contenido limitado en el tiempo y establece una fecha obligatoria de revisión de caducidad en el momento de redactarlo.
Registra y sigue periódicamente las respuestas desconocidas. Revisar con frecuencia el registro de «No lo sé» ayuda a los equipos a detectar carencias repetidas antes de que se acumulen. Utiliza el volumen de consultas y el impacto en los clientes para priorizar las correcciones.
Consejo profesional: Los tickets resueltos son material fuente útil para las respuestas autorizadas porque muestran cómo gestionó el equipo las preguntas reales. Deskhero utiliza periódicamente tickets resueltos como material fuente para sugerir FAQ. Un usuario puede revisar, editar, aprobar o rechazar cada sugerencia antes de que el contenido aprobado esté disponible para el chatbot.
Soluciones rápidas para los equipos que acaban de empezar:
- Establece desde el primer día una convención de nomenclatura para los artículos (Área del producto: Tema: Audiencia). Cambiar retroactivamente el nombre de 200 artículos resulta complicado.
- Crea una plantilla de metadatos con campos obligatorios y pégala en cada artículo nuevo antes de redactarlo.
- Construye un conjunto de pruebas con entre 20 y 30 consultas reales extraídas de los primeros registros de conversaciones y ejecútalo antes de cada publicación en producción.
Deskhero hace operativo el manual de mantenimiento desde el primer día
Ejecutar este manual en herramientas desconectadas puede generar trabajo adicional de coordinación. Deskhero reúne en el mismo servicio de asistencia el flujo de revisión de las FAQ públicas, las sugerencias de FAQ y las conversaciones con los clientes.
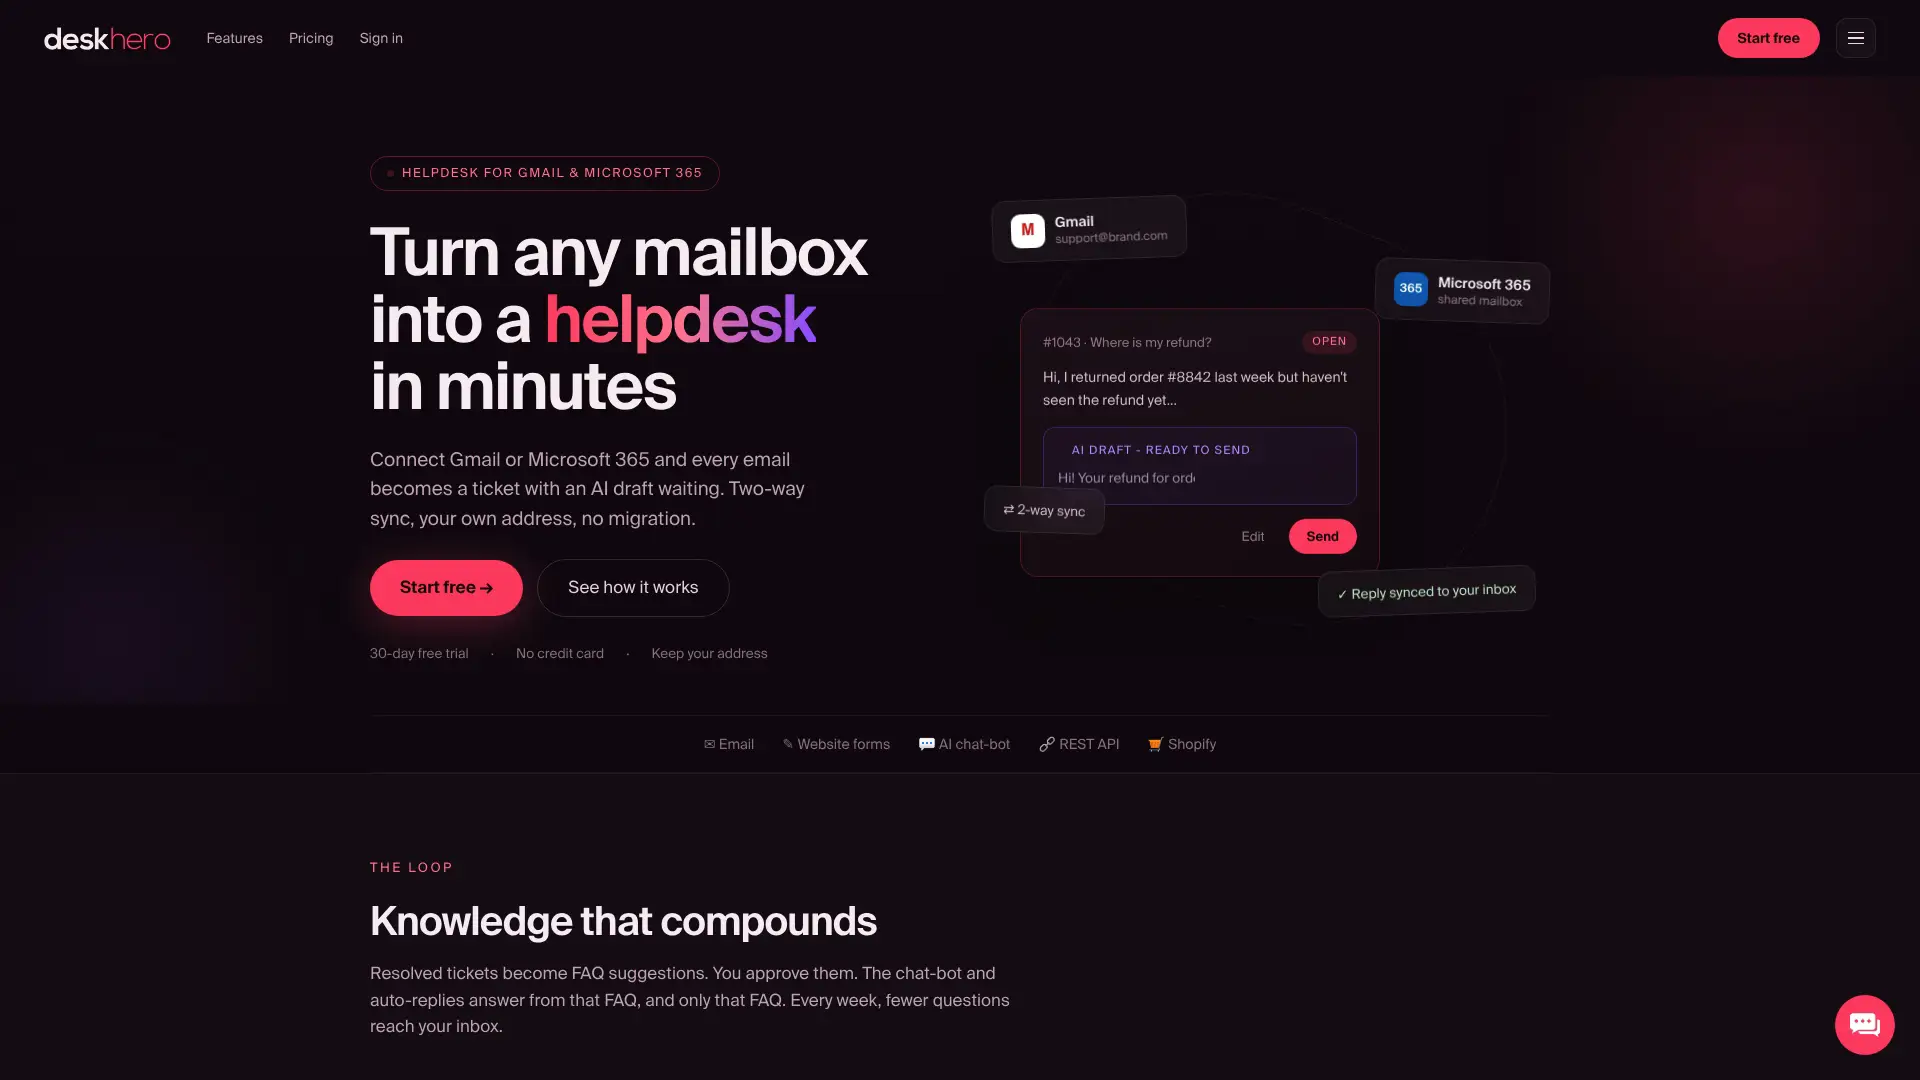
El chatbot responde únicamente a partir del contenido público aprobado de las FAQ, mientras que las sugerencias de respuestas de IA para los usuarios pueden utilizar un conocimiento más amplio del espacio de trabajo. Las sugerencias de FAQ procedentes de tickets resueltos y páginas web rastreadas reducen el trabajo de redactar desde cero, pero siguen requiriendo una revisión humana. La integración bidireccional de buzones mantiene conectados los tickets y las respuestas con la dirección existente del equipo.
Para los equipos que quieren este flujo de trabajo sin montar una pila de recuperación personalizada, Deskhero combina la bandeja de entrada compartida, las FAQ públicas, el chatbot y la transferencia a una persona. Comienza una prueba gratuita de 30 días en Deskhero, sin necesidad de tarjeta de crédito.
Fuentes
Utiliza estas fuentes como referencias de implementación al tomar decisiones técnicas sobre la estrategia de fragmentación, el enfoque de entrenamiento, la política de gobernanza y la configuración de medición.
Preguntas frecuentes
¿Qué es una base de conocimiento para chatbots?
Una base de conocimiento para chatbots es un conjunto seleccionado de documentos fuente, dividido en pasajes, convertido en embeddings vectoriales y almacenado en una base de datos vectorial para que un recuperador pueda extraer el contenido más relevante en el momento de la consulta y fundamentar las respuestas del chatbot en tu contenido real.
¿Cómo se mantiene un chatbot con el paso del tiempo?
Ejecuta un ciclo repetible: audita los registros de conversaciones para encontrar carencias, actualiza o redacta artículos autorizados, fragmenta y genera embeddings en un entorno de pruebas, valida con un conjunto de pruebas de 20 a 30 consultas, obtén la aprobación del responsable, publica en producción y supervisa la calidad de las respuestas y las transferencias para detectar regresiones.
¿Qué nunca debes decirle a un chatbot?
Evita introducir datos personales sensibles (números de la Seguridad Social, contraseñas y datos de cuentas financieras) en cualquier interfaz de chatbot, ya que las entradas pueden registrarse o utilizarse para entrenar modelos, dependiendo de la política de tratamiento de datos de la plataforma. Al redactar una KB interna, nunca escribas de forma fija datos actuales (precios, inventario) que una canalización de ingesta pueda obtener directamente del sistema de referencia.
¿Cuánto cuesta mantener un chatbot?
Los principales costes son el tiempo de revisión, la computación de recuperación y embeddings cuando esos componentes se gestionan directamente, y cualquier suscripción a un servicio de asistencia o plataforma de conocimiento. Estímalos según el volumen de contenido, el volumen de consultas, la frecuencia de las actualizaciones y la cantidad de revisión humana necesaria.