Sådan vedligeholder du chatbotviden: En praktisk guide
Vedligehold chatbotviden som en tilbagevendende, rollebaseret proces: auditér → opdatér → validér → publicér → udfas. Denne cyklus i fem trin, gennemført med en forudsigelig kadence og tydeligt ejerskab ved hvert kontrolpunkt, er det, der adskiller en chatbot, som opbygger kundernes tillid, fra en, der stille og roligt nedbryder den.
Her er den korte tjekliste, dit team har brug for, før noget andet:
- Kildehygiejne: Fjern forældede, dublerede eller modstridende dokumenter, før de når indekset.
- Opdeling og indeksering: Start med tekstblokke på 500 til 1.000 tegn, og justér derefter størrelsen baseret på hentningstests.
- Finjustering af hentning: Test og justér lighedstærskler kvartalsvist, så præcisionen forbliver høj, efterhånden som vidensbasen vokser.
- Godkendelsesworkflow: Alle nye eller redigerede artikler skal godkendes, før de gøres tilgængelige i chatbotten.
- Overvågningsmålinger: Følg svarenes kvalitet, ubesvarede spørgsmål og overdragelser efter en fast tidsplan.
- Tilbagerulning og versionsstyring: Før en ændringslog, så enhver dårlig opdatering kan rulles tilbage på få minutter.
Hvem ejer hvad: Indholdsejere skriver og opdaterer artikler. En vidensansvarlig håndhæver standarder og gennemfører audits. En teknisk ejer håndterer opdeling, embeddings og indstillinger for hentning, når teamet administrerer disse komponenter. En reviewer kører testsæt før hver publicering. Compliance-specialister gennemgår indhold, der omhandler regulerede emner.
Vigtigste pointer
Vedligeholdelse af chatbotviden kræver en gentagelig cyklus fra audit til udfasning, tydeligt ejerskab og regelmæssig overvågning for at opdage mangler, før kunderne gør det.
| Punkt | Detaljer |
|---|---|
| Brug cyklussen fra audit til udfasning | Gennemfør auditér → opdatér → validér → publicér → udfas efter en ugentlig/månedlig/kvartalsvis kadence for at forhindre, at vidensbasen bliver forældet. |
| Test størrelsen på tekstblokke | Start med hentningsblokke på 500 til 1.000 tegn, og justér baseret på testresultaterne. |
| Følg nyttige kvalitetssignaler | Overvåg svarenes nøjagtighed, ubesvarede spørgsmål, overdragelser og bekræftede forkerte svar, og definér derefter tærskler, der passer til din service. |
| Udpeg en vidensansvarlig | Giv én person et tydeligt ansvar for den redaktionelle kalender, gennemgangskøen og vedligeholdelseskadencen. |
| Deskhero håndhæver svar baseret på godkendt viden | Deskhero’s chatbot svarer kun ud fra godkendt offentligt FAQ-indhold og foreslår FAQ-kandidater fra løste tickets og scannede websider. |
Indholdsfortegnelse
- Hvad er en vidensbase til en chatbot, og hvordan danner den grundlag for svar?
- Hvorfor er løbende vedligeholdelse vigtig for chatbotters nøjagtighed?
- Trinvis operationel playbook til vedligeholdelse af chatbotviden
- Standarder, skabeloner og governance, der holder svar pålidelige
- Hvad skal du måle, og hvordan handler du på signalerne?
- Værktøjsmønstre og integrations-tjekliste
- Sådan passer Deskhero til denne vedligeholdelsesplaybook
- Vedligeholdelseskadence, bemanding og omkostningsovervejelser
- Sådan validerer du nye videnskilder før integration
- Sådan bruger du brugerfeedback til at forbedre chatbotviden
- Hvad supportteams faktisk lærer ved at køre dette i produktion
- Deskhero gør vedligeholdelsesplaybooken operationel fra dag ét
- Kilder
- Ofte stillede spørgsmål
Hvad er en vidensbase til en chatbot, og hvordan danner den grundlag for svar?
En chatbot-vidensbase (KB) er ikke bare en mappe med hjælpeartikler. Det er en kurateret pipeline: Kildedokumenter går gennem et trin, hvor de opdeles i tekstblokke, hver tekstblok omdannes til en numerisk vektor (en embedding), vektorerne gemmes i en vektordatabase, og en retriever henter de mest relevante tekstblokke på forespørgselstidspunktet. Sprogmodellen sammensætter derefter et svar ud fra de hentede tekstblokke, baseret på dit faktiske indhold frem for modellens grundlæggende træningsdata.
Mange AI-videnschatsbots bruger en hentningspipeline med tekstblokke, embeddings, en vektordatabase, en retriever og en sprogmodel. Systemer, der bevarer kildereferencer, gør det lettere at inspicere et svar og spore det tilbage til det anvendte materiale.
De centrale komponenter i en velfungerende KB-pipeline:
- Kildedokumenter: KB-artikler, løste tickets, PDF’er, websider og politikdokumenter.
- Metadata: Tags for emne, produktområde, målgruppe, senest opdateret-dato og forfatter.
- Embeddings: Tætte vektorrepræsentationer af hver tekstblok, genereret af en embedding-model.
- Vektordatabase: Gemmer og indekserer embeddings til hurtig semantisk søgning (Pinecone, Weaviate, pgvector og lignende værktøjer).
- Retriever: Forespørger vektor-databasen og returnerer de top-N mest relevante tekstblokke.
- LLM plus systemprompter: Sammensætter de hentede tekstblokke til et naturligt sprogligt svar, begrænset af dine instruktioner.
- Citeringslag: Tilføjer kildereferencer til hvert svar, så brugere og kunder kan verificere det.
Professionelt tip: Hold hver artikel fokuseret på ét tydeligt emne. Opdel dokumenter, der besvarer flere urelaterede spørgsmål. Størrelsen på tekstblokke er også vigtig: start med 500 til 1.000 tegn, og justér baseret på testresultaterne. Tekstblokke, der er for små, kan miste kontekst, mens tekstblokke, der er for store, kan begrave den relevante sætning.
Hvorfor er løbende vedligeholdelse vigtig for chatbotters nøjagtighed?
En chatbot, der trænes én gang og derefter efterlades, forringes. Produkter ændrer sig, politikker opdateres, priser ændres, og vidensbasen sakker ubemærket bagud. Chatbotten fortsætter med at svare ud fra forældede data, og kunderne opdager det, før dit team gør.
En opdateret KB kan forbedre svarenes kvalitet og hjælpe flere kunder med at løse rutinespørgsmål uden en overdragelse. En konsekvent tone og godkendte formuleringer kan også reducere fejl, der kan undgås. Nye brugere får et tydeligere referencepunkt, når KB’en behandles som den autoritative kilde. Resultaterne afhænger stadig af indholdets kvalitet, implementeringens omfang og chatbotkonfigurationen.
Risiciene ved manglende vedligeholdelse er lige så tydelige:
- Forældede svar: En chatbot, der henviser til et udgået produkt eller en gammel returpolitik, skader straks troværdigheden.
- Modstridende indhold: To artikler, der giver forskellige svar på det samme spørgsmål, forvirrer retrieveren og skaber inkonsekvente svar.
- Risiko for hallucinationer: Når retrieveren ikke finder noget relevant, opfinder et dårligt konfigureret system et svar. En velvedligeholdt KB mindsker dette hul.
- Compliance-eksponering: I regulerede brancher kan et forældet svar om en politik skabe alvorlige problemer med gennemgang og compliance.
- Udhulet tillid: Kunder, der får et forkert svar to gange, giver sjældent botten en tredje chance.
Trinvis operationel playbook til vedligeholdelse af chatbotviden
Dette er en gentagelig arbejdsgang, som dit team kan omsætte til en intern SOP. Fastlæg en praktisk kadence for gennemgang af logs, indholdsopdateringer og tests af hentning, og tilpas den derefter til, hvor ofte dine produkter og politikker ændrer sig.
-
Planlæg auditen. Hent samtalelogfilerne fra den foregående periode. Markér forespørgsler med lave konfidensscorer, eskaleringer og “det ved jeg ikke”-fallbacks. Dette er dine vigtigste mangler.
-
Identificér manglende og forældet indhold. Krydsreferér de markerede forespørgsler med eksisterende KB-artikler. Markér artikler, der henviser til udfasede funktioner, gamle priser eller udløbne kampagner, til øjeblikkelig opdatering eller udfasning.
-
Skriv eller opdatér autoritative svar. Skriv én artikel pr. emne. Brug kundevendt sprog, ikke intern jargon. Obligatoriske felter: emnetitel, omfang (hvilket produkt/abonnement den gælder for), tiltænkt målgruppe, forfatter, senest opdateret-dato og godkendelsesstatus.
-
Opdel og lav embeddings. Start med at opdele opdaterede artikler i tekstblokke på 500 til 1.000 tegn. Tilføj metadatatags (emne, produkt, sprog, målgruppe). Kør tekstblokkene gennem din embedding-model, og indlæs dem i vektordatabasen i et stagingmiljø, ikke i produktion.
-
Kør valideringstests i staging. Brug et testsæt med 20 til 30 virkelige forespørgsler fra logs. Kontrollér, at hver forespørgsel henter den korrekte tekstblok, og at det genererede svar stemmer overens med det autoritative svar. Fastlæg en beståelsestærskel for hentningsnøjagtighed, før indholdet flyttes til produktion.
-
Send til produktion med et godkendelsespunkt. En udpeget godkender (vidensansvarlig eller teamleder) gennemgår testresultaterne og godkender dem. Log publiceringshændelsen med tidsstempel, forfatter og versionsnummer.
-
Overvåg efter publicering. Hold nøje øje med svarenes kvalitet og overdragelser efter enhver væsentlig opdatering. Hvis en måling falder, eller gennemgange finder forkerte svar, skal ændringen rulles tilbage ved hjælp af versionshistorikken.
-
Udfas forældet indhold. Arkivér i stedet for at slette, så versionshistorikken forbliver intakt. Opdatér alle artikler, der henviste til det udfasede indhold.
Professionelt tip: Når platformen understøtter det, bør du kræve kildereferencer for faktuelle svar. Kombinér det med en tydelig fallback-instruktion: Hvis hentningen ikke returnerer tilstrækkeligt relevant indhold, skal chatbotten sige, at den ikke kan svare, og tilbyde en menneskelig overdragelse i stedet for at gætte.
Professionelt tip: Kvalitet slår kvantitet på alle trin. Fem til ti velskrevne, fokuserede dokumenter skaber en mere kompetent assistent end halvtreds løst strukturerede dokumenter. Fjern overflødigt indhold konsekvent, før du indekserer.
Standarder, skabeloner og governance, der holder svar pålidelige
God governance er ikke bureaukrati for bureaukratiets egen skyld. En menneskecentreret tilgang til AI tager udgangspunkt i behovene og trivslen hos de mennesker, der påvirkes af systemet. For en kundevendt chatbot gør dokumenterede godkendelser, versionshistorik og ændringsnoter gennemgang og ansvarlighed praktisk muligt.
Redaktionelle standarder, som alle artikler skal opfylde
- Ét emne, ét svar. Ingen artikel må dække mere end ét afgrænset spørgsmål.
- Kundevenligt sprog. Skriv på den måde, en kunde ville spørge, ikke på den måde, en ingeniør ville dokumentere.
- Obligatoriske felter: Emnetitel, omfang, målgruppe, forfatter, senest opdateret-dato, godkendelsesstatus, versionsnummer og en kort ændringsnote.
- Ingen duplikerede data. Hvis en ingest-pipeline allerede henter aktuelle priser fra dit system of record, skal du ikke hardcode prisen i en KB-artikel. Den bliver forældet.
- Proaktiv loggennemgang. Gennemgå samtalelogfiler efter en fast kadence for at finde mangler, før kunderne rapporterer dem.
Governance-roller
- Indholdsejer: Fagekspert, der skriver og opdaterer artikler inden for sit område.
- Vidensansvarlig: Håndhæver standarder, gennemfører audits, administrerer artiklernes livscyklus og ejer den redaktionelle kalender.
- Godkender: Teamleder eller manager, der godkender, før en artikel gøres tilgængelig.
- ML-ejer: Håndterer parametre for opdeling, opdateringer af embedding-model, retrieverkonfiguration og vedligeholdelse af testsæt.
- Compliance-reviewer: Obligatorisk godkendelse af artikler, der berører regulerede emner (priser, juridiske vilkår og databeskyttelse).
Troværdighedssignaler, der bør implementeres nu
- Auditlogs, der registrerer enhver oprettelse, redigering, godkendelse og udfasning med tidsstempel og bruger-id.
- Versionshistorik med diff-visninger, så enhver ændring kan gennemgås.
- Ændringslogs knyttet til hver artikel, der viser, hvad der blev ændret, og hvorfor.
- Godkendelsesstempler, der er synlige i KB-administrationen, så teamet kan se, hvad der er godkendt til chatbotbrug, og hvad der ikke er.
- Kildehenvisninger, der vises i hvert chatbot-svar.
Hvad skal du måle, og hvordan handler du på signalerne?
Det er gennem overvågning, at beslutninger om vedligeholdelse bliver truffet. Uden målinger gætter du på, hvilke artikler der skal opdateres. Med målinger har du en prioriteret arbejdskø hver uge.
Vigtige målinger at følge:
- Svarnøjagtighed/korrekthed: Procentdelen af chatbot-svar, der stemmer overens med det autoritative svar i et udtaget testsæt.
- Forankringsgrad: Procentdelen af svar, der henviser til en specifik kildeblok. Et fald her signalerer retriever-drift eller manglende indhold.
- Afværgerate: Procentdelen af samtaler, der løses uden brugerindblanding. Stigende eskaleringer kan ofte spores tilbage til en specifik mangel i KB’en.
- Eskalationsrate: Det modsatte af afværgeraten; følg den efter emnekategori for at finde de indholdsområder, der kræver opmærksomhed.
- Tid til opdatering: Hvor lang tid det tager fra identificering af en mangel til publicering af en verificeret løsning.
- CSAT for botten: Kundetilfredshedsscore specifikt for samtaler, chatbotten har håndteret.
- Hallucinationshændelser: Antallet af bekræftede tilfælde, hvor botten producerede et faktuelt forkert svar, der ikke var forankret i nogen kilde.
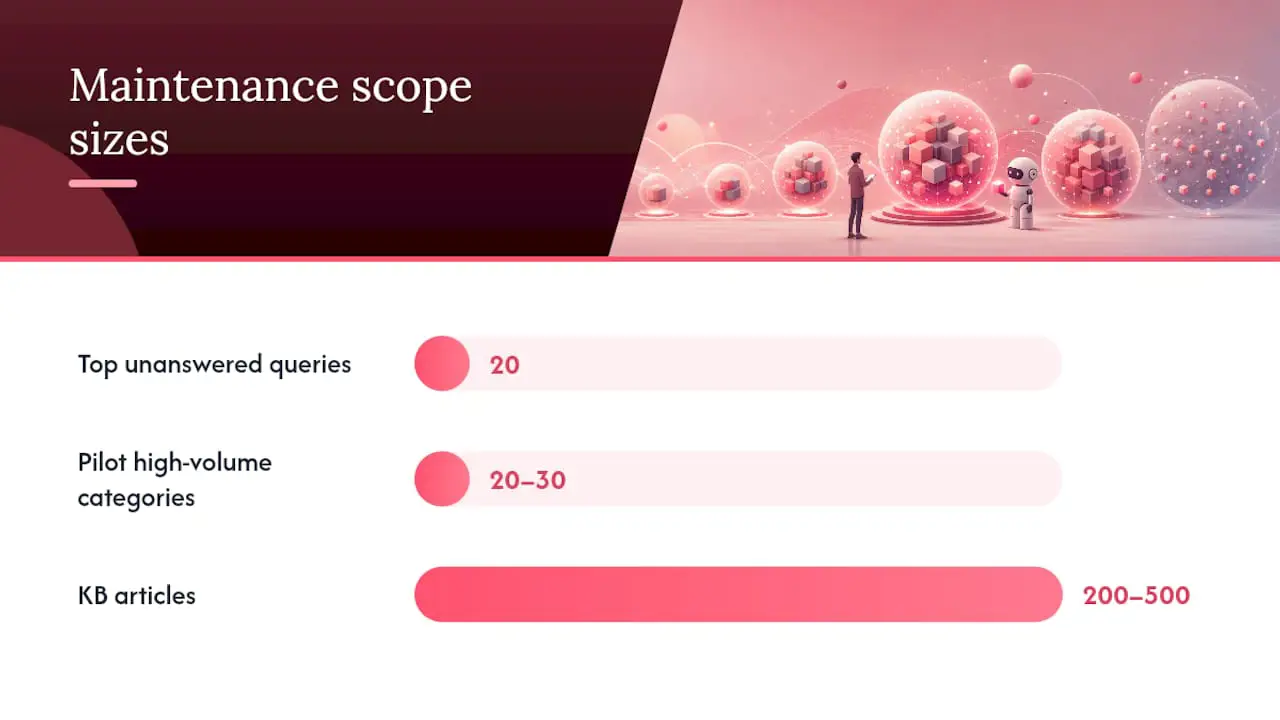
Den mest praktiske anvendelse af logs er at generere en liste over de 20 mest ubesvarede forespørgsler hver uge. Sortér efter antal, tildel hver forespørgsel til en indholdsejer, og følg tiden til lukning. Listen bliver din vedligeholdelsesbacklog.
Værktøjsmønstre og integrations-tjekliste
De rette værktøjer gør ovenstående playbook gentagelig uden heroisk manuelt arbejde. Når du evaluerer platforme og integrationsmønstre, bør du prioritere disse funktioner:
- Inkrementel indeksering: Systemet kan opdatere individuelle tekstblokke uden at genindeksere hele KB’en. Det er afgørende for store KB’er, hvor fuld genindeksering er langsom og dyr.
- Opdatering af embeddings: Mulighed for at generere embeddings på ny for opdaterede artikler uden at berøre uændret indhold.
- Proveniens og understøttelse af citering: Hver hentet tekstblok har en kildereference, der vises i svaret.
- Rollebaseret adgangskontrol: Indholdsejere, godkendere og ML-ingeniører har forskellige tilladelser. Det skal platformen håndhæve.
- Auditlogs: Enhver indekseringshændelse, indholdsændring og godkendelse logges med tidsstempel og bruger.
- Webhooks til ticketsystemer: Når en ticket løses, kan en webhook udløse en KB-gennemgang eller automatisk kladde et forslag til en artikel. Det lukker forbindelsen mellem supportdrift og vedligeholdelse af viden.
- SSO: Google- og Microsoft-SSO mindsker friktionen for teams, der allerede befinder sig i disse økosystemer.
Integrationsmønstre, der fungerer i produktion
Direkte KB-synkronisering: KB-platformen sender opdaterede artikler til vektordatabasen efter en tidsplan eller ved publicering. Det er enkelt, pålideligt og det rigtige udgangspunkt for de fleste teams.
Indeksering i staged sandbox: Nyt eller opdateret indhold indekseres først i et stagingmiljø. Testpakken køres mod staging, før ændringer når produktionen. Det svarer til en CI-pipeline for vidensindhold.
CI-lignende valideringspipelines: Behandl KB-ændringer som kodeændringer. En indholdsopdatering udløser en automatiseret testkørsel mod dit testsæt med 20 til 30 forespørgsler. Fejl blokerer publiceringen. Beståede tests sendes videre til godkenderen for den endelige godkendelse.
Vigtige afvejninger, du bør forstå
RAG er den rette arkitektur for de fleste supportteams med viden, der ændrer sig ofte. Du opdaterer dokumenter, ikke modelvægte, hvilket holder omkostningerne håndterbare og opdateringscyklusserne korte. Finjustering giver mening for statiske, højt specialiserede områder, hvor ordforrådet og ræsonneringsmønstrene er stabile. Forskellen i driftsomkostninger er betydelig: En RAG-opdatering er en dokumentredigering og en genindeksering; en finjusteringscyklus kræver mærkede data, beregningstid og en fuld modelevaluering før implementering.
Hvad angår afvejningen mellem svartid og aktualitet, holder hyppigere opdateringer af embeddings svarene aktuelle, men øger beregningsomkostningerne. Vælg en opdateringsplan baseret på, hvor ofte kildematerialet ændrer sig, og kør validering efter vigtige opdateringer.
Sådan passer Deskhero til denne vedligeholdelsesplaybook
Deskhero er bygget ud fra princippet om, at en chatbot kun bør svare ud fra viden, du udtrykkeligt har godkendt, hvilket passer direkte til governance- og valideringstrinnene i denne playbook.
Sådan forbindes specifikke trin i playbooken med Deskhero-funktioner:
- Svar udelukkende baseret på godkendt viden: Deskhero’s AI-chatbot svarer ud fra godkendt offentligt FAQ-indhold. Anden viden fra arbejdsområdet bruges ikke til kundevendte chatbot-svar. Aktivering af chatbotten kræver mindst 100 godkendte offentlige FAQ-elementer.
- FAQ-forslag fra løste tickets: Løste tickets og scannede websider kan omdannes til forslag til FAQ-poster. En bruger gennemgår og godkender en post, før den kan gøres tilgængelig for chatbotten.
- Adskilte vidensområder: Den interne vidensbase kan informere AI-svarforslag til brugere. Kundevendte chatbot-svar bruger kun den godkendte offentlige FAQ.
- To-vejs e-mailsynkronisering: Kundespørgsmål ankommer via e-mail, formular eller chatbot og bliver til tickets i en fælles indbakke. Svar kan sendes fra virksomhedens tilknyttede adresse.
- Mærkede automatiske handlinger: Automatiske handlinger er mærket og logget, og fuldautomatisk afsendelse er tilvalgsbaseret.
- REST API: Deskhero tilbyder en REST API til ticket- og arbejdsområdehandlinger. Den tilbyder ikke udgående webhooks.
- Flersproget grænseflade: Deskhero’s grænseflade findes på 14 understøttede sprog, og chatbot-hentning kan matche offentligt FAQ-indhold på tværs af sprog.
Deskhero forbinder Gmail-, Google Workspace- eller Microsoft 365-postkasser med en fælles helpdesk, samtidig med at teamet kan beholde sine eksisterende e-mailadresser. Den kundevendte AI svarer ud fra godkendt offentligt FAQ-indhold og sender ubesvarede spørgsmål videre til et menneske. FAQ-forslag kan oprettes som kladder ud fra løste tickets og scannede websider, men en bruger skal gennemgå dem, før de godkendes. Automatiske handlinger er mærket og logget. Platformen omfatter også en intern vidensbase, ticketindsigt, 14 grænsefladesprog, Shopify-integration, Google- og Microsoft-SSO samt en REST API. Den starter med en gratis prøveperiode på 30 dage, uden krav om kreditkort.
Fordi Deskhero’s chatbot er begrænset til den godkendte offentlige FAQ, er vedligeholdelsesopgaven konkret: Gennemgå ubesvarede spørgsmål, forbedr eller tilføj FAQ-poster, godkend dem, og kontrollér, om den opdaterede viden besvarer de tilsigtede spørgsmål.
Hvis du vil se nærmere på, hvordan AI-chatbots håndterer eskalering og menneskelig overdragelse i denne type workflow, gennemgår guiden til menneskelig overdragelse fra chatbot de operationelle mønstre i detaljer.
Vedligeholdelseskadence, bemanding og omkostningsovervejelser
Det er ofte, når man planlægger de mennesker og den tid, der ligger bag håndtering af chatbotviden, at de fleste teams undervurderer arbejdsbyrden. Den gode nyhed er, at et lille team med en tydelig kadence kan vedligeholde en produktions-KB uden dedikerede medarbejdere.
Anbefalede kadencer:
- Ugentligt: Gennemgå samtalelogfiler, hent listen over de 20 mest ubesvarede forespørgsler, markér presserende indholdsmangler, og send højt prioriterede rettelser gennem godkendelsespunktet.
- Månedligt: Gennemfør en komplet indholdsopdateringscyklus. Skriv nye artikler, opdatér ændrede politikker eller produkter, udfas forældet indhold, og kør hele testpakken.
- Kvartalsvist: Gennemgang af politik- og produktændringer, finjustering af retrieveren, evaluering af embedding-modellen og en governance-audit (er alle artikler korrekt godkendt og versionsstyret?).
Minimal bemandingsmodel for små teams:
- Vidensansvarlig: Ejer den redaktionelle kalender, gennemfører audits, håndhæver standarder og administrerer godkendelseskøen. Den nødvendige tid afhænger af indholdsmængden og ændringshyppigheden.
- Teknisk support: Håndterer parametre for opdeling, opdateringer af embeddings, konfiguration af hentning og vedligeholdelse af testsuiten, når teamet selv administrerer sin hentningsstack.
- Roterende fageksperter: Hvert produkt- eller politikområde har en udpeget indholdsejer, som gennemgår og godkender artikler inden for sit område. Dette er typisk et deltidsansvar, der føjes til en eksisterende rolle.
Omkostningsdrivere, der skal estimeres:
- Omkostninger til vektordatabaselagring og forespørgsler skalerer med KB’ens størrelse og antallet af forespørgsler.
- Hyppigheden af opdateringer af embeddings påvirker beregningsomkostningerne, så opdatér ændret indhold, når platformen understøtter inkrementelle opdateringer.
- Tiden til menneskelig gennemgang kan være en betydelig omkostning, især når produkter eller politikker ændrer sig ofte.
- Abonnementsomkostninger til værktøjer varierer fra platform til platform. Platforme, der samler KB-håndtering, ticketing og chatbot i ét abonnement (i stedet for at kræve separate værktøjer til vektordatabase, LLM API og helpdesk), reducerer både omkostninger og integrationskompleksitet.
Forskning i generativ AI i kundesupport har fundet produktivitetsgevinster i en virkelig supportsituation. Betragt resultaterne som kontekst snarere end en bemandingsformel, fordi omkostningerne ved og fordelene ved vedligeholdelse af viden afhænger af teamet, indholdet og værktøjerne.
Afprøvning i et omkostningslavt område: Start med 20 til 30 kategorier af spørgsmål med høj volumen. Opbyg og vedligehold disse artikler først. Kontrollér, at svarenes kvalitet forbedres, før du udvider KB’en. Det holder den indledende vedligeholdelsesbyrde lille og opbygger intern tillid til processen.
Sådan validerer du nye videnskilder før integration
Ikke alle dokumenter, der ser nyttige ud, hører hjemme i chatbotens indeks. Integration af en kilde af lav kvalitet eller med unøjagtigheder forringer hele KB’en, fordi retrieveren ikke kan skelne mellem en veldokumenteret artikel og en dårligt skrevet artikel.
Kør hver kandidat-kilde gennem disse kontroller, før den indekseres:
Nøjagtighedskontrol: Afspejler indholdet den aktuelle produktadfærd, politik eller pris? Krydsreferér med system of record (dit CRM-system, produktdokumentation eller juridiske teams godkendte politikdokumenter). Hvis du ikke kan verificere en påstand mod en primær kilde, må du ikke indeksere den.
Omfangskontrol: Er indholdet relevant for de spørgsmål, din chatbot forventes at besvare? En bred branche-whitepaper kan indeholde nøjagtige oplysninger, men samtidig introducere støj fra irrelevante hentninger. Afgræns dokumenter nøje til din anvendelse.
Duplikatkontrol: Overlapper dette indhold betydeligt med en eksisterende KB-artikel? Duplikeret indhold skaber uklarhed i hentningen. Flet eller konsolidér det før indeksering.
Kontrol af format og struktur: Er dokumentet struktureret, så opdeling vil producere sammenhængende, selvstændige passager? Et dokument med mange krydsreferencer (“se afsnit 4.2 for detaljer”) opdeles dårligt, fordi de enkelte tekstblokke mister kontekst. Omskriv eller omstrukturer dokumentet før indeksering.
Provenienskontrol: Kan du spore indholdet til en autoritativ intern eller ekstern kilde? For regulerede emner skal kilden dokumenteres tydeligt i artiklens metadata.
Stagingtest: Indeksér den nye kilde i et stagingmiljø, og kør dit standardtestsæt med 20 til 30 forespørgsler. Kontrollér, om det nye indhold forbedrer, forringer eller ikke påvirker hentningsnøjagtigheden. Flyt kun kilder videre, der forbedrer eller opretholder nøjagtigheden.
Sådan bruger du brugerfeedback til at forbedre chatbotviden
Brugerfeedback er det mest direkte signal, du har om, hvor KB’en fejler. Udfordringen er at indsamle den systematisk i stedet for at reagere på de højeste klager.
Positiv/negativ vurdering af chatbot-svar er den enkleste feedbackmekanisme. Alle chatbot-svar bør have mulighed for en binær vurdering. Saml resultaterne ugentligt. Et svar med en høj andel negative vurderinger er et direkte signal til KB-gennemgang, uanset om svaret så korrekt ud for teamet, der skrev det.
CSAT-undersøgelser efter samtalen giver et bredere signal. Lave scorer for samtaler håndteret af botten, filtreret efter emnekategori, fortæller dig, hvilke indholdsområder der kræver mest opmærksomhed. Kombinér CSAT-data med eskalationslogs for at bekræfte, om problemet er en mangel i KB’en eller et problem med retrieverkonfigurationen.
Feedbacksløjfer fra supportteamet er værdifulde. Brugere, der håndterer eskaleringer, ved ofte, hvorfor botten fejlede. Et enkelt tagsystem i dit ticketsystem, såsom “forkert svar”, “manglende svar” eller “forældet politik”, kan omsætte denne erfaring til et struktureret vedligeholdelsessignal.
Eksplicitte “det ved jeg ikke”-logs er en guldgrube. Hver gang chatbotten eskalerer, fordi den ikke fandt relevant indhold, skal forespørgslen logges. Sortér efter antal hver uge. De øverste forespørgsler på listen er dine højest prioriterede skriveopgaver.
Periodiske brugerundersøgelser af KB-kvaliteten (sendt til kunder, der har interageret med chatbotten inden for de seneste 30 dage) afdækker systemiske problemer, som individuelle samtalevurderinger ikke fanger. Begræns undersøgelsen til to eller tre spørgsmål, og knyt svarene til samtale-id’er, så du kan spore feedbacken til specifikke artikler.
Feedbacksløjfen lukkes, når en markeret forespørgsel bliver til en KB-artikel, artiklen gennemgår godkendelsesworkflowet, og chatbotens svar på forespørgslen forbedres. At følge denne cyklustid (fra markering til løsning) er en af de mest nyttige driftsmålinger, som en vidensansvarlig kan eje.
Hvad supportteams faktisk lærer ved at køre dette i produktion
Playbooken ovenfor er korrekt i teorien. Her er, hvad der går galt i praksis, og hvordan du løser det hurtigt.
Start småt, og bevis værdien, før du skalerer. Indeksering af alle tilgængelige dokumenter på én gang kan skabe en overfyldt KB og gøre det svært at etablere et nyttigt kvalitetsbaseline. Vælg 20 til 30 spørgsmålskategorier med høj volumen, skriv rene artikler til dem, og kør chatbotten inden for dette begrænsede område. Udvid, når tests viser, at svarene er nøjagtige og nyttige.
Håndtér tidsbegrænset indhold eksplicit. Kampagner, sæsonbestemte politikker og tidsbegrænsede tilbud bliver let forældede. Opret et separat metadatatag til tidsbegrænset indhold, og angiv en obligatorisk dato for udløbsgennemgang, når indholdet skrives.
Log og følg ukendte svar regelmæssigt. Hyppig gennemgang af “det ved jeg ikke”-loggen hjælper teams med at opdage gentagne mangler, før de hober sig op. Brug forespørgslers antal og kundepåvirkning til at prioritere rettelser.
Professionelt tip: Løste tickets er nyttigt kildemateriale til autoritative svar, fordi de viser, hvordan teamet håndterede virkelige spørgsmål. Deskhero bruger med jævne mellemrum løste tickets som kildemateriale til FAQ-forslag. En bruger kan gennemgå, redigere, godkende eller afvise hvert forslag, før godkendt indhold bliver tilgængeligt for chatbotten.
Hurtige løsninger til teams, der lige er begyndt:
- Fastlæg en navngivningskonvention for artikler fra dag ét (Produktområde: Emne: Målgruppe). Det er besværligt efterfølgende at omdøbe 200 artikler.
- Opret en metadataskabelon med obligatoriske felter, og indsæt den i alle nye artikler, før du skriver.
- Opbyg en testsuite med 20 til 30 virkelige forespørgsler fra de første samtalelogfiler, og kør den før hver produktionsudrulning.
Deskhero gør vedligeholdelsesplaybooken operationel fra dag ét
At køre denne playbook på tværs af adskilte værktøjer kan skabe ekstra koordineringsarbejde. Deskhero samler workflowet til gennemgang af offentlige FAQ’er, FAQ-forslag og kundesamtaler i den samme helpdesk.
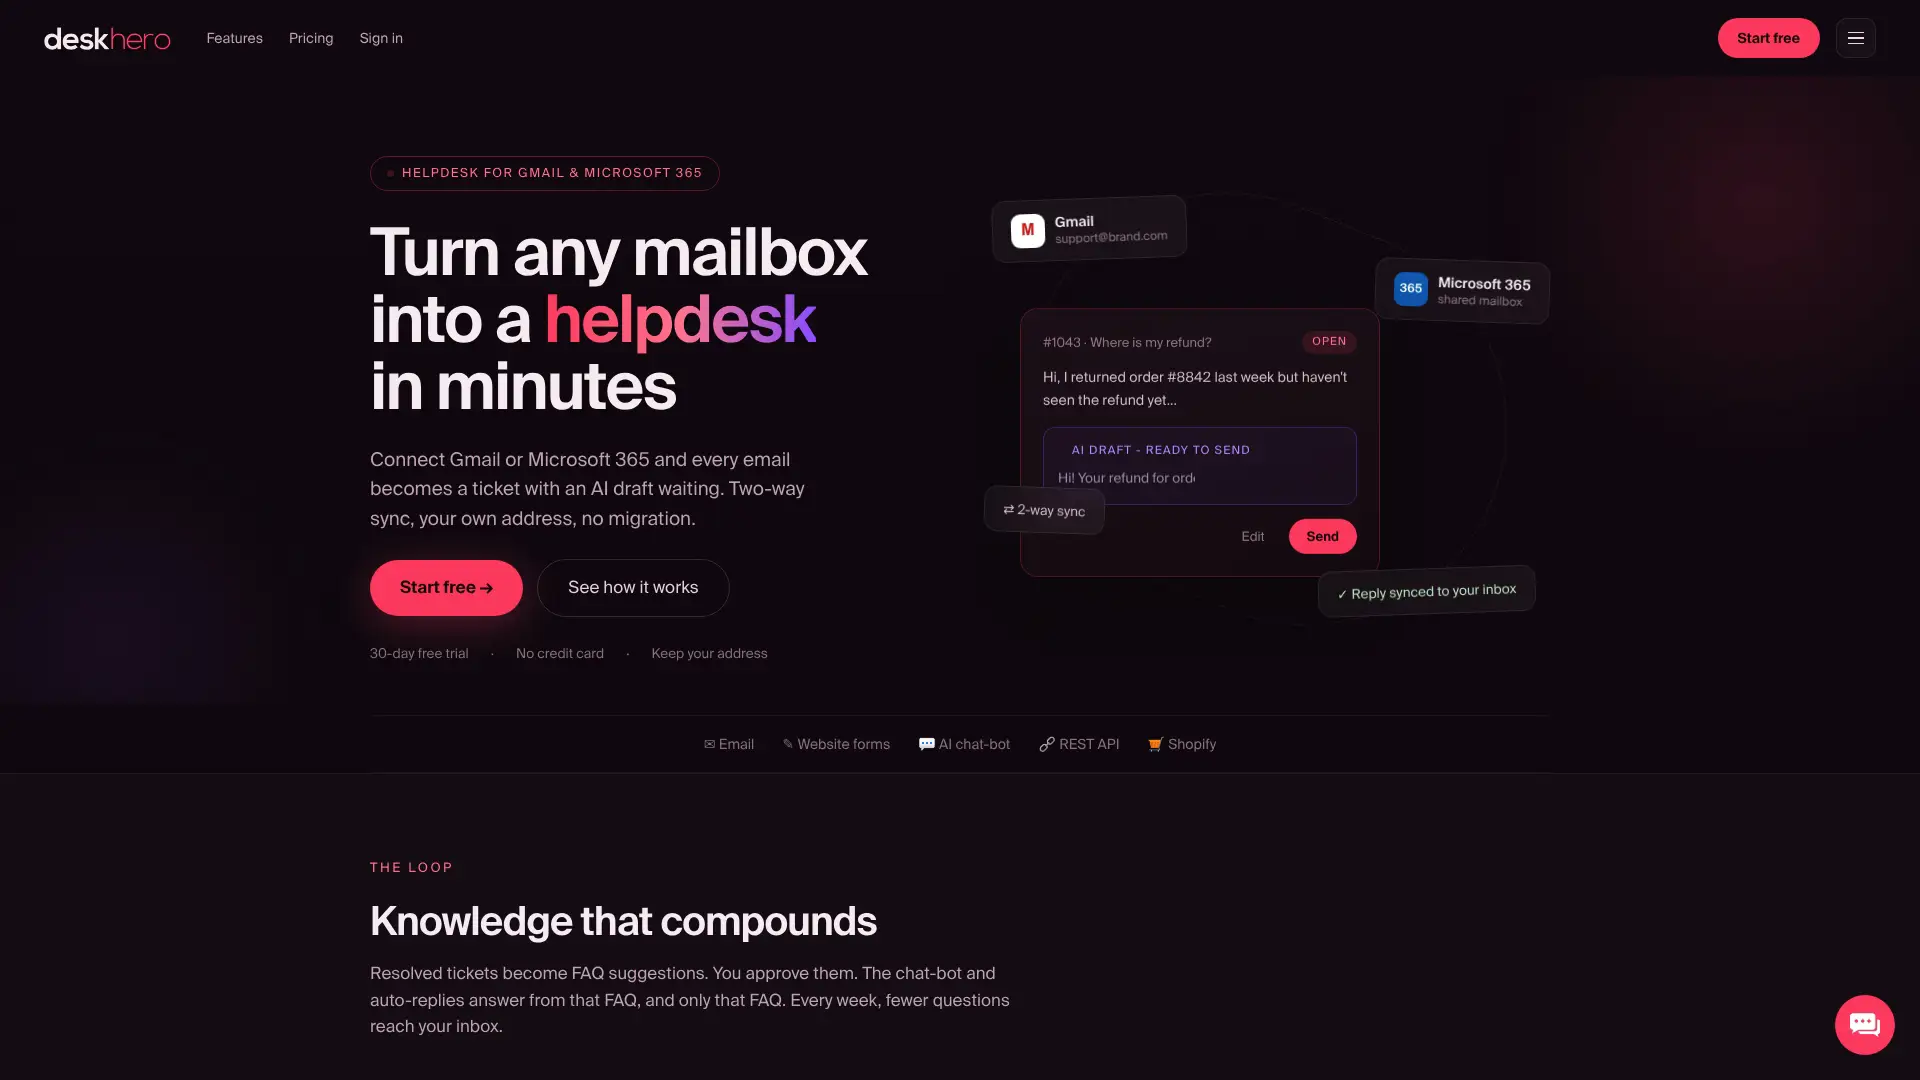
Chatbotten svarer kun ud fra godkendt offentligt FAQ-indhold, mens AI-svarforslag til brugere kan trække på bredere viden fra arbejdsområdet. FAQ-forslag fra løste tickets og scannede websider reducerer arbejdet med at skrive fra bunden, men kræver stadig menneskelig gennemgang. Integration af postkasser i begge retninger holder tickets og svar forbundet med teamets eksisterende adresse.
For teams, der ønsker dette workflow uden at samle en brugerdefineret hentningsstack, kombinerer Deskhero den fælles indbakke, offentlige FAQ’er, chatbot og menneskelige overdragelser. Start en gratis prøveperiode på 30 dage hos Deskhero, uden krav om kreditkort.
Kilder
Brug disse som implementeringsreferencer, når du træffer tekniske valg om strategi for opdeling, træningstilgang, governancepolitik og målingsopsætning.
Ofte stillede spørgsmål
Hvad er en vidensbase til en chatbot?
En chatbot-vidensbase er et kurateret sæt kildedokumenter, der er opdelt i passager, omdannet til vektorembeddings og gemt i en vektordatabase, så en retriever kan hente det mest relevante indhold på forespørgselstidspunktet og forankre chatbotens svar i dit faktiske indhold.
Hvordan vedligeholder man en chatbot over tid?
Gennemfør en gentagelig cyklus: Gennemgå samtalelogfiler for at finde mangler, opdatér eller skriv autoritative artikler, opdel og lav embeddings i et stagingmiljø, validér mod et testsæt med 20 til 30 forespørgsler, indhent godkenderens accept, publicér i produktion, og overvåg svarenes kvalitet og overdragelser for forringelser.
Hvad bør man aldrig fortælle en chatbot?
Undgå at indtaste følsomme personoplysninger (personnumre, adgangskoder og finansielle kontooplysninger) i nogen chatbotgrænseflade, da input kan blive logget eller brugt i modeltræning afhængigt af platformens politik for datahåndtering. Når du skriver indhold til en intern KB, må du aldrig hardcode aktuelle data (priser, lagerbeholdning), som en ingest-pipeline kan hente direkte fra system of record.
Hvad koster det at vedligeholde en chatbot?
De primære omkostninger er tid til gennemgang, beregning til hentning og embeddings, når disse komponenter administreres direkte, samt eventuelle abonnementer på helpdesk- eller vidensplatforme. Estimér dem ud fra indholdsmængde, forespørgselsvolumen, opdateringshyppighed og den nødvendige mængde menneskelig gennemgang.