Slik vedlikeholder du chatbotens kunnskap: En praktisk veiledning
Vedlikehold chatbotens kunnskap som en tilbakevendende, rollebasert prosess: revider → oppdater → valider → publiser → avvikle. Denne femtrinnssyklusen, gjennomført med en forutsigbar frekvens og tydelig eierskap ved hvert kontrollpunkt, er det som skiller en chatbot som opparbeider seg kundenes tillit, fra en som stille bryter den ned.
Her er den korte sjekklisten teamet ditt trenger før alt annet:
- Kildehygiene: Fjern utdaterte, dupliserte eller motstridende dokumenter før de når indeksen.
- Oppdeling og indeksering: Start med deler på 500 til 1 000 tegn, og juster deretter størrelsen basert på tester av informasjonsinnhentingen.
- Justering av informasjonsinnhenteren: Test og juster likhetstersklene kvartalsvis, slik at presisjonen holder seg høy etter hvert som kunnskapsbasen vokser.
- Godkjenningsflyt: Alle nye eller redigerte artikler må godkjennes før de gjøres tilgjengelige i chatboten.
- Overvåkingsmålinger: Følg regelmessig med på svarkvalitet, ubesvarte spørsmål og overføringer til mennesker.
- Tilbakerulling og versjonering: Oppretthold en endringslogg, slik at alle dårlige oppdateringer kan reverseres i løpet av minutter.
Hvem eier hva: Innholdseiere skriver og oppdaterer artikler. En kunnskapsansvarlig håndhever standarder og gjennomfører revisjoner. En teknisk eier håndterer oppdeling, embedding-er og innstillinger for informasjonsinnhenting når teamet administrerer disse komponentene. En fagfelle gjennomfører testsett før hver publisering. Samsvarsspesialister gjennomgår innhold som omhandler regulerte temaer.
Viktigste punkter
Vedlikehold av chatbotkunnskap krever en repeterbar syklus fra revisjon til avvikling, tydelig eierskap og regelmessig overvåking for å oppdage mangler før kundene gjør det.
| Punkt | Detaljer |
|---|---|
| Bruk syklusen fra revisjon til avvikling | Gjennomfør revisjon → oppdater → valider → publiser → avvikle ukentlig, månedlig eller kvartalsvis for å hindre at kunnskapsbasen gradvis blir utdatert. |
| Test størrelsen på delene | Start med informasjonsinnhentingsdeler på 500 til 1 000 tegn, og juster basert på testresultatene. |
| Følg med på nyttige kvalitetssignaler | Overvåk svarnøyaktighet, ubesvarte spørsmål, overføringer og bekreftede feilaktige svar, og definer deretter terskler som passer tjenesten din. |
| Utnevn en kunnskapsansvarlig | Gi én person tydelig ansvar for redaksjonskalenderen, gjennomgangskøen og vedlikeholdsfrekvensen. |
| Deskhero håndhever svar basert på godkjent kunnskap | Deskhero-chatboten svarer bare fra godkjent offentlig FAQ-innhold og foreslår FAQ-kandidater fra løste saker og skannede nettsider. |
Innholdsfortegnelse
- Hva er en kunnskapsbase for chatboter, og hvordan brukes den til å generere svar?
- Hvorfor kontinuerlig vedlikehold er viktig for chatbotens nøyaktighet
- Trinnvis operativ veiledning for vedlikehold av chatbotkunnskap
- Standarder, maler og styring som holder svarene pålitelige
- Hva du bør måle, og hvordan du skal reagere på signalene
- Verktøymønstre og integrasjonssjekkliste
- Slik samsvarer Deskhero med denne vedlikeholdsveiledningen
- Vedlikeholdsfrekvens, bemanning og kostnadshensyn
- Slik validerer du nye kunnskapskilder før integrering
- Slik bruker du tilbakemeldinger fra brukere til å forbedre chatbotkunnskapen
- Hva supportteam faktisk lærer av å kjøre dette i produksjon
- Deskhero gjør vedlikeholdsveiledningen operativ fra dag én
- Kilder
- Vanlige spørsmål
Hva er en kunnskapsbase for chatboter, og hvordan brukes den til å generere svar?
En kunnskapsbase for chatboter (KB) er ikke bare en mappe med hjelpeartikler. Den er en kuratert prosesslinje: Kildedokumenter går gjennom et trinn for oppdeling, hver del konverteres til en numerisk vektor (en embedding), disse vektorene lagres i en vektordatabase, og en informasjonsinnhenter henter de mest relevante delene når et spørsmål stilles. Språkmodellen setter deretter sammen et svar fra de innhentede delene, forankret i det faktiske innholdet ditt i stedet for modellens grunnleggende treningsdata.
Mange AI-kunnskapschatboter bruker en informasjonsinnhentingsprosess med deler, embedding-er, en vektordatabase, en informasjonsinnhenter og en språkmodell. Systemer som beholder kildehenvisninger, gjør det enklere å undersøke et svar og spore det tilbake til materialet som ble brukt.
Kjernekomponentene i en godt utviklet KB-prosesslinje:
- Kildedokumenter: KB-artikler, løste saker, PDF-er, nettsider og retningslinjedokumenter.
- Metadata: Tagger for tema, produktområde, målgruppe, dato for siste oppdatering og forfatter.
- Embedding-er: Kompakte vektorrepresentasjoner av hver del, generert av en embedding-modell.
- Vektordatabase: Lagrer og indekserer embedding-er for rask semantisk søking (Pinecone, Weaviate, pgvector og lignende verktøy).
- Informasjonsinnhenter: Forespør vektordatabasen og returnerer de N mest relevante delene.
- LLM pluss systeminstruksjoner: Setter sammen de innhentede delene til et svar i naturlig språk, begrenset av instruksjonene dine.
- Siteringslag: Legger kildehenvisninger ved hvert svar, slik at brukere og kunder kan kontrollere dem.
Profftips: Hold hver artikkel fokusert på ett tydelig tema. Del opp dokumenter som besvarer flere urelaterte spørsmål. Størrelsen på delene er også viktig: start med 500 til 1 000 tegn og juster basert på testresultatene. Deler som er for små, kan miste kontekst, mens deler som er for store, kan skjule den relevante setningen.
Hvorfor kontinuerlig vedlikehold er viktig for chatbotens nøyaktighet
En chatbot som trenes én gang og deretter overlates til seg selv, blir gradvis dårligere. Produkter endres, retningslinjer oppdateres, priser justeres, og KB-en blir i stillhet hengende etter. Chatboten fortsetter å svare basert på utdaterte data, og kundene legger merke til det før teamet ditt gjør det.
Ved å holde KB-en oppdatert kan du forbedre svarkvaliteten og hjelpe flere kunder med å løse rutinespørsmål uten overføring til en medarbeider. En konsekvent tone og godkjent formulering kan også redusere unødvendige feil. Nye brukere får et tydeligere referansepunkt når KB-en behandles som den autoritative kilden. Resultatene avhenger fortsatt av innholdskvalitet, distribusjonsomfang og hvordan chatboten er konfigurert.
Risikoene ved å forsømme vedlikeholdet er like tydelige:
- Utdaterte svar: En chatbot som viser til et utgått produkt eller en gammel returpolicy, skader troverdigheten umiddelbart.
- Motstridende innhold: To artikler som gir ulike svar på samme spørsmål, forvirrer informasjonsinnhenteren og fører til inkonsekvente svar.
- Risiko for hallusinering: Når informasjonsinnhenteren ikke finner noe relevant, finner et dårlig konfigurert system på et svar. En godt vedlikeholdt KB reduserer dette gapet.
- Samsvarsrisiko: I regulerte bransjer kan et utdatert svar om retningslinjer føre til alvorlige problemer med gjennomgang og samsvar.
- Svekket tillit: Kunder som får feil svar to ganger, gir sjelden boten en tredje sjanse.
Trinnvis operativ veiledning for vedlikehold av chatbotkunnskap
Dette er en repeterbar arbeidsflyt som teamet ditt kan tilpasse til en intern standardprosedyre. Sett en praktisk frekvens for gjennomgang av logger, innholdsoppdateringer og tester av informasjonsinnhentingen, og juster den deretter etter hvor ofte produktene og retningslinjene dine endres.
-
Planlegg revisjonen. Hent samtalelogger fra den foregående perioden. Marker forespørsler med lave konfidensskårer, eskaleringer og tilbakefall av typen «Jeg vet ikke». Dette er manglene du bør prioritere høyest.
-
Identifiser manglende og utdatert innhold. Kryssreferer de markerte forespørslene mot eksisterende KB-artikler. Merk artikler som viser til foreldede funksjoner, gamle priser eller utløpte kampanjer, for umiddelbar oppdatering eller avvikling.
-
Skriv eller oppdater autoritative svar. Skriv én artikkel per tema. Bruk språk rettet mot kunder, ikke intern sjargong. Obligatoriske felt er: tematikktittel, omfang (hvilket produkt/hvilken plan den gjelder), tiltenkt målgruppe, forfatter, dato for siste oppdatering og godkjenningsstatus.
-
Del opp og lag embedding-er. Begynn med å dele oppdaterte artikler i deler på 500 til 1 000 tegn. Legg til metadatatagger (tema, produkt, språk og målgruppe). Kjør delene gjennom embedding-modellen og last dem inn i vektordatabasen i et testmiljø, ikke i produksjon.
-
Gjennomfør valideringstester i trinn. Bruk et testsett med 20 til 30 reelle forespørsler hentet fra loggene. Kontroller at hver forespørsel henter riktig del, og at det genererte svaret samsvarer med det autoritative svaret. Sett en terskel for godkjent nøyaktighet i informasjonsinnhentingen før innholdet flyttes til produksjon.
-
Publiser i produksjon med et godkjenningspunkt. En utpekt godkjenner (kunnskapsansvarlig eller teamleder) gjennomgår testresultatene og godkjenner dem. Loggfør publiseringshendelsen med tidsstempel, forfatter og versjonsnummer.
-
Overvåk etter publisering. Følg nøye med på svarkvalitet og overføringer etter alle større oppdateringer. Hvis en måling faller eller gjennomganger avdekker feilaktige svar, ruller du endringen tilbake ved hjelp av versjonshistorikken.
-
Avvikle utdatert innhold. Arkiver i stedet for å slette, slik at versjonshistorikken beholdes. Oppdater alle artikler som viste til det avviklede innholdet.
Profftips: Når plattformen støtter det, bør du kreve kildehenvisninger for faktabaserte svar. Kombiner dette med en uttrykkelig instruksjon om tilbakefall: Hvis informasjonsinnhentingen ikke returnerer tilstrekkelig relevant innhold, skal chatboten si at den ikke kan svare og tilby overføring til en medarbeider i stedet for å gjette.
Profftips: Kvalitet slår kvantitet i alle trinn. Fem til ti velskrevne og fokuserte dokumenter gir en mer kapabel assistent enn femti løst strukturerte dokumenter. Fjern innhold konsekvent før du indekserer.
Standarder, maler og styring som holder svarene pålitelige
God styring er ikke byråkrati for byråkratiets skyld. En menneskesentrert tilnærming til AI starter med behovene og velferden til menneskene som berøres av systemet. For en chatbot som møter kunder, gjør dokumenterte godkjenninger, versjonshistorikk og endringsnotater gjennomgang og ansvarliggjøring praktisk mulig.
Redaksjonelle standarder alle artikler må oppfylle
- Én tematikk, ett svar. Ingen artikkel skal dekke mer enn ett avgrenset spørsmål.
- Kundevennlig språk. Skriv slik en kunde ville spurt, ikke slik en ingeniør ville dokumentert.
- Obligatoriske felt: Tematikktittel, omfang, målgruppe, forfatter, dato for siste oppdatering, godkjenningsstatus, versjonsnummer og en kort endringsmerknad.
- Ingen dupliserte data. Hvis en inntaksprosess allerede henter oppdaterte priser fra systemet som er autoritativ kilde, skal du ikke skrive prisen inn i en KB-artikkel. Den vil bli utdatert.
- Proaktiv gjennomgang av logger. Gå gjennom samtalelogger etter en fast frekvens for å finne mangler før kundene rapporterer dem.
Styringsroller
- Innholdseier: Fagekspert som skriver og oppdaterer artikler innenfor sitt område.
- Kunnskapsansvarlig: Håndhever standarder, gjennomfører revisjoner, administrerer artikkelens livssyklus og eier redaksjonskalenderen.
- Godkjenner: Teamleder eller leder som godkjenner innholdet før en artikkel publiseres.
- ML-eier: Håndterer parametere for oppdeling, oppdateringer av embedding-modellen, konfigurasjon av informasjonsinnhentingen og vedlikehold av testsett.
- Samsvarsgjennomgår: Påkrevd godkjenning for artikler som berører regulerte temaer (priser, juridiske vilkår og personvern).
Tillitssignaler du bør innføre nå
- Revisjonslogger som registrerer alle opprettelser, redigeringer, godkjenninger og avviklinger med tidsstempel og bruker-ID.
- Versjonshistorikk med visning av forskjeller, slik at alle endringer kan gjennomgås.
- Endringslogger knyttet til hver artikkel, som viser hva som ble endret og hvorfor.
- Godkjenningsstempler som vises i KB-administrasjonen, slik at teamet kan se hva som er og ikke er godkjent for bruk i chatboten.
- Kildehenvisninger som vises i hvert chatbot-svar.
Hva du bør måle, og hvordan du skal reagere på signalene
Det er gjennom overvåking at vedlikeholdsbeslutninger tas. Uten målinger gjetter du hvilke artikler som bør oppdateres. Med målinger har du en prioritert arbeidskø hver uke.
Viktige målinger å følge med på:
- Svarkvalitet/nøyaktighet: Andelen chatbot-svar som samsvarer med det autoritative svaret i et utvalgt testsett.
- Forankringsgrad: Andelen svar som viser til en bestemt kilde. Et fall her signaliserer at informasjonsinnhentingen har endret seg, eller at innhold mangler.
- Avledningsgrad: Andelen samtaler som løses uten involvering fra en bruker. Økende eskaleringer kan ofte spores tilbake til et bestemt hull i KB-en.
- Eskaleringsgrad: Det motsatte av avledningsgrad; følg med på den per temakategori for å finne ut hvilke innholdsområder som trenger oppmerksomhet.
- Tid til oppdatering: Hvor lang tid det tar fra en mangel identifiseres, til en verifisert løsning publiseres.
- CSAT for boten: Kundetilfredshetsscore spesifikt for samtaler håndtert av chatboten.
- Hallusineringshendelser: Antallet bekreftede tilfeller der boten ga et faktuelt feilaktig svar som ikke var forankret i noen kilde.
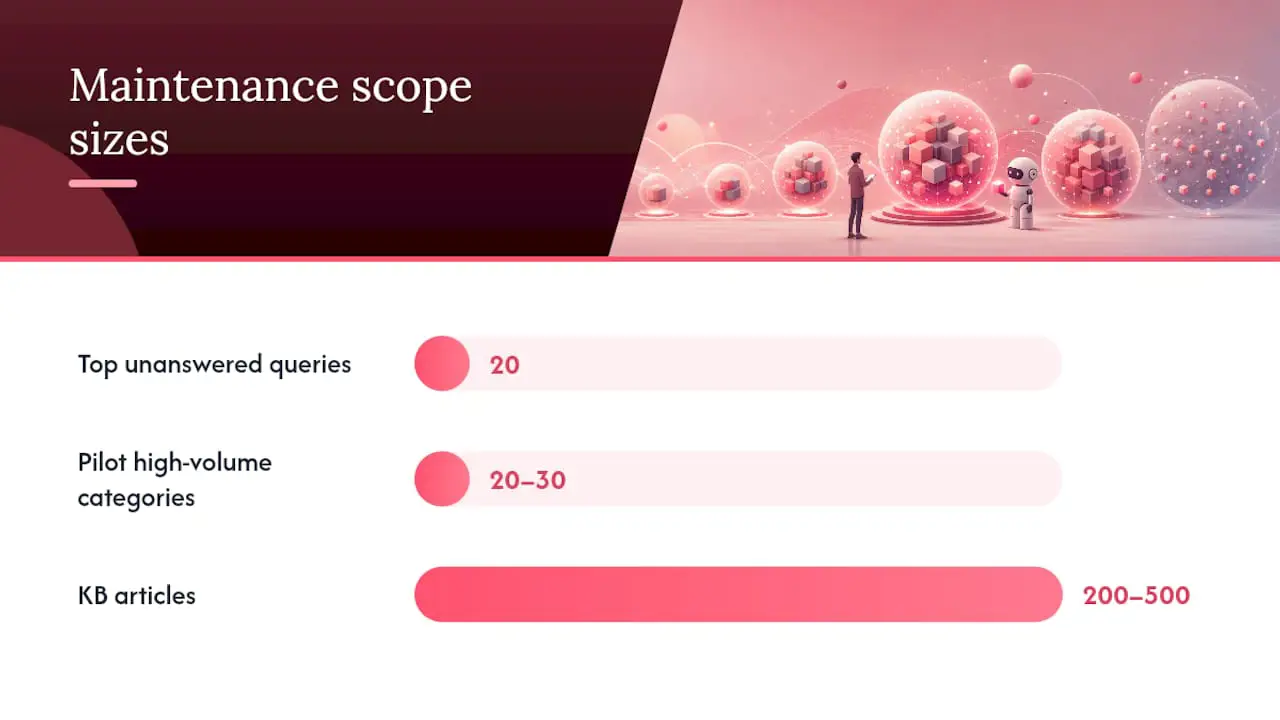
Den mest praktiske bruken av logger er å lage en liste over de 20 viktigste ubesvarte forespørslene hver uke. Sorter etter volum, tildel hver forespørsel til en innholdseier, og følg med på tiden til lukking. Denne listen blir vedlikeholdsetterslepet ditt.
Verktøymønstre og integrasjonssjekkliste
De riktige verktøyene gjør veiledningen ovenfor repeterbar uten heroisk manuelt arbeid. Når du vurderer plattformer og integrasjonsmønstre, bør du prioritere disse funksjonene:
- Trinnvis indeksering: Systemet kan oppdatere enkeltstående deler uten å indeksere hele KB-en på nytt. Dette er avgjørende for store KB-er, der full ny indeksering er langsom og kostbar.
- Oppdatering av embedding-er: Mulighet til å generere embedding-er på nytt for oppdaterte artikler uten å påvirke uendret innhold.
- Sporbarhet og støtte for kildehenvisninger: Hver innhentede del har en kildehenvisning som vises i svaret.
- Rollebasert tilgangskontroll: Innholdseiere, godkjennere og ML-ingeniører har ulike tillatelser. Plattformen må håndheve dette.
- Revisjonslogger: Alle indekseringshendelser, innholdsendringer og godkjenninger logges med tidsstempel og bruker.
- Nettkroker for saksbehandling: Når en sak løses, kan en nett-krok utløse en KB-gjennomgang eller automatisk utarbeide et artikkelforslag. Dette lukker kretsløpet mellom supportdrift og kunnskapsvedlikehold.
- SSO: Google- og Microsoft-SSO reduserer friksjonen for team som allerede bruker disse økosystemene.
Integrasjonsmønstre som fungerer i produksjon
Direkte KB-synkronisering: KB-plattformen sender oppdaterte artikler til vektordatabasen etter en tidsplan eller ved publisering. Det er enkelt, pålitelig og et godt startpunkt for de fleste team.
Trinnvis indeksering i sandkasse: Nytt eller oppdatert innhold indekseres først i et testmiljø. Testpakken kjøres mot testmiljøet før en endring når produksjon. Dette tilsvarer en CI-prosess for kunnskapsinnhold.
CI-lignende valideringsprosesser: Behandle KB-endringer som kodeendringer. En innholdsoppdatering utløser en automatisert testkjøring mot testsettet med 20 til 30 forespørsler. Feil blokkerer publiseringen. Godkjente resultater sendes til godkjenneren for endelig godkjenning.
Viktige avveininger du bør forstå
RAG er riktig arkitektur for de fleste supportteam med kunnskap som endres ofte. Du oppdaterer dokumenter, ikke modellvekter, noe som holder kostnadene håndterbare og oppdateringssyklusene korte. Finjustering gir mening for statiske, svært spesialiserte områder der vokabularet og resonneringsmønstrene er stabile. Forskjellen i driftskostnad er betydelig: En RAG-oppdatering er en dokumentredigering og ny indeksering, mens en finjusteringssyklus krever merkede data, beregningstid og en full modelevaluering før utrulling.
Når det gjelder avveiningen mellom forsinkelse og aktualitet, holder hyppigere oppdateringer av embedding-er svarene oppdaterte, men øker beregningskostnaden. Velg en oppdateringsplan basert på hvor ofte kildematerialet endres, og gjennomfør validering etter viktige oppdateringer.
Slik samsvarer Deskhero med denne vedlikeholdsveiledningen
Deskhero er bygget rundt prinsippet om at en chatbot bare skal svare fra kunnskap du uttrykkelig har godkjent, noe som samsvarer direkte med styrings- og valideringstrinnene i denne veiledningen.
Slik knyttes konkrete trinn i veiledningen til funksjoner i Deskhero:
- Svar utelukkende basert på godkjent kunnskap: Deskhero AI-chatbot svarer fra godkjent offentlig FAQ-innhold. Annen kunnskap i arbeidsområdet brukes ikke i kundevendte chatbot-svar. For å aktivere chatboten kreves minst 100 godkjente offentlige FAQ-elementer.
- FAQ-forslag fra løste saker: Løste saker og skannede nettsider kan omarbeides til mulige FAQ-oppføringer. En bruker gjennomgår og godkjenner en oppføring før den kan gjøres tilgjengelig for chatboten.
- Separate kunnskapsområder: Den interne kunnskapsbasen kan brukes til å informere AI-forslag til svar for brukere. Kundevendte chatbot-svar bruker bare den godkjente offentlige FAQ-en.
- Synkronisering av e-post i begge retninger: Kundespørsmål kommer inn via e-post, skjema eller chatbot og blir til saker i en felles innboks. Svar kan sendes fra selskapets tilkoblede adresse.
- Merkede automatiske handlinger: Automatiske handlinger merkes og logges, og fullstendig automatisk utsending er valgfritt.
- REST API: Deskhero tilbyr et REST API for saks- og arbeidsområdeoperasjoner. Det tilbyr ikke utgående nettkroker.
- Flerspråklig grensesnitt: Deskhero-grensesnittet er tilgjengelig på 14 støttede språk, og chatbotens informasjonsinnhenting kan finne samsvarende offentlig FAQ-innhold på tvers av språk.
Deskhero kobler Gmail-, Google Workspace- eller Microsoft 365-postbokser til en felles helpdesk, samtidig som teamet kan beholde de eksisterende e-postadressene sine. Den kundevendte AI-en svarer fra godkjent offentlig FAQ-innhold og overfører ubesvarte spørsmål til en medarbeider. FAQ-forslag kan utarbeides fra løste saker og skannede nettsider, men en bruker må gjennomgå dem før de godkjennes. Automatiske handlinger merkes og logges. Plattformen inkluderer også en intern kunnskapsbase, innsikt i saker, 14 grensesnittspråk, Shopify-integrasjon, Google- og Microsoft-SSO og et REST API. Den starter med en gratis prøveperiode på 30 dager, uten krav om kredittkort.
Fordi Deskhero-chatboten er begrenset til den godkjente offentlige FAQ-en, er vedlikeholdsoppgaven konkret: Gå gjennom ubesvarte spørsmål, forbedre eller legg til FAQ-oppføringer, godkjenn dem, og kontroller om den oppdaterte kunnskapen besvarer de tiltenkte spørsmålene.
Hvis du vil se nærmere på hvordan AI-chatboter håndterer eskalering og overføring til mennesker i denne typen arbeidsflyt, beskriver veiledningen om overføring fra chatbot til menneske de operative mønstrene i detalj.
Vedlikeholdsfrekvens, bemanning og kostnadshensyn
Det er når man planlegger menneskene og tiden bak kunnskapsforvaltningen for chatboten, at de fleste team undervurderer arbeidsmengden. Den gode nyheten er at et lite team med en tydelig frekvens kan vedlikeholde en KB i produksjon uten egne heltidsstillinger.
Anbefalte frekvenser:
- Ukentlig: Gå gjennom samtalelogger, hent listen over de 20 viktigste ubesvarte forespørslene, marker presserende innholdsmangler og send høyt prioriterte rettelser gjennom godkjenningspunktet.
- Månedlig: Gjennomfør en full innholdsoppdateringssyklus. Skriv nye artikler, oppdater endrede retningslinjer eller produkter, avvikle utdatert innhold og kjør hele testpakken.
- Kvartalsvis: Gjennomgå endringer i retningslinjer og produkter, juster informasjonsinnhentingen, evaluer embedding-modellen og gjennomfør en styringsrevisjon (er alle artiklene riktig godkjent og versjonert?).
Minimal bemanningsmodell for små team:
- Kunnskapsansvarlig: Eier redaksjonskalenderen, gjennomfører revisjoner, håndhever standarder og administrerer godkjenningskøen. Tidsbehovet avhenger av innholdsvolumet og hvor ofte innholdet endres.
- Teknisk støtte: Håndterer parametere for oppdeling, oppdateringer av embedding-er, konfigurasjon av informasjonsinnhenting og vedlikehold av testpakken når teamet administrerer sin egen informasjonsinnhentingsstakk.
- Roterende fageksperter: Hvert produkt- eller retningslinjeområde har en utpekt innholdseier som gjennomgår og godkjenner artikler innenfor sitt område. Dette er vanligvis et deltidsansvar som legges til en eksisterende rolle.
Kostnadsdrivere du bør beregne:
- Lagrings- og spørringskostnader for vektordatabasen øker i takt med KB-størrelsen og spørringsvolumet.
- Hvor ofte embedding-er oppdateres, påvirker beregningskostnaden. Oppdater derfor endret innhold når plattformen støtter trinnvise oppdateringer.
- Tid brukt på menneskelig gjennomgang kan utgjøre en betydelig kostnad, særlig når produkter eller retningslinjer endres ofte.
- Kostnadene for verktøyabonnement varierer mellom plattformer. Plattformer som samler KB-administrasjon, saksbehandling og chatbot i ett abonnement (i stedet for å kreve separate verktøy for vektordatabase, LLM-API og helpdesk), reduserer både kostnader og integrasjonskompleksitet.
Forskning på generativ AI i kundestøtte har avdekket produktivitetsgevinster i en reell supportsituasjon. Se på disse funnene som kontekst, ikke som en bemanningsformel, fordi kostnadene og fordelene ved kunnskapsvedlikehold avhenger av teamet, innholdet og verktøyene.
Start med et kostnadseffektivt område: Begynn med 20 til 30 kategorier med spørsmål som stilles ofte. Bygg og vedlikehold disse artiklene først. Bekreft at svarkvaliteten blir bedre før du utvider KB-en. Dette holder den innledende vedlikeholdsbyrden liten og bygger intern tillit til prosessen.
Slik validerer du nye kunnskapskilder før integrering
Ikke alle dokumenter som ser nyttige ut, hører hjemme i chatbotens indeks. Integrering av en kilde med lav kvalitet eller feilaktig innhold svekker hele KB-en, fordi informasjonsinnhenteren ikke kan skille en godt dokumentert artikkel fra en dårlig skrevet artikkel.
Kjør alle aktuelle kilder gjennom disse kontrollene før indeksering:
Nøyaktighetskontroll: Gjenspeiler innholdet gjeldende produktfunksjonalitet, retningslinjer eller priser? Kryssreferer mot systemet som er autoritativ kilde (CRM-systemet, produktdokumentasjonen eller juridisk avdelings godkjente retningslinjedokumenter). Hvis du ikke kan bekrefte en påstand mot en primærkilde, skal du ikke indeksere den.
Omfangskontroll: Er innholdet relevant for spørsmålene chatboten forventes å besvare? En bred bransjerapport kan inneholde korrekt informasjon, men samtidig skape støy ved informasjonsinnhenting. Avgrens dokumentene nøye til bruksområdet ditt.
Duplikatkontroll: Overlapper dette innholdet betydelig med en eksisterende KB-artikkel? Duplisert innhold skaper tvetydighet i informasjonsinnhentingen. Slå sammen eller konsolider innholdet før indeksering.
Kontroll av format og struktur: Er dokumentet strukturert slik at oppdelingen vil produsere sammenhengende, selvstendige avsnitt? Et dokument med mange kryssreferanser («se del 4.2 for detaljer») deles dårlig opp, fordi de enkelte delene mister kontekst. Skriv om eller omstrukturer dokumentet før indeksering.
Kontroll av opphav: Kan du spore innholdet til en autoritativ intern eller ekstern kilde? For regulerte temaer bør du dokumentere kilden uttrykkelig i artikkelens metadata.
Test i testmiljø: Indekser den nye kilden i et testmiljø og kjør standardtestsettet ditt med 20 til 30 forespørsler. Kontroller om det nye innholdet forbedrer, svekker eller ikke påvirker nøyaktigheten i informasjonsinnhentingen. Flytt bare kilder videre som forbedrer eller opprettholder nøyaktigheten.
Slik bruker du tilbakemeldinger fra brukere til å forbedre chatbotkunnskapen
Tilbakemeldinger fra brukere er det mest direkte signalet du har på hvor KB-en svikter. Utfordringen er å samle dem inn systematisk i stedet for å reagere på de høyeste klagene.
Tommel opp/ned på chatbot-svar er den enkleste tilbakemeldingsmekanismen. Alle chatbot-svar bør ha et alternativ for binær vurdering. Samle disse ukentlig. Et svar med mange tommel ned er et direkte signal om at KB-en bør gjennomgås, uansett om svaret så riktig ut for teamet som skrev det.
CSAT-undersøkelser etter samtalen gir et bredere signal. Lave skårer for samtaler håndtert av boten, filtrert etter temakategori, forteller deg hvilke innholdsområder som trenger mest oppmerksomhet. Koble CSAT-data med eskaleringslogger for å bekrefte om problemet er et hull i KB-en eller et konfigurasjonsproblem i informasjonsinnhentingen.
Tilbakemeldingssløyfer fra supportteamet er verdifulle. Brukere som håndterer eskaleringer, vet ofte hvorfor boten mislyktes. Et enkelt system med tagger i saksbehandlingsverktøyet, for eksempel «feil svar», «manglende svar» eller «utdatert retningslinje», kan gjøre denne erfaringen om til et strukturert vedlikeholdssignal.
Eksplisitte logger over «Jeg vet ikke» er en gullgruve. Hver gang chatboten eskalerer fordi den ikke fant relevant innhold, bør du logge forespørselen. Sorter etter volum hver uke. De øverste forespørslene på denne listen er skriveoppgavene du bør prioritere høyest.
Periodiske brukerundersøkelser om KB-kvalitet (sendt til kunder som har samhandlet med chatboten de siste 30 dagene) avdekker systemiske problemer som individuelle samtalevurderinger ikke fanger opp. Begrens undersøkelsen til to eller tre spørsmål, og knytt svarene til samtale-ID-er slik at du kan spore tilbakemeldingen til bestemte artikler.
Tilbakemeldingssløyfen lukkes når en markert forespørsel blir til en KB-artikkel, artikkelen går gjennom godkjenningsflyten, og chatbotens svar på forespørselen blir bedre. Å følge med på syklustiden (fra markering til løsning) er en av de mest nyttige driftsmålingene en kunnskapsansvarlig kan eie.
Hva supportteam faktisk lærer av å kjøre dette i produksjon
Veiledningen ovenfor er korrekt i teorien. Her er det som bryter sammen i praksis, og hvordan du raskt kan løse det.
Start i det små og dokumenter verdien før du skalerer. Hvis du indekserer alle tilgjengelige dokumenter samtidig, kan du ende opp med en oppblåst KB og få problemer med å etablere et nyttig kvalitetsgrunnlag. Velg 20 til 30 kategorier med spørsmål som stilles ofte, skriv gode og ryddige artikler for disse, og kjør chatboten innenfor dette avgrensede området. Utvid etter at testene viser at svarene er nøyaktige og nyttige.
Håndter tidsbegrenset innhold uttrykkelig. Kampanjer, sesongbaserte retningslinjer og tidsbegrensede tilbud kan raskt bli utdaterte. Opprett en egen metadatatagg for tidsbegrenset innhold, og angi en obligatorisk dato for utløpsgjennomgang når innholdet skrives.
Loggfør og følg regelmessig med på ukjente svar. Hyppig gjennomgang av «Jeg vet ikke»-loggen hjelper team med å oppdage gjentatte mangler før de hoper seg opp. Bruk forespørselsvolum og kundevirkning til å prioritere rettelser.
Profftips: Løste saker er nyttig kildemateriale for autoritative svar fordi de viser hvordan teamet håndterte reelle spørsmål. Deskhero bruker med jevne mellomrom løste saker som kildemateriale for FAQ-forslag. En bruker kan gjennomgå, redigere, godkjenne eller avslå hvert forslag før godkjent innhold blir tilgjengelig for chatboten.
Raske løsninger for team som nettopp har startet:
- Etabler en navnekonvensjon for artikler fra dag én (produktområde: tema: målgruppe). Det er smertefullt å gi 200 artikler nye navn i ettertid.
- Opprett en metadatamal med obligatoriske felt, og lim den inn i hver nye artikkel før du begynner å skrive.
- Bygg et testsett med 20 til 30 reelle forespørsler fra de første samtaleloggingene, og kjør det før hver publisering til produksjon.
Deskhero gjør vedlikeholdsveiledningen operativ fra dag én
Å kjøre denne veiledningen på tvers av frakoblede verktøy kan skape ekstra koordineringsarbeid. Deskhero samler arbeidsflyten for gjennomgang av offentlig FAQ, FAQ-forslag og kundesamtaler i den samme helpdesken.
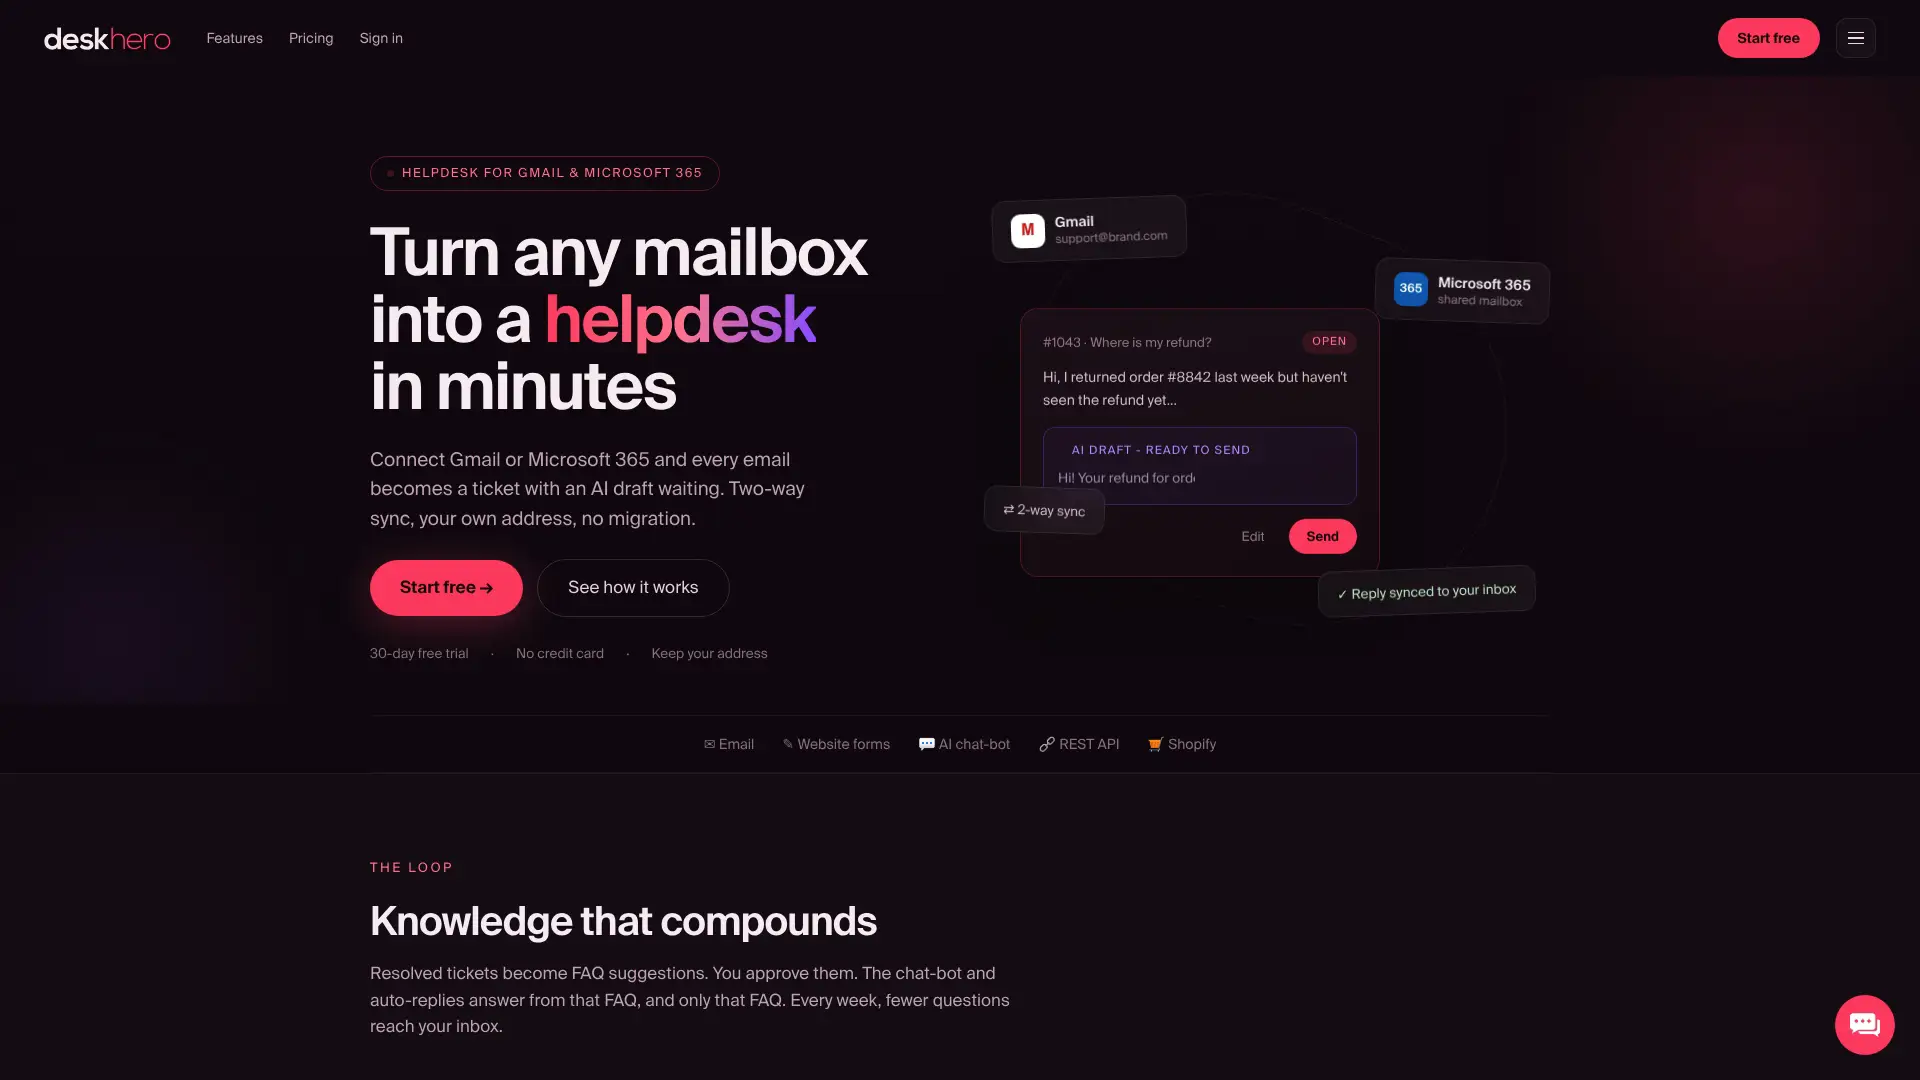
Chatboten svarer bare fra godkjent offentlig FAQ-innhold, mens AI-forslag til svar for brukere kan hente informasjon fra en bredere kunnskapsbase i arbeidsområdet. FAQ-forslag fra løste saker og skannede nettsider reduserer arbeidet med å skrive fra bunnen av, men de krever fortsatt menneskelig gjennomgang. Integrasjon med postbokser i begge retninger holder saker og svar koblet til teamets eksisterende adresse.
For team som ønsker denne arbeidsflyten uten å sette sammen en egen stakk for informasjonsinnhenting, kombinerer Deskhero den felles innboksen, den offentlige FAQ-en, chatboten og overføring til mennesker. Start en gratis prøveperiode på 30 dager hos Deskhero, uten krav om kredittkort.
Kilder
Bruk disse som implementeringsreferanser når du tar tekniske valg om oppdelingsstrategi, treningsmetode, styringspolicy og oppsett av målinger.
Vanlige spørsmål
Hva er en kunnskapsbase for chatboter?
En kunnskapsbase for chatboter er et kuratert sett med kildedokumenter som er delt opp i avsnitt, konvertert til vektorembedding-er og lagret i en vektordatabase, slik at en informasjonsinnhenter kan hente det mest relevante innholdet når et spørsmål stilles, og forankre chatbotens svar i det faktiske innholdet ditt.
Hvordan vedlikeholder man en chatbot over tid?
Følg en repeterbar syklus: Gå gjennom samtalelogger for å finne mangler, oppdater eller skriv autoritative artikler, del opp og lag embedding-er i et testmiljø, valider mot et testsett med 20 til 30 forespørsler, innhent godkjenning fra godkjenneren, publiser i produksjon, og overvåk svarkvalitet og overføringer for å oppdage tilbakegang.
Hva bør du aldri fortelle en chatbot?
Unngå å skrive inn sensitive personopplysninger (personnummer, passord og opplysninger om finansielle kontoer) i et hvilket som helst chatbot-grensesnitt, ettersom inndata kan bli logget eller brukt i modelltrening, avhengig av plattformens policy for datahåndtering. Når du skriver innhold til en intern KB, må du aldri hardkode oppdaterte data (priser, lagerbeholdning) som en inntaksprosess kan hente direkte fra systemet som er autoritativ kilde.
Hvor mye koster det å vedlikeholde en chatbot?
De viktigste kostnadene er tid til gjennomgang, beregning for informasjonsinnhenting og embedding-er når disse komponentene administreres direkte, samt eventuelle abonnementer på helpdesk- eller kunnskapsplattformer. Beregn dem ut fra innholdsvolum, spørringsvolum, oppdateringsfrekvens og mengden menneskelig gjennomgang som kreves.