Como manter o conhecimento do chatbot: um guia prático
Mantenha o conhecimento do chatbot como um processo recorrente e baseado em funções: auditar → atualizar → validar → publicar → aposentar. Esse ciclo de cinco etapas, executado em uma cadência previsível e com responsabilidades claras em cada ponto de controle, é o que diferencia um chatbot que conquista a confiança dos clientes de um que a desgasta silenciosamente.
Aqui está a breve lista de verificação de que sua equipe precisa antes de qualquer outra coisa:
- Higiene das fontes: Remova documentos desatualizados, duplicados ou contraditórios antes que cheguem ao índice.
- Fragmentação e indexação: Comece com fragmentos de 500 a 1.000 caracteres e ajuste o tamanho com base nos testes de recuperação.
- Ajuste do recuperador: Teste e ajuste trimestralmente os limites de similaridade para manter a precisão alta à medida que a base de conhecimento cresce.
- Fluxo de aprovação: Todo artigo novo ou editado precisa de aprovação antes de entrar em produção no chatbot.
- Métricas de monitoramento: Acompanhe regularmente a qualidade das respostas, as perguntas não resolvidas e os encaminhamentos.
- Rollback e versionamento: Mantenha um registro de alterações para que qualquer atualização problemática possa ser revertida em minutos.
Quem é responsável pelo quê: Os responsáveis pelo conteúdo criam e atualizam os artigos. Um responsável pela base de conhecimento aplica os padrões e realiza auditorias. Um responsável técnico cuida da fragmentação, dos embeddings e das configurações de recuperação quando a equipe gerencia esses componentes. Um revisor executa conjuntos de testes antes de cada publicação. Especialistas em conformidade revisam conteúdos que abrangem temas regulamentados.
Principais conclusões
Manter o conhecimento do chatbot exige um ciclo repetível de auditoria a aposentadoria, responsabilidades claras e monitoramento regular para identificar lacunas antes que os clientes o façam.
| Ponto | Detalhes |
|---|---|
| Use o ciclo de auditoria a aposentadoria | Execute auditoria → atualização → validação → publicação → aposentadoria em uma cadência semanal/mensal/trimestral para evitar a deterioração da base de conhecimento. |
| Teste o tamanho dos fragmentos | Comece com fragmentos de recuperação de 500 a 1.000 caracteres e ajuste com base nos resultados dos testes. |
| Acompanhe sinais úteis de qualidade | Monitore a precisão das respostas, as perguntas não resolvidas, os encaminhamentos e as respostas incorretas confirmadas; depois, defina limites adequados ao seu serviço. |
| Designe um responsável pela base de conhecimento | Dê a uma pessoa a responsabilidade clara pelo calendário editorial, pela fila de revisão e pela cadência de manutenção. |
| Deskhero aplica respostas baseadas em conhecimento aprovado | O chatbot do Deskhero responde somente com base no conteúdo público aprovado das FAQs e sugere candidatos a FAQ a partir de tickets resolvidos e páginas do site coletadas automaticamente. |
Índice
- O que é uma base de conhecimento de chatbot e como ela possibilita respostas?
- Por que a manutenção contínua é importante para a precisão do chatbot?
- Manual operacional passo a passo para manter o conhecimento do chatbot
- Padrões, modelos e governança que mantêm as respostas confiáveis
- O que medir e como agir com base nos sinais
- Padrões de ferramentas e lista de verificação de integração
- Como Deskhero se encaixa neste manual de manutenção
- Cadência de manutenção, equipe e considerações de custo
- Como validar novas fontes de conhecimento antes da integração
- Como usar o feedback dos usuários para aprimorar o conhecimento do chatbot
- O que as equipes de suporte realmente aprendem ao executar isso em produção
- Deskhero torna o manual de manutenção operacional desde o primeiro dia
- Fontes
- Perguntas frequentes
O que é uma base de conhecimento de chatbot e como ela possibilita respostas?
Uma base de conhecimento (KB) de chatbot não é apenas uma pasta de artigos de ajuda. Ela é um pipeline organizado: os documentos de origem passam por uma etapa de fragmentação, cada fragmento é convertido em um vetor numérico (um embedding), esses vetores são armazenados em um banco de dados vetorial e um recuperador seleciona os fragmentos mais relevantes no momento da consulta. O modelo de linguagem então sintetiza uma resposta a partir desses fragmentos recuperados, fundamentada no seu conteúdo real, e não nos dados de treinamento básicos do modelo.
Muitos chatbots de conhecimento com IA usam um pipeline de recuperação com fragmentos, embeddings, um banco de dados vetorial, um recuperador e um modelo de linguagem. Sistemas que mantêm referências às fontes facilitam a inspeção de uma resposta e o rastreamento até o material utilizado.
Os principais componentes de um pipeline de KB bem desenvolvido:
- Documentos de origem: Artigos da KB, tickets resolvidos, PDFs, páginas de sites e documentos de políticas.
- Metadados: Tags para tema, área do produto, público, data da última atualização e autor.
- Embeddings: Representações vetoriais densas de cada fragmento, geradas por um modelo de embedding.
- Banco de dados vetorial: Armazena e indexa embeddings para pesquisa semântica rápida (Pinecone, Weaviate, pgvector e ferramentas semelhantes).
- Recuperador: Consulta o banco de dados vetorial e retorna os N principais fragmentos mais relevantes.
- LLM e prompts do sistema: Sintetiza os fragmentos recuperados em uma resposta em linguagem natural, limitada pelas suas instruções.
- Camada de citações: Anexa referências às fontes em cada resposta para que Users e clientes possam verificar.
Dica profissional: Mantenha cada artigo focado em um único tema claro. Divida documentos que respondem a várias perguntas não relacionadas. O tamanho dos fragmentos também importa: comece com 500 a 1.000 caracteres e ajuste com base nos resultados dos testes. Fragmentos pequenos demais podem perder contexto, enquanto fragmentos grandes demais podem ocultar a frase relevante.
Por que a manutenção contínua é importante para a precisão do chatbot?
Um chatbot treinado uma vez e deixado de lado se degrada. Os produtos mudam, as políticas são atualizadas, os preços são alterados e a KB fica silenciosamente para trás. O chatbot continua respondendo com base em dados desatualizados, e os clientes percebem isso antes da sua equipe.
Manter a KB atualizada pode melhorar a qualidade das respostas e ajudar mais clientes a resolver perguntas rotineiras sem encaminhamento. Um tom consistente e uma linguagem aprovada também podem reduzir erros evitáveis. Novos Users têm uma referência mais clara quando a KB é tratada como a fonte oficial. Os resultados ainda dependem da qualidade do conteúdo, do escopo da implantação e da configuração do chatbot.
Os riscos da negligência são igualmente claros:
- Respostas desatualizadas: Um chatbot que cita um produto descontinuado ou uma política antiga de devolução prejudica imediatamente a credibilidade.
- Conteúdo contraditório: Dois artigos que dão respostas diferentes à mesma pergunta confundem o recuperador e produzem respostas inconsistentes.
- Risco de alucinação: Quando o recuperador não encontra nada relevante, um sistema mal configurado inventa uma resposta. Uma KB bem mantida reduz essa lacuna.
- Exposição a riscos de conformidade: Em setores regulamentados, uma resposta desatualizada sobre políticas pode gerar sérias preocupações de revisão e conformidade.
- Confiança desgastada: Clientes que recebem uma resposta errada duas vezes raramente dão ao bot uma terceira chance.
Manual operacional passo a passo para manter o conhecimento do chatbot
Este é um fluxo de trabalho repetível que sua equipe pode adaptar a um procedimento operacional padrão interno. Defina uma cadência prática para a revisão dos registros, as atualizações de conteúdo e os testes de recuperação; depois, ajuste-a de acordo com a frequência com que seus produtos e políticas mudam.
-
Agende a auditoria. Reúna os registros de conversas do período anterior. Sinalize consultas com pontuações de baixa confiança, escalonamentos e respostas alternativas do tipo “não sei”. Essas são as lacunas de maior prioridade.
-
Identifique conteúdo ausente e desatualizado. Compare as consultas sinalizadas com os artigos existentes da KB. Marque para atualização ou aposentadoria imediata os artigos que mencionam recursos obsoletos, preços antigos ou promoções expiradas.
-
Crie ou atualize respostas oficiais. Escreva um artigo por tema. Use uma linguagem voltada para o cliente, não jargão interno. Campos obrigatórios: título do tema, escopo (a qual produto/plano se aplica), público-alvo, autor, data da última atualização e status de aprovação.
-
Fragmente e gere embeddings. Comece dividindo os artigos atualizados em fragmentos de 500 a 1.000 caracteres. Adicione tags de metadados (tema, produto, idioma, público). Passe os fragmentos pelo seu modelo de embedding e carregue-os no banco de dados vetorial em um ambiente de preparação, não em produção.
-
Execute testes de validação em etapas. Use um conjunto de testes com 20 a 30 consultas reais extraídas dos registros. Verifique se cada consulta recupera o fragmento correto e se a resposta gerada corresponde à resposta oficial. Defina um limite de aprovação para a precisão da recuperação antes de promover o conteúdo para produção.
-
Envie para produção com um ponto de aprovação. Um aprovador designado (responsável pela base de conhecimento ou líder da equipe) revisa os resultados dos testes e aprova a publicação. Registre o evento de publicação com data e hora, autor e número da versão.
-
Monitore após a publicação. Observe atentamente a qualidade das respostas e os encaminhamentos após qualquer atualização significativa. Se uma métrica cair ou as revisões encontrarem respostas incorretas, reverta a alteração usando o histórico de versões.
-
Recolha conteúdo obsoleto. Arquive-o em vez de excluí-lo, para que o histórico de versões permaneça intacto. Atualize todos os artigos que faziam referência ao conteúdo recolhido.
Dica profissional: Quando a plataforma oferecer suporte, exija referências às fontes para respostas factuais. Combine isso com uma instrução de fallback explícita: se a recuperação não retornar conteúdo suficientemente relevante, o chatbot deve dizer que não pode responder e oferecer encaminhamento para uma pessoa, em vez de tentar adivinhar.
Dica profissional: Qualidade supera quantidade em todas as etapas. De cinco a dez documentos bem escritos e focados produzem um assistente mais capaz do que cinquenta documentos estruturados de forma vaga. Faça uma limpeza rigorosa antes de indexar.
Padrões, modelos e governança que mantêm as respostas confiáveis
Uma boa governança não é burocracia por si só. Uma abordagem de IA centrada nas pessoas começa pelas necessidades e pelo bem-estar das pessoas afetadas pelo sistema. Para um chatbot voltado ao cliente, aprovações documentadas, histórico de versões e notas de alteração tornam a revisão e a responsabilização práticas.
Padrões editoriais que todos os artigos devem cumprir
- Um tema, uma resposta. Nenhum artigo deve abordar mais de uma pergunta distinta.
- Linguagem amigável para o cliente. Escreva como um cliente perguntaria, não como um engenheiro documentaria.
- Campos obrigatórios: Título do tema, escopo, público, autor, data da última atualização, status de aprovação, número da versão e uma breve nota de alteração.
- Nenhum dado duplicado. Se um pipeline de ingestão já extrai preços atualizados do seu sistema oficial, não codifique esse preço em um artigo da KB. Ele ficará desatualizado.
- Revisão proativa dos registros. Revise os registros de conversas em uma cadência definida para encontrar lacunas antes que os clientes as relatem.
Funções de governança
- Responsável pelo conteúdo: Especialista no assunto que cria e atualiza artigos em seu domínio.
- Responsável pela base de conhecimento: Aplica padrões, realiza auditorias, gerencia o ciclo de vida dos artigos e é responsável pelo calendário editorial.
- Aprovador: Líder ou gerente da equipe que aprova a publicação de qualquer artigo.
- Responsável por ML: Cuida dos parâmetros de fragmentação, das atualizações do modelo de embedding, da configuração do recuperador e da manutenção do conjunto de testes.
- Revisor de conformidade: Aprovação obrigatória para artigos que abordam temas regulamentados (preços, termos legais, privacidade de dados).
Sinais de confiança para implementar agora
- Registros de auditoria que documentam cada ação de criação, edição, aprovação e aposentadoria, com data e hora e ID do usuário.
- Histórico de versões com visualizações de diferenças para que qualquer alteração possa ser revisada.
- Registros de alterações anexados a cada artigo, mostrando o que mudou e por quê.
- Selos de aprovação visíveis no painel administrativo da KB, para que a equipe veja o que está e o que não está liberado para uso pelo chatbot.
- Citações das fontes exibidas em todas as respostas do chatbot.
O que medir e como agir com base nos sinais
É no monitoramento que as decisões de manutenção são tomadas. Sem métricas, você tenta adivinhar quais artigos atualizar. Com elas, você tem uma fila de trabalho priorizada todas as semanas.
Principais métricas a acompanhar:
- Precisão / correção das respostas: Percentual de respostas do chatbot que correspondem à resposta oficial em um conjunto de testes amostrado.
- Taxa de fundamentação: Percentual de respostas que citam um fragmento específico da fonte. Uma queda nesse indicador sinaliza desvio do recuperador ou conteúdo ausente.
- Taxa de deflexão: Percentual de conversas resolvidas sem envolvimento de um User. O aumento dos escalonamentos geralmente remete a uma lacuna específica da KB.
- Taxa de escalonamento: Inverso da deflexão; acompanhe por categoria de tema para identificar quais áreas de conteúdo precisam de atenção.
- Tempo até a atualização: Quanto tempo leva para passar da identificação de uma lacuna à publicação de uma correção verificada.
- CSAT do bot: Índice de satisfação do cliente especificamente para conversas conduzidas pelo chatbot.
- Incidentes de alucinação: Número de casos confirmados em que o bot produziu uma resposta factualmente incorreta e não fundamentada em nenhuma fonte.
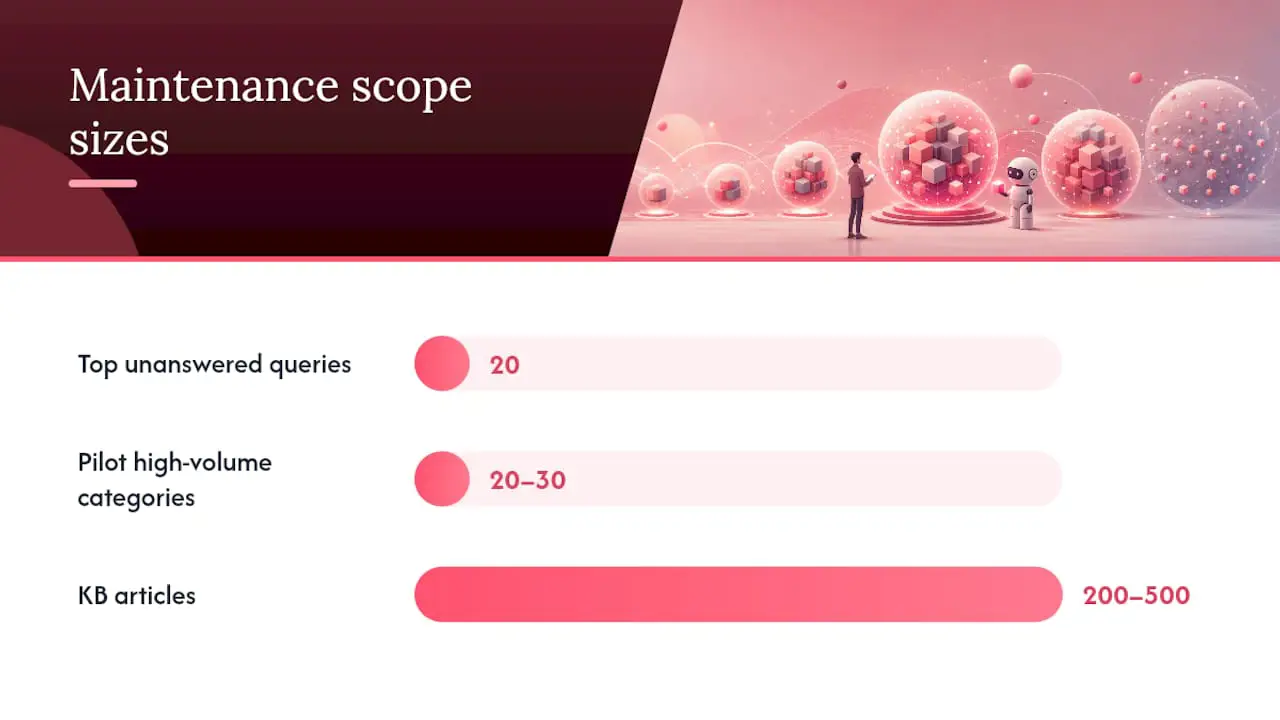
O uso mais prático dos registros é gerar semanalmente uma lista das 20 principais consultas sem resposta. Ordene-a por volume, atribua cada item a um responsável pelo conteúdo e acompanhe o tempo até o encerramento. Essa lista se torna o backlog de manutenção.
Padrões de ferramentas e lista de verificação de integração
As ferramentas certas tornam o manual acima repetível sem exigir um esforço manual heroico. Ao avaliar plataformas e padrões de integração, priorize estes recursos:
- Indexação incremental: O sistema consegue atualizar fragmentos individuais sem reindexar toda a KB. Isso é fundamental para KBs grandes, nas quais a reindexação completa é lenta e cara.
- Atualização de embeddings: Capacidade de regenerar embeddings para artigos atualizados sem tocar no conteúdo inalterado.
- Suporte a proveniência e citações: Todo fragmento recuperado traz uma referência à fonte, exibida na resposta.
- Controle de acesso baseado em funções: Responsáveis pelo conteúdo, aprovadores e engenheiros de ML têm permissões diferentes. A plataforma deve aplicar essa separação.
- Registros de auditoria: Cada evento de indexação, alteração de conteúdo e aprovação é registrado com data e hora e usuário.
- Webhooks para tickets: Quando um ticket é resolvido, um webhook pode acionar uma revisão da KB ou criar automaticamente um rascunho de artigo candidato. Isso fecha o ciclo entre as operações de suporte e a manutenção do conhecimento.
- SSO: O SSO do Google e da Microsoft reduz o atrito para equipes que já usam esses ecossistemas.
Padrões de integração que funcionam em produção
Sincronização direta com a KB: A plataforma da KB envia artigos atualizados ao banco de dados vetorial em uma programação definida ou no momento da publicação. É simples, confiável e o ponto de partida adequado para a maioria das equipes.
Indexação em sandbox de preparação: O conteúdo novo ou atualizado é indexado primeiro em um ambiente de preparação. O conjunto de testes é executado nesse ambiente antes que qualquer alteração chegue à produção. Isso equivale a um pipeline de CI para conteúdo de conhecimento.
Pipelines de validação semelhantes a CI: Trate as alterações da KB como alterações de código. Uma atualização de conteúdo aciona uma execução automatizada de testes com seu conjunto de 20 a 30 consultas. As falhas bloqueiam a publicação. As aprovações encaminham o conteúdo ao aprovador para a aprovação final.
Principais compromissos a entender
RAG é a arquitetura adequada para a maioria das equipes de suporte com conhecimento que muda frequentemente. Você atualiza documentos, não os pesos do modelo, o que mantém os custos controláveis e os ciclos de atualização curtos. O ajuste fino faz sentido para domínios estáticos e altamente especializados, nos quais o vocabulário e os padrões de raciocínio são estáveis. A diferença no custo operacional é significativa: uma atualização de RAG é uma edição de documento e uma reindexação; um ciclo de ajuste fino exige dados rotulados, tempo de computação e uma avaliação completa do modelo antes da implantação.
Quanto ao equilíbrio entre latência e atualização, atualizações mais frequentes dos embeddings mantêm as respostas atuais, mas acrescentam custo computacional. Escolha uma programação de atualização com base na frequência de alteração do material de origem e execute a validação após atualizações importantes.
Como Deskhero se encaixa neste manual de manutenção
Deskhero foi desenvolvido com base no princípio de que um chatbot deve responder somente a partir de conhecimento explicitamente aprovado por você, o que se relaciona diretamente às etapas de governança e validação deste manual.
Veja como etapas específicas do manual se conectam aos recursos do Deskhero:
- Respostas somente com conhecimento aprovado: O chatbot de IA do Deskhero responde com base no conteúdo público aprovado das FAQs. Outros conhecimentos do workspace não são usados nas respostas do chatbot voltadas aos clientes. Para ativar o chatbot, são necessários pelo menos 100 itens públicos de FAQ aprovados.
- Sugestões de FAQ a partir de tickets resolvidos: Tickets resolvidos e páginas do site coletadas automaticamente podem ser transformados em possíveis entradas de FAQ. Um User revisa e aprova uma entrada antes que ela possa ficar disponível para o chatbot.
- Escopos de conhecimento separados: A base de conhecimento interna pode orientar sugestões de respostas de IA para Users. As respostas do chatbot voltadas aos clientes usam somente a FAQ pública aprovada.
- Sincronização de e-mail em duas vias: As perguntas dos clientes chegam por e-mail, formulário ou chatbot e se tornam tickets em uma caixa de entrada compartilhada. As respostas podem ser enviadas pelo endereço conectado da empresa.
- Ações automáticas identificadas: As ações automáticas são identificadas e registradas, e o envio totalmente automático é opcional.
- API REST: Deskhero oferece uma API REST para operações de tickets e workspaces. Não oferece webhooks de saída.
- Interface multilíngue: A interface do Deskhero está disponível em 14 idiomas compatíveis, e a recuperação do chatbot pode encontrar conteúdo público de FAQ em diferentes idiomas.
Deskhero conecta caixas de e-mail do Gmail, Google Workspace ou Microsoft 365 a um helpdesk compartilhado, permitindo que a equipe mantenha seus endereços de e-mail existentes. A IA voltada aos clientes responde com base no conteúdo público aprovado das FAQs e encaminha perguntas não resolvidas para uma pessoa. Sugestões de FAQ podem ser criadas a partir de tickets resolvidos e páginas do site coletadas automaticamente, mas um User precisa revisá-las antes da aprovação. As ações automáticas são identificadas e registradas. A plataforma também inclui uma base de conhecimento interna, insights de tickets, 14 idiomas de interface, integração com Shopify, SSO do Google e da Microsoft e uma API REST. Ela começa com um teste gratuito de 30 dias, sem necessidade de cartão de crédito.
Como o chatbot do Deskhero é limitado à FAQ pública aprovada, a tarefa de manutenção é concreta: revisar perguntas não resolvidas, melhorar ou adicionar entradas de FAQ, aprová-las e verificar se o conhecimento atualizado responde às perguntas pretendidas.
Para uma análise mais aprofundada de como os chatbots de IA lidam com escalonamento e encaminhamento para pessoas nesse tipo de fluxo, o guia de encaminhamento do chatbot para uma pessoa aborda detalhadamente os padrões operacionais.
Cadência de manutenção, equipe e considerações de custo
Planejar as pessoas e o tempo envolvidos no gerenciamento do conhecimento do chatbot é onde a maioria das equipes subestima o trabalho. A boa notícia: uma equipe pequena, com uma cadência clara, consegue manter uma KB em produção sem contratar profissionais exclusivamente para isso.
Cadências recomendadas:
- Semanalmente: Revise os registros de conversas, gere a lista das 20 principais consultas sem resposta, sinalize lacunas urgentes de conteúdo e encaminhe as correções prioritárias pelo ponto de aprovação.
- Mensalmente: Execute um ciclo completo de atualização de conteúdo. Crie novos artigos, atualize políticas ou produtos alterados, recolha conteúdo obsoleto e execute o conjunto completo de testes.
- Trimestralmente: Faça uma revisão de alterações de políticas e produtos, ajuste o recuperador, avalie o modelo de embedding e realize uma auditoria de governança (todos os artigos estão devidamente aprovados e versionados?).
Modelo mínimo de equipe para equipes pequenas:
- Responsável pela base de conhecimento: Cuida do calendário editorial, realiza auditorias, aplica padrões e gerencia a fila de aprovação. O tempo necessário depende do volume de conteúdo e da frequência das alterações.
- Suporte técnico: Cuida dos parâmetros de fragmentação, das atualizações de embeddings, da configuração de recuperação e da manutenção do conjunto de testes quando a equipe gerencia sua própria estrutura de recuperação.
- Especialistas no assunto em rodízio: Cada domínio de produto ou política tem um responsável pelo conteúdo designado, que revisa e aprova os artigos de sua área. Normalmente, essa é uma responsabilidade parcial adicionada a uma função existente.
Fatores de custo a estimar:
- Os custos de armazenamento e consulta do banco de dados vetorial aumentam de acordo com o tamanho da KB e o volume de consultas.
- A frequência de atualização dos embeddings afeta o custo computacional; portanto, atualize o conteúdo alterado quando a plataforma oferecer suporte a atualizações incrementais.
- O tempo de revisão humana pode representar um custo substancial, especialmente quando produtos ou políticas mudam com frequência.
- Os custos de assinatura das ferramentas variam conforme a plataforma. Plataformas que reúnem gerenciamento da KB, tickets e chatbot em uma única assinatura (em vez de exigir banco de dados vetorial, API de LLM e ferramentas de helpdesk separados) reduzem tanto o custo quanto a complexidade de integração.
Pesquisas sobre IA generativa no suporte ao cliente encontraram ganhos de produtividade em um ambiente real de suporte. Considere essas descobertas como contexto, e não como uma fórmula de dimensionamento da equipe, pois o custo e o benefício da manutenção do conhecimento dependem da equipe, do conteúdo e das ferramentas.
Faça um piloto com um escopo de baixo custo: Comece com 20 a 30 categorias de perguntas de alto volume. Crie e mantenha esses artigos primeiro. Verifique se a qualidade das respostas melhora antes de expandir a KB. Isso mantém pequena a carga inicial de manutenção e aumenta a confiança interna no processo.
Como validar novas fontes de conhecimento antes da integração
Nem todo documento que parece útil pertence ao índice do chatbot. Integrar uma fonte de baixa qualidade ou imprecisa degrada toda a KB, pois o recuperador não tem como distinguir um artigo bem fundamentado de um artigo mal escrito.
Submeta todas as fontes candidatas às verificações abaixo antes de indexá-las:
Verificação de precisão: O conteúdo reflete o comportamento, a política ou os preços atuais do produto? Faça uma comparação com o sistema oficial (seu CRM, a documentação do produto ou os documentos de políticas aprovados pela equipe jurídica). Se não conseguir verificar uma afirmação em uma fonte primária, não a indexe.
Verificação de escopo: O conteúdo é relevante para as perguntas que o chatbot deve responder? Um whitepaper amplo do setor pode conter informações precisas, mas introduzir ruído de recuperação fora do tema. Limite rigorosamente o escopo dos documentos ao seu caso de uso.
Verificação de duplicação: Esse conteúdo se sobrepõe significativamente a um artigo existente da KB? Conteúdo duplicado cria ambiguidade na recuperação. Mescle ou consolide o material antes de indexá-lo.
Verificação de formato e estrutura: O documento está estruturado de modo que a fragmentação produza trechos coerentes e autossuficientes? Um documento com muitas referências cruzadas (“consulte a seção 4.2 para obter detalhes”) é fragmentado de forma inadequada, pois os fragmentos individuais perdem contexto. Reescreva ou reestruture o documento antes de indexá-lo.
Verificação de proveniência: É possível rastrear o conteúdo até uma fonte interna ou externa confiável? Para temas regulamentados, documente explicitamente a fonte nos metadados do artigo.
Teste em ambiente de preparação: Indexe a nova fonte em um ambiente de preparação e execute seu conjunto padrão de testes com 20 a 30 consultas. Verifique se o novo conteúdo melhora, piora ou não afeta a precisão da recuperação. Promova somente fontes que melhorem ou mantenham a precisão.
Como usar o feedback dos usuários para aprimorar o conhecimento do chatbot
O feedback dos usuários é o sinal mais direto que você tem sobre onde a KB está falhando. O desafio é capturá-lo sistematicamente, em vez de reagir às reclamações mais ruidosas.
Avaliações positivas/negativas nas respostas do chatbot são o mecanismo de feedback mais simples. Toda resposta do chatbot deve oferecer uma opção de avaliação binária. Agregue essas avaliações semanalmente. Uma resposta com alta taxa de avaliações negativas é um sinal direto para revisar a KB, independentemente de a resposta parecer correta para a equipe que criou o conteúdo.
Pesquisas de CSAT após a conversa fornecem um sinal mais amplo. Pontuações baixas em conversas conduzidas pelo bot, filtradas por categoria de tema, mostram quais áreas de conteúdo precisam de mais atenção. Combine os dados de CSAT com os registros de escalonamento para confirmar se o problema é uma lacuna da KB ou uma questão de configuração do recuperador.
Ciclos de feedback da equipe de suporte são valiosos. Users que lidam com escalonamentos geralmente sabem por que o bot falhou. Um sistema simples de tags na sua ferramenta de tickets, como “resposta errada”, “resposta ausente” ou “política desatualizada”, pode transformar essa experiência em um sinal estruturado de manutenção.
Registros explícitos de “não sei” são uma mina de ouro. Sempre que o chatbot fizer um escalonamento por não encontrar conteúdo relevante, registre a consulta. Ordene-a por volume semanalmente. As principais consultas dessa lista são suas tarefas de criação de conteúdo mais prioritárias.
Pesquisas periódicas com usuários sobre a qualidade da KB (enviadas a clientes que interagiram com o chatbot nos últimos 30 dias) revelam problemas sistêmicos que as avaliações de conversas individuais não identificam. Limite a pesquisa a duas ou três perguntas e associe as respostas aos IDs das conversas para que seja possível rastrear o feedback até artigos específicos.
O ciclo de feedback se fecha quando uma consulta sinalizada se torna um artigo da KB, o artigo passa pelo fluxo de aprovação e a resposta do chatbot a essa consulta melhora. Acompanhar esse tempo de ciclo (do sinal à correção) é uma das métricas operacionais mais úteis que um responsável pela base de conhecimento pode gerenciar.
O que as equipes de suporte realmente aprendem ao executar isso em produção
O manual acima está correto em teoria. Veja o que dá errado na prática e como corrigir rapidamente.
Comece pequeno e comprove o valor antes de escalar. Indexar todos os documentos disponíveis de uma só vez pode criar uma KB inchada e dificultar o estabelecimento de uma linha de base de qualidade útil. Escolha de 20 a 30 categorias de perguntas de alto volume, crie artigos bem estruturados para elas e execute o chatbot nesse escopo restrito. Expanda depois que os testes mostrarem que as respostas são precisas e úteis.
Trate explicitamente o conteúdo com prazo determinado. Promoções, políticas sazonais e ofertas por tempo limitado podem ficar desatualizadas facilmente. Crie uma tag de metadados separada para conteúdo com prazo determinado e defina uma data obrigatória de revisão da validade no momento da criação.
Registre e acompanhe regularmente as respostas desconhecidas. Revisar com frequência o registro de “não sei” ajuda as equipes a identificar lacunas recorrentes antes que elas se acumulem. Use o volume de consultas e o impacto nos clientes para priorizar as correções.
Dica profissional: Tickets resolvidos são material de origem útil para respostas oficiais porque mostram como a equipe lidou com perguntas reais. O Deskhero usa periodicamente tickets resolvidos como material de origem para sugestões de FAQ. Um User pode revisar, editar, aprovar ou recusar cada sugestão antes que o conteúdo aprovado fique disponível para o chatbot.
Correções rápidas para equipes que estão começando:
- Estabeleça uma convenção de nomenclatura para os artigos desde o primeiro dia (Área do produto: Tema: Público). Renomear retroativamente 200 artigos é trabalhoso.
- Crie um modelo de metadados com campos obrigatórios e cole-o em todos os artigos novos antes de começar a escrever.
- Crie um conjunto de testes com 20 a 30 consultas reais dos primeiros registros de conversas e execute-o antes de cada envio para produção.
Deskhero torna o manual de manutenção operacional desde o primeiro dia
Executar este manual em ferramentas desconectadas pode gerar trabalho adicional de coordenação. Deskhero reúne o fluxo de revisão da FAQ pública, as sugestões de FAQ e as conversas com clientes no mesmo helpdesk.
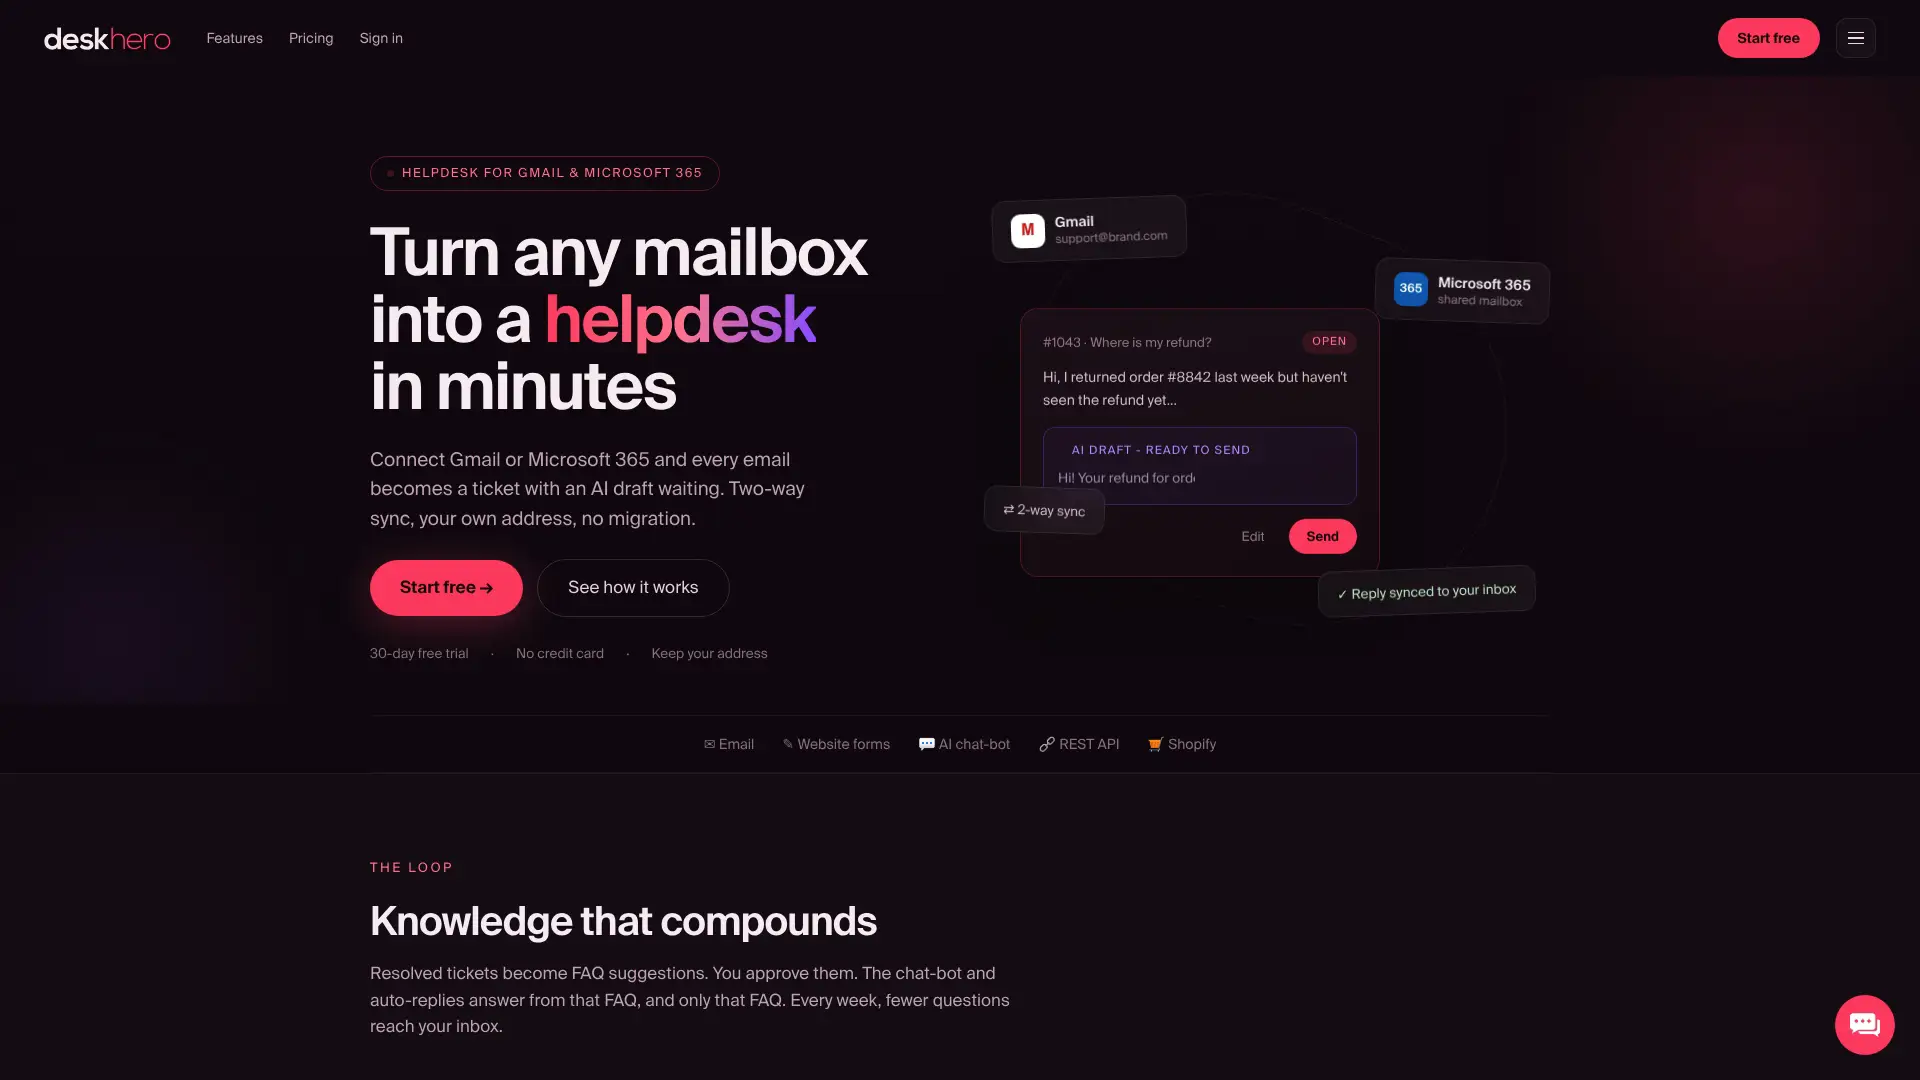
O chatbot responde somente com base no conteúdo público aprovado das FAQs, enquanto as sugestões de respostas de IA para Users podem usar um conhecimento mais amplo do workspace. As sugestões de FAQ provenientes de tickets resolvidos e páginas do site coletadas automaticamente reduzem o trabalho de criação do zero, mas ainda exigem revisão humana. A integração bidirecional com caixas de e-mail mantém os tickets e as respostas conectados ao endereço já usado pela equipe.
Para equipes que desejam esse fluxo sem montar uma estrutura de recuperação personalizada, Deskhero combina a caixa de entrada compartilhada, a FAQ pública, o chatbot e o encaminhamento para uma pessoa. Comece um teste gratuito de 30 dias em Deskhero, sem necessidade de cartão de crédito.
Fontes
Use estas fontes como referências de implementação ao tomar decisões técnicas sobre estratégia de fragmentação, abordagem de treinamento, política de governança e configuração de medição.
Perguntas frequentes
O que é uma base de conhecimento de chatbot?
Uma base de conhecimento de chatbot é um conjunto organizado de documentos de origem, divididos em trechos, convertidos em embeddings vetoriais e armazenados em um banco de dados vetorial, para que um recuperador possa selecionar o conteúdo mais relevante no momento da consulta e fundamentar as respostas do chatbot no seu conteúdo real.
Como manter um chatbot ao longo do tempo?
Execute um ciclo repetível: audite os registros de conversas para encontrar lacunas, atualize ou crie artigos oficiais, fragmente e gere embeddings em um ambiente de preparação, valide com um conjunto de testes de 20 a 30 consultas, obtenha a aprovação do responsável, publique em produção e monitore a qualidade das respostas e os encaminhamentos para identificar regressões.
O que você nunca deve dizer a um chatbot?
Evite inserir dados pessoais confidenciais (números de Seguro Social, senhas e dados de contas financeiras) em qualquer interface de chatbot, pois as entradas podem ser registradas ou usadas no treinamento do modelo, dependendo da política de tratamento de dados da plataforma. Ao criar conteúdo para a KB interna, nunca codifique dados dinâmicos (preços, estoque) que um pipeline de ingestão possa buscar diretamente no sistema oficial.
Quanto custa manter um chatbot?
Os principais custos são o tempo de revisão, a computação de recuperação e embeddings quando esses componentes são gerenciados diretamente e qualquer assinatura de helpdesk ou plataforma de conhecimento. Estime-os com base no volume de conteúdo, no volume de consultas, na frequência das atualizações e na quantidade de revisão humana necessária.