Chatbot-Wissen pflegen: Ein praxisnaher Leitfaden
Pflegen Sie das Wissen Ihres Chatbots als wiederkehrenden, rollenbasierten Prozess: prüfen → aktualisieren → validieren → veröffentlichen → ausmustern. Dieser fünfstufige Zyklus, der nach einem vorhersehbaren Zeitplan mit klarer Verantwortlichkeit an jedem Kontrollpunkt durchgeführt wird, unterscheidet einen Chatbot, der das Vertrauen der Kunden gewinnt, von einem, der es stillschweigend untergräbt.
Hier ist die kurze Checkliste, die Ihr Team vor allem anderen benötigt:
- Quellenhygiene: Entfernen Sie veraltete, doppelte oder widersprüchliche Dokumente, bevor sie den Index erreichen.
- Chunking und Indexierung: Beginnen Sie mit Chunks von 500 bis 1.000 Zeichen und passen Sie die Größe anschließend auf Grundlage von Abruf-Tests an.
- Retriever-Optimierung: Testen und justieren Sie die Ähnlichkeitsschwellenwerte vierteljährlich, damit die Präzision auch bei wachsender KB hoch bleibt.
- Genehmigungs-Workflow: Jeder neue oder bearbeitete Artikel benötigt eine Freigabe, bevor er im Chatbot live geht.
- Überwachungsmetriken: Verfolgen Sie Antwortqualität, ungelöste Fragen und Übergaben nach einem regelmäßigen Zeitplan.
- Rollback und Versionierung: Führen Sie ein Änderungsprotokoll, damit jedes fehlerhafte Update innerhalb von Minuten rückgängig gemacht werden kann.
Wer wofür verantwortlich ist: Inhaltsverantwortliche erstellen und aktualisieren Artikel. Ein Knowledge Steward setzt Standards durch und führt Prüfungen durch. Ein technischer Verantwortlicher kümmert sich um Chunking, Embeddings und Retrieval-Einstellungen, wenn das Team diese Komponenten verwaltet. Ein Reviewer führt vor jeder Veröffentlichung Testsätze aus. Compliance-Spezialisten prüfen Inhalte zu regulierten Themen.
Die wichtigsten Erkenntnisse
Die Pflege des Chatbot-Wissens erfordert einen wiederholbaren Zyklus vom Prüfen bis zum Ausmustern, klare Verantwortlichkeiten und regelmäßige Überwachung, damit Lücken erkannt werden, bevor die Kunden sie bemerken.
| Punkt | Details |
|---|---|
| Verwenden Sie den Zyklus vom Prüfen bis zum Ausmustern | Führen Sie prüfen → aktualisieren → validieren → veröffentlichen → ausmustern wöchentlich, monatlich oder vierteljährlich durch, um eine Drift der KB zu verhindern. |
| Testen Sie die Chunk-Größe | Beginnen Sie bei Retrieval-Chunks mit 500 bis 1.000 Zeichen und passen Sie die Größe anhand der Testergebnisse an. |
| Verfolgen Sie aussagekräftige Qualitätssignale | Überwachen Sie Antwortgenauigkeit, ungelöste Fragen, Übergaben und bestätigte falsche Antworten und legen Sie anschließend Schwellenwerte fest, die zu Ihrem Service passen. |
| Bestimmen Sie einen Knowledge Steward | Übertragen Sie einer Person die klare Verantwortung für den Redaktionskalender, die Prüfwarteschlange und den Wartungsrhythmus. |
| Deskhero erzwingt Antworten aus freigegebenem Wissen | Der Chatbot von Deskhero antwortet ausschließlich auf Grundlage freigegebener öffentlicher FAQ-Inhalte und schlägt FAQ-Kandidaten aus gelösten Tickets und ausgelesenen Website-Seiten vor. |
Inhaltsverzeichnis
- Was ist eine Chatbot-Wissensdatenbank und wie ermöglicht sie Antworten?
- Warum kontinuierliche Pflege für die Genauigkeit eines Chatbots wichtig ist
- Schritt-für-Schritt-Leitfaden für die operative Pflege von Chatbot-Wissen
- Standards, Vorlagen und Governance für zuverlässige Antworten
- Was Sie messen und wie Sie auf die Signale reagieren sollten
- Muster für Tools und Integrations-Checkliste
- Wie Deskhero zu diesem Wartungsleitfaden passt
- Wartungsrhythmus, Personal und Kostenüberlegungen
- So validieren Sie neue Wissensquellen vor der Integration
- So nutzen Sie Nutzerfeedback zur Verbesserung des Chatbot-Wissens
- Was Supportteams bei der Nutzung in der Produktion tatsächlich lernen
- Deskhero macht den Wartungsleitfaden ab dem ersten Tag praktisch umsetzbar
- Quellen
- FAQ
Was ist eine Chatbot-Wissensdatenbank und wie ermöglicht sie Antworten?
Eine Chatbot-Wissensdatenbank (KB) ist nicht einfach nur ein Ordner mit Hilfeartikeln. Sie ist eine kuratierte Pipeline: Quelldokumente durchlaufen einen Chunking-Schritt, jeder Chunk wird in einen numerischen Vektor (ein Embedding) umgewandelt, diese Vektoren werden in einer Vektordatenbank gespeichert und ein Retriever ruft zur Anfragezeit die relevantesten Chunks ab. Das Sprachmodell erstellt anschließend aus diesen abgerufenen Chunks eine Antwort, die auf Ihren tatsächlichen Inhalten und nicht auf den ursprünglichen Trainingsdaten basiert.
Viele KI-Wissenschatbots verwenden eine Retrieval-Pipeline mit Chunks, Embeddings, einer Vektordatenbank, einem Retriever und einem Sprachmodell. Systeme, die Quellenreferenzen beibehalten, erleichtern die Prüfung einer Antwort und die Rückverfolgung zu dem verwendeten Material.
Die zentralen Komponenten einer gut aufgebauten KB-Pipeline:
- Quelldokumente: KB-Artikel, gelöste Tickets, PDFs, Website-Seiten und Richtliniendokumente.
- Metadaten: Tags für Thema, Produktbereich, Zielgruppe, Datum der letzten Aktualisierung und Autor.
- Embeddings: Dichte Vektordarstellungen jedes Chunks, die von einem Embedding-Modell erzeugt werden.
- Vektordatenbank: Speichert und indexiert Embeddings für eine schnelle semantische Suche (Pinecone, Weaviate, pgvector und ähnliche Tools).
- Retriever: Fragt die Vektordatenbank ab und gibt die relevantesten Chunks zurück.
- LLM plus System-Prompts: Erstellt aus den abgerufenen Chunks eine natürlichsprachliche Antwort, die durch Ihre Anweisungen begrenzt wird.
- Zitationsebene: Fügt jeder Antwort Quellenreferenzen hinzu, damit Nutzer und Kunden sie überprüfen können.
Profi-Tipp: Beschränken Sie jeden Artikel auf ein eindeutig abgegrenztes Thema. Teilen Sie Dokumente auf, die mehrere nicht zusammenhängende Fragen beantworten. Auch die Chunk-Größe ist wichtig: Beginnen Sie mit 500 bis 1.000 Zeichen und passen Sie die Größe anhand der Testergebnisse an. Zu kleine Chunks können Kontext verlieren, während zu große Chunks den relevanten Satz verbergen können.
Warum kontinuierliche Pflege für die Genauigkeit eines Chatbots wichtig ist
Ein Chatbot, der einmal trainiert und anschließend sich selbst überlassen wird, verliert an Qualität. Produkte ändern sich, Richtlinien werden aktualisiert, Preise ändern sich und die KB bleibt unbemerkt zurück. Der Chatbot antwortet weiterhin auf Grundlage veralteter Daten, und die Kunden bemerken das vor Ihrem Team.
Eine aktuelle KB kann die Antwortqualität verbessern und mehr Kunden dabei helfen, Routinefragen ohne Übergabe zu lösen. Eine einheitliche Tonalität und freigegebene Formulierungen können außerdem vermeidbare Fehler reduzieren. Neue Nutzer haben einen klareren Bezugspunkt, wenn die KB als maßgebliche Quelle behandelt wird. Die Ergebnisse hängen weiterhin von der Inhaltsqualität, dem Einsatzbereich und der Konfiguration des Chatbots ab.
Die Risiken einer Vernachlässigung sind ebenso eindeutig:
- Veraltete Antworten: Ein Chatbot, der ein eingestelltes Produkt oder eine alte Rückgaberichtlinie zitiert, beschädigt sofort seine Glaubwürdigkeit.
- Widersprüchliche Inhalte: Zwei Artikel mit unterschiedlichen Antworten auf dieselbe Frage verwirren den Retriever und erzeugen uneinheitliche Antworten.
- Halluzinationsrisiko: Wenn der Retriever nichts Relevantes findet, erfindet ein schlecht konfiguriertes System eine Antwort. Eine gut gepflegte KB verringert diese Lücke.
- Compliance-Risiko: In regulierten Branchen kann eine veraltete Antwort zu einer Richtlinie erhebliche Prüfungs- und Compliance-Probleme verursachen.
- Verlust von Vertrauen: Kunden, die zweimal eine falsche Antwort erhalten, geben dem Bot nur selten eine dritte Chance.
Schritt-für-Schritt-Leitfaden für die operative Pflege von Chatbot-Wissen
Dies ist ein wiederholbarer Workflow, den Ihr Team auf eine interne SOP abbilden kann. Legen Sie einen praktikablen Rhythmus für die Prüfung von Protokollen, Inhaltsaktualisierungen und Retrieval-Tests fest und passen Sie ihn anschließend daran an, wie häufig sich Ihre Produkte und Richtlinien ändern.
-
Prüfung planen. Rufen Sie die Gesprächsprotokolle des vorherigen Zeitraums ab. Markieren Sie Anfragen mit niedrigen Konfidenzwerten, Eskalationen und „Ich weiß es nicht“-Fallbacks. Dies sind Ihre dringendsten Lücken.
-
Fehlende und veraltete Inhalte identifizieren. Vergleichen Sie markierte Anfragen mit vorhandenen KB-Artikeln. Markieren Sie Artikel, die auf veraltete Funktionen, alte Preise oder abgelaufene Angebote verweisen, zur sofortigen Aktualisierung oder Ausmusterung.
-
Kanonische Antworten erstellen oder aktualisieren. Schreiben Sie einen Artikel pro Thema. Verwenden Sie kundenorientierte Sprache statt internen Jargons. Erforderliche Felder: Thementitel, Geltungsbereich (für welches Produkt/welchen Tarif der Artikel gilt), Zielgruppe, Autor, Datum der letzten Aktualisierung und Genehmigungsstatus.
-
Chunks bilden und Embeddings erstellen. Teilen Sie aktualisierte Artikel zunächst in Chunks mit 500 bis 1.000 Zeichen auf. Fügen Sie Metadaten-Tags hinzu (Thema, Produkt, Sprache, Zielgruppe). Verarbeiten Sie die Chunks durch Ihr Embedding-Modell und laden Sie sie in einer Staging-Umgebung und nicht in der Produktion in die Vektordatenbank.
-
Validierungstests in Stufen durchführen. Verwenden Sie einen Testsatz aus 20 bis 30 echten, aus Protokollen entnommenen Anfragen. Prüfen Sie, ob jede Anfrage den richtigen Chunk abruft und ob die generierte Antwort der kanonischen Antwort entspricht. Legen Sie einen Schwellenwert für die Retrieval-Genauigkeit fest, bevor Sie die Inhalte in die Produktion übernehmen.
-
Mit einem Genehmigungsschritt in die Produktion übertragen. Ein bestimmter Genehmiger (Knowledge Steward oder Teamleiter) prüft die Testergebnisse und erteilt die Freigabe. Protokollieren Sie das Veröffentlichungsereignis mit Zeitstempel, Autor und Versionsnummer.
-
Nach der Veröffentlichung überwachen. Beobachten Sie die Antwortqualität und Übergaben nach jedem wichtigen Update genau. Wenn eine Metrik sinkt oder Prüfungen falsche Antworten ergeben, machen Sie die Änderung mithilfe des Versionsverlaufs rückgängig.
-
Veraltete Inhalte ausmustern. Archivieren Sie sie, statt sie zu löschen, damit der Versionsverlauf erhalten bleibt. Aktualisieren Sie alle Artikel, die auf den ausgemusterten Inhalt verwiesen haben.
Profi-Tipp: Wenn die Plattform dies unterstützt, verlangen Sie bei faktischen Antworten Quellenreferenzen. Kombinieren Sie dies mit einer ausdrücklichen Fallback-Anweisung: Wenn das Retrieval keine ausreichend relevanten Inhalte liefert, sollte der Chatbot sagen, dass er die Frage nicht beantworten kann, und statt zu raten eine Übergabe an einen Menschen anbieten.
Profi-Tipp: Qualität ist in jeder Phase wichtiger als Quantität. Fünf bis zehn gut geschriebene, fokussierte Dokumente ergeben einen leistungsfähigeren Assistenten als fünfzig lose strukturierte Dokumente. Bereinigen Sie Ihre Inhalte gründlich, bevor Sie sie indexieren.
Standards, Vorlagen und Governance für zuverlässige Antworten
Gute Governance ist keine Bürokratie um ihrer selbst willen. Ein menschenzentrierter Ansatz für KI beginnt bei den Bedürfnissen und dem Wohlergehen der vom System betroffenen Menschen. Bei einem kundenorientierten Chatbot machen dokumentierte Freigaben, Versionsverläufe und Änderungsnotizen Prüfung und Verantwortlichkeit praktikabel.
Redaktionelle Standards, die jeder Artikel erfüllen muss
- Ein Thema, eine Antwort. Kein Artikel behandelt mehr als eine einzelne, klar abgegrenzte Frage.
- Kundenfreundliche Sprache. Schreiben Sie so, wie ein Kunde fragen würde, nicht so, wie ein Ingenieur dokumentieren würde.
- Erforderliche Felder: Thementitel, Geltungsbereich, Zielgruppe, Autor, Datum der letzten Aktualisierung, Genehmigungsstatus, Versionsnummer und eine kurze Änderungsnotiz.
- Keine doppelten Daten. Wenn eine Ingest-Pipeline bereits aktuelle Preise aus Ihrem führenden System abruft, hinterlegen Sie diesen Preis nicht fest in einem KB-Artikel. Er wird veralten.
- Proaktive Protokollprüfung. Prüfen Sie Gesprächsprotokolle nach einem festgelegten Rhythmus, um Lücken zu finden, bevor Kunden sie melden.
Governance-Rollen
- Inhaltsverantwortlicher: Fachexperte, der Artikel in seinem Fachbereich erstellt und aktualisiert.
- Knowledge Steward: Setzt Standards durch, führt Prüfungen aus, verwaltet den Artikel-Lebenszyklus und verantwortet den Redaktionskalender.
- Genehmiger: Teamleiter oder Manager, der vor der Veröffentlichung jedes Artikels seine Freigabe erteilt.
- ML-Verantwortlicher: Kümmert sich um Chunking-Parameter, Aktualisierungen des Embedding-Modells, Retriever-Konfiguration und Pflege des Testsatzes.
- Compliance-Prüfer: Erforderliche Freigabe für Artikel zu regulierten Themen (Preise, rechtliche Bedingungen, Datenschutz).
Vertrauenssignale, die Sie jetzt umsetzen sollten
- Prüfprotokolle, die jede Erstellung, Bearbeitung, Genehmigung und Ausmusterung mit Zeitstempel und Nutzer-ID erfassen.
- Versionsverläufe mit Diff-Ansichten, damit jede Änderung überprüfbar ist.
- Änderungsprotokolle an jedem Artikel, aus denen hervorgeht, was und warum etwas geändert wurde.
- Im KB-Administrationsbereich sichtbare Genehmigungsstempel, damit das Team erkennen kann, welche Inhalte für die Chatbot-Nutzung freigegeben sind und welche nicht.
- In jedem Chatbot-Fenster angezeigte Quellenzitate.
Was Sie messen und wie Sie auf die Signale reagieren sollten
Bei der Überwachung werden Wartungsentscheidungen getroffen. Ohne Metriken raten Sie, welche Artikel aktualisiert werden müssen. Mit Metriken verfügen Sie jede Woche über eine priorisierte Arbeitswarteschlange.
Wichtige Metriken:
- Antwortgenauigkeit / Korrektheit: Prozentsatz der Chatbot-Antworten, die in einem Stichprobentestsatz der kanonischen Antwort entsprechen.
- Grounding-Rate: Prozentsatz der Antworten, die einen bestimmten Quellen-Chunk zitieren. Ein Rückgang weist auf eine Retriever-Drift oder fehlende Inhalte hin.
- Deflection-Rate: Prozentsatz der Gespräche, die ohne Beteiligung eines Nutzers gelöst werden. Zunehmende Eskalationen lassen sich häufig auf eine bestimmte KB-Lücke zurückführen.
- Eskalationsrate: Das Gegenstück zur Deflection-Rate; verfolgen Sie sie nach Themenkategorie, um die Inhaltsbereiche zu ermitteln, die Aufmerksamkeit benötigen.
- Time-to-Update: Zeit vom Erkennen einer Lücke bis zur Veröffentlichung einer verifizierten Korrektur.
- CSAT für den Bot: Kundenzufriedenheitswert speziell für vom Chatbot bearbeitete Gespräche.
- Halluzinationsvorfälle: Anzahl bestätigter Fälle, in denen der Bot eine sachlich falsche Antwort erzeugt hat, die nicht auf einer Quelle beruht.
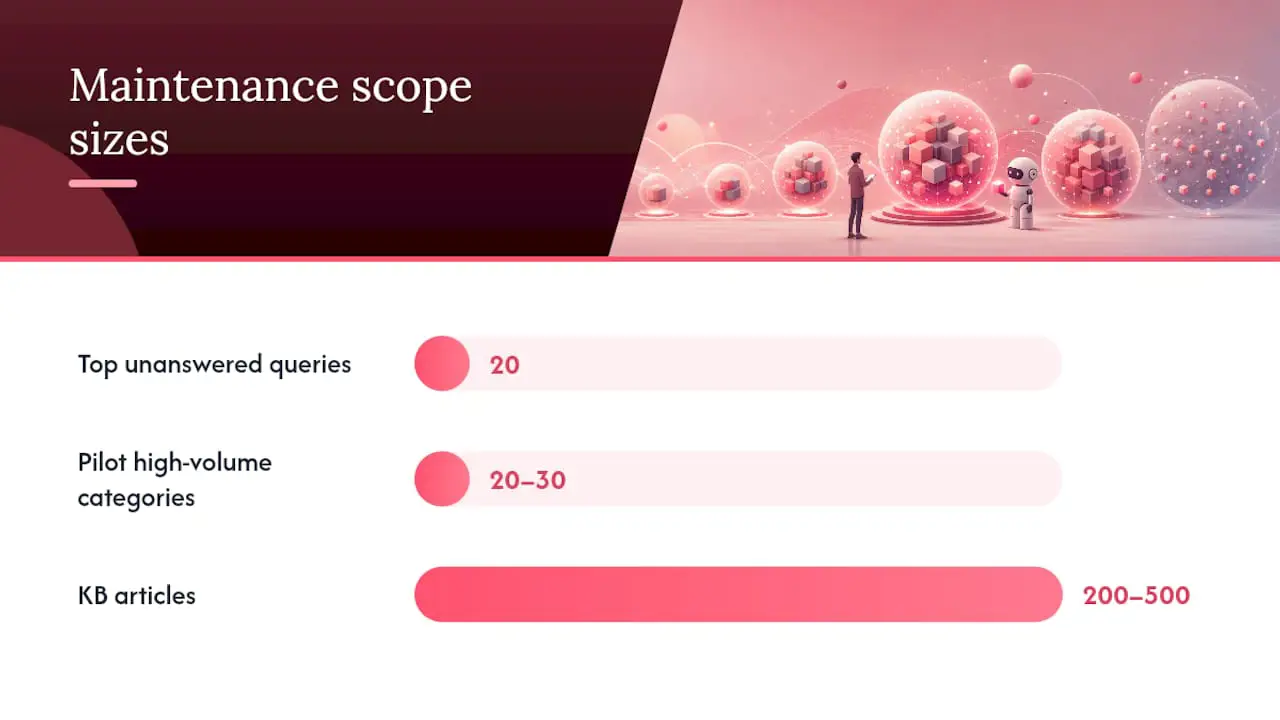
Die praktischste Nutzung von Protokollen ist die wöchentliche Erstellung einer Liste der 20 häufigsten unbeantworteten Anfragen. Sortieren Sie nach Volumen, weisen Sie jede Anfrage einem Inhaltsverantwortlichen zu und verfolgen Sie die Zeit bis zum Abschluss. Diese Liste wird zu Ihrem Wartungs-Backlog.
Muster für Tools und Integrations-Checkliste
Die richtigen Tools machen den obigen Leitfaden wiederholbar, ohne heroischen manuellen Aufwand. Bei der Bewertung von Plattformen und Integrationsmustern sollten Sie diese Funktionen priorisieren:
- Inkrementelle Indexierung: Das System kann einzelne Chunks aktualisieren, ohne die gesamte KB neu zu indexieren. Dies ist für große KBs entscheidend, bei denen eine vollständige Neuindexierung langsam und teuer ist.
- Embedding-Aktualisierung: Möglichkeit, Embeddings für aktualisierte Artikel neu zu erzeugen, ohne unveränderte Inhalte anzufassen.
- Herkunft und Zitationsunterstützung: Jeder abgerufene Chunk enthält eine Quellenreferenz, die in der Antwort angezeigt wird.
- Rollenbasierte Zugriffskontrolle: Inhaltsverantwortliche, Genehmiger und ML-Ingenieure haben unterschiedliche Berechtigungen. Die Plattform muss dies durchsetzen.
- Prüfprotokolle: Jedes Indexierungsereignis, jede Inhaltsänderung und jede Genehmigung wird mit Zeitstempel und Nutzer protokolliert.
- Webhooks für Ticketing: Wenn ein Ticket gelöst wird, kann ein Webhook eine KB-Prüfung oder den automatischen Entwurf eines Artikelkandidaten auslösen. Dadurch wird die Verbindung zwischen Supportbetrieb und Wissenspflege geschlossen.
- SSO: Google- und Microsoft-SSO reduzieren Reibungsverluste für Teams, die bereits in diesen Ökosystemen arbeiten.
Integrationsmuster, die in der Produktion funktionieren
Direkte KB-Synchronisierung: Die KB-Plattform überträgt aktualisierte Artikel nach einem Zeitplan oder bei der Veröffentlichung in die Vektordatenbank. Einfach, zuverlässig und der richtige Ausgangspunkt für die meisten Teams.
Indexierung in einer Staging-Sandbox: Neue oder aktualisierte Inhalte werden zunächst in einer Staging-Umgebung indexiert. Die Testsuite läuft gegen Staging, bevor eine Änderung die Produktion erreicht. Dies entspricht einer CI-Pipeline für Wissensinhalte.
CI-ähnliche Validierungspipelines: Behandeln Sie KB-Änderungen wie Codeänderungen. Ein Inhaltsupdate löst einen automatisierten Testlauf gegen Ihren Testsatz mit 20 bis 30 Anfragen aus. Fehler blockieren die Veröffentlichung. Erfolgreiche Tests werden zur endgültigen Freigabe an den Genehmiger weitergeleitet.
Wichtige Zielkonflikte, die Sie verstehen sollten
RAG ist für die meisten Supportteams mit häufig wechselndem Wissen die richtige Architektur. Sie aktualisieren Dokumente statt Modellgewichte, wodurch die Kosten überschaubar und die Aktualisierungszyklen kurz bleiben. Fine-Tuning ist für statische, hochspezialisierte Bereiche sinnvoll, in denen Vokabular und Argumentationsmuster stabil sind. Der Unterschied bei den Betriebskosten ist erheblich: Ein RAG-Update besteht aus einer Dokumentbearbeitung und einer Neuindexierung; ein Fine-Tuning-Zyklus erfordert gekennzeichnete Daten, Rechenzeit und vor der Bereitstellung eine vollständige Modellevaluierung.
Beim Verhältnis zwischen Latenz und Aktualität halten häufigere Embedding-Aktualisierungen die Antworten aktuell, verursachen jedoch zusätzliche Rechenkosten. Wählen Sie den Aktualisierungsplan danach, wie häufig sich das Quellenmaterial ändert, und führen Sie nach wichtigen Updates eine Validierung durch.
Wie Deskhero zu diesem Wartungsleitfaden passt
Deskhero basiert auf dem Prinzip, dass ein Chatbot nur aus Wissen antworten sollte, das Sie ausdrücklich freigegeben haben. Dies entspricht direkt den Governance- und Validierungsschritten dieses Leitfadens.
So verbinden sich konkrete Schritte des Leitfadens mit den Funktionen von Deskhero:
- Antworten ausschließlich aus freigegebenem Wissen: Der KI-Chatbot von Deskhero antwortet aus freigegebenen öffentlichen FAQ-Inhalten. Anderes Wissen aus dem Workspace wird nicht für kundenorientierte Chatbot-Antworten verwendet. Zur Aktivierung des Chatbots sind mindestens 100 freigegebene öffentliche FAQ-Einträge erforderlich.
- FAQ-Vorschläge aus gelösten Tickets: Gelöste Tickets und ausgelesene Website-Seiten können zu FAQ-Kandidaten verdichtet werden. Ein Nutzer prüft und genehmigt einen Eintrag, bevor er dem Chatbot zur Verfügung stehen kann.
- Getrennte Wissensbereiche: Die interne Wissensdatenbank kann KI-Antwortvorschläge für Nutzer unterstützen. Kundenorientierte Chatbot-Antworten verwenden ausschließlich die freigegebenen öffentlichen FAQs.
- Zwei-Wege-E-Mail-Synchronisierung: Kundenfragen treffen per E-Mail, Formular oder Chatbot ein und werden zu Tickets in einem gemeinsamen Posteingang. Antworten können von der verbundenen Unternehmensadresse versendet werden.
- Gekennzeichnete automatische Aktionen: Automatische Aktionen werden gekennzeichnet und protokolliert; der vollständig automatische Versand ist optional.
- REST-API: Deskhero bietet eine REST-API für Ticket- und Workspace-Operationen. Es bietet keine ausgehenden Webhooks.
- Mehrsprachige Oberfläche: Die Oberfläche von Deskhero ist in 14 unterstützten Sprachen verfügbar, und das Chatbot-Retrieval kann öffentliche FAQ-Inhalte sprachübergreifend abgleichen.
Deskhero verbindet Gmail-, Google-Workspace- oder Microsoft-365-Postfächer mit einem gemeinsamen Helpdesk und ermöglicht dem Team gleichzeitig, seine bestehenden E-Mail-Adressen beizubehalten. Die kundenorientierte KI antwortet auf Grundlage freigegebener öffentlicher FAQ-Inhalte und übergibt ungelöste Fragen an einen Menschen. FAQ-Vorschläge können aus gelösten Tickets und ausgelesenen Website-Seiten erstellt werden, müssen vor der Genehmigung jedoch von einem Nutzer geprüft werden. Automatische Aktionen werden gekennzeichnet und protokolliert. Die Plattform umfasst außerdem eine interne Wissensdatenbank, Ticket-Insights, 14 Oberflächensprachen, eine Shopify-Integration, Google- und Microsoft-SSO sowie eine REST-API. Sie beginnt mit einer kostenlosen 30-Tage-Testversion, für die keine Kreditkarte erforderlich ist.
Da der Chatbot von Deskhero auf die freigegebenen öffentlichen FAQs beschränkt ist, ist die Wartungsaufgabe konkret: Prüfen Sie ungelöste Fragen, verbessern oder ergänzen Sie FAQ-Einträge, genehmigen Sie diese und überprüfen Sie, ob das aktualisierte Wissen die vorgesehenen Fragen beantwortet.
Weitere Informationen dazu, wie KI-Chatbots in einem solchen Workflow mit Eskalationen und Übergaben an Menschen umgehen, finden Sie im ausführlichen Leitfaden zur Übergabe von Chatbots an Menschen.
Wartungsrhythmus, Personal und Kostenüberlegungen
Bei der Planung der Personen und Zeit hinter dem Chatbot-Wissensmanagement unterschätzen die meisten Teams den Aufwand. Die gute Nachricht: Ein kleines Team mit einem klaren Rhythmus kann eine produktive KB ohne eigens dafür vorgesehene Vollzeitstellen pflegen.
Empfohlene Rhythmen:
- Wöchentlich: Gesprächsprotokolle prüfen, die Liste der 20 häufigsten unbeantworteten Anfragen erstellen, dringende Inhaltslücken markieren und besonders wichtige Korrekturen durch den Genehmigungsschritt bringen.
- Monatlich: Einen vollständigen Inhaltsaktualisierungszyklus durchführen. Neue Artikel erstellen, geänderte Richtlinien oder Produkte aktualisieren, veraltete Inhalte ausmustern und die komplette Testsuite ausführen.
- Vierteljährlich: Richtlinien- und Produktänderungen prüfen, den Retriever optimieren, das Embedding-Modell evaluieren und ein Governance-Audit durchführen (sind alle Artikel ordnungsgemäß genehmigt und versioniert?).
Minimales Personalmodell für kleine Teams:
- Knowledge Steward: Verantwortet den Redaktionskalender, führt Prüfungen durch, setzt Standards durch und verwaltet die Genehmigungswarteschlange. Der erforderliche Zeitaufwand hängt vom Inhaltsvolumen und der Änderungshäufigkeit ab.
- Technischer Support: Kümmert sich um Chunking-Parameter, Embedding-Aktualisierungen, Retrieval-Konfiguration und die Pflege der Testsuite, wenn das Team seinen eigenen Retrieval-Stack verwaltet.
- Rotierende Fachexperten: Für jeden Produkt- oder Richtlinienbereich gibt es einen bestimmten Inhaltsverantwortlichen, der die Artikel seines Bereichs prüft und genehmigt. Dies ist typischerweise eine Teilzeitaufgabe innerhalb einer bestehenden Rolle.
Zu schätzende Kostentreiber:
- Die Kosten für Speicher und Abfragen der Vektordatenbank steigen mit der Größe der KB und dem Anfragevolumen.
- Die Häufigkeit der Embedding-Aktualisierung beeinflusst die Rechenkosten. Aktualisieren Sie daher geänderte Inhalte, wenn die Plattform inkrementelle Updates unterstützt.
- Der Zeitaufwand für die manuelle Prüfung kann beträchtlich sein, insbesondere wenn sich Produkte oder Richtlinien häufig ändern.
- Die Abonnementkosten für Tools unterscheiden sich je nach Plattform. Plattformen, die KB-Management, Ticketing und Chatbot in einem einzigen Abonnement bündeln, statt separate Vektordatenbanken, LLM-APIs und Helpdesk-Tools zu erfordern, senken sowohl Kosten als auch Integrationskomplexität.
Untersuchungen zu generativer KI im Kundensupport haben in einem realen Supportumfeld Produktivitätsgewinne festgestellt. Betrachten Sie diese Ergebnisse als Kontext und nicht als Personalformel, da Kosten und Nutzen der Wissenspflege vom Team, den Inhalten und den Tools abhängen.
Pilotprojekt mit begrenztem Kostenumfang: Beginnen Sie mit 20 bis 30 häufigen Fragenkategorien. Erstellen und pflegen Sie zunächst die Artikel für diese Kategorien. Vergewissern Sie sich, dass sich die Antwortqualität verbessert, bevor Sie die KB erweitern. Dadurch bleibt der anfängliche Wartungsaufwand gering und das interne Vertrauen in den Prozess wächst.
So validieren Sie neue Wissensquellen vor der Integration
Nicht jedes Dokument, das nützlich aussieht, gehört in den Index des Chatbots. Die Integration einer minderwertigen oder ungenauen Quelle verschlechtert die gesamte KB, weil der Retriever keine Möglichkeit hat, zwischen einem gut belegten und einem schlecht geschriebenen Artikel zu unterscheiden.
Führen Sie jede potenzielle Quelle vor der Indexierung durch diese Prüfungen:
Genauigkeitsprüfung: Spiegelt der Inhalt das aktuelle Produktverhalten, die aktuelle Richtlinie oder die aktuellen Preise wider? Vergleichen Sie ihn mit dem führenden System (Ihrem CRM, der Produktdokumentation oder den von der Rechtsabteilung genehmigten Richtliniendokumenten). Wenn Sie eine Aussage nicht anhand einer Primärquelle überprüfen können, indexieren Sie sie nicht.
Geltungsbereichsprüfung: Ist der Inhalt für die Fragen relevant, die Ihr Chatbot beantworten soll? Ein allgemeines Whitepaper zur Branche kann zwar korrekte Informationen enthalten, aber Retrieval-Rauschen durch irrelevante Themen verursachen. Grenzen Sie Dokumente eng auf Ihren Anwendungsfall ein.
Duplikatprüfung: Überschneidet sich dieser Inhalt erheblich mit einem bestehenden KB-Artikel? Doppelte Inhalte erzeugen Mehrdeutigkeiten beim Retrieval. Führen Sie sie vor der Indexierung zusammen oder konsolidieren Sie sie.
Format- und Strukturprüfung: Ist das Dokument so strukturiert, dass das Chunking kohärente, in sich geschlossene Passagen erzeugt? Ein Dokument mit zahlreichen Querverweisen („siehe Abschnitt 4.2 für Details“) lässt sich schlecht in Chunks aufteilen, weil einzelne Chunks den Kontext verlieren. Schreiben Sie den Inhalt vor der Indexierung um oder strukturieren Sie ihn neu.
Herkunftsprüfung: Können Sie den Inhalt zu einer maßgeblichen internen oder externen Quelle zurückverfolgen? Bei regulierten Themen sollten Sie die Quelle ausdrücklich in den Artikelmetadaten dokumentieren.
Staging-Test: Indexieren Sie die neue Quelle in einer Staging-Umgebung und führen Sie Ihren Standardtestsatz mit 20 bis 30 Anfragen aus. Prüfen Sie, ob der neue Inhalt die Retrieval-Genauigkeit verbessert, verschlechtert oder nicht beeinflusst. Übernehmen Sie nur Quellen, die die Genauigkeit verbessern oder beibehalten.
So nutzen Sie Nutzerfeedback zur Verbesserung des Chatbot-Wissens
Nutzerfeedback ist das direkteste Signal dafür, wo die KB versagt. Die Herausforderung besteht darin, es systematisch zu erfassen, statt nur auf die lautesten Beschwerden zu reagieren.
Daumen hoch/Daumen runter bei Chatbot-Antworten ist der einfachste Feedback-Mechanismus. Jede Chatbot-Antwort sollte eine binäre Bewertungsoption enthalten. Fassen Sie die Ergebnisse wöchentlich zusammen. Eine Antwort mit vielen negativen Bewertungen ist ein direktes Signal für eine KB-Prüfung, unabhängig davon, ob sie für das Autorenteam korrekt aussah.
CSAT-Umfragen nach dem Gespräch liefern ein umfassenderes Signal. Niedrige Werte bei vom Bot bearbeiteten Gesprächen, nach Themenkategorie gefiltert, zeigen, welche Inhaltsbereiche die meiste Aufmerksamkeit benötigen. Kombinieren Sie CSAT-Daten mit Eskalationsprotokollen, um zu bestätigen, ob es sich um eine KB-Lücke oder ein Problem der Retriever-Konfiguration handelt.
Feedbackschleifen mit dem Supportteam sind wertvoll. Nutzer, die Eskalationen bearbeiten, wissen häufig, warum der Bot gescheitert ist. Ein einfaches Tag-System in Ihrem Ticketing-Tool, etwa „falsche Antwort“, „fehlende Antwort“ oder „veraltete Richtlinie“, kann diese Erfahrung in ein strukturiertes Wartungssignal umwandeln.
Explizite „Ich weiß es nicht“-Protokolle sind eine wahre Fundgrube. Jedes Mal, wenn der Chatbot eskaliert, weil er keinen relevanten Inhalt gefunden hat, sollte die Anfrage protokolliert werden. Sortieren Sie wöchentlich nach Volumen. Die häufigsten Anfragen auf dieser Liste sind Ihre dringendsten Aufgaben bei der Inhaltserstellung.
Regelmäßige Nutzerumfragen zur KB-Qualität, die an Kunden gesendet werden, die in den vergangenen 30 Tagen mit dem Chatbot interagiert haben, machen systemische Probleme sichtbar, die einzelne Gesprächsbewertungen übersehen. Beschränken Sie die Umfrage auf zwei oder drei Fragen und verknüpfen Sie die Antworten mit Gesprächs-IDs, damit Sie das Feedback zu bestimmten Artikeln zurückverfolgen können.
Die Feedbackschleife ist geschlossen, wenn eine markierte Anfrage zu einem KB-Artikel wird, der Artikel den Genehmigungs-Workflow durchläuft und sich die Antwort des Chatbots auf diese Anfrage verbessert. Die Verfolgung dieser Zykluszeit (vom Signal bis zur Korrektur) ist eine der nützlichsten operativen Metriken, für die ein Knowledge Steward verantwortlich sein kann.
Was Supportteams bei der Nutzung in der Produktion tatsächlich lernen
Der obige Leitfaden ist theoretisch korrekt. Hier erfahren Sie, was in der Praxis schiefläuft und wie Sie es schnell beheben.
Klein anfangen und den Nutzen vor der Skalierung nachweisen. Die gleichzeitige Indexierung aller verfügbaren Dokumente kann eine überladene KB erzeugen und es erschweren, eine sinnvolle Qualitäts-Baseline festzulegen. Wählen Sie 20 bis 30 häufige Fragenkategorien aus, erstellen Sie dafür saubere Artikel und betreiben Sie den Chatbot zunächst in diesem begrenzten Umfang. Erweitern Sie den Umfang, sobald Tests zeigen, dass die Antworten genau und nützlich sind.
Zeitgebundene Inhalte ausdrücklich behandeln. Angebote, saisonale Richtlinien und zeitlich begrenzte Aktionen können schnell veralten. Erstellen Sie für zeitgebundene Inhalte ein separates Metadaten-Tag und legen Sie bereits bei der Erstellung ein verpflichtendes Prüfdatum für den Ablauf fest.
Unbekannte Antworten regelmäßig protokollieren und verfolgen. Die häufige Prüfung des „Ich weiß es nicht“-Protokolls hilft Teams, wiederkehrende Lücken zu erkennen, bevor sie sich anhäufen. Priorisieren Sie Korrekturen anhand des Anfragevolumens und der Auswirkungen auf Kunden.
Profi-Tipp: Gelöste Tickets sind wertvolles Ausgangsmaterial für kanonische Antworten, weil sie zeigen, wie das Team echte Fragen behandelt hat. Deskhero verwendet gelöste Tickets regelmäßig als Ausgangsmaterial für FAQ-Vorschläge. Ein Nutzer kann jeden Vorschlag prüfen, bearbeiten, genehmigen oder ablehnen, bevor freigegebene Inhalte dem Chatbot zur Verfügung stehen.
Schnelle Lösungen für Teams, die gerade beginnen:
- Legen Sie am ersten Tag eine Namenskonvention für Artikel fest (Produktbereich: Thema: Zielgruppe). 200 Artikel nachträglich umzubenennen ist mühsam.
- Erstellen Sie eine Metadatenvorlage mit Pflichtfeldern und fügen Sie sie vor dem Schreiben in jeden neuen Artikel ein.
- Erstellen Sie aus den ersten Gesprächsprotokollen eine Testsuite mit 20 bis 30 echten Anfragen und führen Sie sie vor jedem Produktions-Deployment aus.
Deskhero macht den Wartungsleitfaden ab dem ersten Tag praktisch umsetzbar
Die Ausführung dieses Leitfadens über voneinander getrennte Tools hinweg kann zusätzlichen Koordinationsaufwand verursachen. Deskhero vereint den Prüf-Workflow für öffentliche FAQs, FAQ-Vorschläge und Kundengespräche in einem einzigen Helpdesk.
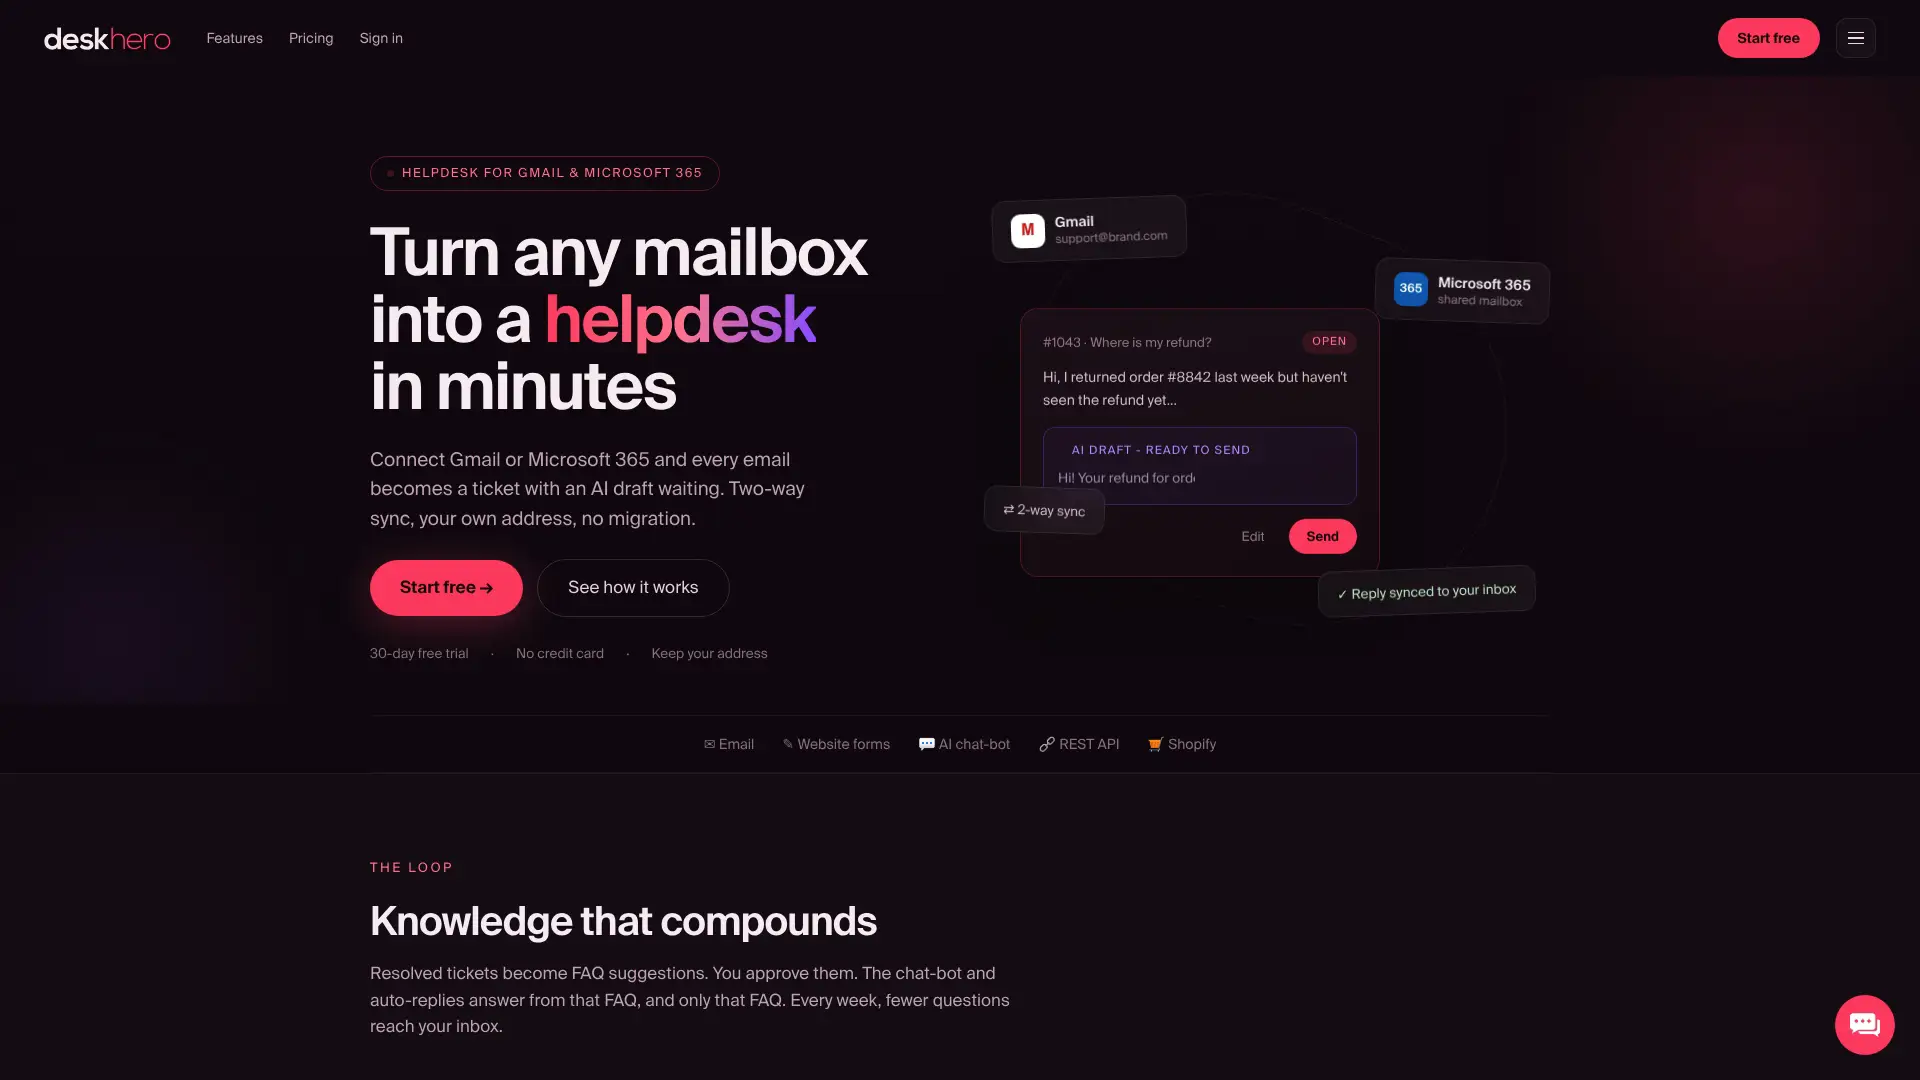
Der Chatbot antwortet ausschließlich auf Grundlage freigegebener öffentlicher FAQ-Inhalte, während KI-Antwortvorschläge für Nutzer auf breiteres Workspace-Wissen zurückgreifen können. FAQ-Vorschläge aus gelösten Tickets und ausgelesenen Website-Seiten reduzieren den Aufwand für die Erstellung von Grund auf, erfordern jedoch weiterhin eine manuelle Prüfung. Die Zwei-Wege-Postfachintegration hält Tickets und Antworten mit der bestehenden Adresse des Teams verbunden.
Für Teams, die diesen Workflow ohne den Aufbau eines eigenen Retrieval-Stacks umsetzen möchten, kombiniert Deskhero gemeinsamen Posteingang, öffentliche FAQs, Chatbot und Übergabe an Menschen. Starten Sie eine kostenlose 30-Tage-Testversion bei Deskhero, ohne Kreditkarte.
Quellen
Verwenden Sie diese Quellen als Referenzen für die Umsetzung, wenn Sie technische Entscheidungen zu Chunking-Strategie, Trainingsansatz, Governance-Richtlinien und Messkonzept treffen.
FAQ
Was ist eine Chatbot-Wissensdatenbank?
Eine Chatbot-Wissensdatenbank ist eine kuratierte Sammlung von Quelldokumenten, die in Passagen aufgeteilt, in Vektor-Embeddings umgewandelt und in einer Vektordatenbank gespeichert werden. So kann ein Retriever zur Anfragezeit die relevantesten Inhalte abrufen und die Antworten des Chatbots auf Ihren tatsächlichen Inhalten basieren lassen.
Wie pflegt man einen Chatbot langfristig?
Führen Sie einen wiederholbaren Zyklus durch: Prüfen Sie Gesprächsprotokolle, um Lücken zu finden, aktualisieren oder erstellen Sie kanonische Artikel, bilden Sie in einer Staging-Umgebung Chunks und Embeddings, validieren Sie anhand eines Testsatzes mit 20 bis 30 Anfragen, holen Sie die Freigabe des Genehmigers ein, veröffentlichen Sie in der Produktion und überwachen Sie Antwortqualität sowie Übergaben auf Rückschritte.
Was sollte man einem Chatbot niemals mitteilen?
Vermeiden Sie die Eingabe vertraulicher personenbezogener Daten (Sozialversicherungsnummern, Passwörter, Finanzkontodaten) in jede Chatbot-Oberfläche, da Eingaben abhängig von den Richtlinien der Plattform zur Datenverarbeitung protokolliert oder zum Modelltraining verwendet werden können. Bei der Erstellung interner KB-Inhalte sollten Sie niemals aktuelle Daten (Preise, Bestand) fest hinterlegen, die eine Ingest-Pipeline direkt aus dem führenden System abrufen kann.
Wie viel kostet die Pflege eines Chatbots?
Die wichtigsten Kosten entstehen durch Prüfzeit, Retrieval- und Embedding-Rechenleistung, wenn diese Komponenten direkt verwaltet werden, sowie durch Abonnements für Helpdesk- oder Wissensplattformen. Schätzen Sie diese Kosten anhand des Inhaltsvolumens, Anfragevolumens, der Aktualisierungshäufigkeit und des erforderlichen manuellen Prüfaufwands.