Come mantenere la knowledge base di un chatbot: guida pratica
Mantieni la conoscenza del chatbot come un processo ricorrente e basato sui ruoli: verifica → aggiorna → valida → pubblica → ritira. Questo ciclo in cinque fasi, eseguito con una cadenza prevedibile e responsabilità chiare a ogni passaggio, è ciò che distingue un chatbot che conquista la fiducia dei clienti da uno che la erode silenziosamente.
Ecco la breve checklist di cui il tuo team ha bisogno prima di qualsiasi altra cosa:
- Igiene delle fonti: Rimuovi i documenti obsoleti, duplicati o contraddittori prima che raggiungano l’indice.
- Suddivisione e indicizzazione: Inizia con blocchi da 500 a 1.000 caratteri, poi regola le dimensioni in base ai test di recupero.
- Ottimizzazione del retriever: Testa e regola trimestralmente le soglie di similarità, così la precisione rimane elevata mentre la KB cresce.
- Flusso di approvazione: Ogni articolo nuovo o modificato deve essere approvato prima di essere reso disponibile nel chatbot.
- Metriche di monitoraggio: Monitora regolarmente la qualità delle risposte, le domande senza risposta e i passaggi a un operatore.
- Rollback e controllo delle versioni: Conserva un changelog, così ogni aggiornamento problematico può essere annullato in pochi minuti.
Chi è responsabile di cosa: I responsabili dei contenuti scrivono e aggiornano gli articoli. Un responsabile della conoscenza applica gli standard ed esegue le verifiche. Un responsabile tecnico gestisce suddivisione, embedding e impostazioni di recupero quando il team amministra questi componenti. Un revisore esegue i set di test prima di ogni pubblicazione. Gli specialisti della conformità esaminano i contenuti relativi ad argomenti regolamentati.
Punti chiave
La manutenzione della conoscenza di un chatbot richiede un ciclo ripetibile dalla verifica al ritiro, responsabilità chiare e monitoraggio regolare per individuare le lacune prima dei clienti.
| Punto | Dettagli |
|---|---|
| Usa il ciclo dalla verifica al ritiro | Esegui verifica → aggiornamento → validazione → pubblicazione → ritiro con cadenza settimanale/mensile/trimestrale per prevenire il deterioramento della KB. |
| Testa la dimensione dei blocchi | Inizia con blocchi di recupero da 500 a 1.000 caratteri e regolali in base ai risultati dei test. |
| Monitora segnali di qualità utili | Monitora l’accuratezza delle risposte, le domande senza risposta, i passaggi a un operatore e le risposte confermate come errate, quindi definisci soglie adatte al tuo servizio. |
| Assegna un responsabile della conoscenza | Affida a una persona la responsabilità chiara del calendario editoriale, della coda di revisione e della cadenza di manutenzione. |
| Deskhero applica le risposte basate sulla conoscenza approvata | Il chatbot di Deskhero risponde solo utilizzando contenuti FAQ pubblici approvati e suggerisce candidati per le FAQ a partire dai ticket risolti e dalle pagine web acquisite. |
Indice
- Che cos’è una knowledge base per chatbot e come alimenta le risposte?
- Perché la manutenzione continua è importante per l’accuratezza del chatbot
- Playbook operativo passo dopo passo per mantenere la conoscenza del chatbot
- Standard, modelli e governance che mantengono affidabili le risposte
- Cosa misurare e come agire in base ai segnali
- Modelli di strumenti e checklist di integrazione
- Come Deskhero si adatta a questo playbook di manutenzione
- Cadenza di manutenzione, personale e considerazioni sui costi
- Come validare nuove fonti di conoscenza prima dell’integrazione
- Come usare il feedback degli utenti per perfezionare la conoscenza del chatbot
- Cosa imparano realmente i team di supporto usando questo sistema in produzione
- Deskhero rende operativo il playbook di manutenzione fin dal primo giorno
- Fonti
- FAQ
Che cos’è una knowledge base per chatbot e come alimenta le risposte?
Una knowledge base (KB) per chatbot non è semplicemente una cartella di articoli di assistenza. È una pipeline curata: i documenti di origine passano attraverso una fase di suddivisione, ogni blocco viene convertito in un vettore numerico (un embedding), questi vettori vengono archiviati in un database vettoriale e un retriever estrae i blocchi più pertinenti al momento della richiesta. Il modello linguistico sintetizza quindi una risposta a partire dai blocchi recuperati, basandosi sui tuoi contenuti effettivi anziché sui dati di addestramento di base.
Molti chatbot di conoscenza basati sull’IA utilizzano una pipeline di recupero con blocchi, embedding, un database vettoriale, un retriever e un modello linguistico. I sistemi che conservano i riferimenti alle fonti rendono più semplice esaminare una risposta e ricondurla al materiale utilizzato.
I componenti fondamentali di una pipeline KB ben costruita:
- Documenti di origine: Articoli della KB, ticket risolti, PDF, pagine web, documenti relativi alle policy.
- Metadati: Tag relativi all’argomento, all’area di prodotto, al pubblico, alla data dell’ultimo aggiornamento e all’autore.
- Embedding: Rappresentazioni vettoriali dense di ogni blocco, generate da un modello di embedding.
- Database vettoriale: Archivia e indicizza gli embedding per una ricerca semantica rapida (Pinecone, Weaviate, pgvector e strumenti simili).
- Retriever: Interroga il database vettoriale e restituisce i blocchi più pertinenti.
- LLM e prompt di sistema: Sintetizza i blocchi recuperati in una risposta in linguaggio naturale, vincolata dalle tue istruzioni.
- Livello di citazione: Collega i riferimenti alle fonti a ogni risposta, così Utenti e clienti possono verificarla.
Consiglio: Mantieni ogni articolo concentrato su un unico argomento chiaro. Dividi i documenti che rispondono a diverse domande non correlate. Anche la dimensione dei blocchi è importante: inizia con 500-1.000 caratteri e regola la dimensione in base ai risultati dei test. I blocchi troppo piccoli possono perdere il contesto, mentre quelli troppo grandi possono nascondere la frase pertinente.
Perché la manutenzione continua è importante per l’accuratezza del chatbot
Un chatbot addestrato una volta e poi lasciato senza manutenzione peggiora. I prodotti cambiano, le policy vengono aggiornate, i prezzi variano e la KB rimane silenziosamente indietro. Il chatbot continua a rispondere utilizzando dati obsoleti e i clienti se ne accorgono prima del tuo team.
Mantenere aggiornata la KB può migliorare la qualità delle risposte e aiutare più clienti a risolvere domande di routine senza passare a un operatore. Un tono coerente e formulazioni approvate possono inoltre ridurre gli errori evitabili. I nuovi Utenti hanno un punto di riferimento più chiaro quando la KB viene trattata come fonte autorevole. I risultati dipendono comunque dalla qualità dei contenuti, dall’ambito di implementazione e dalla configurazione del chatbot.
I rischi della trascuratezza sono altrettanto evidenti:
- Risposte obsolete: Un chatbot che cita un prodotto fuori produzione o una vecchia policy sui resi danneggia immediatamente la credibilità.
- Contenuti contraddittori: Due articoli che forniscono risposte diverse alla stessa domanda confondono il retriever e producono risposte incoerenti.
- Rischio di allucinazioni: Quando il retriever non trova nulla di pertinente, un sistema configurato male inventa una risposta. Una KB ben mantenuta riduce questa lacuna.
- Esposizione alla non conformità: Nei settori regolamentati, una risposta obsoleta su una policy può creare seri problemi di revisione e conformità.
- Fiducia erosa: I clienti che ricevono due volte una risposta errata raramente concedono al bot una terza possibilità.
Playbook operativo passo dopo passo per mantenere la conoscenza del chatbot
Questo è un flusso di lavoro ripetibile che il tuo team può associare a una SOP interna. Stabilisci una cadenza pratica per la revisione dei log, gli aggiornamenti dei contenuti e i test di recupero, quindi adattala alla frequenza con cui cambiano i tuoi prodotti e le tue policy.
-
Programma la verifica. Recupera i log delle conversazioni del periodo precedente. Contrassegna le richieste con punteggi di affidabilità bassi, escalation e risposte di fallback come “Non lo so”. Queste sono le lacune a più alta priorità.
-
Individua i contenuti mancanti e obsoleti. Confronta le richieste contrassegnate con gli articoli KB esistenti. Contrassegna per l’aggiornamento o il ritiro immediato gli articoli che fanno riferimento a funzionalità deprecate, vecchi prezzi o promozioni scadute.
-
Scrivi o aggiorna le risposte canoniche. Scrivi un articolo per ogni argomento. Usa un linguaggio rivolto ai clienti, non il gergo interno. Campi obbligatori: titolo dell’argomento, ambito (a quale prodotto/piano si applica), pubblico previsto, autore, data dell’ultimo aggiornamento e stato di approvazione.
-
Suddividi e crea gli embedding. Inizia suddividendo gli articoli aggiornati in blocchi da 500 a 1.000 caratteri. Aggiungi tag di metadati (argomento, prodotto, lingua, pubblico). Invia i blocchi al modello di embedding e caricali nel database vettoriale in un ambiente di staging, non in produzione.
-
Esegui test di validazione in staging. Usa un set di test composto da 20-30 richieste reali ricavate dai log. Verifica che ogni richiesta recuperi il blocco corretto e che la risposta generata corrisponda a quella canonica. Definisci una soglia di superamento per l’accuratezza del recupero prima di promuovere la modifica in produzione.
-
Distribuisci in produzione con un passaggio di approvazione. Un approvatore designato (responsabile della conoscenza o team leader) esamina i risultati dei test e approva. Registra l’evento di pubblicazione con data e ora, autore e numero di versione.
-
Monitora dopo la pubblicazione. Dopo ogni aggiornamento significativo, osserva attentamente la qualità delle risposte e i passaggi a un operatore. Se una metrica diminuisce o le revisioni rilevano risposte errate, annulla la modifica usando la cronologia delle versioni.
-
Ritira i contenuti obsoleti. Archiviali invece di eliminarli, così la cronologia delle versioni rimane intatta. Aggiorna gli eventuali articoli che facevano riferimento al contenuto ritirato.
Consiglio: Quando la piattaforma lo consente, richiedi riferimenti alle fonti per le risposte fattuali. Abbina questa impostazione a un’istruzione di fallback esplicita: se il recupero non restituisce contenuti sufficientemente pertinenti, il chatbot dovrebbe dire di non poter rispondere e offrire il passaggio a un operatore umano invece di tirare a indovinare.
Consiglio: La qualità supera la quantità in ogni fase. Da cinque a dieci documenti ben scritti e mirati producono un assistente più efficace di cinquanta documenti strutturati in modo approssimativo. Elimina senza esitazione prima di indicizzare.
Standard, modelli e governance che mantengono affidabili le risposte
Una buona governance non è burocrazia fine a se stessa. Un approccio all’IA incentrato sulle persone parte dalle esigenze e dal benessere delle persone interessate dal sistema. Per un chatbot rivolto ai clienti, approvazioni documentate, cronologia delle versioni e note sulle modifiche rendono concreta la revisione e la responsabilità.
Standard editoriali che ogni articolo deve rispettare
- Un argomento, una risposta. Nessun articolo deve coprire più di una domanda distinta.
- Linguaggio adatto ai clienti. Scrivi come farebbe una domanda un cliente, non come documenterebbe un ingegnere.
- Campi obbligatori: Titolo dell’argomento, ambito, pubblico, autore, data dell’ultimo aggiornamento, stato di approvazione, numero di versione e breve nota sulla modifica.
- Nessun dato duplicato. Se una pipeline di acquisizione recupera già i prezzi aggiornati dal sistema di riferimento, non inserire quel prezzo in modo fisso in un articolo KB. Diventerebbe obsoleto.
- Revisione proattiva dei log. Esamina i log delle conversazioni con una cadenza stabilita per individuare le lacune prima che siano segnalate dai clienti.
Ruoli di governance
- Responsabile dei contenuti: Esperto della materia che scrive e aggiorna gli articoli del proprio ambito.
- Responsabile della conoscenza: Applica gli standard, esegue le verifiche, gestisce il ciclo di vita degli articoli e cura il calendario editoriale.
- Approvatore: Team leader o manager che approva ogni articolo prima della pubblicazione.
- Responsabile ML: Gestisce i parametri di suddivisione, gli aggiornamenti del modello di embedding, la configurazione del retriever e la manutenzione del set di test.
- Revisore della conformità: Approvazione obbligatoria per gli articoli relativi ad argomenti regolamentati (prezzi, termini legali, privacy dei dati).
Segnali di affidabilità da implementare subito
- Log di audit che registrano ogni azione di creazione, modifica, approvazione e ritiro con data e ora e ID utente.
- Cronologia delle versioni con visualizzazioni delle differenze, così ogni modifica può essere revisionata.
- Changelog associati a ogni articolo che mostrano cosa è cambiato e perché.
- Indicatori di approvazione visibili nell’area di amministrazione della KB, così il team può vedere quali contenuti sono autorizzati o meno per l’uso nel chatbot.
- Citazioni delle fonti visualizzate in ogni risposta del chatbot.
Cosa misurare e come agire in base ai segnali
È attraverso il monitoraggio che vengono prese le decisioni sulla manutenzione. Senza metriche, vai a tentativi per capire quali articoli aggiornare. Con le metriche, ogni settimana hai una coda di lavoro ordinata per priorità.
Metriche chiave da monitorare:
- Accuratezza/correttezza delle risposte: Percentuale di risposte del chatbot che corrispondono alla risposta canonica in un set di test campionato.
- Tasso di grounding: Percentuale di risposte che citano uno specifico blocco di origine. Una diminuzione indica un deterioramento del retriever o contenuti mancanti.
- Tasso di deflection: Percentuale di conversazioni risolte senza il coinvolgimento di un Utente. L’aumento delle escalation spesso riconduce a una specifica lacuna della KB.
- Tasso di escalation: Inverso del deflection; monitoralo per categoria di argomento per individuare le aree di contenuto che richiedono attenzione.
- Tempo di aggiornamento: Quanto tempo serve per passare dall’identificazione di una lacuna alla pubblicazione di una correzione verificata.
- CSAT del bot: Punteggio di soddisfazione del cliente specificamente per le conversazioni gestite dal chatbot.
- Incidenti di allucinazione: Numero di casi confermati in cui il bot ha prodotto una risposta fattualmente errata e non basata su alcuna fonte.
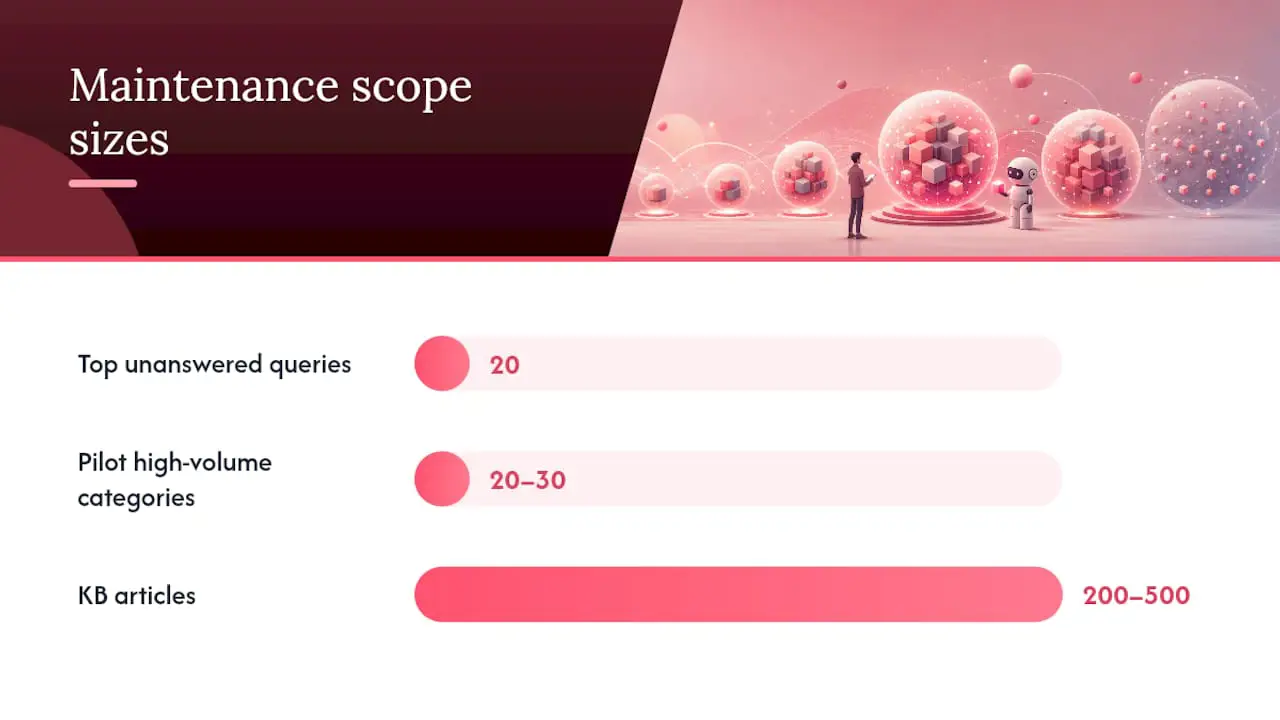
L’uso più pratico dei log consiste nel generare ogni settimana un elenco delle 20 domande principali senza risposta. Ordinale per volume, assegnale a un responsabile dei contenuti e monitora il tempo di chiusura. Questo elenco diventa il backlog di manutenzione.
Modelli di strumenti e checklist di integrazione
Gli strumenti giusti rendono ripetibile il playbook precedente senza richiedere un impegno manuale straordinario. Quando valuti piattaforme e modelli di integrazione, dai priorità a queste funzionalità:
- Indicizzazione incrementale: Il sistema può aggiornare singoli blocchi senza reindicizzare l’intera KB. È fondamentale per le KB di grandi dimensioni, dove la reindicizzazione completa è lenta e costosa.
- Aggiornamento degli embedding: Possibilità di rigenerare gli embedding per gli articoli aggiornati senza modificare i contenuti invariati.
- Provenienza e supporto alle citazioni: Ogni blocco recuperato include un riferimento alla fonte che viene mostrato nella risposta.
- Controllo degli accessi basato sui ruoli: Responsabili dei contenuti, approvatori e ingegneri ML hanno autorizzazioni diverse. La piattaforma deve applicarle.
- Log di audit: Ogni evento di indicizzazione, modifica dei contenuti e approvazione viene registrato con data e ora e utente.
- Webhook per la gestione dei ticket: Quando un ticket viene risolto, un webhook può attivare una revisione della KB o creare automaticamente una bozza di articolo candidato. In questo modo si chiude il ciclo tra operazioni di supporto e manutenzione della conoscenza.
- SSO: L’SSO di Google e Microsoft riduce gli ostacoli per i team che utilizzano già questi ecosistemi.
Modelli di integrazione efficaci in produzione
Sincronizzazione diretta della KB: La piattaforma KB invia gli articoli aggiornati al database vettoriale secondo una pianificazione o al momento della pubblicazione. È semplice, affidabile e rappresenta il punto di partenza giusto per la maggior parte dei team.
Indicizzazione in sandbox di staging: I contenuti nuovi o aggiornati vengono indicizzati prima in un ambiente di staging. La suite di test viene eseguita sullo staging prima che qualsiasi modifica raggiunga la produzione. È l’equivalente di una pipeline CI per i contenuti della knowledge base.
Pipeline di validazione simili alla CI: Tratta le modifiche alla KB come modifiche al codice. Un aggiornamento dei contenuti attiva un’esecuzione automatica dei test sul set di 20-30 richieste. Gli errori bloccano la pubblicazione. I test superati vengono inviati all’approvatore per l’approvazione finale.
Principali compromessi da comprendere
RAG è l’architettura giusta per la maggior parte dei team di supporto che gestiscono conoscenze soggette a frequenti cambiamenti. Aggiorni i documenti, non i pesi del modello, mantenendo sotto controllo i costi e brevi i cicli di aggiornamento. Il fine-tuning è adatto a domini statici e altamente specializzati, nei quali il vocabolario e i modelli di ragionamento sono stabili. La differenza nei costi operativi è significativa: un aggiornamento RAG consiste nella modifica di un documento e nella reindicizzazione; un ciclo di fine-tuning richiede dati etichettati, tempo di calcolo e una valutazione completa del modello prima della distribuzione.
Per quanto riguarda il compromesso tra latenza e aggiornamento, aggiornamenti più frequenti degli embedding mantengono le risposte attuali ma aumentano i costi di calcolo. Scegli una pianificazione degli aggiornamenti in base alla frequenza con cui cambiano i materiali di origine ed esegui la validazione dopo gli aggiornamenti importanti.
Come Deskhero si adatta a questo playbook di manutenzione
Deskhero è basato sul principio secondo cui un chatbot dovrebbe rispondere solo utilizzando conoscenze esplicitamente approvate, che corrisponde direttamente alle fasi di governance e validazione descritte in questo playbook.
Ecco come le fasi specifiche del playbook si collegano alle funzionalità di Deskhero:
- Risposte basate esclusivamente sulla conoscenza approvata: Il chatbot IA di Deskhero risponde utilizzando contenuti FAQ pubblici approvati. Le altre conoscenze dell’area di lavoro non vengono utilizzate per le risposte del chatbot rivolte ai clienti. Per abilitare il chatbot sono necessari almeno 100 elementi FAQ pubblici approvati.
- Suggerimenti FAQ dai ticket risolti: I ticket risolti e le pagine web acquisite possono essere trasformati in voci FAQ candidate. Un Utente esamina e approva una voce prima che possa essere resa disponibile al chatbot.
- Ambiti di conoscenza separati: La knowledge base interna può contribuire ai suggerimenti di risposta IA per gli Utenti. Le risposte del chatbot rivolte ai clienti utilizzano solo le FAQ pubbliche approvate.
- Sincronizzazione e-mail bidirezionale: Le domande dei clienti arrivano tramite e-mail, modulo o chatbot e diventano ticket in una casella di posta condivisa. Le risposte possono essere inviate dall’indirizzo collegato dell’azienda.
- Azioni automatiche etichettate: Le azioni automatiche sono etichettate e registrate; l’invio completamente automatico è facoltativo.
- API REST: Deskhero offre un’API REST per le operazioni sui ticket e sull’area di lavoro. Non offre webhook in uscita.
- Interfaccia multilingue: L’interfaccia di Deskhero è disponibile in 14 lingue supportate e il recupero del chatbot può abbinare contenuti FAQ pubblici in diverse lingue.
Deskhero collega le caselle Gmail, Google Workspace o Microsoft 365 a un helpdesk condiviso, consentendo al team di mantenere gli indirizzi e-mail esistenti. La sua IA rivolta ai clienti risponde utilizzando contenuti FAQ pubblici approvati e trasferisce le domande senza risposta a un operatore umano. I suggerimenti FAQ possono essere creati a partire dai ticket risolti e dalle pagine web acquisite, ma un Utente deve esaminarli prima dell’approvazione. Le azioni automatiche sono etichettate e registrate. La piattaforma include inoltre una knowledge base interna, analisi dei ticket, 14 lingue per l’interfaccia, integrazione con Shopify, SSO di Google e Microsoft e un’API REST. Inizia con una prova gratuita di 30 giorni, senza carta di credito.
Poiché il chatbot di Deskhero è limitato alle FAQ pubbliche approvate, l’attività di manutenzione è concreta: esamina le domande senza risposta, migliora o aggiungi voci FAQ, approvale e verifica che la conoscenza aggiornata risponda alle domande previste.
Per approfondire il modo in cui i chatbot IA gestiscono le escalation e il passaggio a un operatore umano in questo tipo di flusso di lavoro, la guida al passaggio del chatbot a un operatore umano illustra in dettaglio i modelli operativi.
Cadenza di manutenzione, personale e considerazioni sui costi
È nella pianificazione delle persone e del tempo necessari per gestire la conoscenza del chatbot che la maggior parte dei team sottovaluta il lavoro. La buona notizia è che un piccolo team con una cadenza chiara può mantenere una KB in produzione senza personale dedicato.
Cadenze consigliate:
- Settimanale: Esamina i log delle conversazioni, estrai l’elenco delle 20 domande principali senza risposta, segnala le lacune urgenti nei contenuti e invia le correzioni ad alta priorità attraverso il passaggio di approvazione.
- Mensile: Esegui un ciclo completo di aggiornamento dei contenuti. Scrivi nuovi articoli, aggiorna le policy o i prodotti modificati, ritira i contenuti obsoleti ed esegui la suite completa di test.
- Trimestrale: Esegui la revisione delle modifiche alle policy e ai prodotti, l’ottimizzazione del retriever, la valutazione del modello di embedding e un audit di governance (tutti gli articoli sono approvati e versionati correttamente?).
Modello minimo di personale per i piccoli team:
- Responsabile della conoscenza: Gestisce il calendario editoriale, esegue gli audit, applica gli standard e amministra la coda di approvazione. Il tempo necessario dipende dal volume dei contenuti e dalla frequenza delle modifiche.
- Supporto tecnico: Gestisce i parametri di suddivisione, gli aggiornamenti degli embedding, la configurazione del recupero e la manutenzione della suite di test quando il team gestisce autonomamente il proprio stack di recupero.
- Esperti della materia a rotazione: Ogni area di prodotto o policy ha un responsabile dei contenuti designato, che esamina e approva gli articoli del proprio ambito. In genere si tratta di una responsabilità part-time aggiunta a un ruolo esistente.
Fattori di costo da stimare:
- I costi di archiviazione e interrogazione del database vettoriale crescono in base alle dimensioni della KB e al volume delle richieste.
- La frequenza di aggiornamento degli embedding influisce sui costi di calcolo; aggiorna quindi i contenuti modificati quando la piattaforma supporta gli aggiornamenti incrementali.
- Il tempo dedicato alla revisione umana può rappresentare un costo considerevole, soprattutto quando prodotti o policy cambiano frequentemente.
- I costi degli abbonamenti agli strumenti variano in base alla piattaforma. Le piattaforme che integrano gestione della KB, ticketing e chatbot in un unico abbonamento (anziché richiedere database vettoriale, API LLM e strumenti di helpdesk separati) riducono sia i costi sia la complessità dell’integrazione.
La ricerca sull’IA generativa nell’assistenza clienti ha rilevato aumenti di produttività in un contesto reale di supporto. Considera questi risultati come un riferimento e non come una formula per il dimensionamento del personale, poiché costi e vantaggi della manutenzione della conoscenza dipendono dal team, dai contenuti e dagli strumenti.
Avviare un progetto pilota con un ambito a basso costo: Inizia con 20-30 categorie di domande ad alto volume. Crea e mantieni prima questi articoli. Verifica che la qualità delle risposte migliori prima di ampliare la KB. In questo modo mantieni ridotto il carico iniziale di manutenzione e accresci la fiducia interna nel processo.
Come validare nuove fonti di conoscenza prima dell’integrazione
Non tutti i documenti che sembrano utili appartengono all’indice del chatbot. Integrare una fonte di bassa qualità o inesatta peggiora l’intera KB, perché il retriever non è in grado di distinguere un articolo ben documentato da uno scritto male.
Prima di indicizzare, sottoponi ogni fonte candidata ai seguenti controlli:
Controllo dell’accuratezza: Il contenuto riflette il comportamento, la policy o i prezzi attuali del prodotto? Confrontalo con il sistema di riferimento (il tuo CRM, la documentazione del prodotto o i documenti di policy approvati dal team legale). Se non puoi verificare un’affermazione rispetto a una fonte primaria, non indicizzarla.
Controllo dell’ambito: Il contenuto è pertinente alle domande a cui il chatbot dovrebbe rispondere? Un whitepaper generale sul settore può contenere informazioni accurate, ma introdurre rumore nel recupero su argomenti fuori tema. Limita rigorosamente l’ambito dei documenti al tuo caso d’uso.
Controllo della duplicazione: Il contenuto si sovrappone in modo significativo a un articolo KB esistente? I contenuti duplicati creano ambiguità nel recupero. Uniscili o consolidali prima dell’indicizzazione.
Controllo di formato e struttura: Il documento è strutturato in modo che la suddivisione produca passaggi coerenti e autonomi? Un documento con molti riferimenti incrociati (“vedi la sezione 4.2 per i dettagli”) viene suddiviso male, perché i singoli blocchi perdono il contesto. Riscrivilo o ristrutturalo prima dell’indicizzazione.
Controllo della provenienza: Puoi ricondurre il contenuto a una fonte interna o esterna autorevole? Per gli argomenti regolamentati, documenta esplicitamente la fonte nei metadati dell’articolo.
Test in staging: Indicizza la nuova fonte in un ambiente di staging ed esegui il set standard di test composto da 20-30 richieste. Verifica se il nuovo contenuto migliora, peggiora o non influisce sull’accuratezza del recupero. Promuovi solo le fonti che migliorano o mantengono l’accuratezza.
Come usare il feedback degli utenti per perfezionare la conoscenza del chatbot
Il feedback degli utenti è il segnale più diretto disponibile per capire dove la KB non funziona. La difficoltà consiste nel raccoglierlo sistematicamente invece di reagire alle lamentele più rumorose.
Il pulsante pollice su/giù sulle risposte del chatbot è il meccanismo di feedback più semplice. Ogni risposta del chatbot dovrebbe includere un’opzione di valutazione binaria. Aggrega questi dati ogni settimana. Una risposta con un alto tasso di valutazioni negative è un’indicazione diretta per la revisione della KB, indipendentemente dal fatto che al team che l’ha scritta sembrasse corretta.
I sondaggi CSAT dopo la conversazione forniscono un segnale più ampio. Punteggi bassi nelle conversazioni gestite dal bot, filtrati per categoria di argomento, indicano quali aree di contenuto richiedono maggiore attenzione. Abbina i dati CSAT ai log delle escalation per verificare se il problema è una lacuna della KB o un problema di configurazione del retriever.
I cicli di feedback del team di supporto sono preziosi. Gli Utenti che gestiscono le escalation spesso sanno perché il bot ha fallito. Un semplice sistema di tag nello strumento di ticketing, come “risposta errata”, “risposta mancante” o “policy obsoleta”, può trasformare questa esperienza in un segnale strutturato per la manutenzione.
I log espliciti “Non lo so” sono una miniera d’oro. Ogni volta che il chatbot trasferisce una conversazione perché non ha trovato contenuti pertinenti, registra la richiesta. Ordinala per volume ogni settimana. Le richieste principali dell’elenco sono le attività di scrittura a più alta priorità.
I sondaggi periodici agli utenti sulla qualità della KB (inviati ai clienti che hanno interagito con il chatbot negli ultimi 30 giorni) fanno emergere problemi sistemici che le valutazioni delle singole conversazioni non rilevano. Limita il sondaggio a due o tre domande e collega le risposte agli ID delle conversazioni, così puoi ricondurre il feedback ad articoli specifici.
Il ciclo di feedback si chiude quando una richiesta segnalata diventa un articolo KB, l’articolo attraversa il flusso di approvazione e la risposta del chatbot a quella richiesta migliora. Monitorare il tempo di questo ciclo (dalla segnalazione alla correzione) è una delle metriche operative più utili che un responsabile della conoscenza possa gestire.
Cosa imparano realmente i team di supporto usando questo sistema in produzione
Il playbook precedente è corretto in teoria. Ecco cosa si rompe nella pratica e come risolverlo rapidamente.
Inizia in piccolo e dimostra il valore prima di scalare. Indicizzare subito tutti i documenti disponibili può creare una KB sovraccarica e rendere difficile stabilire una baseline di qualità utile. Scegli 20-30 categorie di domande ad alto volume, crea articoli chiari per queste categorie ed esegui il chatbot su questo ambito ristretto. Espandilo dopo che i test hanno dimostrato che le risposte sono accurate e utili.
Gestisci esplicitamente i contenuti con validità temporale. Promozioni, policy stagionali e offerte a tempo limitato possono diventare facilmente obsolete. Crea un tag di metadati separato per i contenuti con validità temporale e imposta, al momento della scrittura, una data obbligatoria per la revisione della scadenza.
Registra e monitora regolarmente le risposte sconosciute. Esaminare frequentemente il log “Non lo so” aiuta i team a individuare le lacune ricorrenti prima che si accumulino. Usa il volume delle richieste e l’impatto sui clienti per stabilire la priorità delle correzioni.
Consiglio: I ticket risolti sono materiale utile per le risposte canoniche perché mostrano come il team ha gestito domande reali. Deskhero utilizza periodicamente i ticket risolti come materiale di origine per i suggerimenti FAQ. Un Utente può esaminare, modificare, approvare o rifiutare ogni suggerimento prima che il contenuto approvato diventi disponibile al chatbot.
Correzioni rapide per i team agli inizi:
- Stabilisci una convenzione per i nomi degli articoli fin dal primo giorno (Area del prodotto: Argomento: Pubblico). Rinominare retroattivamente 200 articoli è complicato.
- Crea un modello di metadati con i campi obbligatori e inseriscilo in ogni nuovo articolo prima della scrittura.
- Costruisci una suite di test con 20-30 richieste reali ricavate dai primi log delle conversazioni ed eseguila prima di ogni distribuzione in produzione.
Deskhero rende operativo il playbook di manutenzione fin dal primo giorno
Eseguire questo playbook su strumenti separati può creare ulteriore lavoro di coordinamento. Deskhero riunisce nello stesso helpdesk il flusso di revisione delle FAQ pubbliche, i suggerimenti FAQ e le conversazioni con i clienti.
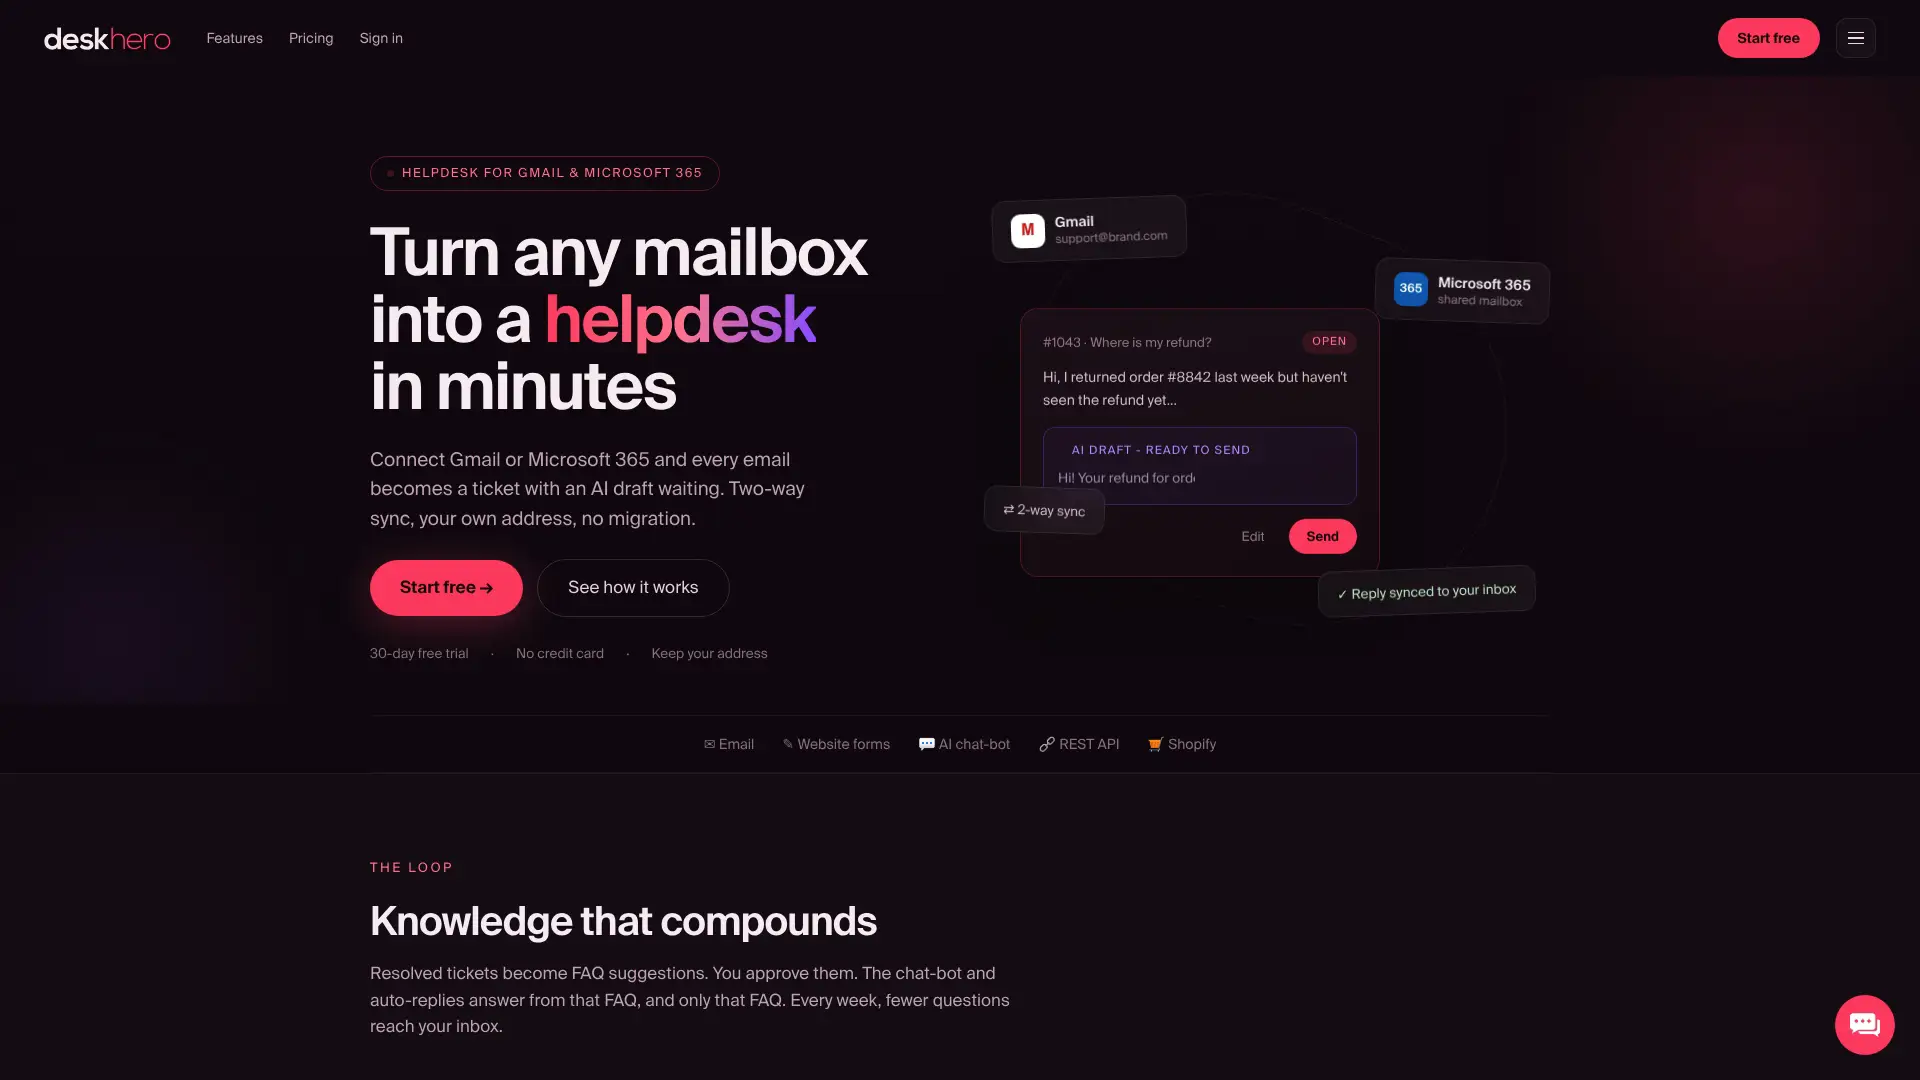
Il chatbot risponde solo utilizzando contenuti FAQ pubblici approvati, mentre i suggerimenti di risposta IA per gli Utenti possono attingere a una knowledge base più ampia dell’area di lavoro. I suggerimenti FAQ ricavati dai ticket risolti e dalle pagine web acquisite riducono il lavoro necessario per creare contenuti da zero, ma richiedono comunque una revisione umana. L’integrazione bidirezionale delle caselle di posta mantiene collegati ticket e risposte all’indirizzo già utilizzato dal team.
Per i team che desiderano questo flusso senza assemblare uno stack di recupero personalizzato, Deskhero combina casella di posta condivisa, FAQ pubbliche, chatbot e passaggio a un operatore umano. Avvia una prova gratuita di 30 giorni su Deskhero, senza carta di credito.
Fonti
Usale come riferimenti per l’implementazione quando prendi decisioni tecniche sulla strategia di suddivisione, sull’approccio all’addestramento, sulla policy di governance e sulla configurazione delle misurazioni.
FAQ
Che cos’è una knowledge base per chatbot?
Una knowledge base per chatbot è un insieme curato di documenti di origine, suddivisi in passaggi, convertiti in embedding vettoriali e archiviati in un database vettoriale, così che un retriever possa estrarre i contenuti più pertinenti al momento della richiesta e basare le risposte del chatbot sui tuoi contenuti effettivi.
Come si mantiene un chatbot nel tempo?
Esegui un ciclo ripetibile: analizza i log delle conversazioni per individuare le lacune, aggiorna o scrivi articoli canonici, suddividi e crea gli embedding in un ambiente di staging, valida il risultato con un set di test da 20-30 richieste, ottieni l’approvazione, pubblica in produzione e monitora la qualità delle risposte e i passaggi a un operatore per individuare eventuali regressioni.
Cosa non si dovrebbe mai dire a un chatbot?
Evita di inserire dati personali sensibili (numeri di previdenza sociale, password, dati di conti finanziari) in qualsiasi interfaccia di chatbot, poiché gli input potrebbero essere registrati o utilizzati nell’addestramento del modello, a seconda della policy di gestione dei dati della piattaforma. Per la scrittura della KB interna, non inserire mai dati dinamici (prezzi, inventario) che una pipeline di acquisizione può recuperare direttamente dal sistema di riferimento.
Quanto costa mantenere un chatbot?
I costi principali sono il tempo dedicato alle revisioni, il calcolo per il recupero e la generazione degli embedding quando questi componenti sono gestiti direttamente e gli eventuali abbonamenti a helpdesk o piattaforme di knowledge base. Stimali in base al volume dei contenuti, al volume delle richieste, alla frequenza degli aggiornamenti e alla quantità di revisione umana necessaria.