Så underhåller du chatbotens kunskap: en praktisk guide
Underhåll chatbotens kunskap som en återkommande, rollbaserad process: granska → uppdatera → validera → publicera → avveckla. Denna femstegscykel, som genomförs enligt en förutsägbar tidsplan med tydligt ägarskap vid varje kontrollpunkt, är det som skiljer en chatbot som vinner kundernas förtroende från en som i det tysta urholkar det.
Här är den korta checklista ditt team behöver innan något annat:
- Källhygien: Ta bort inaktuella, duplicerade eller motstridiga dokument innan de når indexet.
- Chunkning och indexering: Börja med textsegment på 500 till 1 000 tecken och justera sedan storleken baserat på hämtningstester.
- Finjustering av hämtaren: Testa och justera likhetströsklar kvartalsvis så att precisionen förblir hög när kunskapsbasen växer.
- Godkännandeflöde: Varje ny eller redigerad artikel behöver godkännas innan den blir aktiv i chatboten.
- Övervakningsmått: Följ regelbundet upp svarskvalitet, olösta frågor och överlämningar.
- Återställning och versionshantering: Behåll en ändringslogg så att alla felaktiga uppdateringar kan återställas inom några minuter.
Vem äger vad: Innehållsägare skriver och uppdaterar artiklar. En kunskapsförvaltare upprätthåller standarder och genomför granskningar. En tekniskt ansvarig hanterar chunkning, embeddingar och inställningar för hämtning när teamet ansvarar för dessa komponenter. En granskare kör testuppsättningar före varje publicering. Efterlevnadsspecialister granskar innehåll som omfattar reglerade ämnen.
Viktigaste slutsatserna
Att underhålla chatbotens kunskap kräver en återkommande cykel från granskning till avveckling, tydligt ägarskap och regelbunden övervakning för att upptäcka luckor innan kunderna gör det.
| Punkt | Detaljer |
|---|---|
| Använd cykeln från granskning till avveckling | Genomför granska → uppdatera → validera → publicera → avveckla varje vecka, månad eller kvartal för att förhindra att kunskapsbasen gradvis blir inaktuell. |
| Testa segmentstorleken | Börja med hämtningstextsegment på 500 till 1 000 tecken och justera baserat på testresultaten. |
| Följ användbara kvalitetssignaler | Övervaka svarens korrekthet, olösta frågor, överlämningar och bekräftat felaktiga svar. Definiera sedan tröskelvärden som passar er tjänst. |
| Utse en kunskapsförvaltare | Ge en person tydligt ansvar för redaktionens kalender, granskningskön och underhållsplanen. |
| Deskhero säkerställer svar baserade på godkänd kunskap | Deskheroes chatbot svarar endast utifrån godkänt offentligt FAQ-innehåll och föreslår FAQ-kandidater från lösta ärenden och inskrapade webbsidor. |
Innehållsförteckning
- Vad är en kunskapsbas för en chatbot och hur används den för att skapa svar?
- Varför kontinuerligt underhåll är viktigt för chatbotens träffsäkerhet
- Steg-för-steg: operativ handbok för att underhålla chatbotens kunskap
- Standarder, mallar och styrning som håller svaren tillförlitliga
- Vad du ska mäta och hur du agerar utifrån signalerna
- Verktygsmönster och integrationschecklista
- Så passar Deskhero in i denna underhållshandbok
- Underhållsplan, bemanning och kostnadsöverväganden
- Så validerar du nya kunskapskällor före integration
- Så använder du användarfeedback för att förbättra chatbotens kunskap
- Vad supportteam faktiskt lär sig när detta körs i produktion
- Deskhero gör underhållshandboken operativ från dag ett
- Källor
- Vanliga frågor
Vad är en kunskapsbas för en chatbot och hur används den för att skapa svar?
En kunskapsbas för en chatbot (KB) är inte bara en mapp med hjälpartiklar. Den är ett kurerat flöde: källdokument passerar genom ett chunkningssteg, varje textsegment omvandlas till en numerisk vektor (en embedding), vektorerna lagras i en vektordatabas och en hämtare väljer de mest relevanta segmenten när en fråga ställs. Språkmodellen sammanställer sedan ett svar utifrån de hämtade segmenten, förankrat i ert faktiska innehåll i stället för modellens grundläggande träningsdata.
Många AI-drivna kunskapschatbotar använder ett hämtningsflöde med textsegment, embeddingar, en vektordatabas, en hämtare och en språkmodell. System som behåller källreferenser gör det enklare att granska ett svar och spåra det tillbaka till materialet som användes.
De centrala komponenterna i ett välbyggt KB-flöde:
- Källdokument: KB-artiklar, lösta ärenden, PDF-filer, webbsidor och policydokument.
- Metadata: Taggar för ämne, produktområde, målgrupp, senast uppdaterad och författare.
- Embeddingar: Täta vektorrepresentationer av varje textsegment, genererade av en embeddingmodell.
- Vektordatabas: Lagrar och indexerar embeddingar för snabb semantisk sökning (Pinecone, Weaviate, pgvector och liknande verktyg).
- Hämtare: Skickar frågor till vektordatabasen och returnerar de N mest relevanta textsegmenten.
- LLM och systemprompter: Sammanställer de hämtade segmenten till ett svar på naturligt språk, begränsat av era instruktioner.
- Citeringslager: Kopplar källreferenser till varje svar så att Users och kunder kan verifiera det.
Experttips: Håll varje artikel fokuserad på ett tydligt ämne. Dela upp dokument som besvarar flera orelaterade frågor. Segmentstorleken spelar också roll: börja med 500 till 1 000 tecken och justera utifrån testresultaten. För små segment kan förlora sammanhang, medan för stora segment kan dölja den relevanta meningen.
Varför kontinuerligt underhåll är viktigt för chatbotens träffsäkerhet
En chatbot som tränas en gång och sedan lämnas åt sig själv försämras. Produkter ändras, policyer uppdateras, priser förändras och KB:n hamnar obemärkt efter. Chatboten fortsätter att svara utifrån inaktuella uppgifter, och kunderna märker det innan teamet gör det.
Att hålla KB:n aktuell kan förbättra svarskvaliteten och hjälpa fler kunder att lösa rutinfrågor utan en överlämning. En konsekvent ton och godkända formuleringar kan också minska undvikbara fel. Nya Users får en tydligare referenspunkt när KB:n behandlas som den auktoritativa källan. Resultaten beror fortfarande på innehållets kvalitet, distributionens omfattning och hur chatboten är konfigurerad.
Riskerna med att försumma underhållet är lika tydliga:
- Inaktuella svar: En chatbot som hänvisar till en utgången produkt eller en gammal returpolicy skadar omedelbart trovärdigheten.
- Motstridigt innehåll: Två artiklar som ger olika svar på samma fråga förvirrar hämtaren och leder till inkonsekventa svar.
- Risk för hallucinationer: När hämtaren inte hittar något relevant hittar ett dåligt konfigurerat system på ett svar. En välunderhållen KB minskar detta tomrum.
- Efterlevnadsrisk: I reglerade branscher kan ett inaktuellt policysvar skapa allvarliga gransknings- och efterlevnadsproblem.
- Urholkat förtroende: Kunder som får fel svar två gånger ger sällan boten en tredje chans.
Steg-för-steg: operativ handbok för att underhålla chatbotens kunskap
Detta är ett återanvändbart arbetsflöde som teamet kan anpassa till en intern SOP. Bestäm en praktisk plan för loggranskning, innehållsuppdateringar och hämtningstester och anpassa den sedan efter hur ofta era produkter och policyer förändras.
-
Planera granskningen. Hämta konversationsloggarna från föregående period. Markera frågor med låga konfidenspoäng, eskaleringar och reservsvar som säger ”jag vet inte”. Detta är era luckor med högst prioritet.
-
Identifiera saknat och inaktuellt innehåll. Jämför de markerade frågorna med befintliga KB-artiklar. Markera artiklar som hänvisar till utgångna funktioner, gamla priser eller avslutade kampanjer för omedelbar uppdatering eller avveckling.
-
Skriv eller uppdatera auktoritativa svar. Skriv en artikel per ämne. Använd ett kundorienterat språk, inte intern jargong. Obligatoriska fält: ämnesrubrik, omfattning (vilken produkt/plan den gäller), avsedd målgrupp, författare, senast uppdaterad och godkännandestatus.
-
Chunk:a och skapa embeddingar. Börja med att dela upp uppdaterade artiklar i segment på 500 till 1 000 tecken. Lägg till metadatataggar (ämne, produkt, språk, målgrupp). Kör segmenten genom embeddingmodellen och läs in dem i vektordatabasen i en stagingmiljö, inte i produktion.
-
Genomför valideringstester i staging. Använd en testuppsättning med 20 till 30 verkliga frågor från loggarna. Kontrollera att varje fråga hämtar rätt segment och att det genererade svaret överensstämmer med det auktoritativa svaret. Sätt en godkänd tröskel för hämtningsprecision innan ändringen flyttas till produktion.
-
Publicera med en godkännandekontroll. En utsedd godkännare (kunskapsförvaltare eller teamledare) granskar testresultaten och godkänner. Logga publiceringen med tidsstämpel, författare och versionsnummer.
-
Övervaka efter publicering. Följ noga upp svarskvalitet och överlämningar efter varje större uppdatering. Om ett mått sjunker eller granskningar hittar felaktiga svar ska ändringen återställas med hjälp av versionshistoriken.
-
Avveckla inaktuellt innehåll. Arkivera i stället för att radera så att versionshistoriken bevaras. Uppdatera alla artiklar som hänvisade till det avvecklade innehållet.
Experttips: Kräv, när plattformen stöder det, källreferenser för faktabaserade svar. Kombinera detta med en uttrycklig reservinstruktion: om hämtningen inte ger något tillräckligt relevant innehåll ska chatboten säga att den inte kan svara och erbjuda en mänsklig överlämning i stället för att gissa.
Experttips: Kvalitet slår kvantitet i varje steg. Fem till tio välskrivna och fokuserade dokument skapar en mer kapabel assistent än femtio löst strukturerade dokument. Rensa aggressivt innan du indexerar.
Standarder, mallar och styrning som håller svaren tillförlitliga
God styrning är inte byråkrati för byråkratins egen skull. Ett människocentrerat förhållningssätt till AI börjar med behoven och välmåendet hos de människor som påverkas av systemet. För en kundinriktad chatbot gör dokumenterade godkännanden, versionshistorik och ändringsanteckningar granskning och ansvarsskyldighet praktiska.
Redaktionella standarder som varje artikel måste uppfylla
- Ett ämne, ett svar. Ingen artikel behandlar mer än en avgränsad fråga.
- Kundvänligt språk. Skriv på det sätt en kund skulle fråga, inte på det sätt en ingenjör skulle dokumentera.
- Obligatoriska fält: Ämnesrubrik, omfattning, målgrupp, författare, senast uppdaterad, godkännandestatus, versionsnummer och en kort ändringsanteckning.
- Inga duplicerade uppgifter. Om ett inläsningsflöde redan hämtar aktuella priser från ert system of record ska priset inte hårdkodas i en KB-artikel. Det blir inaktuellt.
- Proaktiv loggranskning. Granska konversationsloggar enligt en fast plan för att hitta luckor innan kunderna rapporterar dem.
Styrningsroller
- Innehållsägare: Ämnesexpert som skriver och uppdaterar artiklar inom sitt område.
- Kunskapsförvaltare: Upprätthåller standarder, genomför granskningar, hanterar artikelns livscykel och äger redaktionens kalender.
- Godkännare: Teamledare eller chef som godkänner innan en artikel blir aktiv.
- ML-ansvarig: Hanterar chunkningsparametrar, uppdateringar av embeddingmodellen, hämtarkonfiguration och underhåll av testuppsättningen.
- Efterlevnadsgranskare: Obligatoriskt godkännande för artiklar som berör reglerade ämnen (priser, juridiska villkor och dataskydd).
Förtroendesignaler att införa nu
- Granskningsloggar som registrerar varje skapande-, redigerings-, godkännande- och avvecklingsåtgärd med tidsstämpel och användar-ID.
- Versionshistorik med diff-vyer så att varje ändring kan granskas.
- Ändringsloggar kopplade till varje artikel som visar vad som ändrades och varför.
- Godkännandestämplar som visas i KB-administrationen så att teamet kan se vad som är godkänt för chatbotanvändning.
- Källhänvisningar som visas i varje chatbot-svar.
Vad du ska mäta och hur du agerar utifrån signalerna
Det är genom övervakning som underhållsbesluten fattas. Utan mätvärden gissar ni vilka artiklar som ska uppdateras. Med mätvärden får ni varje vecka en prioriterad arbetskö.
Viktiga mätvärden att följa:
- Svarsprecision / korrekthet: Andelen chatbot-svar som överensstämmer med det auktoritativa svaret i en testuppsättning.
- Förankringsgrad: Andelen svar som hänvisar till ett specifikt källsegment. En minskning signalerar att hämtaren glider eller att innehåll saknas.
- Avlastningsgrad: Andelen konversationer som löses utan User-inblandning. Ökande eskaleringar kan ofta spåras till en specifik KB-lucka.
- Eskaleringgrad: Motsatsen till avlastningsgrad; följ den per ämneskategori för att hitta vilka innehållsområden som behöver uppmärksamhet.
- Tid till uppdatering: Hur lång tid det tar från att en lucka identifieras tills en verifierad lösning publiceras.
- CSAT för boten: Kundnöjdhet specifikt för konversationer som hanterats av chatboten.
- Hallucinationsincidenter: Antalet bekräftade fall där boten gav ett sakligt felaktigt svar som inte var förankrat i någon källa.
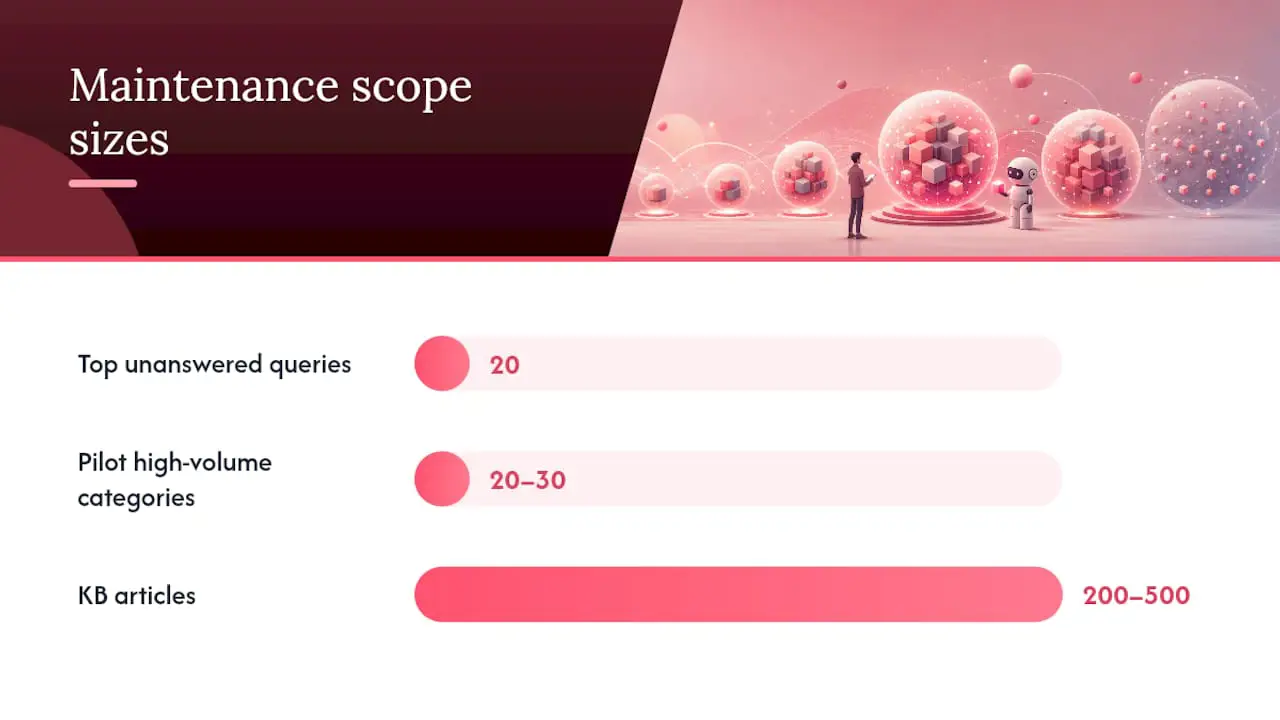
Den mest praktiska användningen av loggar är att varje vecka skapa en lista över de 20 vanligaste obesvarade frågorna. Sortera efter volym, tilldela varje fråga till en innehållsägare och följ upp tiden till lösning. Listan blir er underhållsbacklogg.
Verktygsmönster och integrationschecklista
Rätt verktyg gör handboken ovan återanvändbar utan heroiska manuella insatser. När ni utvärderar plattformar och integrationsmönster bör ni prioritera följande funktioner:
- Inkrementell indexering: Systemet kan uppdatera enskilda segment utan att indexera om hela KB:n. Detta är avgörande för stora KB:er där fullständig omindexering är långsam och dyr.
- Uppdatering av embeddingar: Möjlighet att skapa nya embeddingar för uppdaterade artiklar utan att röra oförändrat innehåll.
- Ursprung och stöd för citeringar: Varje hämtat segment innehåller en källreferens som visas i svaret.
- Rollbaserad åtkomstkontroll: Innehållsägare, godkännare och ML-ingenjörer har olika behörigheter. Plattformen måste upprätthålla detta.
- Granskningsloggar: Varje indexeringshändelse, innehållsändring och godkännande loggas med tidsstämpel och användare.
- Webhooks för ärendehantering: När ett ärende löses kan en webhook utlösa en KB-granskning eller automatiskt skapa ett utkast till en kandidatartikel. Detta sluter cirkeln mellan supportverksamhet och kunskapsunderhåll.
- SSO: Google- och Microsoft-SSO minskar friktionen för team som redan använder dessa ekosystem.
Integrationsmönster som fungerar i produktion
Direktsynkronisering av KB: KB-plattformen skickar uppdaterade artiklar till vektordatabasen enligt ett schema eller vid publicering. Enkelt, tillförlitligt och rätt startpunkt för de flesta team.
Indexerad stagingmiljö: Nytt eller uppdaterat innehåll indexeras först i en stagingmiljö. Testsviten körs mot staging innan någon ändring når produktionen. Detta motsvarar en CI-pipeline för kunskapsinnehåll.
CI-liknande valideringsflöden: Behandla KB-ändringar som kodändringar. En innehållsuppdatering utlöser en automatiserad testkörning mot testuppsättningen med 20 till 30 frågor. Fel stoppar publiceringen. Godkända resultat skickas vidare till godkännaren för slutligt godkännande.
Viktiga avvägningar att förstå
RAG är rätt arkitektur för de flesta supportteam med kunskap som förändras ofta. Ni uppdaterar dokument, inte modellvikter, vilket håller kostnaderna hanterbara och uppdateringscyklerna korta. Finjustering passar för statiska, mycket specialiserade områden där vokabulär och resonemangsmönster är stabila. Skillnaden i driftskostnad är betydande: en RAG-uppdatering är en dokumentredigering och en omindexering, medan en finjusteringscykel kräver märkta data, beräkningstid och en fullständig modellevaluering före driftsättning.
När det gäller avvägningen mellan svarstid och aktualitet håller tätare uppdateringar av embeddingar svaren aktuella, men de ökar beräkningskostnaden. Välj uppdateringsschema utifrån hur ofta källmaterialet förändras och kör validering efter viktiga uppdateringar.
Så passar Deskhero in i denna underhållshandbok
Deskhero bygger på principen att en chatbot endast ska svara utifrån kunskap som ni uttryckligen har godkänt. Det kopplar direkt till styrnings- och valideringsstegen i denna handbok.
Så kopplas specifika steg i handboken till funktioner i Deskhero:
- Svar baserade enbart på godkänd kunskap: Deskheroes AI-chatbot svarar utifrån godkänt offentligt FAQ-innehåll. Annan arbetsplatskunskap används inte för kundinriktade chatbot-svar. För att aktivera chatboten krävs minst 100 godkända offentliga FAQ-poster.
- FAQ-förslag från lösta ärenden: Lösta ärenden och inskrapade webbsidor kan omvandlas till föreslagna FAQ-poster. En User granskar och godkänner en post innan den kan göras tillgänglig för chatboten.
- Separata kunskapsomfattningar: Den interna kunskapsbasen kan användas för AI-förslag på svar till Users. Kundinriktade chatbot-svar använder endast den godkända offentliga FAQ:n.
- Tvåvägssynkronisering av e-post: Kundfrågor kommer in via e-post, formulär eller chatbot och blir ärenden i en gemensam inkorg. Svar kan skickas från företagets anslutna adress.
- Märkta automatiska åtgärder: Automatiska åtgärder märks och loggas, och helt automatiskt utskick är ett frivilligt alternativ.
- REST API: Deskhero tillhandahåller ett REST API för ärende- och arbetsplatsåtgärder. Det tillhandahåller inte utgående webhooks.
- Flerspråkigt gränssnitt: Deskheroes gränssnitt finns på 14 språk, och chatbotens hämtning kan matcha offentligt FAQ-innehåll på olika språk.
Deskhero ansluter Gmail-, Google Workspace- eller Microsoft 365-brevlådor till en gemensam helpdesk och låter teamet behålla sina befintliga e-postadresser. Den kundinriktade AI:n svarar utifrån godkänt offentligt FAQ-innehåll och lämnar olösta frågor vidare till en människa. FAQ-förslag kan skapas från lösta ärenden och inskrapade webbsidor, men en User måste granska dem innan de godkänns. Automatiska åtgärder märks och loggas. Plattformen innehåller även en intern kunskapsbas, ärendeinsikter, 14 gränssnittsspråk, Shopify-integration, Google- och Microsoft-SSO samt ett REST API. Den börjar med en kostnadsfri provperiod på 30 dagar utan krav på kreditkort.
Eftersom Deskheroes chatbot är begränsad till den godkända offentliga FAQ:n är underhållsuppgiften konkret: granska olösta frågor, förbättra eller lägg till FAQ-poster, godkänn dem och kontrollera om den uppdaterade kunskapen besvarar de avsedda frågorna.
För en djupare genomgång av hur AI-chatbotar hanterar eskalering och mänsklig överlämning i den här typen av arbetsflöde beskriver guiden om mänsklig överlämning från chatbot de operativa mönstren i detalj.
Underhållsplan, bemanning och kostnadsöverväganden
Det är när man planerar människorna och tiden bakom chatbotens kunskapshantering som de flesta team underskattar arbetet. Den goda nyheten är att ett litet team med en tydlig plan kan underhålla en KB i produktion utan särskilt avsatta tjänster.
Rekommenderade intervall:
- Varje vecka: Granska konversationsloggar, ta fram listan över de 20 vanligaste obesvarade frågorna, markera brådskande innehållsluckor och skicka prioriterade korrigeringar genom godkännandekontrollen.
- Varje månad: Genomför en fullständig innehållsuppdatering. Skriv nya artiklar, uppdatera ändrade policyer eller produkter, avveckla inaktuellt innehåll och kör hela testsviten.
- Varje kvartal: Granska policy- och produktförändringar, finjustera hämtaren, utvärdera embeddingmodellen och genomför en styrningsgranskning (är alla artiklar korrekt godkända och versionshanterade?).
Minimal bemanningsmodell för små team:
- Kunskapsförvaltare: Ansvarar för redaktionens kalender, genomför granskningar, upprätthåller standarder och hanterar godkännandekön. Tidsåtgången beror på innehållsvolymen och hur ofta ändringar görs.
- Teknisk support: Hanterar chunkningsparametrar, uppdateringar av embeddingar, hämtningskonfiguration och underhåll av testsviten när teamet driver sin egen hämtningsstack.
- Roterande ämnesexperter: Varje produkt- eller policyområde har en utsedd innehållsägare som granskar och godkänner artiklar inom sitt område. Detta är vanligtvis ett deltidsansvar som läggs till en befintlig roll.
Kostnadsdrivare att uppskatta:
- Lagrings- och frågekostnader för vektordatabasen ökar med KB:ns storlek och frågevolymen.
- Hur ofta embeddingar uppdateras påverkar beräkningskostnaden, så uppdatera förändrat innehåll när plattformen stöder inkrementella uppdateringar.
- Tiden för mänsklig granskning kan vara en betydande kostnad, särskilt när produkter eller policyer ändras ofta.
- Kostnaderna för verktygsabonnemang varierar mellan plattformar. Plattformar som samlar KB-hantering, ärendehantering och chatbot i ett enda abonnemang (i stället för separata verktyg för vektordatabas, LLM API och helpdesk) minskar både kostnad och integrationskomplexitet.
Forskning om generativ AI i kundsupport har visat produktivitetsvinster i en verklig supportsituation. Se resultaten som ett sammanhang snarare än en bemanningsformel, eftersom kostnaden och nyttan med kunskapsunderhåll beror på teamet, innehållet och verktygen.
Pilottesta inom ett kostnadseffektivt område: Börja med 20 till 30 kategorier av frågor med hög volym. Bygg och underhåll dessa artiklar först. Kontrollera att svarskvaliteten förbättras innan KB:n utökas. På så sätt hålls den initiala underhållsbelastningen låg och teamets förtroende för processen byggs upp.
Så validerar du nya kunskapskällor före integration
Alla dokument som ser användbara ut hör inte hemma i chatbotens index. Om en källa av låg kvalitet eller med felaktigheter integreras försämras hela KB:n, eftersom hämtaren inte kan skilja en välunderbyggd artikel från en dåligt skriven.
Kör varje kandidatkälla genom följande kontroller före indexering:
Kontroll av korrekthet: Återspeglar innehållet aktuellt produktbeteende, aktuell policy eller aktuella priser? Jämför med system of record (ert CRM, produktdokumentation eller juridikteamets godkända policydokument). Om ett påstående inte kan verifieras mot en primärkälla ska det inte indexeras.
Omfattningskontroll: Är innehållet relevant för de frågor chatboten förväntas besvara? Ett brett branschdokument kan innehålla korrekt information men skapa brus från irrelevanta hämtningar. Begränsa dokumentens omfattning noggrant till användningsområdet.
Dupliceringskontroll: Överlappar innehållet i stor utsträckning med en befintlig KB-artikel? Duplicerat innehåll skapar oklarhet vid hämtning. Slå ihop eller konsolidera före indexering.
Kontroll av format och struktur: Är dokumentet strukturerat så att chunkning ger sammanhängande, självständiga avsnitt? Ett dokument med många korsreferenser (”se avsnitt 4.2 för detaljer”) chunkas dåligt eftersom enskilda segment förlorar sammanhang. Skriv om eller strukturera om före indexering.
Kontroll av ursprung: Kan innehållet spåras till en auktoritativ intern eller extern källa? För reglerade ämnen ska källan dokumenteras uttryckligen i artikelns metadata.
Stagingtest: Indexera den nya källan i en stagingmiljö och kör den vanliga testuppsättningen med 20 till 30 frågor. Kontrollera om det nya innehållet förbättrar, försämrar eller inte påverkar hämtningsprecisionen. Flytta endast vidare källor som förbättrar eller bibehåller precisionen.
Så använder du användarfeedback för att förbättra chatbotens kunskap
Användarfeedback är den mest direkta signalen om var KB:n brister. Utmaningen är att samla in den systematiskt i stället för att reagera på de mest högljudda klagomålen.
Tummen upp/ner på chatbot-svar är den enklaste feedbackmekanismen. Varje chatbot-svar bör ha ett alternativ för binär betygsättning. Sammanställ dessa varje vecka. Ett svar med hög andel tummen ner är en direkt signal för KB-granskning, oavsett om svaret verkade korrekt för redaktionsteamet.
CSAT-enkäter efter konversationen ger en bredare signal. Låga poäng för konversationer som hanterats av boten, filtrerade efter ämneskategori, visar vilka innehållsområden som behöver mest uppmärksamhet. Kombinera CSAT-data med eskaleringsloggar för att bekräfta om problemet är en KB-lucka eller ett konfigurationsproblem hos hämtaren.
Feedbackloopar från supportteamet är värdefulla. Users som hanterar eskaleringar vet ofta varför boten misslyckades. Ett enkelt märkningssystem i ärendehanteringsverktyget, exempelvis ”felaktigt svar”, ”svar saknas” eller ”inaktuell policy”, kan omvandla erfarenheten till en strukturerad underhållssignal.
Loggar över uttryckliga ”jag vet inte”-svar är en guldgruva. Varje gång chatboten eskalerar eftersom den inte hittade relevant innehåll ska frågan loggas. Sortera efter volym varje vecka. De vanligaste frågorna på listan är era viktigaste skrivuppgifter.
Regelbundna användarundersökningar om KB:ns kvalitet (skickade till kunder som interagerat med chatboten under de senaste 30 dagarna) synliggör systemiska problem som enskilda samtalsbetyg missar. Begränsa enkäten till två eller tre frågor och koppla svaren till konversations-ID:n så att feedbacken kan spåras till specifika artiklar.
Feedbackloopen sluts när en markerad fråga blir en KB-artikel, artikeln går genom godkännandeflödet och chatbotens svar på frågan förbättras. Att följa denna cykeltid (från markering till lösning) är ett av de mest användbara operativa mätvärdena som en kunskapsförvaltare kan äga.
Vad supportteam faktiskt lär sig när detta körs i produktion
Handboken ovan är korrekt i teorin. Här är vad som går sönder i praktiken och hur ni snabbt åtgärdar det.
Börja smått och bevisa värdet innan ni skalar. Att indexera alla tillgängliga dokument samtidigt kan skapa en överlastad KB och göra det svårt att fastställa en användbar kvalitetsnivå. Välj 20 till 30 kategorier av frågor med hög volym, skapa rena artiklar för dessa och kör chatboten inom det begränsade området. Utöka först när tester visar att svaren är korrekta och användbara.
Hantera tidsbegränsat innehåll uttryckligen. Kampanjer, säsongspolicyer och tidsbegränsade erbjudanden kan snabbt bli inaktuella. Skapa en separat metadatatagg för tidsbegränsat innehåll och ange ett obligatoriskt datum för förnyad granskning redan när artikeln skrivs.
Logga och följ regelbundet upp okända svar. Genom att ofta granska ”jag vet inte”-loggen kan team upptäcka återkommande luckor innan de hopar sig. Använd frågevolym och kundpåverkan för att prioritera korrigeringar.
Experttips: Lösta ärenden är användbart källmaterial för auktoritativa svar eftersom de visar hur teamet hanterade verkliga frågor. Deskhero använder regelbundet lösta ärenden som källmaterial för FAQ-förslag. En User kan granska, redigera, godkänna eller avvisa varje förslag innan godkänt innehåll blir tillgängligt för chatboten.
Snabba lösningar för team som precis har börjat:
- Inför en namnstandard för artiklar från dag ett (Produktområde: Ämne: Målgrupp). Att i efterhand döpa om 200 artiklar är smärtsamt.
- Skapa en metadatamall med obligatoriska fält och klistra in den i varje ny artikel innan du börjar skriva.
- Bygg en testsvit med 20 till 30 verkliga frågor från de första konversationsloggarna och kör den före varje produktionspublicering.
Deskhero gör underhållshandboken operativ från dag ett
Att köra denna handbok i separata verktyg kan skapa extra samordningsarbete. Deskhero samlar granskningsflödet för offentliga FAQ:er, FAQ-förslag och kundkonversationer i samma helpdesk.
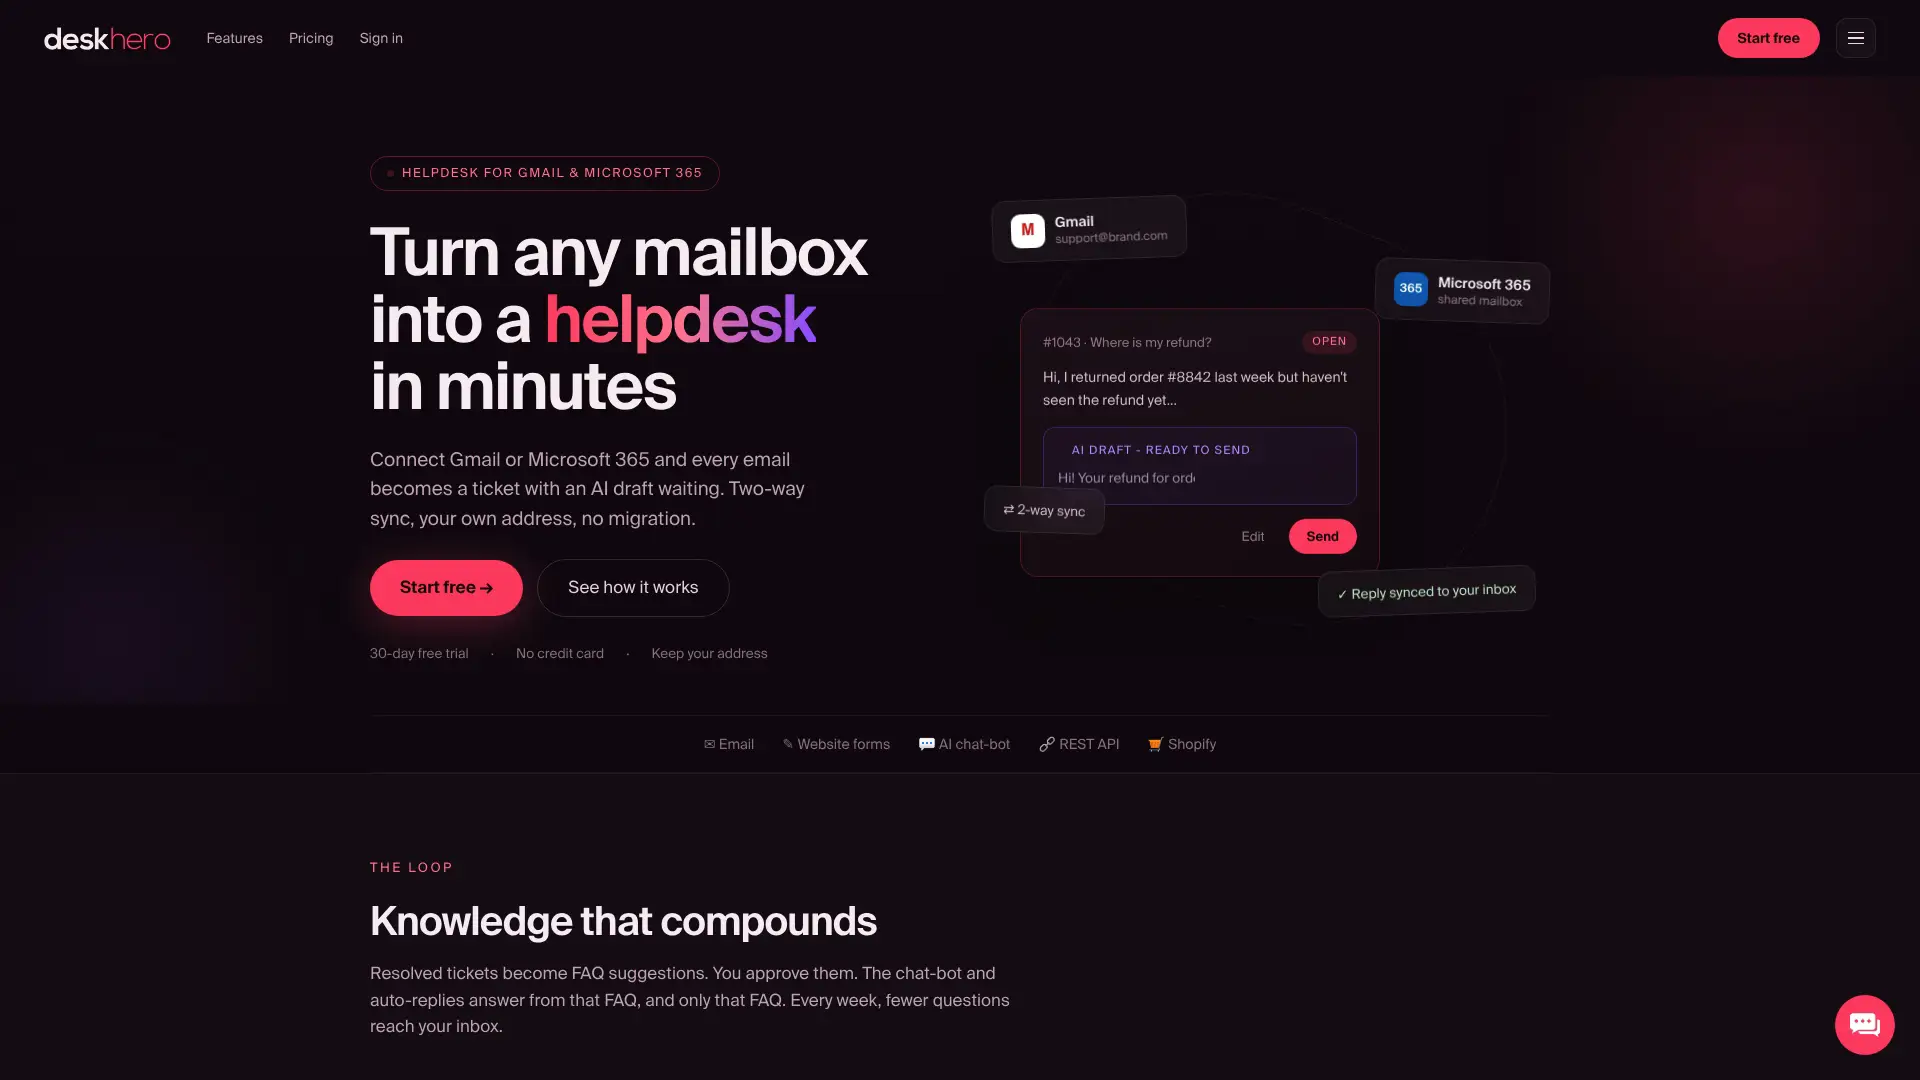
Chatboten svarar endast utifrån godkänt offentligt FAQ-innehåll, medan AI-förslag på svar till Users kan använda bredare arbetsplatskunskap. FAQ-förslag från lösta ärenden och inskrapade webbsidor minskar arbetet med att skriva från grunden, men kräver fortfarande mänsklig granskning. Tvåvägsintegrationen med brevlådor håller ärenden och svar kopplade till teamets befintliga adress.
För team som vill ha detta arbetsflöde utan att bygga en egen hämtningsstack kombinerar Deskhero den gemensamma inkorgen, den offentliga FAQ:n, chatboten och den mänskliga överlämningen. Starta en kostnadsfri provperiod på 30 dagar hos Deskhero, utan krav på kreditkort.
Källor
Använd dessa som implementeringsreferenser när ni fattar tekniska beslut om chunkningsstrategi, träningsmetod, styrningspolicy och mätupplägg.
Vanliga frågor
Vad är en kunskapsbas för en chatbot?
En kunskapsbas för en chatbot är en kurerad uppsättning källdokument som delas upp i textavsnitt, omvandlas till vektorembeddingar och lagras i en vektordatabas, så att en hämtare kan välja det mest relevanta innehållet när en fråga ställs och förankra chatbotens svar i ert faktiska innehåll.
Hur underhåller man en chatbot över tid?
Genomför en återkommande cykel: granska konversationsloggar för att hitta luckor, uppdatera eller skriv auktoritativa artiklar, chunka och skapa embeddingar i en stagingmiljö, validera mot en testuppsättning med 20 till 30 frågor, få godkännarens godkännande, publicera i produktion och övervaka svarskvalitet och överlämningar för försämringar.
Vad ska man aldrig berätta för en chatbot?
Undvik att ange känsliga personuppgifter (personnummer, lösenord och uppgifter om finansiella konton) i ett chatbotgränssnitt, eftersom indata kan loggas eller användas vid modellträning beroende på plattformens policy för datahantering. Vid internt KB-skrivande ska du aldrig hårdkoda aktuell information (priser, lagersaldo) som ett inläsningsflöde kan hämta direkt från system of record.
Vad kostar det att underhålla en chatbot?
De huvudsakliga kostnaderna är granskningstid, beräkningskostnader för hämtning och embeddingar när dessa komponenter hanteras direkt samt eventuella abonnemang för helpdesk eller kunskapsplattform. Uppskatta dem utifrån innehållsvolym, frågevolym, uppdateringsfrekvens och hur mycket mänsklig granskning som krävs.