Comment maintenir les connaissances d’un chatbot : guide pratique
Maintenez les connaissances du chatbot comme un processus récurrent et fondé sur les rôles : auditer → mettre à jour → valider → publier → retirer. Ce cycle en cinq étapes, exécuté selon une cadence prévisible avec des responsabilités clairement définies à chaque étape de contrôle, est ce qui distingue un chatbot qui gagne la confiance des clients d’un chatbot qui l’érode discrètement.
Voici la courte checklist dont votre équipe a besoin avant toute autre chose :
- Hygiène des sources : Supprimez les documents obsolètes, dupliqués ou contradictoires avant qu’ils n’atteignent l’index.
- Segmentation et indexation : Commencez avec des segments de 500 à 1 000 caractères, puis ajustez leur taille en fonction des tests de récupération.
- Réglage du récupérateur : Testez et ajustez les seuils de similarité chaque trimestre afin de maintenir une haute précision à mesure que la base de connaissances s’agrandit.
- Flux d’approbation : Chaque article nouveau ou modifié doit être approuvé avant sa mise en ligne dans le chatbot.
- Indicateurs de suivi : Suivez régulièrement la qualité des réponses, les questions non résolues et les transferts vers un agent.
- Restauration et gestion des versions : Tenez un journal des modifications afin de pouvoir annuler toute mauvaise mise à jour en quelques minutes.
Qui est responsable de quoi : Les responsables de contenu rédigent et mettent à jour les articles. Un responsable des connaissances fait respecter les normes et réalise les audits. Un responsable technique gère la segmentation, les embeddings et les paramètres de récupération lorsque l’équipe administre ces composants. Un réviseur exécute les jeux de tests avant chaque publication. Les spécialistes de la conformité examinent les contenus portant sur des sujets réglementés.
Points clés à retenir
La maintenance des connaissances d’un chatbot nécessite un cycle reproductible allant de l’audit au retrait, des responsabilités clairement définies et un suivi régulier pour détecter les lacunes avant les clients.
| Point | Détails |
|---|---|
| Utiliser le cycle de l’audit au retrait | Exécutez le cycle audit → mise à jour → validation → publication → retrait selon une cadence hebdomadaire/mensuelle/trimestrielle afin d’éviter la dérive de la base de connaissances. |
| Tester la taille des segments | Commencez avec des segments de récupération de 500 à 1 000 caractères et ajustez-les selon les résultats des tests. |
| Suivre les indicateurs de qualité utiles | Surveillez la précision des réponses, les questions non résolues, les transferts et les réponses incorrectes confirmées, puis définissez des seuils adaptés à votre service. |
| Nommer un responsable des connaissances | Confiez à une personne la responsabilité claire du calendrier éditorial, de la file de révision et de la cadence de maintenance. |
| Deskhero impose des réponses fondées sur des connaissances approuvées | Le chatbot de Deskhero répond uniquement à partir du contenu public approuvé de la FAQ et suggère des candidats à la FAQ à partir des tickets résolus et des pages de site web récupérées. |
Table des matières
- Qu’est-ce qu’une base de connaissances de chatbot et comment permet-elle de générer des réponses ?
- Pourquoi la maintenance continue est-elle importante pour la précision d’un chatbot ?
- Guide opérationnel étape par étape pour maintenir les connaissances d’un chatbot
- Normes, modèles et gouvernance qui garantissent la fiabilité des réponses
- Que mesurer et comment agir en fonction des signaux
- Modèles d’outillage et checklist d’intégration
- Comment Deskhero s’intègre à ce guide de maintenance
- Cadence de maintenance, effectifs et considérations de coût
- Comment valider de nouvelles sources de connaissances avant leur intégration
- Comment utiliser les retours des utilisateurs pour affiner les connaissances du chatbot
- Ce que les équipes de support apprennent réellement en exécutant ce processus en production
- Deskhero rend ce guide de maintenance opérationnel dès le premier jour
- Sources
- FAQ
Qu’est-ce qu’une base de connaissances de chatbot et comment permet-elle de générer des réponses ?
Une base de connaissances de chatbot (KB) n’est pas simplement un dossier contenant des articles d’aide. Il s’agit d’un pipeline organisé : les documents sources passent par une étape de segmentation, chaque segment est converti en vecteur numérique (un embedding), ces vecteurs sont stockés dans une base de données vectorielle, puis un récupérateur extrait les segments les plus pertinents au moment de la requête. Le modèle de langage synthétise ensuite une réponse à partir de ces segments récupérés, en s’appuyant sur votre contenu réel plutôt que sur ses données d’entraînement de base.
De nombreux chatbots de connaissances basés sur l’IA utilisent un pipeline de récupération composé de segments, d’embeddings, d’une base de données vectorielle, d’un récupérateur et d’un modèle de langage. Les systèmes qui conservent les références aux sources facilitent l’examen d’une réponse et sa traçabilité jusqu’au document utilisé.
Les composants essentiels d’un pipeline de base de connaissances bien conçu :
- Documents sources : Articles de la base de connaissances, tickets résolus, PDF, pages web et documents de politique interne.
- Métadonnées : Étiquettes indiquant le sujet, le domaine produit, le public, la date de dernière mise à jour et l’auteur.
- Embeddings : Représentations vectorielles denses de chaque segment, générées par un modèle d’embedding.
- Base de données vectorielle : Stocke et indexe les embeddings pour permettre une recherche sémantique rapide (Pinecone, Weaviate, pgvector et outils similaires).
- Récupérateur : Interroge la base de données vectorielle et renvoie les N segments les plus pertinents.
- LLM et invites système : Synthétisent les segments récupérés en une réponse en langage naturel, encadrée par vos instructions.
- Couche de citation : Ajoute des références aux sources à chaque réponse afin que les utilisateurs et les clients puissent la vérifier.
Conseil pratique : Consacrez chaque article à un sujet clairement défini. Divisez les documents qui répondent à plusieurs questions sans rapport. La taille des segments compte également : commencez avec 500 à 1 000 caractères et ajustez selon les résultats des tests. Des segments trop petits peuvent perdre le contexte, tandis que des segments trop volumineux peuvent enfouir la phrase pertinente.
Pourquoi la maintenance continue est-elle importante pour la précision d’un chatbot ?
Un chatbot entraîné une seule fois puis laissé à l’abandon se dégrade. Les produits évoluent, les politiques sont mises à jour, les prix changent et la base de connaissances prend silencieusement du retard. Le chatbot continue de répondre à partir de données obsolètes, et les clients s’en rendent compte avant votre équipe.
Maintenir la base de connaissances à jour peut améliorer la qualité des réponses et aider davantage de clients à résoudre leurs questions courantes sans transfert vers un agent. Un ton cohérent et des formulations approuvées peuvent également réduire les erreurs évitables. Les nouveaux utilisateurs disposent d’un point de référence plus clair lorsque la base de connaissances est considérée comme la source faisant autorité. Les résultats dépendent toujours de la qualité du contenu, du périmètre de déploiement et de la configuration du chatbot.
Les risques liés à la négligence sont tout aussi évidents :
- Réponses obsolètes : Un chatbot qui cite un produit abandonné ou une ancienne politique de retour perd immédiatement en crédibilité.
- Contenu contradictoire : Deux articles donnant des réponses différentes à la même question perturbent le récupérateur et produisent des réponses incohérentes.
- Risque d’hallucination : Lorsque le récupérateur ne trouve rien de pertinent, un système mal configuré invente une réponse. Une base de connaissances bien entretenue réduit ce risque.
- Exposition aux problèmes de conformité : Dans les secteurs réglementés, une réponse obsolète concernant une politique peut entraîner de graves problèmes d’examen et de conformité.
- Érosion de la confiance : Les clients qui reçoivent deux fois une réponse erronée accordent rarement une troisième chance au bot.
Guide opérationnel étape par étape pour maintenir les connaissances d’un chatbot
Voici un flux de travail reproductible que votre équipe peut intégrer à une procédure opérationnelle standard interne. Définissez une cadence pratique pour l’examen des journaux, les mises à jour de contenu et les tests de récupération, puis adaptez-la à la fréquence d’évolution de vos produits et politiques.
-
Planifiez l’audit. Récupérez les journaux de conversation de la période précédente. Signalez les requêtes associées à de faibles scores de confiance, les escalades et les réponses de secours « Je ne sais pas ». Il s’agit de vos lacunes prioritaires.
-
Identifiez les contenus manquants et obsolètes. Comparez les requêtes signalées aux articles existants de la base de connaissances. Marquez pour une mise à jour ou un retrait immédiat les articles faisant référence à des fonctionnalités supprimées, à d’anciens tarifs ou à des promotions expirées.
-
Rédigez ou mettez à jour les réponses de référence. Rédigez un article par sujet. Utilisez un langage destiné aux clients, et non du jargon interne. Champs obligatoires : titre du sujet, périmètre (produit/forfait concerné), public visé, auteur, date de dernière mise à jour et statut d’approbation.
-
Segmentez et générez les embeddings. Commencez par découper les articles mis à jour en segments de 500 à 1 000 caractères. Ajoutez des étiquettes de métadonnées (sujet, produit, langue, public). Faites passer les segments dans votre modèle d’embedding et chargez-les dans la base de données vectorielle dans un environnement de préproduction, et non en production.
-
Exécutez des tests de validation en environnement de préproduction. Utilisez un jeu de tests composé de 20 à 30 requêtes réelles issues des journaux. Vérifiez que chaque requête récupère le bon segment et que la réponse générée correspond à la réponse de référence. Définissez un seuil de réussite pour la précision de récupération avant la mise en production.
-
Déployez en production avec une étape d’approbation. Un approbateur désigné (responsable des connaissances ou chef d’équipe) examine les résultats des tests et donne son accord. Consignez l’événement de publication avec un horodatage, l’auteur et un numéro de version.
-
Surveillez après la publication. Surveillez attentivement la qualité des réponses et les transferts après toute mise à jour importante. Si un indicateur baisse ou si les contrôles révèlent des réponses incorrectes, restaurez la modification à l’aide de l’historique des versions.
-
Retirez les contenus obsolètes. Archivez-les plutôt que de les supprimer afin de préserver l’historique des versions. Mettez à jour les articles qui faisaient référence au contenu retiré.
Conseil pratique : Lorsque la plateforme le permet, exigez des références aux sources pour les réponses factuelles. Associez cette règle à une instruction de secours explicite : si la récupération ne renvoie aucun contenu suffisamment pertinent, le chatbot doit indiquer qu’il ne peut pas répondre et proposer un transfert vers un agent humain plutôt que de deviner.
Conseil pratique : La qualité prime sur la quantité à chaque étape. Cinq à dix documents bien rédigés et ciblés produisent un assistant plus performant que cinquante documents peu structurés. Éliminez sans hésiter avant l’indexation.
Normes, modèles et gouvernance qui garantissent la fiabilité des réponses
Une bonne gouvernance n’est pas de la bureaucratie pour elle-même. Une approche de l’IA centrée sur l’humain commence par les besoins et le bien-être des personnes concernées par le système. Pour un chatbot destiné aux clients, des approbations documentées, un historique des versions et des notes de modification rendent l’examen et la responsabilisation concrets.
Normes éditoriales que chaque article doit respecter
- Un sujet, une réponse. Aucun article ne doit couvrir plus d’une question distincte.
- Un langage adapté aux clients. Écrivez comme un client poserait la question, et non comme un ingénieur la documenterait.
- Champs obligatoires : Titre du sujet, périmètre, public, auteur, date de dernière mise à jour, statut d’approbation, numéro de version et brève note de modification.
- Aucune donnée dupliquée. Si un pipeline d’ingestion récupère déjà les prix en temps réel depuis votre système de référence, ne codez pas ce prix en dur dans un article de la base de connaissances. Il deviendra obsolète.
- Examen proactif des journaux. Examinez les journaux de conversation selon une cadence définie afin de trouver les lacunes avant que les clients ne les signalent.
Rôles de gouvernance
- Responsable de contenu : Expert du domaine qui rédige et met à jour les articles relevant de son périmètre.
- Responsable des connaissances : Fait respecter les normes, réalise les audits, gère le cycle de vie des articles et est responsable du calendrier éditorial.
- Approbateur : Chef d’équipe ou responsable qui donne son accord avant la mise en ligne d’un article.
- Responsable ML : Gère les paramètres de segmentation, les mises à jour du modèle d’embedding, la configuration du récupérateur et la maintenance du jeu de tests.
- Réviseur conformité : Approbation obligatoire pour les articles portant sur des sujets réglementés (tarification, conditions juridiques, confidentialité des données).
Signaux de confiance à mettre en place dès maintenant
- Des journaux d’audit enregistrant chaque action de création, de modification, d’approbation et de retrait avec un horodatage et l’identifiant de l’utilisateur.
- Un historique des versions avec affichage des différences afin que toute modification puisse être examinée.
- Des journaux des modifications associés à chaque article, indiquant ce qui a changé et pourquoi.
- Des tampons d’approbation visibles dans l’administration de la base de connaissances afin que l’équipe sache quels contenus sont autorisés ou non pour le chatbot.
- Des citations des sources affichées dans chaque réponse du chatbot.
Que mesurer et comment agir en fonction des signaux
C’est grâce au suivi que sont prises les décisions de maintenance. Sans indicateurs, vous devinez quels articles mettre à jour. Avec eux, vous disposez chaque semaine d’une file de travail priorisée.
Principaux indicateurs à suivre :
- Précision / exactitude des réponses : Pourcentage de réponses du chatbot correspondant à la réponse de référence sur un échantillon de test.
- Taux d’ancrage : Pourcentage de réponses citant un segment source précis. Une baisse de cet indicateur signale une dérive du récupérateur ou un contenu manquant.
- Taux de résolution autonome : Pourcentage de conversations résolues sans intervention d’un utilisateur. Une hausse des escalades est souvent liée à une lacune précise de la base de connaissances.
- Taux d’escalade : Inverse du taux de résolution autonome ; suivez-le par catégorie de sujet afin d’identifier les domaines de contenu nécessitant une attention particulière.
- Délai de mise à jour : Temps nécessaire entre l’identification d’une lacune et la publication d’une correction vérifiée.
- CSAT du bot : Score de satisfaction client pour les conversations traitées spécifiquement par le chatbot.
- Incidents d’hallucination : Nombre de cas confirmés où le bot a produit une réponse factuellement incorrecte et non fondée sur une source.
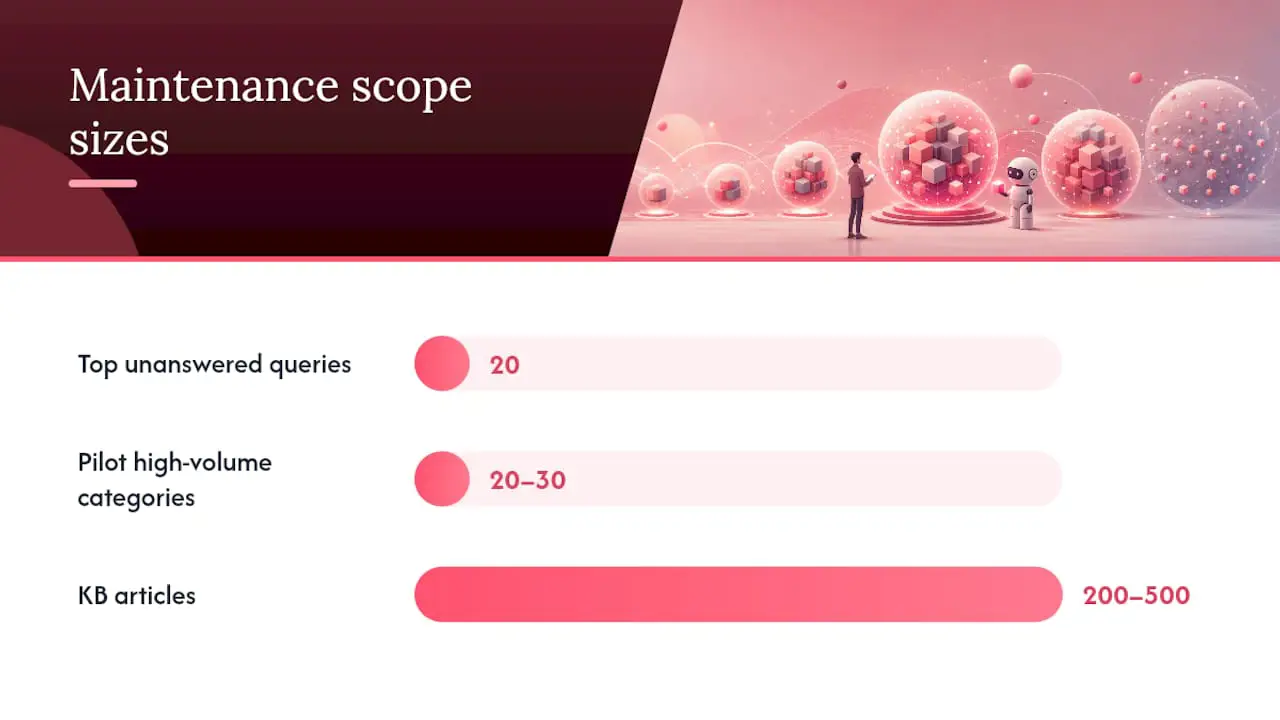
L’utilisation la plus pratique des journaux consiste à générer chaque semaine une liste des 20 principales requêtes sans réponse. Triez-les par volume, attribuez chacune à un responsable de contenu et suivez le délai de clôture. Cette liste devient votre backlog de maintenance.
Modèles d’outillage et checklist d’intégration
Les bons outils rendent le guide ci-dessus reproductible sans nécessiter un effort manuel héroïque. Lors de l’évaluation des plateformes et des modèles d’intégration, donnez la priorité aux fonctionnalités suivantes :
- Indexation incrémentielle : Le système peut mettre à jour des segments individuels sans réindexer l’ensemble de la base de connaissances. C’est essentiel pour les grandes bases, dont la réindexation complète est lente et coûteuse.
- Actualisation des embeddings : Capacité à régénérer les embeddings des articles mis à jour sans modifier le contenu inchangé.
- Provenance et prise en charge des citations : Chaque segment récupéré contient une référence à sa source, affichée dans la réponse.
- Contrôle d’accès fondé sur les rôles : Les responsables de contenu, les approbateurs et les ingénieurs ML disposent de permissions différentes. La plateforme doit l’imposer.
- Journaux d’audit : Chaque événement d’indexation, modification de contenu et approbation est enregistré avec un horodatage et l’utilisateur concerné.
- Webhooks pour la gestion des tickets : Lorsqu’un ticket est résolu, un webhook peut déclencher un examen de la base de connaissances ou générer automatiquement une ébauche d’article candidat. Cela ferme la boucle entre les opérations de support et la maintenance des connaissances.
- SSO : Les solutions SSO de Google et Microsoft réduisent les frictions pour les équipes déjà présentes dans ces écosystèmes.
Modèles d’intégration qui fonctionnent en production
Synchronisation directe de la base de connaissances : La plateforme de base de connaissances transmet les articles mis à jour à la base de données vectorielle selon un calendrier ou lors de la publication. Simple et fiable, c’est le bon point de départ pour la plupart des équipes.
Indexation dans un environnement de test : Le contenu nouveau ou mis à jour est d’abord indexé dans un environnement de préproduction. La suite de tests s’exécute sur cet environnement avant qu’une modification n’atteigne la production. C’est l’équivalent d’un pipeline CI pour le contenu de connaissances.
Pipelines de validation similaires à la CI : Traitez les modifications de la base de connaissances comme des modifications de code. Une mise à jour de contenu déclenche une série de tests automatisés sur votre jeu de 20 à 30 requêtes. Les échecs bloquent la publication. Les réussites sont transmises à l’approbateur pour validation finale.
Principaux compromis à comprendre
Le RAG est la bonne architecture pour la plupart des équipes de support dont les connaissances évoluent fréquemment. Vous mettez à jour les documents, et non les poids du modèle, ce qui maintient les coûts sous contrôle et raccourcit les cycles de mise à jour. Le fine-tuning est pertinent pour les domaines statiques et très spécialisés, où le vocabulaire et les schémas de raisonnement sont stables. La différence de coût opérationnel est importante : une mise à jour RAG consiste à modifier un document et à le réindexer ; un cycle de fine-tuning nécessite des données annotées, du temps de calcul et une évaluation complète du modèle avant son déploiement.
Concernant le compromis entre latence et actualité, des actualisations plus fréquentes des embeddings maintiennent les réponses à jour, mais augmentent le coût de calcul. Choisissez une cadence d’actualisation en fonction de la fréquence de modification des documents sources et exécutez une validation après les mises à jour importantes.
Comment Deskhero s’intègre à ce guide de maintenance
Deskhero repose sur le principe selon lequel un chatbot ne doit répondre qu’à partir de connaissances que vous avez explicitement approuvées, ce qui correspond directement aux étapes de gouvernance et de validation de ce guide.
Voici comment certaines étapes du guide se connectent aux fonctionnalités de Deskhero :
- Réponses fondées uniquement sur des connaissances approuvées : Le chatbot IA de Deskhero répond à partir du contenu public approuvé de la FAQ. Les autres connaissances de l’espace de travail ne sont pas utilisées pour les réponses destinées aux clients. L’activation du chatbot nécessite au moins 100 éléments publics de FAQ approuvés.
- Suggestions de FAQ à partir des tickets résolus : Les tickets résolus et les pages web récupérées peuvent être transformés en entrées candidates pour la FAQ. Un utilisateur examine et approuve une entrée avant qu’elle ne puisse être mise à la disposition du chatbot.
- Périmètres de connaissances distincts : La base de connaissances interne peut alimenter les suggestions de réponses IA destinées aux utilisateurs. Les réponses du chatbot destiné aux clients utilisent uniquement la FAQ publique approuvée.
- Synchronisation bidirectionnelle des e-mails : Les questions des clients arrivent par e-mail, formulaire ou chatbot et deviennent des tickets dans une boîte de réception partagée. Les réponses peuvent être envoyées depuis l’adresse connectée de l’entreprise.
- Actions automatiques identifiées : Les actions automatiques sont identifiées et consignées, et l’envoi entièrement automatique est activé sur option.
- API REST : Deskhero fournit une API REST pour les opérations liées aux tickets et à l’espace de travail. Il ne fournit pas de webhooks sortants.
- Interface multilingue : L’interface de Deskhero est disponible dans 14 langues prises en charge, et la récupération du chatbot peut faire correspondre le contenu public de la FAQ dans plusieurs langues.
Deskhero connecte les boîtes Gmail, Google Workspace ou Microsoft 365 à un service d’assistance partagé tout en permettant à l’équipe de conserver ses adresses e-mail existantes. Son IA destinée aux clients répond à partir du contenu public approuvé de la FAQ et transmet les questions non résolues à un agent humain. Des suggestions de FAQ peuvent être générées à partir de tickets résolus et de pages web récupérées, mais un utilisateur doit les examiner avant leur approbation. Les actions automatiques sont identifiées et consignées. La plateforme comprend également une base de connaissances interne, des informations sur les tickets, 14 langues d’interface, une intégration Shopify, le SSO Google et Microsoft ainsi qu’une API REST. Elle propose un essai gratuit de 30 jours, sans carte bancaire.
Comme le chatbot de Deskhero est limité à la FAQ publique approuvée, la tâche de maintenance est concrète : examinez les questions non résolues, améliorez ou ajoutez des entrées à la FAQ, approuvez-les, puis vérifiez si les connaissances mises à jour répondent aux questions visées.
Pour approfondir la manière dont les chatbots IA gèrent l’escalade et le transfert vers un agent humain dans ce type de flux de travail, le guide du transfert d’un chatbot vers un agent humain présente en détail les modèles opérationnels.
Cadence de maintenance, effectifs et considérations de coût
La planification des personnes et du temps consacrés à la gestion des connaissances du chatbot est le domaine dans lequel la plupart des équipes sous-estiment le travail nécessaire. La bonne nouvelle : une petite équipe disposant d’une cadence claire peut maintenir une base de connaissances en production sans recruter de personnel dédié.
Cadences recommandées :
- Chaque semaine : Examinez les journaux de conversation, établissez la liste des 20 principales requêtes sans réponse, signalez les lacunes urgentes et faites passer les corrections prioritaires par l’étape d’approbation.
- Chaque mois : Exécutez un cycle complet de mise à jour du contenu. Rédigez de nouveaux articles, mettez à jour les politiques ou produits modifiés, retirez les contenus obsolètes et exécutez la suite complète de tests.
- Chaque trimestre : Réalisez une revue des changements de politique et de produit, un réglage du récupérateur, une évaluation du modèle d’embedding et un audit de gouvernance (tous les articles sont-ils correctement approuvés et versionnés ?).
Modèle d’effectifs minimal pour les petites équipes :
- Responsable des connaissances : Est responsable du calendrier éditorial, réalise les audits, fait respecter les normes et gère la file d’approbation. Le temps nécessaire dépend du volume de contenu et de la fréquence des changements.
- Support technique : Gère les paramètres de segmentation, les actualisations des embeddings, la configuration de la récupération et la maintenance de la suite de tests lorsque l’équipe administre sa propre infrastructure de récupération.
- Experts du domaine en rotation : Chaque domaine produit ou politique dispose d’un responsable de contenu désigné, chargé d’examiner et d’approuver les articles de son domaine. Il s’agit généralement d’une responsabilité à temps partiel ajoutée à un poste existant.
Facteurs de coût à estimer :
- Les coûts de stockage et de requêtes de la base de données vectorielle évoluent selon la taille de la base de connaissances et le volume de requêtes.
- La fréquence d’actualisation des embeddings influe sur le coût de calcul ; actualisez donc le contenu modifié lorsque la plateforme prend en charge les mises à jour incrémentielles.
- Le temps consacré à la révision humaine peut représenter un coût important, notamment lorsque les produits ou les politiques changent fréquemment.
- Les coûts d’abonnement aux outils varient selon la plateforme. Les plateformes qui regroupent la gestion de la base de connaissances, les tickets et le chatbot dans un seul abonnement (au lieu d’exiger une base de données vectorielle, une API LLM et des outils de service d’assistance distincts) réduisent à la fois les coûts et la complexité d’intégration.
Les recherches sur l’IA générative dans le support client ont constaté des gains de productivité dans un contexte réel de support. Considérez ces résultats comme un élément de contexte plutôt que comme une formule d’effectifs, car le coût et les bénéfices de la maintenance des connaissances dépendent de l’équipe, du contenu et des outils.
Piloter sur un périmètre peu coûteux : Commencez par 20 à 30 catégories de questions à fort volume. Créez et entretenez d’abord les articles correspondants. Vérifiez que la qualité des réponses s’améliore avant d’élargir la base de connaissances. Cela limite la charge de maintenance initiale et renforce la confiance de l’équipe dans le processus.
Comment valider de nouvelles sources de connaissances avant leur intégration
Tous les documents qui semblent utiles n’ont pas leur place dans l’index du chatbot. L’intégration d’une source de mauvaise qualité ou inexacte dégrade l’ensemble de la base de connaissances, car le récupérateur ne peut pas distinguer un article bien sourcé d’un article mal rédigé.
Soumettez chaque source candidate aux contrôles suivants avant son indexation :
Contrôle de l’exactitude : Le contenu reflète-t-il le comportement actuel du produit, la politique en vigueur ou les tarifs actuels ? Comparez-le au système de référence (votre CRM, la documentation produit ou les documents de politique approuvés par l’équipe juridique). Si vous ne pouvez pas vérifier une affirmation auprès d’une source primaire, ne l’indexez pas.
Contrôle du périmètre : Le contenu est-il pertinent pour les questions auxquelles votre chatbot est censé répondre ? Un livre blanc général sur un secteur peut contenir des informations exactes, mais introduire du bruit dans la récupération. Limitez précisément les documents à votre cas d’usage.
Contrôle des doublons : Ce contenu recoupe-t-il significativement un article existant de la base de connaissances ? Le contenu dupliqué crée une ambiguïté lors de la récupération. Fusionnez ou regroupez les contenus avant l’indexation.
Contrôle du format et de la structure : Le document est-il structuré de manière à ce que la segmentation produise des passages cohérents et autonomes ? Un document comportant de nombreuses références croisées (« voir la section 4.2 pour plus de détails ») se segmente mal, car les segments individuels perdent leur contexte. Réécrivez ou restructurez le document avant son indexation.
Contrôle de la provenance : Pouvez-vous retracer le contenu jusqu’à une source interne ou externe faisant autorité ? Pour les sujets réglementés, indiquez explicitement la source dans les métadonnées de l’article.
Test en préproduction : Indexez la nouvelle source dans un environnement de préproduction et exécutez votre jeu de tests standard de 20 à 30 requêtes. Vérifiez si le nouveau contenu améliore, dégrade ou n’affecte pas la précision de récupération. Ne déployez que les sources qui améliorent ou maintiennent la précision.
Comment utiliser les retours des utilisateurs pour affiner les connaissances du chatbot
Les retours des utilisateurs constituent le signal le plus direct dont vous disposez pour identifier les défaillances de la base de connaissances. Le défi consiste à les recueillir systématiquement plutôt qu’à réagir aux plaintes les plus bruyantes.
Les pouces vers le haut ou vers le bas sur les réponses du chatbot constituent le mécanisme de retour le plus simple. Chaque réponse du chatbot devrait proposer une option d’évaluation binaire. Agrégez ces évaluations chaque semaine. Un taux élevé de pouces vers le bas signale directement qu’un article de la base de connaissances doit être examiné, même si la réponse semblait correcte à l’équipe de rédaction.
Les enquêtes CSAT après conversation fournissent un signal plus large. Les scores faibles pour les conversations traitées par le bot, filtrés par catégorie de sujet, indiquent les domaines de contenu qui nécessitent le plus d’attention. Associez les données CSAT aux journaux d’escalade afin de déterminer si le problème vient d’une lacune de la base de connaissances ou de la configuration du récupérateur.
Les boucles de retour de l’équipe de support sont précieuses. Les utilisateurs qui gèrent les escalades savent souvent pourquoi le bot a échoué. Un système simple d’étiquetage dans votre outil de gestion des tickets, avec des catégories telles que « réponse incorrecte », « réponse manquante » ou « politique obsolète », peut transformer cette expérience en signal de maintenance structuré.
Les journaux explicites « Je ne sais pas » sont une mine d’or. Chaque fois que le chatbot transfère une conversation parce qu’il n’a trouvé aucun contenu pertinent, consignez la requête. Triez-les chaque semaine par volume. Les principales requêtes de cette liste sont vos tâches de rédaction prioritaires.
Les enquêtes périodiques auprès des utilisateurs sur la qualité de la base de connaissances (envoyées aux clients ayant échangé avec le chatbot au cours des 30 derniers jours) font ressortir des problèmes systémiques que les évaluations individuelles des conversations ne permettent pas de détecter. Limitez l’enquête à deux ou trois questions et associez les réponses aux identifiants de conversation afin de pouvoir relier les retours à des articles précis.
La boucle de retour se referme lorsqu’une requête signalée devient un article de la base de connaissances, que l’article passe par le flux d’approbation et que la réponse du chatbot à cette requête s’améliore. Le suivi de ce délai (entre le signalement et la correction) est l’un des indicateurs opérationnels les plus utiles qu’un responsable des connaissances puisse gérer.
Ce que les équipes de support apprennent réellement en exécutant ce processus en production
Le guide ci-dessus est correct en théorie. Voici ce qui ne fonctionne pas en pratique et comment y remédier rapidement.
Commencez petit et prouvez la valeur avant de passer à l’échelle. Indexer tous les documents disponibles en une seule fois peut créer une base de connaissances trop volumineuse et compliquer l’établissement d’une référence de qualité utile. Choisissez 20 à 30 catégories de questions à fort volume, créez des articles propres pour celles-ci et faites fonctionner le chatbot sur ce périmètre restreint. Élargissez-le une fois que les tests montrent que les réponses sont exactes et utiles.
Gérez explicitement les contenus limités dans le temps. Les promotions, les politiques saisonnières et les offres à durée limitée peuvent rapidement devenir obsolètes. Créez une étiquette de métadonnées distincte pour les contenus limités dans le temps et définissez dès la rédaction une date obligatoire de réexamen et d’expiration.
Consignez et suivez régulièrement les réponses inconnues. L’examen fréquent du journal « Je ne sais pas » aide les équipes à détecter les lacunes récurrentes avant qu’elles ne s’accumulent. Utilisez le volume des requêtes et leur impact client pour prioriser les corrections.
Conseil pratique : Les tickets résolus sont une source utile pour les réponses de référence, car ils montrent comment l’équipe a traité de vraies questions. Deskhero utilise périodiquement des tickets résolus comme source pour suggérer des FAQ. Un utilisateur peut examiner, modifier, approuver ou refuser chaque suggestion avant que le contenu approuvé ne soit mis à la disposition du chatbot.
Corrections rapides pour les équipes qui débutent :
- Établissez dès le premier jour une convention de nommage des articles (Domaine produit : Sujet : Public). Renommer rétroactivement 200 articles est pénible.
- Créez un modèle de métadonnées avec les champs obligatoires et collez-le dans chaque nouvel article avant de commencer la rédaction.
- Constituez une suite de tests de 20 à 30 requêtes réelles issues des premiers journaux de conversation et exécutez-la avant chaque déploiement en production.
Deskhero rend ce guide de maintenance opérationnel dès le premier jour
Exécuter ce guide avec des outils déconnectés peut entraîner un travail de coordination supplémentaire. Deskhero réunit le flux d’examen de la FAQ publique, les suggestions de FAQ et les conversations clients dans le même service d’assistance.
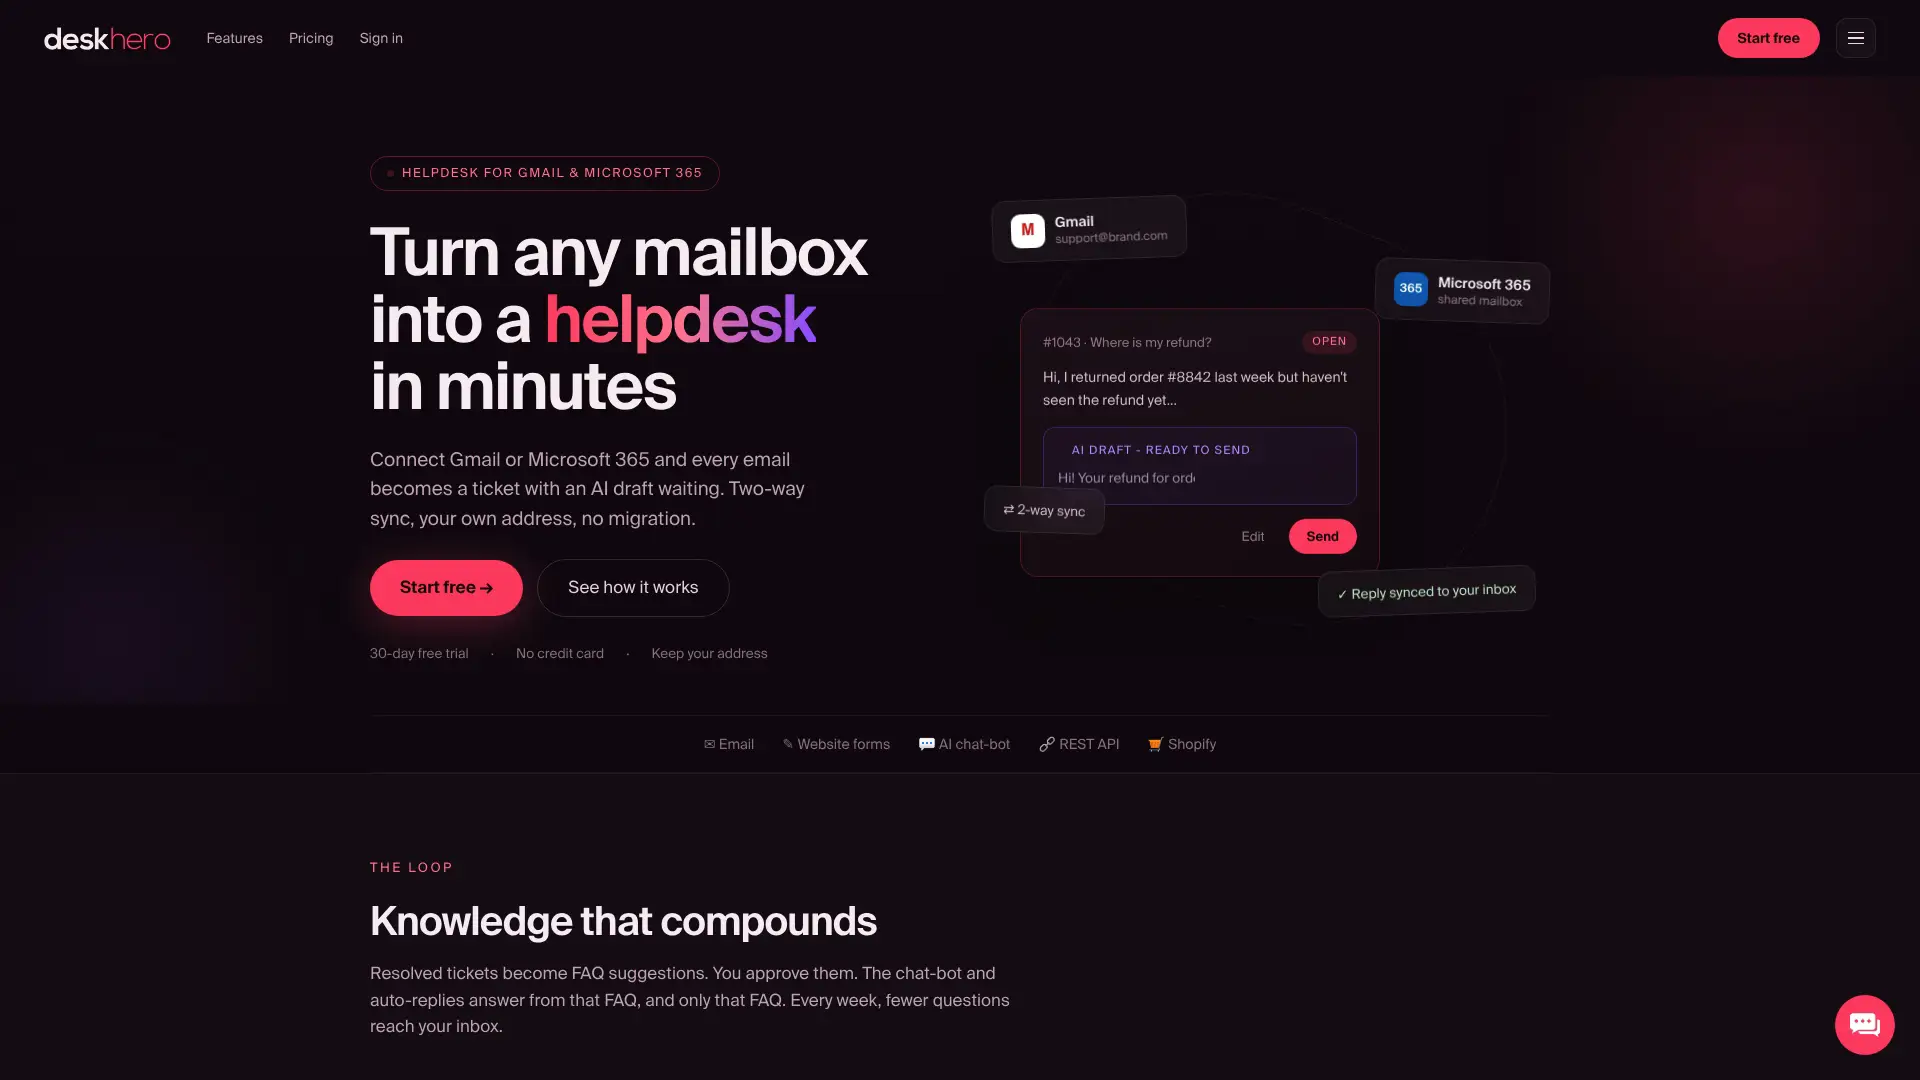
Le chatbot répond uniquement à partir du contenu public approuvé de la FAQ, tandis que les suggestions de réponses IA destinées aux utilisateurs peuvent s’appuyer sur des connaissances plus larges de l’espace de travail. Les suggestions de FAQ issues des tickets résolus et des pages web récupérées réduisent le travail de rédaction à partir de zéro, mais elles nécessitent toujours une révision humaine. L’intégration bidirectionnelle des boîtes mail maintient les tickets et les réponses reliés à l’adresse existante de l’équipe.
Pour les équipes qui souhaitent ce flux de travail sans assembler leur propre infrastructure de récupération, Deskhero combine la boîte de réception partagée, la FAQ publique, le chatbot et le transfert vers un agent humain. Commencez un essai gratuit de 30 jours sur Deskhero, sans carte bancaire.
Sources
Utilisez-les comme références de mise en œuvre lorsque vous prenez des décisions techniques concernant la stratégie de segmentation, l’approche d’entraînement, la politique de gouvernance et la configuration des mesures.
FAQ
Qu’est-ce qu’une base de connaissances de chatbot ?
Une base de connaissances de chatbot est un ensemble organisé de documents sources, segmentés en passages, convertis en embeddings vectoriels et stockés dans une base de données vectorielle afin qu’un récupérateur puisse extraire le contenu le plus pertinent au moment de la requête et fonder les réponses du chatbot sur votre contenu réel.
Comment maintenir un chatbot au fil du temps ?
Exécutez un cycle reproductible : examinez les journaux de conversation pour trouver les lacunes, mettez à jour ou rédigez les articles de référence, segmentez et générez les embeddings dans un environnement de préproduction, validez le résultat sur un jeu de tests de 20 à 30 requêtes, obtenez l’approbation, publiez en production, puis surveillez la qualité des réponses et les transferts afin de détecter toute régression.
Que ne devez-vous jamais communiquer à un chatbot ?
Évitez de saisir des données personnelles sensibles (numéros de sécurité sociale, mots de passe, coordonnées de comptes financiers) dans une interface de chatbot, car les données saisies peuvent être enregistrées ou utilisées pour l’entraînement des modèles selon la politique de traitement des données de la plateforme. Lors de la rédaction de la base de connaissances interne, ne codez jamais en dur des données dynamiques (prix, stocks) qu’un pipeline d’ingestion peut récupérer directement depuis le système de référence.
Combien coûte la maintenance d’un chatbot ?
Les principaux coûts sont le temps de révision, les ressources de calcul nécessaires à la récupération et aux embeddings lorsque ces composants sont gérés directement, ainsi que l’abonnement à un service d’assistance ou à une plateforme de connaissances. Estimez-les en fonction du volume de contenu, du volume de requêtes, de la fréquence des mises à jour et du niveau de révision humaine requis.