Welke helpdeskmetrics er echt toe doen
Als je deze week maar één ding bouwt, bouw dan een wekelijks managerdashboard van één pagina waarop alle acht metrics elke maandagmorgen voor je team staan. Al het andere, inclusief gebruikerswidgets per uur en kwartaalpresentaties voor managers, kan wachten totdat dat ene rapport betrouwbaar is.
Dit is wat elke metric je daadwerkelijk vertelt:
- Eerste reactietijd beantwoordt de vraag: hoe lang wachten klanten voordat ze iets van een medewerker horen?
- MTTR beantwoordt de vraag: hoe lang duurt het daadwerkelijk om een probleem van begin tot eind op te lossen?
- Oplossing bij het eerste contact beantwoordt de vraag: lossen gebruikers problemen bij de eerste poging op, of worden tickets heen en weer gestuurd?
- CSAT beantwoordt de vraag: zijn klanten tevreden over de manier waarop hun probleem is afgehandeld?
- SLA-naleving beantwoordt de vraag: kom je de beloofde responstijden en oplostijden na?
- Ticketvolume en achterstand beantwoorden de vraag: groeit de binnenkomende vraag sneller dan de capaciteit van je team?
- Heropeningspercentage beantwoordt de vraag: blijven “opgeloste” tickets daadwerkelijk opgelost?
- Kosten per ticket beantwoordt de vraag: wat kost elke supportinteractie het bedrijf?
Geen van deze cijfers zegt op zichzelf bijzonder veel. Een snelle FRT in combinatie met een lage FCR betekent alleen dat je snel antwoord geeft en het antwoord verkeerd hebt. De echte vaardigheid bij helpdeskrapportagemetrics is de juiste combinaties kiezen, ze correct segmenteren en de juiste weergave naar de juiste persoon sturen.
Belangrijkste punten
Betrouwbare helpdeskranking komt neer op het consequent bijhouden van acht kernmetrics, ze correct segmenteren en de juiste weergave volgens een vast ritme naar het juiste publiek sturen.
| Punt | Details |
|---|---|
| Begin met acht metrics | Houd FRT, MTTR, FCR, CSAT, SLA-naleving, achterstandsratio, heropeningspercentage en kosten per ticket bij. |
| Bouw eerst het wekelijkse dashboard | Een managerrapport van één pagina is beter dan een uitgebreid systeem met meerdere tabbladen dat niemand controleert. |
| Stem dashboards af op het publiek | Managers hebben trendgegevens nodig, teamleiders dagelijkse operationele weergaven en gebruikers realtime persoonlijke wachtrijen. |
| Combineer metrics om manipulatie te signaleren | Bekijk FCR naast het heropeningspercentage en FRT naast CSAT om het volledige beeld te zien. |
| Deskhero biedt vaste rapportageweergaven | Het onderdeel Statistics omvat tickettrends, responstijden, SLA, teamactiviteit, AI en automatisering, kanalen en onderwerpen. |
Inhoudsopgave
- Helpdeskrankagemetrics versus KPI’s: wat is het verschil?
- Belangrijkste helpdeskemetrics: definities, formules en benchmarks
- Correct meten en veelvoorkomende valkuilen vermijden
- Dashboards ontwerpen per publiek: weergaven voor managers, teamleiders en gebruikers
- Rapportageritme en voorbeeldrapportagesjablonen
- Metricsignalen omzetten in actie
- Datagovernance: zorgen dat de cijfers betrouwbaar zijn
- Deze rapporten laten draaien zonder handmatig werk
- Bronnen
- Veelgestelde vragen
Helpdeskrankagemetrics versus KPI’s: wat is het verschil?
Een metric is elk getal dat je kunt meten. Een KPI is een metric waarvan je organisatie heeft besloten dat deze belangrijk genoeg is om er een doel voor vast te stellen en er regelmatig actie op te ondernemen. Ticketvolume is een metric. “Houd het gemiddelde ticketvolume onder 40 per gebruiker per dag” is een KPI. Een benchmark is daarentegen een extern referentiepunt, zoals een branchegemiddelde, dat je vertelt of je KPI-doel überhaupt realistisch is.
Dit onderscheid is belangrijk, omdat supportteams veel metrics kunnen verzamelen zonder te bepalen welke ervan een doel en een regelmatige reactie verdienen. Een compacte kernset is eenvoudiger consequent te beoordelen. Voeg een metric alleen toe als iemand er verantwoordelijkheid voor draagt en weet welke actie een verandering moet activeren.
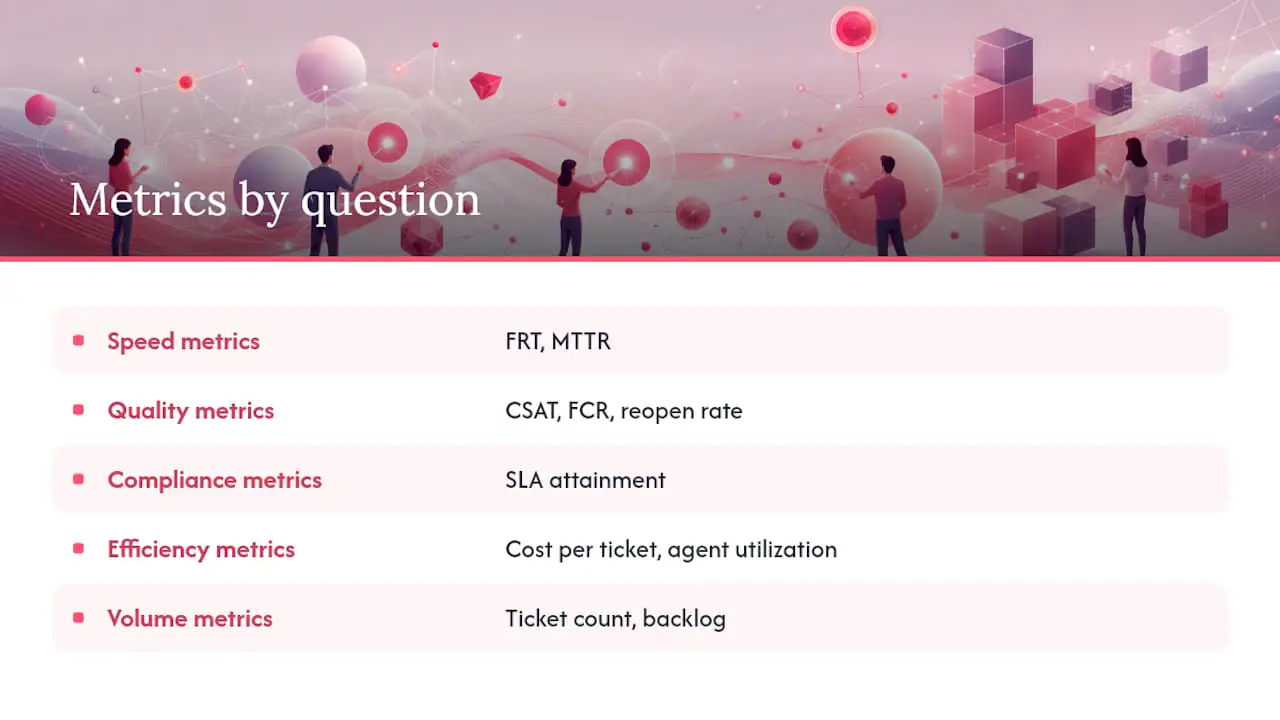
Groepeer je metrics op basis van de vraag die ze beantwoorden, en het ontwerp van je rapportage wordt veel eenvoudiger:
Snelheidsmetrics (FRT, MTTR) vertellen hoe snel het team werkt. Kwaliteitsmetrics (CSAT, FCR, heropeningspercentage) vertellen of die snelheid goede resultaten oplevert. Compliancemetrics (SLA-naleving) vertellen of je contractuele of interne beloften nakomt. Efficiëntiemetrics (kosten per ticket, teambenutting) vertellen wat het kost om de operatie te runnen. Volumemetrics (aantal tickets, achterstand) vertellen iets over de vraag.
Managers letten doorgaans op efficiëntie- en kwaliteitstrends over meerdere maanden. Teamleiders hebben dagelijks of wekelijks gecontroleerde compliance- en volumevertoningen nodig. Gebruikers hebben snelheids- en kwaliteitsmetrics nodig die zijn beperkt tot hun eigen wachtrij. Als je elk publiek op één dashboard combineert, kan de informatie die elke persoon nodig heeft ondergesneeuwd raken.
Belangrijkste helpdeskemetrics: definities, formules en benchmarks
Hier is het overzicht. Definieer elke metric expliciet, segmenteer deze langs deze lijnen en stel doelen vast op basis van je eigen serviceverplichtingen en historische basislijn.
Eerste reactietijd (FRT) meet de verstreken tijd tussen het aanmaken van een ticket en het eerste inhoudelijke antwoord van een medewerker. Rapporteer waar mogelijk zowel een mediaan als een hoger percentiel en sluit automatische ontvangstbevestigingen uit. Segmenteer op kanaal en prioriteit, omdat klanten verschillende verwachtingen hebben voor e-mail, chat en telefoon.
Oplostijd, vaak samengevat als gemiddelde tijd tot oplossing (MTTR), meet de levenscyclus vanaf het aanmaken van een ticket tot de oplossing of sluiting ervan. Rapporteer de mediaan naast of in plaats van het gemiddelde wanneer een klein aantal complexe tickets het resultaat zou vertekenen. Segmenteer op prioriteit en soort probleem en definieer hoe wachten op de klant de klok beïnvloedt.
Oplossing bij het eerste contact (FCR) meet het aandeel tickets dat zonder vervolginteractie is opgelost. Definieer “eerste contact” duidelijk en segmenteer vervolgens op categorie en gebruikersanciënniteit, zodat veranderingen in de ticketsamenstelling niet ten onrechte worden gezien als veranderingen in prestaties.
Klanttevredenheid (CSAT) meet het aandeel positieve enquêtereacties. Rapporteer het aantal reacties en het responspercentage naast de score, omdat een kleine of zelfselecterende steekproef misleidend kan zijn. Segmenteer op probleemcategorie voordat je gebruikers met elkaar vergelijkt.
SLA-naleving meet het percentage tickets dat voldoet aan je vastgelegde afspraken over responstijd en oplostijd. Segmenteer op SLA-niveau en type klantcontract; als je SLA’s voor zakelijke klanten en gratis abonnementen samenvoegt tot één getal, verberg je het verhaal.
Ticketvolume en achterstand meten de binnenkomende vraag en de wachtrij met onopgelost werk. Houd de achterstand bij als zowel een absoluut aantal als een ratio (open tickets gedeeld door de gemiddelde dagelijkse oplossingscapaciteit), zodat je kunt zien of de wachtrij sneller groeit dan het team deze kan wegwerken.
Heropeningspercentage meet het percentage opgeloste tickets dat binnen een vastgestelde periode opnieuw wordt geopend, doorgaans 48 tot 72 uur. Segmenteer op gebruiker en categorie. Dit is de metric die FCR eerlijk houdt.
Kosten per ticket meet de totale operationele supportkosten gedeeld door het ticketvolume over een bepaalde periode. Segmenteer op kanaal, omdat telefonische support per ticket doorgaans veel meer kost dan e-mail of chat.
| Metric | Formule | Segmenteren op | Startpunt voor benchmark |
|---|---|---|---|
| Eerste reactietijd | Tijd tot eerste antwoord van een medewerker | Kanaal, prioriteit | Vaststellen per kanaal en supporturen |
| MTTR (mediaan) | Tijd van openen tot sluiten | Prioriteitsniveau | Vaststellen per prioriteit en probleemtype |
| Oplossing bij het eerste contact | Sluitingen bij eerste contact ÷ totaal aantal tickets | Categorie, gebruikersanciënniteit | Gebruik een historische basislijn |
| CSAT | Positieve reacties ÷ totaal aantal reacties | Gebruiker, categorie | Toon score, aantal reacties en responspercentage |
| SLA-naleving | Tickets die aan de SLA voldoen ÷ totaal aantal tickets | SLA-niveau, contracttype | Vaststellen per contract |
| Heropeningspercentage | Heropende tickets ÷ opgeloste tickets | Gebruiker, categorie | Combineren met FCR |
Twee metrics zijn alleen samen zinvol: oplossing bij het eerste contact en het heropeningspercentage binnen 48 uur. Een hoge FCR in combinatie met een stijgend heropeningspercentage betekent dat gebruikers tickets sluiten om een doelstelling te halen, niet omdat het probleem daadwerkelijk is opgelost.
Correct meten en veelvoorkomende valkuilen vermijden
Precisie in de manier waarop je een metric berekent is belangrijker dan de metric die je kiest. Gebruik de mediaan in plaats van het gemiddelde voor elke tijdsgebonden metric met een lange staart, wat in de praktijk bijna elk getal voor de oplostijd betekent dat je rapporteert. Eén ticket dat drie weken nodig heeft om te sluiten omdat het op een leverancier wacht, trekt je gemiddelde oplostijd omhoog op een manier die de prestaties van het hele team verkeerd weergeeft.
Tel de eerste reactie van een medewerker als je FRT, niet de automatische bevestiging “we hebben je bericht ontvangen”. Als je systeem de automatische reactie als eerste contact registreert, lijken je FRT-cijfers kunstmatig snel en blijft een echt personeelsprobleem verborgen. Definieer je heropeningsperiode expliciet — 24, 48 of 72 uur — en pas deze consequent toe op elke categorie, zodat je vergelijkbare zaken met elkaar vergelijkt. Stem je rapportageklok af op je werkelijke supporturen; een ticket dat vrijdag om 23.00 uur is ingediend en maandag om 9.00 uur is beantwoord, zou niet hetzelfde moeten tellen als een vertraging van drie dagen tijdens kantooruren als je team in het weekend niet werkt.
Een veelvoorkomende valkuil is het middelen van een metric over kanalen die zich verschillend gedragen. Door de FRT van e-mail te combineren met die van chat ontstaat een getal dat geen van beide kanalen goed beschrijft. Een andere valkuil is rapporteren over oplossing bij het eerste contact zonder het heropeningspercentage, waardoor voortijdig sluiten kan worden beloond. Ook bij CSAT heb je de steekproefgrootte en het responspercentage nodig, niet alleen de opvallende score.
Pro-tip: Voer een snelle plausibiliteitscontrole uit voordat je een rapport presenteert. Bekijk een paar tickets die als “binnen SLA” zijn gemarkeerd en vergelijk hun tijdstempels met het rapport. Elke afwijking verdient nader onderzoek voordat je het getal voor een beslissing gebruikt.
Bekijk FRT naast CSAT en de achterstandsratio naast het aantal SLA-overschrijdingen. Deze combinaties brengen problemen aan het licht die één getal verbergt. Een team kan op papier elke SLA-doelstelling halen terwijl de achterstand ongemerkt verdrievoudigt, omdat SLA-naleving alleen de tickets meet die je hebt afgehandeld, niet de tickets die zich daarachter opstapelen.
Dashboards ontwerpen per publiek: weergaven voor managers, teamleiders en gebruikers
Verschillende doelgroepen hebben verschillende weergaven nodig. Een dashboard dat is gebouwd voor de huidige werkvoorraad van een gebruiker is te gedetailleerd voor een manager die kwartaaltrends beoordeelt, terwijl een strategische managementweergave te traag verandert om iemand te helpen de wachtrij van vandaag te beheren.
Managers hebben trendlijnen nodig, geen live tellers. Zet de CSAT-trend door de tijd heen, kosten per ticket per maand, ticketvolume in verhouding tot het aantal medewerkers, de MTTR-trend per kwartaal, de SLA-nalevingstrend en een overzicht van de ontwikkeling van de achterstand in hun weergave. Ze bekijken dit maandelijks, soms wekelijks, om te zien of de supportfunctie op een gezonde manier met het bedrijf meegroeit.
Teamleiders hebben dagelijks vernieuwde operationele details nodig. Hun dashboard moet realtime openstaande tickets per prioriteit tonen, SLA-naleving uitgesplitst per categorie, de verdeling van de werklast onder gebruikers, het ticketvolume van vandaag ten opzichte van het daggemiddelde, de ouderdomsverdeling van de achterstand en het heropeningspercentage per gebruiker. Dit is de weergave die personeelsbeslissingen en dagelijkse triagebesprekingen aanstuurt.
Gebruikers hebben een smalle, persoonlijke realtimeweergave nodig: hun eigen openstaande tickets met SLA-afteltimers, hun persoonlijke CSAT-score, hun FCR-percentage en een wachtrij met tickets die op hun antwoord wachten, gesorteerd op urgentie. Alles buiten hun eigen werkvoorraad is ruis die hen vertraagt.
| Type dashboard | Vernieuwingsfrequentie | Tijdshorizon | Belangrijkste metrics | Primair publiek |
|---|---|---|---|---|
| Realtime operationeel | Live tot elk uur | Vandaag | Openstaande tickets, SLA-timers, wachtrijdiepte | Gebruikers, teamleiders |
| Wekelijks tactisch | Dagelijks tot wekelijks | Deze week versus vorige week | Volume, achterstandsratio, werklast per gebruiker | Teamleiders |
| Strategische trend | Wekelijks tot maandelijks | Maand/kwartaal/jaar | CSAT-trend, kosten per ticket, MTTR | Managers |
Realtime operationele weergaven helpen teamleiders werk opnieuw te verdelen voordat een wachtrij de doelstellingen overschrijdt. Historische rapporten dienen een ander doel: ze laten zien of werklast, kwaliteit en reactiepatronen in de loop van de tijd verbeteren.
De meeste kleine en middelgrote teams hebben niet direct een volledige BI-integratie nodig. Ingebouwde helpdeskrapportage kan operationele en wekelijkse beoordelingen afdekken. Voeg een tool zoals Looker Studio of Power BI toe wanneer je supportgegevens moet combineren met omzet-, personeels- of andere bedrijfssystemen. Voor veel teams is een gericht dashboard voor klantenondersteuning voldoende voor een wekelijkse evaluatie.
Je KPI-checklist van één pagina voor een wekelijkse evaluatie moet passen zonder te scrollen: FRT, MTTR (mediaan), FCR, CSAT, SLA-naleving, achterstandsratio, heropeningspercentage en kosten per ticket. Acht cijfers, één scherm, zonder zoekwerk.
Rapportageritme en voorbeeldrapportagesjablonen
Het ritme moet aansluiten bij de snelheid waarmee een metric betekenisvol kan veranderen en de snelheid waarmee iemand erop moet reageren. Hier is een structuur die je rechtstreeks kunt kopiëren.
-
Dagelijkse waarschuwingen. Stel triggers in voor tickets die een SLA-deadline naderen, ongebruikelijke volumeveranderingen en groei in de wachtrij met kritieke prioriteit. Kies drempelwaarden op basis van je operationele basislijn en verstuur waarschuwingen via kanalen die je team actief in de gaten houdt.
-
Wekelijks managerrapport. Structureer het als deze week versus vorige week versus dezelfde week vorig jaar, met bovenaan een toelichting van twee zinnen waarin de grootste verandering wordt uitgelegd. Volg met de vijf belangrijkste ticketcategorieën op volume, een weergave van de werklast per gebruiker waarin zichtbaar is waar de capaciteit krap is en de kernset KPI’s (FRT, oplostijd, FCR, CSAT, SLA-naleving, achterstandsratio). Verstuur het vóór de wekelijkse teamreview.
-
Maandelijks bedrijfsrapport. Dit rapport is bedoeld voor directie en management en behandelt maand-op-maand- en jaar-op-jaartrends voor dezelfde kernmetrics, kosten per ticket per kanaal, een personeelsanalyse waarin het aantal medewerkers wordt vergeleken met de volumegroei en een korte vooruitblik op risico’s, zoals een aanstaande productlancering die naar verwachting het ticketvolume zal doen stijgen. Dit is het rapport dat verzoeken om extra personeel onderbouwt (of ter discussie stelt).
Veel helpdeskplatforms bieden vooraf gebouwde operationele weergaven. Gebruik deze als startpunt, verwijder vervolgens velden waarop niemand actie onderneemt en definieer elke berekening voordat je deze als KPI gebruikt.
Metricsignalen omzetten in actie
Een rapport dat alleen in een inbox blijft staan, is verspilde moeite. Elke metric die de verkeerde kant op beweegt, moet een specifieke, toegewezen reactie activeren, niet een vaag gesprek over “het in de gaten houden”.
Stijgende achterstand. Controleer eerst of het om een volum probleem of een doorvoerprobleem gaat. Als het volume is gestegen, zet dan tijdelijk een triageteam in of open een selfservice-afhandelingsroute via een AI-chatbot voor veelgestelde vragen. Als de doorvoer is gedaald, controleer dan op een kennistekort of een defecte routeringsregel. Eigenaar: supportmanager. Houd de achterstandsratio een week lang dagelijks in de gaten nadat de oplossing is doorgevoerd.
Dalende FCR. Haal de categorieën naar boven die het getal omlaag trekken en controleer of er sprake is van een kennistekort. Vaak gaat het om één of twee probleemtypen die herhaaldelijk tussen gebruikers heen en weer worden gestuurd. Werk de interne kennisbank bij met een duidelijk oplossingspad voor die categorie en train het team opnieuw. Eigenaar: teamleider. Controleer de FCR per categorie na twee weken opnieuw, niet meteen, omdat gebruikers tijd nodig hebben om nieuwe richtlijnen eigen te maken.
Dalende CSAT. Vergelijk de verandering met de FRT en oplostijd voor dezelfde periode om te zien of tragere service bijdraagt aan de daling. Als de snelheid stabiel is, lees dan de tickets met negatieve reacties en groepeer de redenen. Eigenaar: teamleider. Beoordeel de score samen met het aantal reacties en het responspercentage.
Stijgend heropeningspercentage. Vergelijk het met FCR. De combinatie kan erop wijzen dat tickets worden gesloten voordat het probleem volledig is opgelost. Bekijk de betrokken categorieën en tickets voordat je coaching of incentives aanpast. Eigenaar: teamleider. Controleer dit wekelijks.
Stijgende kosten per ticket. Controleer eerst de kanaalmix, omdat telefoon, e-mail en chat verschillende kostenstructuren hebben. Als de mix stabiel is, onderzoek dan personeelsbezetting, overuren, tooling en complexiteit van cases. Eigenaar: manager. Beoordeel dit maandelijks, omdat deze metric doorgaans langzamer verandert dan metrics voor de wachtrij.
Pro-tip: Kies een evaluatieperiode voordat je een verandering doorvoert. Deze moet lang genoeg zijn om een representatief ticketvolume en ten minste één normale rapportagecyclus te omvatten.
Veranderingen in routering en documentatie kunnen operationele metrics sneller beïnvloeden dan nieuwe medewerkers aannemen of een omvangrijke training uitvoeren. Stem de evaluatieperiode af op de interventie en het ticketvolume, in plaats van succes af te leiden uit één goede dag.
Datagovernance: zorgen dat de cijfers betrouwbaar zijn
Dit werkt allemaal niet als de onderliggende data onjuist is, en ergens is dat meestal het geval. Elke kernmetric heeft een benoemde eigenaar nodig die verantwoordelijk is voor de definitie, een gedocumenteerde berekeningsmethode die niet zonder aankondiging verandert, een vastgestelde vernieuwingsfrequentie en een regel voor het omgaan met ontbrekende of verkeerd gevormde data.
Maak een korte governancechecklist en neem deze elk kwartaal opnieuw door:
- Wijs één eigenaar per metric aan die elke wijziging in de definitie goedkeurt.
- Documenteer de exacte berekeningsformule op een plek die het hele team kan zien, niet alleen in het hoofd van één teamleider.
- Stel een vaste vernieuwingsfrequentie voor data in en waarschuw bij elke onderbreking daarvan, omdat een stilzwijgend defecte datapijplijn erger is dan helemaal geen rapport.
- Stel een minimumaantal reacties of minimumresponspercentage vast voordat je CSAT publiceert, gebaseerd op je ticketvolume en het gewenste betrouwbaarheidsniveau.
- Voer regelmatig controles uit op steekproeven van tickets: selecteer maandelijks 10 tot 15 willekeurige tickets en controleer handmatig de tijdstempels en categorisering aan de hand van het rapport.
- Onderzoek plotselinge veranderingen waarvoor geen overeenkomstige operationele gebeurtenis bestaat, omdat ze kunnen wijzen op een probleem met definities, tags of integraties.
Geef voor benchmarks de voorkeur aan bronnen die hun methodologie en steekproef publiceren. Gebruik externe cijfers alleen als context en stel vervolgens doelen vast op basis van je eigen serviceverplichtingen, ticketsamenstelling, supporturen en historische basislijn.
Een praktische opmerking over dit goed aanpakken
De meeste teams falen bij helpdeskrankage niet omdat ze de verkeerde metrics kiezen, maar omdat ze vanaf dag één twintig metrics proberen bij te houden en de hele inspanning binnen een maand opgeven. Acht metrics die consequent worden bijgehouden en elke week tot actie leiden, leren je meer over je supportoperatie dan dertig metrics waar af en toe vluchtig naar wordt gekeken.
Begin met het wekelijkse managerrapport van één pagina. Zorg dat dit een maand lang goed werkt voordat je begint aan managementrapportage of individuele gebruikerswidgets bouwt. Het is verleidelijk om op dag één het volledige systeem te bouwen omdat de tooling dat eenvoudig maakt, maar de discipline om acht cijfers nauwlettend te volgen is beter dan de illusie dat je dertig cijfers in de gaten houdt.
Voor een klein of middelgroot team zonder een speciaal aangewezen data-analist biedt Deskhero vaste Statistics-weergaven voor trends, responstijden, SLA, teamactiviteit, AI en automatisering, kanalen en onderwerpen.
Deze rapporten laten draaien zonder handmatig werk
Veel van de frictie bij helpdeskrankage komt voort uit verspreide gesprekken, inconsistente ticketvelden en herhaald werk in spreadsheets. Deskhero koppelt Gmail- of Microsoft 365-mailboxen aan een gedeelde helpdesk. Het onderdeel Statistics rapporteert over tickettrends, responstijden, SLA-naleving, teamactiviteit, kanalen, AI en automatisering en onderwerpstrends.
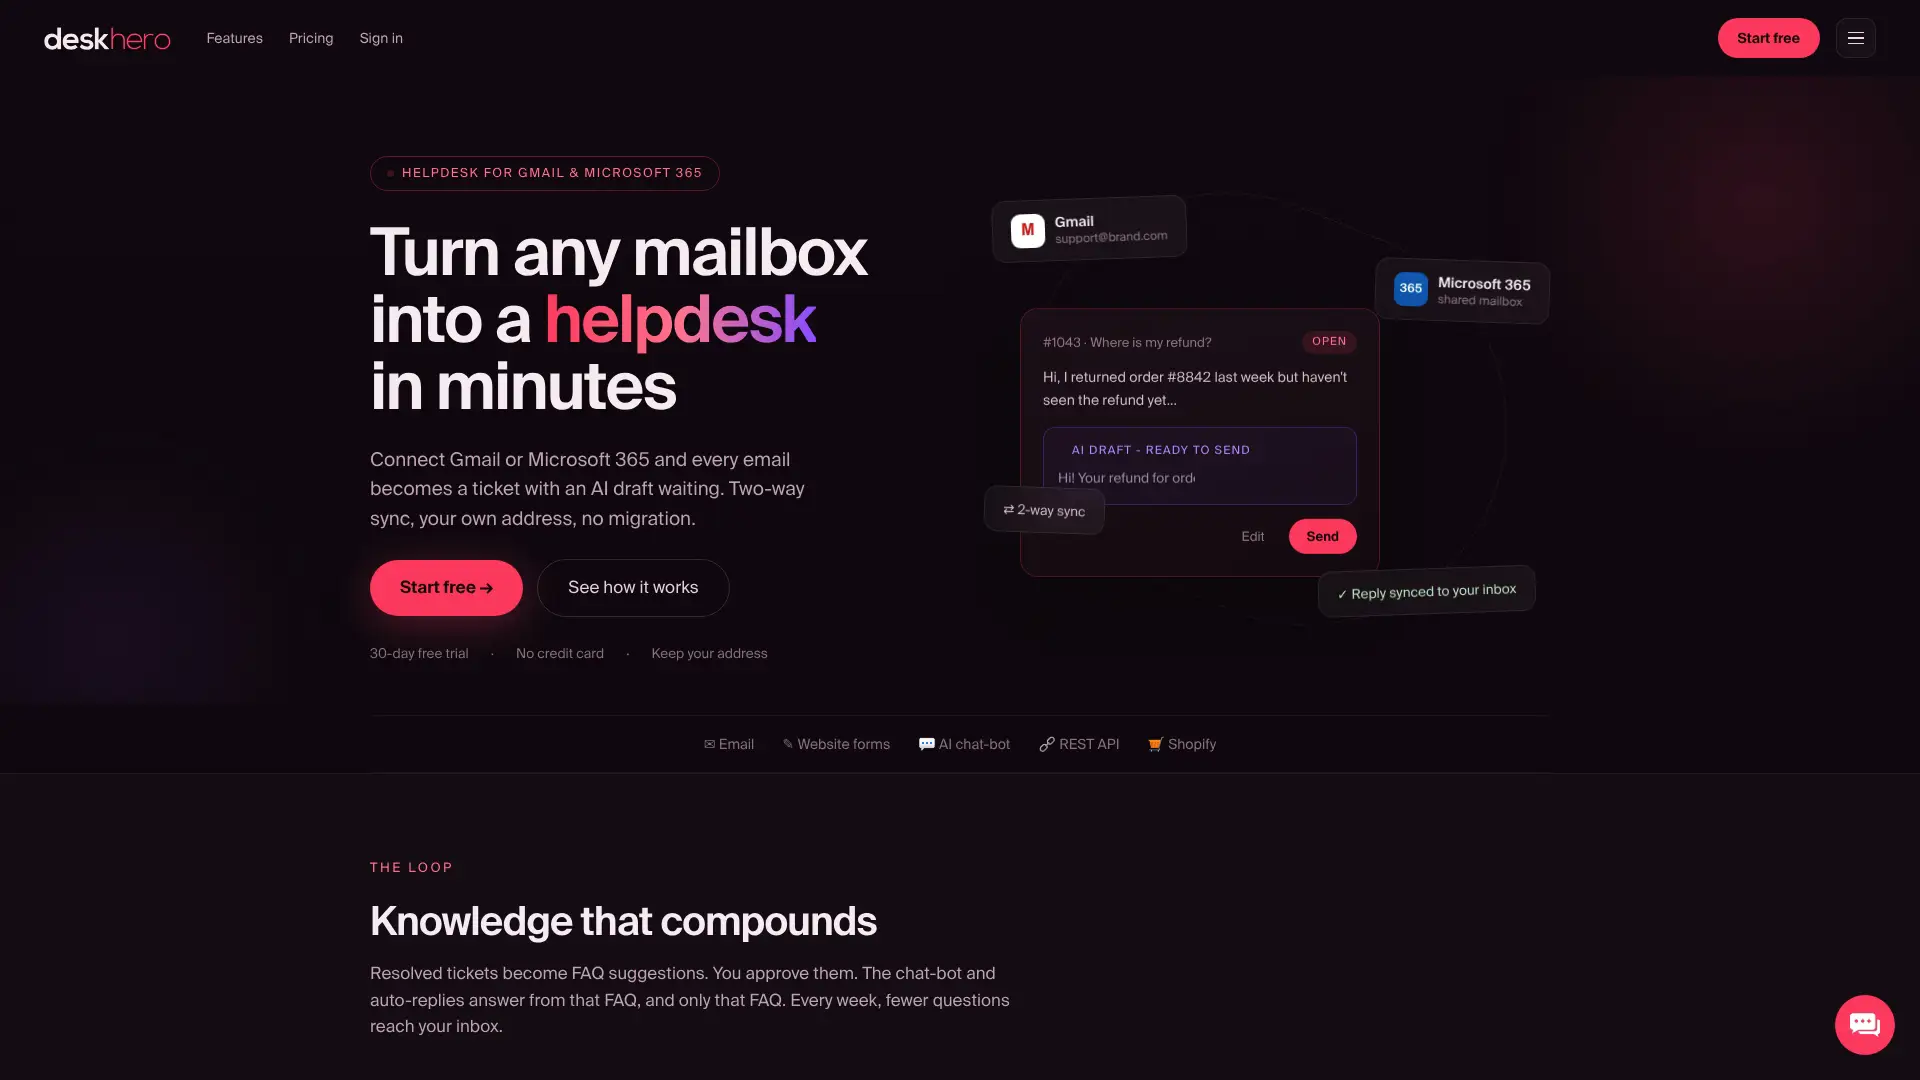
Tweerichtings-e-mailsynchronisatie houdt binnenkomende berichten en antwoorden bij in de ticketgeschiedenis die voor rapportage over responstijden wordt gebruikt. Concepten voor AI-antwoorden maken gebruik van kennis uit de werkruimte, waaronder beantwoorde tickets, interne kennis, goedgekeurde openbare FAQ-items, gescande webpagina’s en gekoppelde Shopify-productgegevens. Het onderdeel Statistics biedt vaste grafiek- en tabelweergaven met Excel-export per tabblad. Voor e-commerceteams plaatst het Shopify-klantpaneel klant- en ordercontext in de zijbalk van het ticket.
Als je een klein of middelgroot team bent dat overstapt van een gedeelde inbox naar gestructureerde rapportage, kun je zonder creditcard een gratis proefperiode van 30 dagen starten en ticketvolume-, responsduur-, oplostijd-, SLA-, kanaal- en teamweergaven bekijken zonder eerst een spreadsheet te bouwen.
Bronnen
- Gids voor helpdeskrankage en dashboards 2026 | HelpDeskFocus
- Helpdesk-KPI’s en metrics: 10 essentiële benchmarks | Softabase
Deze referenties bieden aanvullende definities en voorbeelden. Controleer de methodologie van elke bron en pas benchmarks aan je eigen operatie aan.
Veelgestelde vragen
Wat zijn de belangrijkste metrics voor servicdeskrankage?
De kernset bestaat uit eerste reactietijd, MTTR, oplossing bij het eerste contact, CSAT, SLA-naleving, ticketvolume en achterstand, heropeningspercentage en kosten per ticket, voor nauwkeurigheid gesegmenteerd op kanaal, prioriteit en categorie.
Wat zijn de vijf belangrijkste CX-metrics?
Definities verschillen per organisatie, maar een praktische shortlist omvat CSAT, oplossing bij het eerste contact, eerste reactietijd, SLA-naleving en een relatiemetric zoals Net Promoter Score. Kies metrics met duidelijke definities en eigenaars.
Wat zijn enkele voorbeelden van KPI’s voor een IT-helpdesk?
Sterke KPI’s voor een IT-helpdesk zijn SLA-naleving per ticketniveau, MTTR per prioriteit, achterstandsratio, kosten per ticket en het heropeningspercentage binnen 48 uur, omdat deze direct verband houden met zowel servicekwaliteit als operationele kosten.
Wat zijn goede KPI’s voor een IT-afdeling?
Naast helpdeskspecifieke cijfers houden IT-afdelingen vaak systeemuptime, gemiddelde tijd tot detectie en oplossing van incidenten en het percentage mislukte wijzigingen bij, naast standaardmetrics voor support zoals FRT en CSAT, om zowel dienstverlening als infrastructuurb betrouwbaarheid vast te leggen.
Hoe vaak moeten helpdeskrankagerapporten worden beoordeeld?
Stel dagelijkse waarschuwingen in voor drempelwaarden rond SLA-overschrijdingen en volumepieken, bespreek wekelijks een gestructureerd rapport met je team en maak maandelijks een bedrijfsrapport voor managers waarin maand-op-maand- en jaar-op-jaartrends worden bijgehouden.
Kan helpdesksoftware deze metrics automatisch berekenen?
Ja. Deskhero biedt vaste rapportage voor tickettrends, responstijden, SLA-naleving, teamactiviteit, AI en automatisering, kanalen en onderwerpen. Voor CSAT, FCR, het heropeningspercentage en kosten per ticket is afzonderlijke meting nodig, tenzij het gekozen platform deze expliciet ondersteunt.