Qué métricas de informes del helpdesk importan realmente
Si esta semana solo vas a crear una cosa, crea un panel de control semanal de una página para managers que muestre las ocho métricas a tu equipo cada lunes por la mañana. Todo lo demás, incluidos los widgets de usuario por hora y las presentaciones trimestrales para ejecutivos, puede esperar hasta que ese informe único sea fiable.
Esto es lo que realmente te dice cada métrica:
- Tiempo de primera respuesta responde a la pregunta: ¿cuánto esperan los clientes para recibir una respuesta humana?
- MTTR responde a la pregunta: ¿cuánto tarda realmente en cerrarse un problema, de principio a fin?
- Resolución en el primer contacto responde a la pregunta: ¿los usuarios resuelven los problemas al primer intento o los tickets van pasando de un lado a otro?
- CSAT responde a la pregunta: ¿están satisfechos los clientes con la forma en que se gestionó su problema?
- Cumplimiento de SLA responde a la pregunta: ¿estás cumpliendo las promesas de respuesta y resolución que hiciste?
- Volumen de tickets y acumulación responden a la pregunta: ¿la demanda entrante está superando la capacidad de tu equipo?
- Índice de reapertura responde a la pregunta: ¿los tickets “resueltos” siguen realmente resueltos?
- Coste por ticket responde a la pregunta: ¿cuánto le cuesta al negocio cada interacción de soporte?
Ninguna de estas cifras significa demasiado por sí sola. Un FRT rápido combinado con un FCR bajo solo significa que respondes rápidamente y te equivocas. La verdadera habilidad en las métricas de informes del helpdesk consiste en elegir las combinaciones adecuadas, segmentarlas correctamente y dirigir la vista correcta a la persona adecuada.
Conclusiones clave
Un reporting fiable del helpdesk se reduce a realizar un seguimiento constante de ocho métricas principales, segmentarlas correctamente y enviar la vista adecuada al público correcto con una frecuencia fija.
| Punto | Detalles |
|---|---|
| Empieza con ocho métricas | Haz seguimiento del FRT, MTTR, FCR, CSAT, cumplimiento de SLA, ratio de acumulación, índice de reapertura y coste por ticket. |
| Crea primero el panel semanal | Un informe de managers de una página es mejor que un sistema interminable con múltiples pestañas que nadie consulta. |
| Adapta los paneles al público | Los ejecutivos necesitan tendencias, los managers necesitan vistas operativas diarias y los usuarios necesitan colas personales en tiempo real. |
| Combina métricas para detectar manipulaciones | Observa el FCR junto con el índice de reapertura, y el FRT junto con el CSAT, para ver el panorama completo. |
| Deskhero ofrece vistas de informes fijas | Su área de Statistics cubre las tendencias de tickets, los tiempos de respuesta, el SLA, la actividad del equipo, la IA y la automatización, los canales y los temas. |
Tabla de contenidos
- Métricas de reporting del helpdesk frente a KPI: ¿cuál es la diferencia?
- Métricas principales del helpdesk: definiciones, fórmulas y referencias
- Cómo medir correctamente y evitar errores habituales
- Diseña paneles según el público: vistas para ejecutivos, managers y usuarios
- Frecuencia de los informes y plantillas de informes de ejemplo
- Convertir las señales de las métricas en acciones
- Gobernanza de datos: cómo asegurarte de que las cifras son fiables
- Poner en marcha estos informes sin trabajo manual
- Fuentes
- Preguntas frecuentes
Métricas de reporting del helpdesk frente a KPI: ¿cuál es la diferencia?
Una métrica es cualquier cifra que puedas medir. Un KPI es una métrica que tu organización ha decidido que es lo bastante importante como para fijarle un objetivo y actuar sobre ella periódicamente. El volumen de tickets es una métrica. “Mantener el volumen medio de tickets por debajo de 40 por usuario y día” es un KPI. Una referencia, por su parte, es un punto de comparación externo, como la media del sector, que te indica si tu objetivo de KPI es realista en primer lugar.
Esta distinción es importante porque los equipos de soporte pueden recopilar muchas métricas sin decidir cuáles merecen un objetivo y una respuesta periódica. Un conjunto básico y compacto es más fácil de revisar de forma constante. Añade una medida solo cuando alguien sea responsable de ella y sepa qué acción debe desencadenar un cambio.
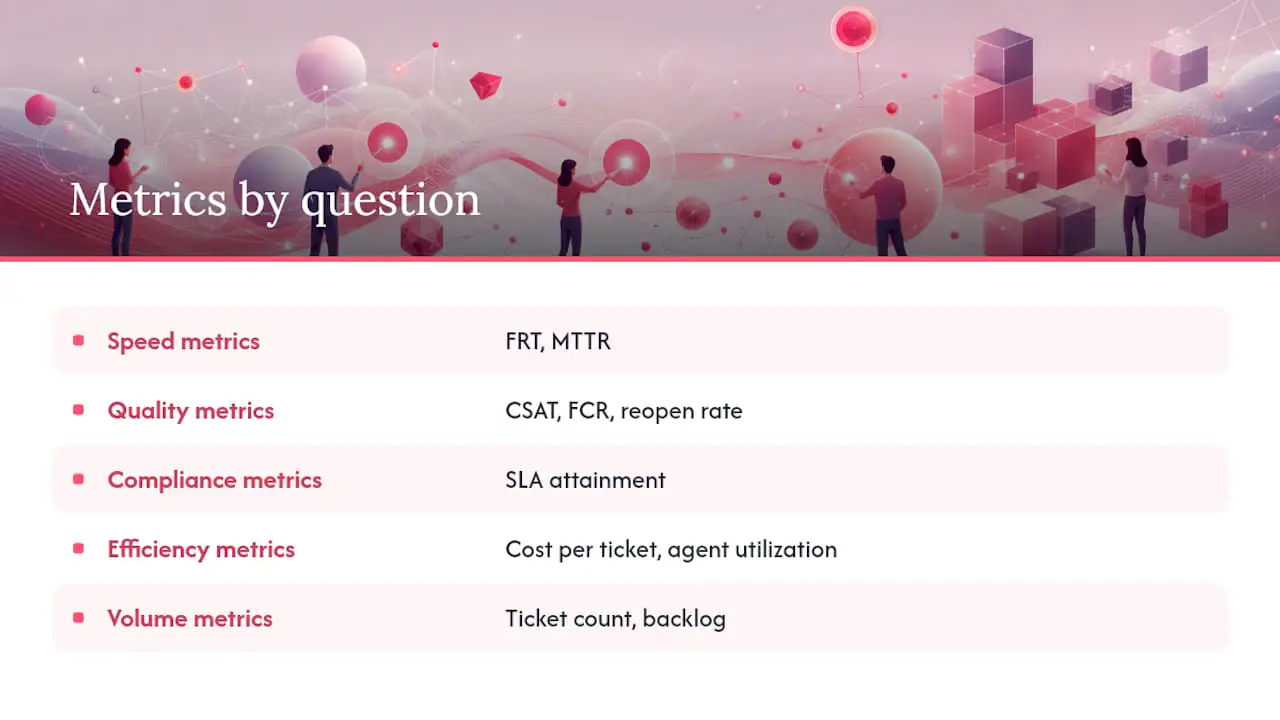
Agrupa tus métricas según la pregunta a la que responden y el diseño de los informes será mucho más sencillo:
Las métricas de velocidad (FRT, MTTR) te indican a qué velocidad avanza el equipo. Las métricas de calidad (CSAT, FCR, índice de reapertura) te indican si esa velocidad produce buenos resultados. Las métricas de cumplimiento (cumplimiento del SLA) te indican si estás cumpliendo las promesas contractuales o internas. Las métricas de eficiencia (coste por ticket, utilización del equipo) te indican cuánto cuesta gestionar la operación. Las métricas de volumen (cantidad de tickets, acumulación) te informan sobre la demanda.
Por lo general, a los ejecutivos les interesan las tendencias de eficiencia y calidad a lo largo de varios meses. Los managers necesitan consultar a diario o semanalmente las vistas de cumplimiento y volumen. Los usuarios necesitan métricas de velocidad y calidad limitadas a su propia cola. Mezclar a todos los públicos en un mismo panel puede ocultar la información que necesita cada persona.
Métricas principales del helpdesk: definiciones, fórmulas y referencias
Aquí tienes la hoja de referencia. Define cada métrica de forma explícita, segmenta siguiendo estas líneas y establece objetivos a partir de tus propios compromisos de servicio y tu línea base histórica.
El tiempo de primera respuesta (FRT) mide el tiempo transcurrido entre la creación de un ticket y la primera respuesta humana sustancial. Informa tanto de la mediana como de un percentil superior cuando sea posible, y excluye las confirmaciones automáticas. Segmenta por canal y prioridad porque los clientes tienen expectativas diferentes para el correo electrónico, el chat y el teléfono.
El tiempo de resolución, que a menudo se resume como tiempo medio de resolución (MTTR), mide el ciclo desde la creación del ticket hasta su resolución o cierre. Informa de la mediana junto con la media o en lugar de esta cuando un pequeño número de tickets complejos pueda distorsionar el resultado. Segmenta por prioridad y tipo de problema, y define cómo afecta al contador el tiempo de espera del cliente.
La resolución en el primer contacto (FCR) mide la proporción de tickets resueltos sin una interacción de seguimiento. Define claramente qué significa “primer contacto” y, después, segmenta por categoría y antigüedad del usuario para que los cambios en la combinación de tickets no se hagan pasar por cambios en el rendimiento.
La satisfacción del cliente (CSAT) mide la proporción de respuestas positivas en las encuestas. Muestra el número de respuestas y la tasa de respuesta junto a la puntuación, porque una muestra pequeña o autoseleccionada puede inducir a error. Segmenta por categoría del problema antes de comparar usuarios.
El cumplimiento del SLA mide el porcentaje de tickets que cumplen los compromisos definidos de tiempo de respuesta y resolución. Segmenta por nivel de SLA y tipo de contrato del cliente; combinar los SLA empresariales y los de niveles gratuitos en una sola cifra oculta la realidad.
El volumen de tickets y la acumulación miden la demanda entrante y la cola de trabajo sin resolver. Haz un seguimiento de la acumulación tanto como recuento bruto como en forma de ratio (tickets abiertos divididos por la capacidad media diaria de resolución) para ver si la cola crece más rápido de lo que el equipo puede vaciarla.
El índice de reapertura mide el porcentaje de tickets resueltos que se vuelven a abrir dentro de un periodo definido, normalmente de 48 a 72 horas. Segmenta por usuario y categoría. Esta es la métrica que mantiene honesto al FCR.
El coste por ticket mide el coste operativo total del soporte dividido por el volumen de tickets durante un periodo determinado. Segmenta por canal, ya que el soporte telefónico normalmente cuesta mucho más por ticket que el correo electrónico o el chat.
| Métrica | Fórmula | Segmentar por | Punto de partida de referencia |
|---|---|---|---|
| Tiempo de primera respuesta | Tiempo hasta la primera respuesta humana | Canal, prioridad | Establecer según el canal y el horario de soporte |
| MTTR (mediana) | Tiempo desde la apertura hasta el cierre | Nivel de prioridad | Establecer según la prioridad y el tipo de problema |
| Resolución en el primer contacto | Cierres en el primer contacto ÷ total de tickets | Categoría, antigüedad del usuario | Usar una línea base histórica |
| CSAT | Respuestas positivas ÷ total de respuestas | Usuario, categoría | Mostrar la puntuación, las respuestas y la tasa de respuesta |
| Cumplimiento del SLA | Tickets cumplidos ÷ total de tickets | Nivel de SLA, tipo de contrato | Establecer por contrato |
| Índice de reapertura | Tickets reabiertos ÷ tickets resueltos | Usuario, categoría | Combinar con el FCR |
Dos métricas solo tienen sentido juntas: la resolución en el primer contacto y el índice de reapertura en un plazo de 48 horas. Un FCR alto combinado con un índice de reapertura creciente significa que los usuarios están cerrando tickets para alcanzar un objetivo, no porque el problema esté realmente solucionado.
Cómo medir correctamente y evitar errores habituales
La precisión en la forma de calcular una métrica importa más que la métrica que elijas. Utiliza la mediana en lugar de la media para cualquier métrica temporal con una cola larga, lo que en la práctica significa casi todas las cifras de tiempo de resolución que informes. Un solo ticket que tarde tres semanas en cerrarse porque está atascado esperando a un proveedor hará subir tu tiempo medio de resolución de una forma que representa incorrectamente el rendimiento de todo el equipo.
Cuenta la primera respuesta humana como tu FRT, no la confirmación automática de “hemos recibido tu mensaje”. Si tu sistema registra la respuesta automática como el primer contacto, tus cifras de FRT parecerán artificialmente rápidas y ocultarán un problema real de personal. Define explícitamente tu ventana de reapertura, ya sea de 24, 48 o 72 horas, y aplícala de forma coherente en todas las categorías para que compares elementos equivalentes. Alinea el reloj de tus informes con tu horario de soporte real; un ticket enviado el viernes a las 23:00 y respondido el lunes a las 9:00 no debería contar igual que un incumplimiento de tres días durante el horario laboral si tu equipo no trabaja los fines de semana.
Un error habitual es calcular la media de una métrica entre canales que funcionan de manera diferente. Combinar el FRT del correo electrónico con el FRT del chat produce una cifra que no describe bien a ninguno de los dos canales. Otro error es informar de la resolución en el primer contacto sin el índice de reapertura, lo que puede recompensar los cierres prematuros. El CSAT también necesita su tamaño de muestra y su tasa de respuesta, no solo la puntuación principal.
Consejo profesional: Haz una comprobación rápida de coherencia antes de presentar un informe. Selecciona algunos tickets marcados como “dentro del SLA” y compara sus marcas de tiempo con el informe. Cualquier discrepancia merece una investigación antes de utilizar la cifra para tomar una decisión.
Consulta el FRT junto al CSAT, y el ratio de acumulación junto al recuento de incumplimientos del SLA. Estas combinaciones detectan problemas que una sola cifra oculta. Un equipo puede cumplir todos los objetivos de SLA sobre el papel mientras la acumulación se triplica silenciosamente, porque el cumplimiento del SLA mide los tickets que gestionaste, no los que se amontonan detrás.
Diseña paneles según el público: vistas para ejecutivos, managers y usuarios
Los distintos públicos necesitan vistas diferentes. Un panel creado para la carga de trabajo actual de un usuario contiene demasiados detalles para un ejecutivo que evalúa tendencias trimestrales, mientras que una vista ejecutiva estratégica cambia demasiado despacio para ayudar a alguien a gestionar la cola de hoy.
Los ejecutivos necesitan líneas de tendencia, no contadores en directo. Incluye en su vista la tendencia del CSAT a lo largo del tiempo, el coste por ticket mensual, el volumen de tickets comparado con el número de empleados, la tendencia trimestral del MTTR, la tendencia del cumplimiento del SLA y la trayectoria general de la acumulación. Consultan esta información mensualmente, y a veces semanalmente, para comprobar si la función de soporte está creciendo de forma saludable junto con el negocio.
Los managers necesitan detalles operativos actualizados a diario. Su panel debería mostrar los tickets abiertos por prioridad en tiempo real, el cumplimiento del SLA desglosado por categoría, la distribución de la carga de trabajo de los usuarios, el volumen de tickets de hoy comparado con la media diaria, la distribución por antigüedad de la acumulación y el índice de reapertura por usuario. Esta es la vista que impulsa las decisiones de personal y las reuniones diarias de triaje.
Los usuarios necesitan una vista limitada, personal y en tiempo real: sus propios tickets abiertos con temporizadores de cuenta atrás del SLA, su puntuación personal de CSAT, su tasa de FCR y una cola de tickets pendientes de su respuesta ordenados por urgencia. Todo lo que vaya más allá de su propia carga de trabajo es ruido que los ralentiza.
| Tipo de panel | Frecuencia de actualización | Horizonte temporal | Métricas clave | Público principal |
|---|---|---|---|---|
| Operativo en tiempo real | En directo a cada hora | Hoy | Tickets abiertos, temporizadores de SLA, profundidad de la cola | Usuarios, managers |
| Táctico semanal | Diaria a semanal | Esta semana frente a la anterior | Volumen, ratio de acumulación, carga de trabajo de los usuarios | Managers |
| Tendencia estratégica | Semanal a mensual | Mes/trimestre/año | Tendencia del CSAT, coste por ticket, MTTR | Ejecutivos |
Las vistas operativas en tiempo real ayudan a los managers a redistribuir el trabajo antes de que una cola incumpla sus objetivos. Los informes históricos cumplen otra función: muestran si la carga de trabajo, la calidad y los patrones de respuesta están mejorando con el tiempo.
La mayoría de los equipos pequeños y medianos no necesitan integrar de inmediato una solución completa de BI. Los informes integrados del helpdesk pueden cubrir las revisiones operativas y semanales. Añade una herramienta como Looker Studio o Power BI cuando necesites combinar los datos de soporte con los ingresos, el personal u otros sistemas empresariales. Para muchos equipos, un panel de atención al cliente específico es suficiente para una revisión semanal.
Tu lista de comprobación de KPI de una página para una revisión semanal debería caber sin desplazarte: FRT, MTTR (mediana), FCR, CSAT, cumplimiento del SLA, ratio de acumulación, índice de reapertura y coste por ticket. Ocho cifras, una pantalla, sin tener que buscar.
Frecuencia de los informes y plantillas de informes de ejemplo
La frecuencia debe adaptarse a la rapidez con la que una métrica puede cambiar de forma significativa y a la rapidez con la que alguien debe actuar sobre ella. Esta es una estructura que puedes copiar directamente.
-
Alertas diarias. Configura activadores para los tickets que se aproximen a una fecha límite del SLA, los cambios inusuales en el volumen y el crecimiento de la cola de prioridad crítica. Elige los umbrales a partir de tu línea base operativa y envía alertas a través de los canales que tu equipo supervise activamente.
-
Informe semanal para managers. Estructúralo como esta semana frente a la semana pasada frente a la misma semana del año anterior, con una explicación de dos frases al principio que describa el cambio más importante. Continúa con las cinco categorías principales de tickets por volumen, una vista de la carga de trabajo de los usuarios que muestre dónde la capacidad es limitada y el conjunto básico de KPI (FRT, tiempo de resolución, FCR, CSAT, cumplimiento del SLA, ratio de acumulación). Envíalo antes de la revisión semanal del equipo.
-
Informe empresarial mensual. Diseñado para directores y ejecutivos, cubre las tendencias intermensuales e interanuales de las mismas métricas principales, el coste por ticket por canal, un análisis de personal que compare el número de empleados con el crecimiento del volumen y una breve nota de riesgos futuros, como el próximo lanzamiento de un producto que previsiblemente disparará el volumen de tickets. Este es el informe que justifica —o cuestiona— las solicitudes de personal.
Muchas plataformas de helpdesk ofrecen vistas operativas prediseñadas. Utilízalas como punto de partida, elimina después los campos sobre los que nadie actúa y define cada cálculo antes de usarlo como KPI.
Convertir las señales de las métricas en acciones
Un informe que simplemente permanece en una bandeja de entrada es un esfuerzo desperdiciado. Cada métrica que avance en la dirección equivocada debería desencadenar una respuesta específica y asignada, no una conversación vaga sobre “vigilarla”.
Acumulación creciente. Comprueba primero si se trata de un problema de volumen o de rendimiento. Si el volumen ha aumentado, despliega un equipo temporal de triaje o abre una vía de desvío de autoservicio mediante un chatbot de IA para las preguntas habituales. Si el rendimiento ha disminuido, comprueba si existe una carencia de formación o una regla de enrutamiento defectuosa. Responsable: manager de soporte. Supervisa el ratio de acumulación diariamente durante una semana después de aplicar la solución.
Descenso del FCR. Extrae las categorías que están haciendo bajar la cifra y comprueba si existe una carencia de conocimientos. A menudo se trata de uno o dos tipos de problemas que pasan repetidamente de un usuario a otro. Actualiza la base de conocimientos interna con una ruta de resolución clara para esa categoría y vuelve a formar al equipo. Responsable: líder del equipo. Vuelve a comprobar el FCR por categoría después de dos semanas, no de inmediato, ya que los usuarios necesitan tiempo para interiorizar las nuevas indicaciones.
Descenso del CSAT. Compara el cambio con el FRT y el tiempo de resolución del mismo periodo para comprobar si un servicio más lento está contribuyendo al problema. Si la velocidad se mantiene estable, lee los tickets con respuestas negativas y agrupa los motivos. Responsable: manager. Revisa la puntuación junto con el número de respuestas y la tasa de respuesta.
Índice de reapertura creciente. Compáralo con el FCR. La combinación puede indicar que los tickets se están cerrando antes de que el problema se haya resuelto por completo. Revisa las categorías y los tickets afectados antes de cambiar la formación o los incentivos. Responsable: manager. Supervisa semanalmente.
Coste por ticket creciente. Comprueba primero la combinación de canales, porque el teléfono, el correo electrónico y el chat tienen estructuras de costes diferentes. Si la combinación se mantiene estable, examina el personal, las horas extra, las herramientas y la complejidad de los casos. Responsable: director. Revísalo mensualmente porque esta métrica normalmente cambia más despacio que las medidas de las colas.
Consejo profesional: Elige un periodo de evaluación antes de realizar un cambio. Debe ser lo bastante largo como para incluir un volumen representativo de tickets y al menos un ciclo normal de informes.
Los cambios en el enrutamiento y la documentación pueden afectar a las métricas operativas antes que una contratación o una revisión completa de la formación. Adapta el periodo de revisión a la intervención y al volumen de tickets en lugar de declarar el éxito basándote en un único día bueno.
Gobernanza de datos: cómo asegurarte de que las cifras son fiables
Nada de esto funciona si los datos subyacentes son incorrectos, y normalmente lo son en algún punto. Cada métrica principal necesita una persona responsable de su definición, un método de cálculo documentado que no cambie sin previo aviso, una frecuencia de actualización definida y una regla para gestionar los datos ausentes o con formato incorrecto.
Crea una lista de comprobación breve de gobernanza y revísala trimestralmente:
- Asigna un responsable a cada métrica que apruebe cualquier cambio en su definición.
- Documenta la fórmula de cálculo exacta en un lugar que todo el equipo pueda consultar, no solo en la cabeza de un manager.
- Establece una frecuencia fija de actualización de datos y genera una alerta ante cualquier interrupción de esa frecuencia, ya que una canalización de datos averiada y silenciosa es peor que no tener ningún informe.
- Establece un número o una tasa de respuesta mínimos antes de publicar el CSAT, basándote en tu volumen de tickets y en el nivel de confianza deseado.
- Realiza auditorías periódicas de muestras de tickets, seleccionando entre 10 y 15 tickets aleatorios al mes y comprobando manualmente sus marcas de tiempo y categorización frente al informe.
- Investiga los cambios repentinos que no tengan un evento operativo correspondiente, ya que pueden indicar un problema de definición, etiquetado o integración.
Para las referencias, prefiere fuentes que publiquen su metodología y muestra. Utiliza las cifras externas solo como contexto y establece después los objetivos a partir de tus propios compromisos de servicio, combinación de tickets, horario de soporte y línea base histórica.
Una nota práctica para hacerlo bien
La mayoría de los equipos fracasan en el reporting del helpdesk no porque elijan las métricas equivocadas, sino porque intentan hacer seguimiento de veinte desde el primer día y abandonan todo el esfuerzo al cabo de un mes. Ocho métricas seguidas de forma constante y que generan acciones cada semana te enseñarán más sobre tu operación de soporte que treinta métricas consultadas ocasionalmente.
Empieza con el panel semanal de managers de una página. Hazlo bien durante un mes antes de ocuparte de los informes ejecutivos o crear widgets individuales para los usuarios. Es tentador crear el sistema completo desde el primer día porque las herramientas lo facilitan, pero la disciplina de observar atentamente ocho cifras supera a la ilusión de observar treinta.
Para un equipo pequeño o mediano sin una persona dedicada al análisis, Deskhero ofrece vistas fijas de Statistics para tendencias, tiempos de respuesta, SLA, actividad del equipo, IA y automatización, canales y temas.
Poner en marcha estos informes sin trabajo manual
Gran parte de la fricción del reporting del helpdesk procede de conversaciones dispersas, campos de tickets incoherentes y trabajo repetido en hojas de cálculo. Deskhero conecta los buzones de Gmail o Microsoft 365 con un helpdesk compartido. Su área de Statistics informa sobre las tendencias de los tickets, los tiempos de respuesta, el cumplimiento del SLA, la actividad del equipo, los canales, la IA y la automatización, y los patrones de temas.
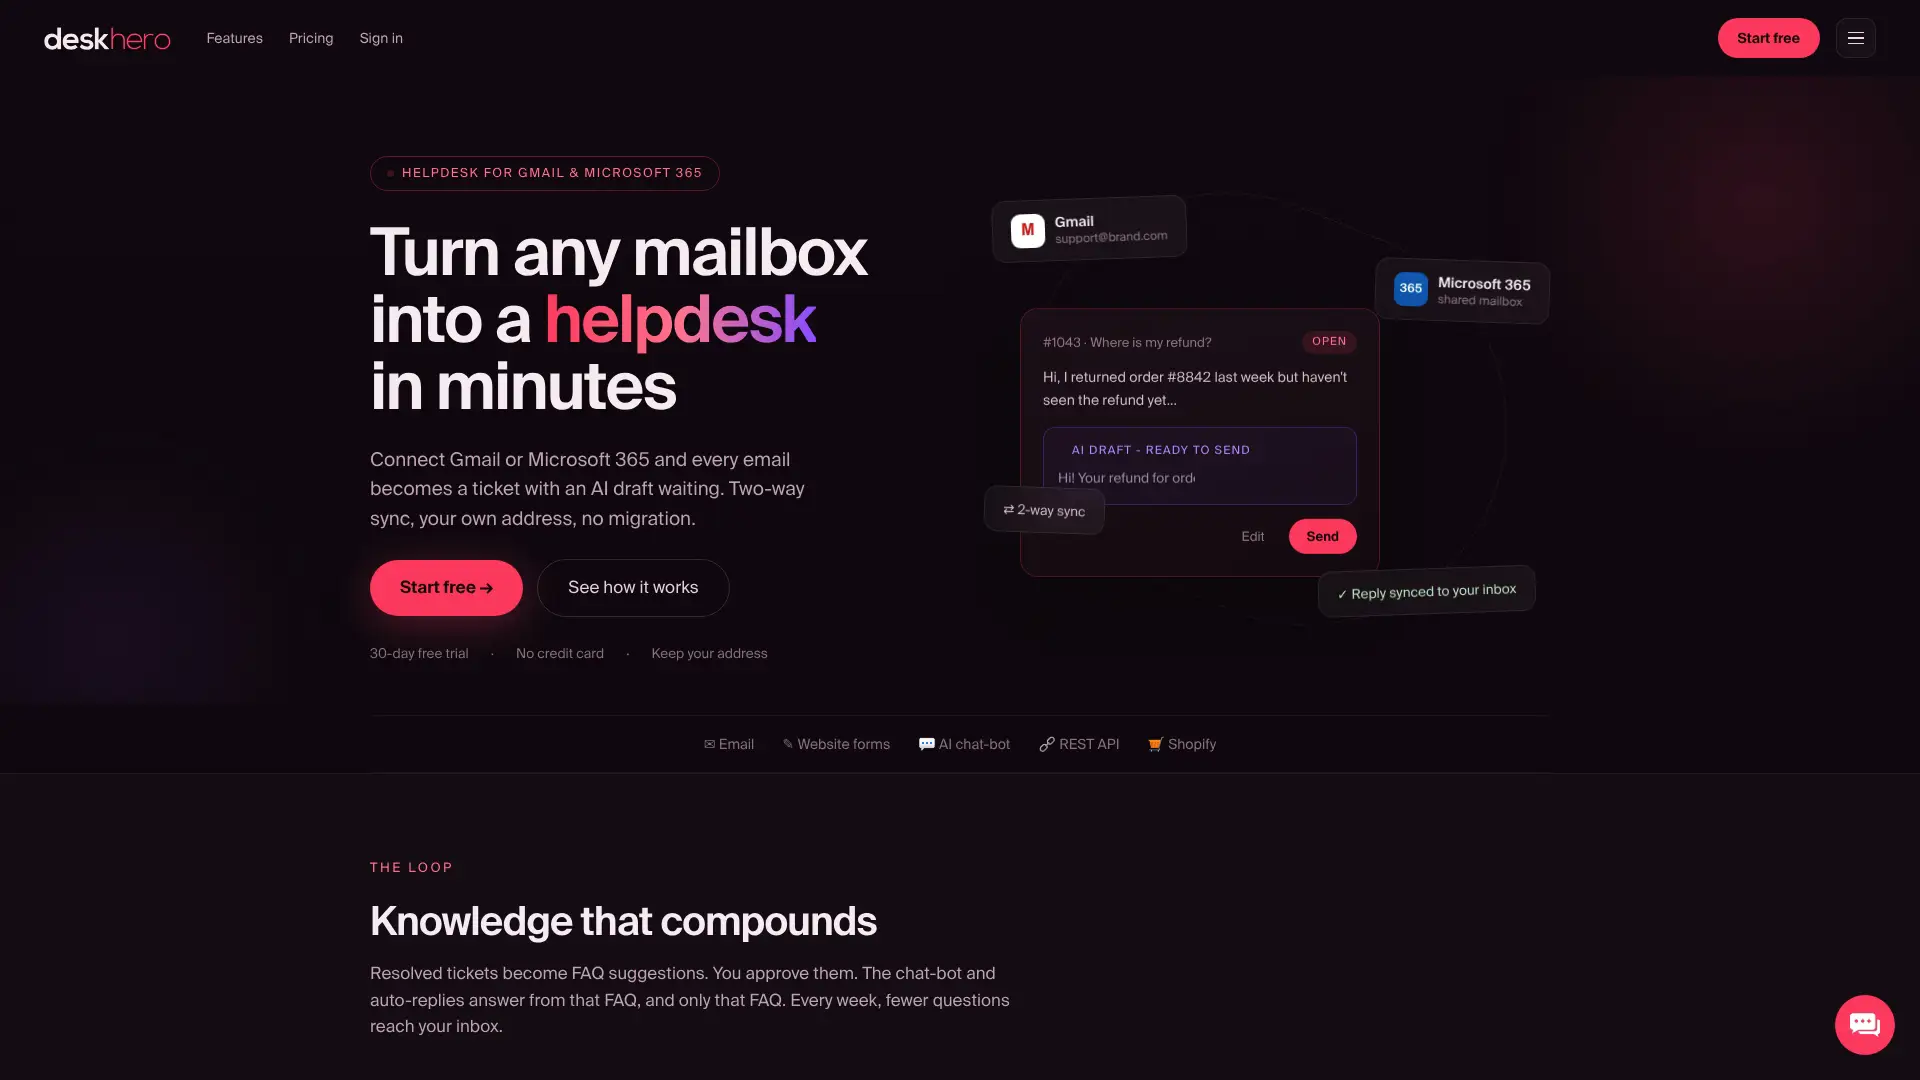
La sincronización bidireccional del correo electrónico mantiene los mensajes entrantes y las respuestas en el historial del ticket utilizado para elaborar informes sobre los tiempos de respuesta. Los borradores de respuestas de IA se basan en los conocimientos del espacio de trabajo, incluidos los tickets respondidos, la base de conocimientos interna, las entradas aprobadas de las preguntas frecuentes públicas, las páginas extraídas del sitio web y los datos de productos conectados de Shopify. El área de Statistics ofrece vistas fijas de gráficos y tablas, con exportación a Excel por pestaña. Para los equipos de comercio electrónico, el panel de clientes de Shopify coloca el contexto del cliente y del pedido en la barra lateral del ticket.
Si eres un equipo pequeño o mediano que está pasando de una bandeja de entrada compartida a un reporting estructurado, puedes iniciar una prueba gratuita de 30 días sin tarjeta de crédito y revisar las vistas de volumen de tickets, tiempo de respuesta, tiempo de resolución, SLA, canales y equipo sin crear primero una hoja de cálculo.
Fuentes
- Guía de reporting y paneles del helpdesk 2026 | HelpDeskFocus
- KPI y métricas del helpdesk: 10 referencias esenciales | Softabase
Estas referencias ofrecen definiciones y ejemplos adicionales. Comprueba la metodología de cada fuente y adapta cualquier referencia a tu propia operación.
Preguntas frecuentes
¿Cuáles son las métricas clave para los informes del service desk?
El conjunto básico incluye el tiempo de primera respuesta, MTTR, resolución en el primer contacto, CSAT, cumplimiento del SLA, volumen de tickets y acumulación, índice de reapertura y coste por ticket, segmentados por canal, prioridad y categoría para garantizar la precisión.
¿Cuáles son las 5 métricas clave de CX?
Las definiciones varían según la organización, pero una lista práctica incluye CSAT, resolución en el primer contacto, tiempo de primera respuesta, cumplimiento del SLA y una medida de relación como el Net Promoter Score. Elige medidas que tengan definiciones y responsables claros.
¿Cuáles son algunos ejemplos de KPI para un helpdesk de TI?
Entre los KPI sólidos para un helpdesk de TI se incluyen el cumplimiento del SLA por nivel de ticket, el MTTR por prioridad, el ratio de acumulación, el coste por ticket y el índice de reapertura en un plazo de 48 horas, ya que están directamente relacionados tanto con la calidad del servicio como con el coste operativo.
¿Cuáles son buenos KPI para un departamento de TI?
Además de las cifras específicas del helpdesk, los departamentos de TI suelen hacer seguimiento del tiempo de actividad de los sistemas, el tiempo medio de detección y resolución de incidentes y el índice de fallos de cambios, junto con las métricas de soporte habituales, como el FRT y el CSAT, para reflejar tanto la prestación del servicio como la fiabilidad de la infraestructura.
¿Con qué frecuencia deben revisarse los informes del helpdesk?
Configura alertas diarias para los umbrales de incumplimiento del SLA y los picos de volumen, revisa semanalmente un informe estructurado con tu equipo y prepara un informe empresarial mensual para los directores que haga seguimiento de las tendencias intermensuales e interanuales.
¿Puede el software de helpdesk calcular automáticamente estas métricas?
Sí. Deskhero ofrece informes fijos sobre tendencias de tickets, tiempos de respuesta, cumplimiento del SLA, actividad del equipo, IA y automatización, canales y temas. El CSAT, el FCR, el índice de reapertura y el coste por ticket requieren una medición independiente, a menos que la plataforma elegida los admita explícitamente.