Quels indicateurs de reporting du helpdesk comptent vraiment
Si vous ne devez construire qu’une seule chose cette semaine, créez un tableau de bord hebdomadaire pour les responsables, sur une page, qui présente ces huit indicateurs à votre équipe chaque lundi matin. Tout le reste, y compris les widgets horaires destinés aux utilisateurs et les présentations trimestrielles pour les dirigeants, peut attendre que ce rapport unique soit fiable.
Voici ce que chaque indicateur vous apprend réellement :
- Délai de première réponse répond à la question suivante : combien de temps les clients attendent-ils avant d’obtenir une réponse humaine ?
- MTTR répond à la question suivante : combien de temps faut-il réellement pour clôturer un problème, du début à la fin ?
- Résolution au premier contact répond à la question suivante : les utilisateurs résolvent-ils les problèmes dès leur première demande ou les tickets sont-ils transférés d’un interlocuteur à l’autre ?
- CSAT répond à la question suivante : les clients sont-ils satisfaits de la manière dont leur problème a été traité ?
- Respect des SLA répond à la question suivante : respectez-vous les engagements de réponse et de résolution que vous avez pris ?
- Volume de tickets et backlog répondent à la question suivante : la demande entrante dépasse-t-elle la capacité de votre équipe ?
- Taux de réouverture répond à la question suivante : les tickets « résolus » restent-ils effectivement résolus ?
- Coût par ticket répond à la question suivante : combien chaque interaction avec le support coûte-t-elle à l’entreprise ?
Aucun de ces chiffres n’a beaucoup de signification pris isolément. Un FRT rapide associé à un faible FCR signifie simplement que vous répondez rapidement, mais que vos réponses sont incorrectes. La véritable compétence en matière d’indicateurs de reporting du helpdesk consiste à choisir les bonnes combinaisons, à les segmenter correctement et à transmettre la bonne vue à la bonne personne.
Points clés à retenir
Un reporting fiable du helpdesk repose sur le suivi constant de huit indicateurs essentiels, leur segmentation correcte et la transmission de la bonne vue au bon public selon une fréquence fixe.
| Point | Détails |
|---|---|
| Commencer par huit indicateurs | Suivez le FRT, le MTTR, le FCR, le CSAT, le respect des SLA, le ratio de backlog, le taux de réouverture et le coût par ticket. |
| Créer d’abord le tableau de bord hebdomadaire | Un rapport de responsables sur une page est plus efficace qu’un système tentaculaire composé de nombreux onglets que personne ne consulte. |
| Adapter les tableaux de bord au public | Les dirigeants ont besoin des tendances, les responsables de vues opérationnelles quotidiennes et les utilisateurs de files personnelles en temps réel. |
| Associer les indicateurs pour détecter les biais | Surveillez le FCR avec le taux de réouverture, et le FRT avec le CSAT, afin d’obtenir une vision complète. |
| Deskhero propose des vues de reporting prédéfinies | Sa section Statistics couvre les tendances des tickets, les délais de réponse, les SLA, l’activité de l’équipe, l’IA et l’automatisation, les canaux et les sujets. |
Table des matières
- Indicateurs de reporting du helpdesk et KPI : quelle différence ?
- Indicateurs essentiels du helpdesk : définitions, formules et références
- Comment mesurer correctement et éviter les pièges courants
- Concevoir des tableaux de bord selon le public : vues dirigeant, responsable et utilisateur
- Fréquence des rapports et modèles de rapports
- Transformer les signaux des indicateurs en actions
- Gouvernance des données : s’assurer que les chiffres sont fiables
- Mettre ces rapports en place sans travail manuel
- Sources
- FAQ
Indicateurs de reporting du helpdesk et KPI : quelle différence ?
Un indicateur est tout chiffre que vous pouvez mesurer. Un KPI est un indicateur auquel votre organisation a décidé d’accorder suffisamment d’importance pour lui fixer un objectif et agir régulièrement en fonction de celui-ci. Le volume de tickets est un indicateur. « Maintenir le volume moyen de tickets sous 40 par utilisateur et par jour » est un KPI. Une référence, quant à elle, est un point de comparaison externe, comme une moyenne sectorielle, qui vous indique si votre objectif de KPI est réaliste au départ.
Cette distinction est importante, car les équipes de support peuvent collecter de nombreux indicateurs sans décider lesquels méritent un objectif et une réponse régulière. Un ensemble central et compact est plus facile à examiner de manière constante. N’ajoutez un indicateur que lorsqu’une personne en est responsable et sait quelle action un changement doit déclencher.
Regroupez vos indicateurs selon la question à laquelle ils répondent : la conception du reporting devient alors beaucoup plus simple :
Les indicateurs de rapidité (FRT, MTTR) vous indiquent à quelle vitesse l’équipe avance. Les indicateurs de qualité (CSAT, FCR, taux de réouverture) vous indiquent si cette rapidité produit de bons résultats. Les indicateurs de conformité (respect des SLA) vous indiquent si vous tenez vos engagements contractuels ou internes. Les indicateurs d’efficacité (coût par ticket, utilisation de l’équipe) vous indiquent combien coûte le fonctionnement de l’activité. Les indicateurs de volume (nombre de tickets, backlog) vous renseignent sur la demande.
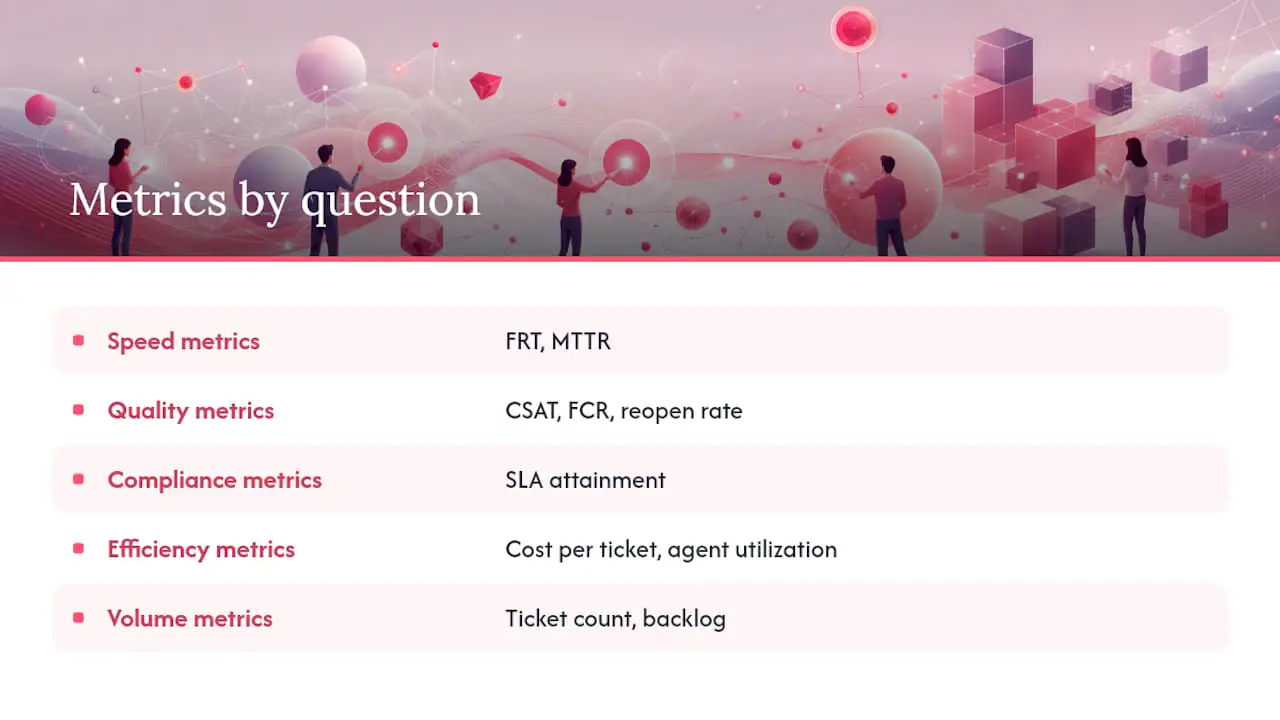
Les dirigeants s’intéressent généralement aux tendances d’efficacité et de qualité sur plusieurs mois. Les responsables ont besoin de vues sur la conformité et le volume, consultées quotidiennement ou chaque semaine. Les utilisateurs ont besoin d’indicateurs de rapidité et de qualité limités à leur propre file. Mélanger tous les publics sur un seul tableau de bord peut enfouir les informations dont chacun a besoin.
Indicateurs essentiels du helpdesk : définitions, formules et références
Voici la fiche de référence. Définissez explicitement chaque indicateur, segmentez-le selon ces axes et fixez vos objectifs à partir de vos propres engagements de service et de votre référence historique.
Le délai de première réponse (FRT) mesure le temps écoulé entre la création d’un ticket et la première réponse humaine substantielle. Indiquez à la fois la médiane et, lorsque c’est possible, un percentile élevé, et excluez les accusés de réception automatiques. Segmentez par canal et par priorité, car les attentes des clients diffèrent selon qu’il s’agit d’un e-mail, d’un chat ou d’un appel téléphonique.
Le délai de résolution, souvent résumé par le temps moyen de résolution (MTTR), mesure le cycle de vie entre la création et la résolution ou la clôture d’un ticket. Indiquez la médiane en complément de la moyenne, ou à sa place, lorsqu’un petit nombre de tickets complexes risque de fausser le résultat. Segmentez par priorité et par type de problème, et définissez l’impact de l’attente d’une réponse du client sur le calcul du délai.
La résolution au premier contact (FCR) mesure la proportion de tickets résolus sans interaction de suivi. Définissez clairement ce que signifie « premier contact », puis segmentez par catégorie et par ancienneté de l’utilisateur afin que les changements dans la composition des tickets ne soient pas pris pour des changements de performance.
La satisfaction client (CSAT) mesure la proportion de réponses positives aux enquêtes. Indiquez le nombre de réponses et le taux de réponse à côté du score, car un échantillon réduit ou constitué de répondants qui s’auto-sélectionnent peut être trompeur. Segmentez par catégorie de problème avant de comparer les utilisateurs.
Le respect des SLA mesure le pourcentage de tickets respectant vos engagements définis en matière de délai de réponse et de résolution. Segmentez par niveau de SLA et par type de contrat client ; regrouper les SLA des entreprises et ceux des offres gratuites en un seul chiffre masque la réalité.
Le volume de tickets et le backlog mesurent la demande entrante et la file de travail non résolu. Suivez le backlog à la fois comme un nombre brut et comme un ratio (tickets ouverts divisés par la capacité moyenne quotidienne de résolution), afin de voir si la file augmente plus vite que l’équipe ne peut la résorber.
Le taux de réouverture mesure le pourcentage de tickets résolus qui sont rouverts dans une période définie, généralement de 48 à 72 heures. Segmentez par utilisateur et par catégorie. C’est l’indicateur qui permet de vérifier la fiabilité du FCR.
Le coût par ticket mesure le coût total de fonctionnement du support divisé par le volume de tickets sur une période donnée. Segmentez par canal, car le support téléphonique coûte généralement bien plus cher par ticket que l’e-mail ou le chat.
| Indicateur | Formule | Segmenter par | Point de départ pour la référence |
|---|---|---|---|
| Délai de première réponse | Délai avant la première réponse humaine | Canal, priorité | À définir selon le canal et les heures de support |
| MTTR (médiane) | Délai entre l’ouverture et la clôture | Niveau de priorité | À définir selon la priorité et le type de problème |
| Résolution au premier contact | Tickets résolus au premier contact ÷ nombre total de tickets | Catégorie, ancienneté de l’utilisateur | Utiliser une référence historique |
| CSAT | Réponses positives ÷ nombre total de réponses | Utilisateur, catégorie | Afficher le score, le nombre de réponses et le taux de réponse |
| Respect des SLA | Tickets respectant le SLA ÷ nombre total de tickets | Niveau de SLA, type de contrat | À définir pour chaque contrat |
| Taux de réouverture | Tickets rouverts ÷ tickets résolus | Utilisateur, catégorie | À associer au FCR |
Deux indicateurs n’ont de sens qu’ensemble : la résolution au premier contact et le taux de réouverture dans les 48 heures. Un FCR élevé associé à un taux de réouverture en hausse signifie que les utilisateurs clôturent les tickets pour atteindre un objectif, et non parce que le problème est réellement résolu.
Comment mesurer correctement et éviter les pièges courants
La précision de votre méthode de calcul compte davantage que le choix de l’indicateur. Utilisez la médiane plutôt que la moyenne pour tout indicateur temporel présentant une longue traîne, ce qui signifie en pratique presque tous les chiffres de délai de résolution que vous communiquez. Un seul ticket qui prend trois semaines à clôturer parce qu’il attend la réponse d’un fournisseur fera augmenter votre délai moyen de résolution d’une manière qui déforme les performances de toute l’équipe.
Comptabilisez la première réponse humaine comme votre FRT, et non la confirmation automatique « nous avons bien reçu votre message ». Si votre système enregistre la réponse automatique comme premier contact, vos chiffres de FRT sembleront artificiellement rapides et masqueront un véritable problème de personnel. Définissez explicitement votre fenêtre de réouverture, qu’elle soit de 24, 48 ou 72 heures, et appliquez-la uniformément à chaque catégorie afin de comparer des situations équivalentes. Alignez votre horloge de reporting sur vos véritables heures de support ; un ticket envoyé vendredi à 23 heures et traité lundi à 9 heures ne devrait pas être considéré comme un retard de trois jours pendant les heures ouvrées si votre équipe n’assure pas de permanence le week-end.
Un piège courant consiste à calculer la moyenne d’un indicateur sur des canaux qui fonctionnent différemment. Mélanger le FRT des e-mails et celui des chats produit un chiffre qui ne décrit correctement aucun des deux canaux. Autre piège : communiquer la résolution au premier contact sans le taux de réouverture, ce qui peut encourager les clôtures prématurées. Le CSAT nécessite également d’indiquer la taille de l’échantillon et le taux de réponse, pas seulement le score principal.
Conseil de pro : Effectuez une rapide vérification de cohérence avant de présenter un rapport. Échantillonnez quelques tickets marqués « dans les délais SLA » et comparez leurs horodatages avec ceux du rapport. Toute différence mérite une enquête avant que le chiffre ne soit utilisé pour prendre une décision.
Affichez le FRT à côté du CSAT, et le ratio de backlog à côté du nombre de violations de SLA. Ces associations permettent de détecter des problèmes qu’un chiffre isolé dissimule. Une équipe peut atteindre tous ses objectifs de SLA sur le papier tandis que le backlog triple discrètement, car le respect des SLA mesure les tickets que vous avez traités, et non ceux qui s’accumulent derrière.
Concevoir des tableaux de bord selon le public : vues dirigeant, responsable et utilisateur
Les différents publics ont besoin de vues différentes. Un tableau de bord conçu pour la charge de travail actuelle d’un utilisateur est trop détaillé pour un dirigeant qui évalue les tendances trimestrielles, tandis qu’une vue stratégique destinée aux dirigeants évolue trop lentement pour aider quelqu’un à gérer la file du jour.
Les dirigeants ont besoin de courbes de tendance, pas de compteurs en temps réel. Affichez dans leur vue l’évolution du CSAT dans le temps, le coût par ticket chaque mois, le volume de tickets rapporté à l’effectif, l’évolution trimestrielle du MTTR, la tendance du respect des SLA et la trajectoire générale du backlog. Ils consultent cette vue chaque mois, parfois chaque semaine, pour déterminer si la fonction support évolue sainement avec l’entreprise.
Les responsables ont besoin de détails opérationnels actualisés quotidiennement. Leur tableau de bord doit afficher en temps réel les tickets ouverts par priorité, le respect des SLA ventilé par catégorie, la répartition de la charge de travail des utilisateurs, le volume de tickets du jour comparé à la moyenne quotidienne, la répartition de l’ancienneté du backlog et le taux de réouverture par utilisateur. C’est cette vue qui guide les décisions de planification des effectifs et les réunions quotidiennes de triage.
Les utilisateurs ont besoin d’une vue étroite, personnelle et en temps réel : leurs propres tickets ouverts avec des compteurs de délai SLA, leur score CSAT personnel, leur taux de FCR et une file de tickets en attente de leur réponse, triés par urgence. Tout ce qui dépasse leur propre charge de travail constitue du bruit qui les ralentit.
| Type de tableau de bord | Fréquence d’actualisation | Horizon temporel | Indicateurs clés | Public principal |
|---|---|---|---|---|
| Opérationnel en temps réel | En direct à horaire | Aujourd’hui | Tickets ouverts, compteurs SLA, profondeur de la file | Utilisateurs, responsables |
| Tactique hebdomadaire | Du quotidien à l’hebdomadaire | Cette semaine par rapport à la précédente | Volume, ratio de backlog, charge de travail des utilisateurs | Responsables |
| Tendance stratégique | De l’hebdomadaire au mensuel | Mois/trimestre/année | Tendance du CSAT, coût par ticket, MTTR | Dirigeants |
Les vues opérationnelles en temps réel aident les responsables à redistribuer le travail avant qu’une file ne dépasse ses objectifs. Les rapports historiques servent un autre objectif : ils montrent si la charge de travail, la qualité et les habitudes de réponse s’améliorent au fil du temps.
La plupart des équipes petites et moyennes n’ont pas besoin immédiatement d’une intégration BI complète. Les fonctionnalités de reporting intégrées au helpdesk peuvent suffire pour les revues opérationnelles et hebdomadaires. Ajoutez un outil comme Looker Studio ou Power BI lorsque vous devez combiner les données du support avec les revenus, les effectifs ou d’autres systèmes de l’entreprise. Pour de nombreuses équipes, un tableau de bord du support client ciblé suffit pour une revue hebdomadaire.
Votre liste de contrôle KPI d’une page pour une revue hebdomadaire doit tenir sans défilement : FRT, MTTR (médiane), FCR, CSAT, respect des SLA, ratio de backlog, taux de réouverture et coût par ticket. Huit chiffres, un écran, aucune recherche fastidieuse.
Fréquence des rapports et modèles de rapports
La fréquence doit correspondre à la vitesse à laquelle un indicateur peut évoluer de manière significative et à la rapidité avec laquelle quelqu’un doit agir. Voici une structure que vous pouvez reprendre directement.
-
Alertes quotidiennes. Configurez des déclencheurs pour les tickets qui approchent de leur échéance SLA, les variations inhabituelles de volume et l’augmentation de la file des tickets à priorité critique. Choisissez les seuils à partir de votre référence opérationnelle et envoyez les alertes via les canaux que votre équipe surveille activement.
-
Rapport hebdomadaire des responsables. Structurez-le ainsi : cette semaine par rapport à la semaine dernière et à la même semaine de l’année précédente, avec en tête un commentaire de deux phrases expliquant le changement le plus important. Ajoutez ensuite les cinq principales catégories de tickets par volume, une vue de la charge de travail des utilisateurs indiquant où la capacité est limitée et l’ensemble des KPI essentiels (FRT, délai de résolution, FCR, CSAT, respect des SLA, ratio de backlog). Envoyez-le avant la revue hebdomadaire de l’équipe.
-
Rapport mensuel d’activité. Destiné aux directeurs et aux dirigeants, il couvre les tendances mensuelles et annuelles des mêmes indicateurs essentiels, le coût par ticket et par canal, une analyse des effectifs comparant l’évolution de l’effectif à celle du volume et une courte note prospective sur les risques, comme le lancement prochain d’un produit susceptible de faire bondir le volume de tickets. C’est le rapport qui justifie — ou remet en question — les demandes d’augmentation des effectifs.
De nombreuses plateformes de helpdesk proposent des vues opérationnelles prédéfinies. Considérez-les comme un point de départ, puis supprimez les champs sur lesquels personne n’agit et définissez chaque calcul avant de l’utiliser comme KPI.
Transformer les signaux des indicateurs en actions
Un rapport qui reste simplement dans une boîte de réception représente un effort gaspillé. Chaque indicateur qui évolue dans la mauvaise direction doit déclencher une réponse précise et attribuée, et non une vague discussion sur le fait de « garder un œil dessus ».
Backlog en hausse. Déterminez d’abord s’il s’agit d’un problème de volume ou de capacité de traitement. Si le volume augmente, déployez temporairement une équipe de triage ou ouvrez un parcours de libre-service avec un chatbot IA pour les questions courantes. Si la capacité de traitement diminue, recherchez une lacune de formation ou une règle de routage défaillante. Responsable : responsable du support. Surveillez quotidiennement le ratio de backlog pendant une semaine après la correction.
FCR en baisse. Identifiez les catégories qui tirent le chiffre vers le bas et vérifiez s’il s’agit d’un manque de connaissances. Il s’agit souvent d’un ou deux types de problèmes qui sont transférés à répétition d’un utilisateur à l’autre. Mettez à jour la base de connaissances interne avec un parcours de résolution clair pour cette catégorie et reformez l’équipe. Responsable : chef d’équipe. Vérifiez de nouveau le FCR par catégorie après deux semaines, et non immédiatement, car les utilisateurs ont besoin de temps pour assimiler les nouvelles consignes.
CSAT en baisse. Comparez cette évolution au FRT et au délai de résolution sur la même période afin de déterminer si un service plus lent y contribue. Si la rapidité reste stable, lisez les tickets ayant reçu une réponse négative et regroupez les motifs. Responsable : responsable. Examinez le score avec le nombre de réponses et le taux de réponse.
Taux de réouverture en hausse. Comparez-le au FCR. Cette combinaison peut indiquer que les tickets sont clôturés avant que le problème ne soit entièrement résolu. Examinez les catégories et les tickets concernés avant de modifier l’accompagnement ou les mesures incitatives. Responsable : responsable. Surveillez chaque semaine.
Coût par ticket en hausse. Commencez par vérifier la répartition des canaux, car le téléphone, l’e-mail et le chat ont des structures de coûts différentes. Si cette répartition reste stable, examinez les effectifs, les heures supplémentaires, les outils et la complexité des dossiers. Responsable : directeur. Effectuez une revue mensuelle, car cet indicateur évolue généralement plus lentement que les mesures liées aux files.
Conseil de pro : Choisissez une période d’évaluation avant d’effectuer un changement. Elle doit être suffisamment longue pour inclure un volume représentatif de tickets et au moins un cycle normal de reporting.
Les changements de routage et de documentation peuvent affecter les indicateurs opérationnels plus rapidement qu’un recrutement ou une refonte de la formation. Adaptez la période d’évaluation à l’intervention et au volume de tickets au lieu de déclarer la réussite après une seule bonne journée.
Gouvernance des données : s’assurer que les chiffres sont fiables
Rien de tout cela ne fonctionne si les données sous-jacentes sont incorrectes, ce qui arrive généralement quelque part. Chaque indicateur essentiel doit avoir un responsable nommé pour sa définition, une méthode de calcul documentée qui ne change pas sans préavis, une fréquence d’actualisation définie et une règle de gestion des données manquantes ou malformées.
Créez une courte liste de contrôle de gouvernance et revoyez-la chaque trimestre :
- Attribuez un responsable à chaque indicateur ; cette personne doit valider toute modification de sa définition.
- Documentez la formule de calcul exacte dans un emplacement accessible à toute l’équipe, et pas uniquement dans la tête d’un responsable.
- Définissez une fréquence fixe d’actualisation des données et déclenchez une alerte en cas d’interruption, car un pipeline de données silencieusement défaillant est pire que l’absence totale de rapport.
- Définissez un nombre ou un taux minimal de réponses avant de publier le CSAT, en fonction de votre volume de tickets et du niveau de confiance souhaité.
- Effectuez régulièrement des audits par échantillonnage des tickets : sélectionnez chaque mois 10 à 15 tickets aléatoires et vérifiez manuellement leurs horodatages et leur catégorisation par rapport au rapport.
- Analysez les changements soudains qui ne correspondent à aucun événement opérationnel, car ils peuvent indiquer un problème de définition, de balisage ou d’intégration.
Pour les références, privilégiez les sources qui publient leur méthodologie et leur échantillon. Utilisez les chiffres externes uniquement comme contexte, puis fixez vos objectifs à partir de vos propres engagements de service, de la répartition de vos tickets, de vos heures de support et de votre référence historique.
Une remarque pratique pour bien faire les choses
La plupart des équipes échouent dans leur reporting du helpdesk non pas parce qu’elles choisissent les mauvais indicateurs, mais parce qu’elles essaient d’en suivre vingt dès le premier jour et abandonnent tout au bout d’un mois. Huit indicateurs suivis régulièrement et utilisés chaque semaine vous apprendront davantage sur votre activité de support que trente indicateurs consultés occasionnellement.
Commencez par le tableau de bord hebdomadaire des responsables, sur une page. Faites-le fonctionner correctement pendant un mois avant de vous occuper du reporting destiné aux dirigeants ou de créer des widgets individuels pour les utilisateurs. Il est tentant de construire le système complet dès le premier jour parce que les outils rendent la tâche facile, mais la discipline consistant à surveiller attentivement huit chiffres vaut mieux que l’illusion d’en surveiller trente.
Pour une équipe petite ou moyenne sans analyste dédié, Deskhero propose des vues Statistics prédéfinies pour les tendances, les délais de réponse, les SLA, l’activité de l’équipe, l’IA et l’automatisation, les canaux et les sujets.
Mettre ces rapports en place sans travail manuel
Une grande partie des difficultés du reporting du helpdesk provient de conversations dispersées, de champs de tickets incohérents et de tâches répétées sur des feuilles de calcul. Deskhero connecte les boîtes aux lettres Gmail ou Microsoft 365 à un helpdesk partagé. Sa section Statistics fournit des rapports sur les tendances des tickets, les délais de réponse, le respect des SLA, l’activité de l’équipe, les canaux, l’IA et l’automatisation ainsi que les tendances par sujet.
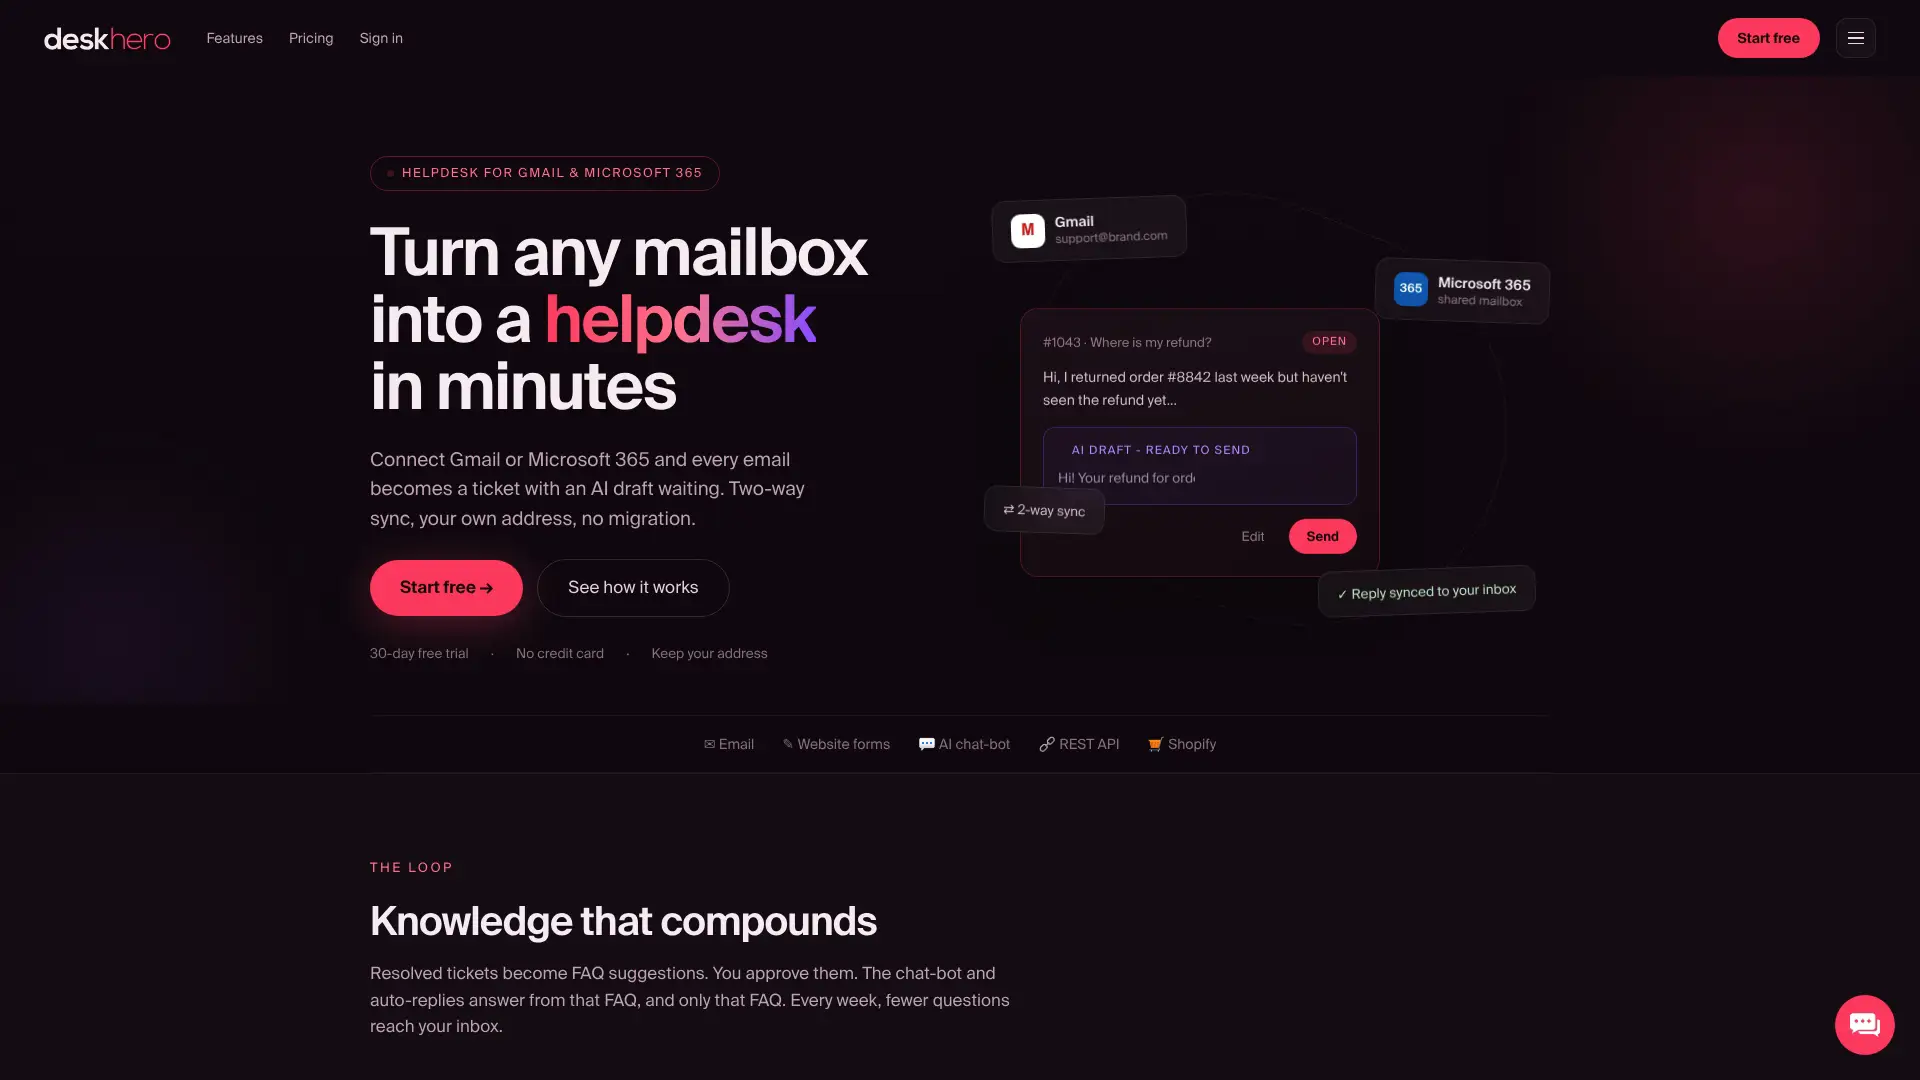
La synchronisation bidirectionnelle des e-mails conserve les messages entrants et les réponses dans l’historique des tickets utilisé pour le reporting des délais de réponse. Les brouillons de réponses IA s’appuient sur les connaissances de l’espace de travail, notamment les tickets traités, la base de connaissances interne, les entrées approuvées de la FAQ publique, les pages extraites du site web et les données produits Shopify connectées. La section Statistics propose des vues fixes sous forme de graphiques et de tableaux, avec export Excel pour chaque onglet. Pour les équipes e-commerce, le panneau client Shopify place le contexte du client et de la commande dans la barre latérale du ticket.
Si vous êtes une équipe petite ou moyenne qui passe d’une boîte de réception partagée à un reporting structuré, vous pouvez commencer un essai gratuit de 30 jours sans carte bancaire et examiner le volume des tickets ainsi que les vues sur les délais de réponse, les délais de résolution, les SLA, les canaux et l’équipe, sans créer d’abord une feuille de calcul.
Sources
- Guide du reporting et des tableaux de bord du helpdesk 2026 | HelpDeskFocus
- KPI et indicateurs du helpdesk : 10 références essentielles | Softabase
Ces références fournissent des définitions et des exemples supplémentaires. Consultez la méthodologie de chaque source et adaptez toute référence à votre propre activité.
FAQ
Quels sont les indicateurs clés du reporting d’un service desk ?
L’ensemble essentiel comprend le délai de première réponse, le MTTR, la résolution au premier contact, le CSAT, le respect des SLA, le volume de tickets et le backlog, le taux de réouverture et le coût par ticket, segmentés par canal, priorité et catégorie pour garantir leur précision.
Quels sont les 5 indicateurs clés de l’expérience client ?
Les définitions varient selon les organisations, mais une sélection pratique comprend le CSAT, la résolution au premier contact, le délai de première réponse, le respect des SLA et un indicateur relationnel tel que le Net Promoter Score. Choisissez des indicateurs dont les définitions et les responsables sont clairs.
Quels sont des exemples de KPI pour un helpdesk informatique ?
Parmi les KPI solides d’un helpdesk informatique figurent le respect des SLA par niveau de ticket, le MTTR par priorité, le ratio de backlog, le coût par ticket et le taux de réouverture dans les 48 heures, car ils sont directement liés à la fois à la qualité du service et au coût de fonctionnement.
Quels sont les bons KPI pour un service informatique ?
Au-delà des chiffres propres au helpdesk, les services informatiques suivent souvent la disponibilité des systèmes, le délai moyen de détection et de résolution des incidents ainsi que le taux d’échec des changements, en complément des indicateurs de support standard comme le FRT et le CSAT, afin de mesurer à la fois la prestation de service et la fiabilité de l’infrastructure.
À quelle fréquence les rapports du helpdesk doivent-ils être examinés ?
Configurez des alertes quotidiennes pour les seuils de violation des SLA et les pics de volume, examinez chaque semaine un rapport structuré avec votre équipe et produisez chaque mois un rapport d’activité pour les directeurs, qui suit les tendances mensuelles et annuelles.
Les logiciels de helpdesk peuvent-ils calculer automatiquement ces indicateurs ?
Oui. Deskhero propose des rapports prédéfinis sur les tendances des tickets, les délais de réponse, le respect des SLA, l’activité de l’équipe, l’IA et l’automatisation, les canaux et les sujets. Le CSAT, le FCR, le taux de réouverture et le coût par ticket nécessitent une mesure distincte, sauf si la plateforme choisie les prend explicitement en charge.