Quali metriche dei report dell'helpdesk contano davvero
Se questa settimana costruisci una sola cosa, crea una dashboard manageriale settimanale di una pagina che mostri tutti e otto questi indicatori al tuo team ogni lunedì mattina. Tutto il resto, inclusi i widget utente aggiornati ogni ora e le presentazioni trimestrali per i dirigenti, può aspettare finché quel singolo report non sarà affidabile.
Ecco cosa ti dice realmente ogni metrica:
- Tempo di prima risposta risponde alla domanda: quanto aspettano i clienti prima di ricevere una risposta da una persona?
- MTTR risponde alla domanda: quanto tempo richiede realmente la chiusura di un problema, dall’inizio alla fine?
- Risoluzione al primo contatto risponde alla domanda: gli utenti risolvono i problemi al primo tentativo o i ticket vengono rimbalzati da una persona all’altra?
- CSAT risponde alla domanda: i clienti sono soddisfatti del modo in cui è stato gestito il loro problema?
- Conformità agli SLA risponde alla domanda: stai rispettando le promesse sui tempi di risposta e risoluzione che hai fatto?
- Volume dei ticket e arretrato rispondono alla domanda: la domanda in arrivo sta superando la capacità del tuo team?
- Tasso di riapertura risponde alla domanda: i ticket “risolti” restano davvero risolti?
- Costo per ticket risponde alla domanda: quanto costa all’azienda ogni interazione con l’assistenza?
Nessuno di questi numeri dice molto preso isolatamente. Un FRT rapido abbinato a un FCR basso significa soltanto che stai rispondendo velocemente e sbagliando la risposta. La vera abilità nelle metriche di reportistica dell’helpdesk consiste nello scegliere le combinazioni giuste, segmentarle correttamente e indirizzare la visualizzazione appropriata alla persona giusta.
Punti chiave
Una reportistica affidabile dell’helpdesk si basa sul monitoraggio costante di otto metriche fondamentali, sulla loro corretta segmentazione e sull’invio della visualizzazione giusta al pubblico giusto secondo una cadenza fissa.
| Punto | Dettagli |
|---|---|
| Inizia con otto metriche | Monitora FRT, MTTR, FCR, CSAT, conformità agli SLA, rapporto di arretrato, tasso di riapertura e costo per ticket. |
| Costruisci prima la dashboard settimanale | Un report manageriale di una pagina è più efficace di un sistema complesso con molte schede che nessuno controlla. |
| Adatta le dashboard al pubblico | I dirigenti hanno bisogno dei trend, i manager di visualizzazioni operative quotidiane, gli utenti delle proprie code personali in tempo reale. |
| Abbina le metriche per evitare manipolazioni | Osserva l’FCR insieme al tasso di riapertura e l’FRT insieme al CSAT per avere il quadro completo. |
| Deskhero offre visualizzazioni di reportistica predefinite | La sua area Statistics copre i trend dei ticket, i tempi di risposta, gli SLA, l’attività del team, l’AI e l’automazione, i canali e gli argomenti. |
Indice
- Metriche di reportistica dell’helpdesk e KPI: qual è la differenza?
- Metriche fondamentali dell’helpdesk: definizioni, formule e benchmark
- Come misurare correttamente ed evitare gli errori più comuni
- Progetta le dashboard in base al pubblico: visualizzazioni per dirigenti, manager e utenti
- Cadenza della reportistica e modelli di report di esempio
- Trasformare i segnali delle metriche in azioni
- Governance dei dati: assicurarsi che i numeri siano affidabili
- Avviare questi report senza lavoro manuale
- Fonti
- FAQ
Metriche di reportistica dell’helpdesk e KPI: qual è la differenza?
Una metrica è qualsiasi numero che puoi misurare. Un KPI è una metrica a cui la tua organizzazione ha deciso di attribuire abbastanza importanza da stabilire un obiettivo e intraprendere azioni regolari. Il volume dei ticket è una metrica. “Mantieni il volume medio dei ticket al di sotto di 40 per utente al giorno” è un KPI. Un benchmark, invece, è un punto di riferimento esterno, come una media di settore, che ti indica innanzitutto se il tuo obiettivo KPI è realistico.
Questa distinzione è importante perché i team di assistenza possono raccogliere molte metriche senza decidere quali meritino un obiettivo e una risposta regolare. Un insieme essenziale e compatto è più facile da esaminare con costanza. Aggiungi una misura solo quando qualcuno ne è responsabile e sa quale azione dovrebbe generare un cambiamento.
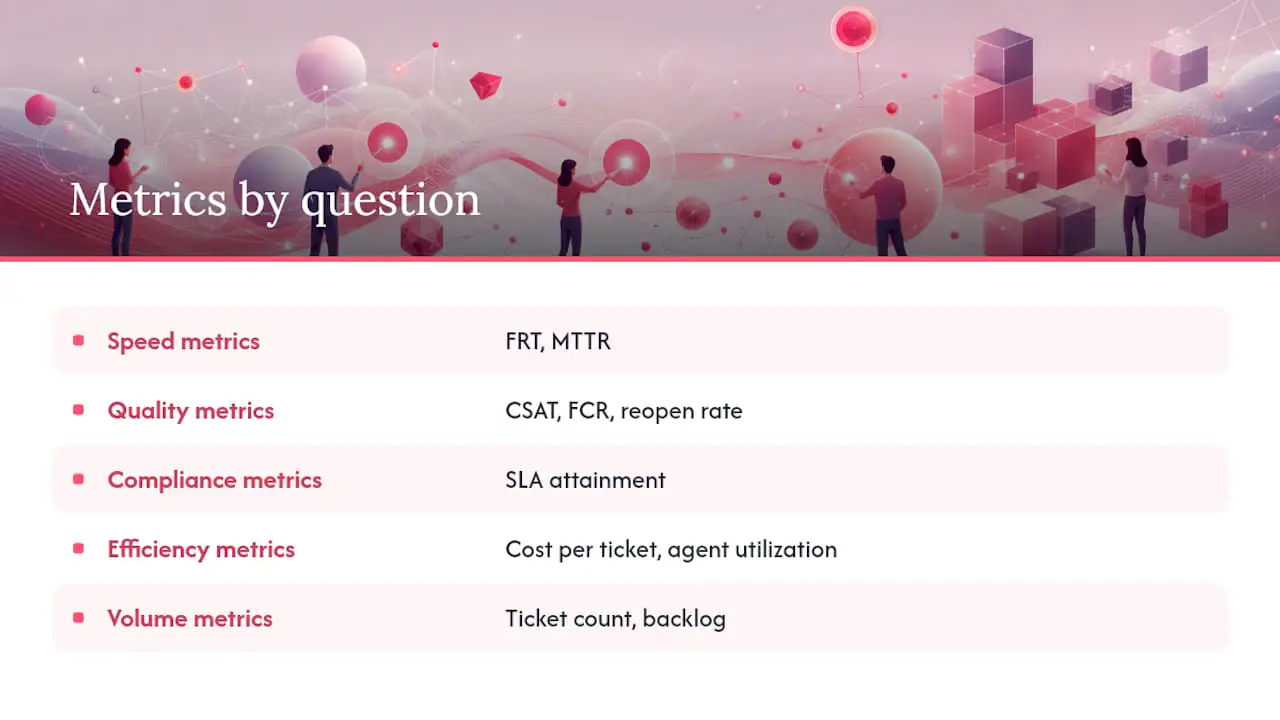
Raggruppa le metriche in base alla domanda a cui rispondono e la progettazione della reportistica diventerà molto più semplice:
Le metriche di velocità (FRT, MTTR) indicano quanto rapidamente si muove il team. Le metriche di qualità (CSAT, FCR, tasso di riapertura) indicano se quella velocità sta producendo buoni risultati. Le metriche di conformità (rispetto degli SLA) indicano se stai mantenendo le promesse contrattuali o interne. Le metriche di efficienza (costo per ticket, utilizzo del team) indicano quanto costa gestire l’operazione. Le metriche di volume (numero di ticket, arretrato) forniscono informazioni sulla domanda.
I dirigenti generalmente si interessano ai trend di efficienza e qualità nell’arco di diversi mesi. I manager hanno bisogno di visualizzazioni sulla conformità e sui volumi da controllare ogni giorno o ogni settimana. Gli utenti hanno bisogno di metriche di velocità e qualità riferite alla propria coda. Mescolare tutti i pubblici in un’unica dashboard può seppellire le informazioni di cui ogni persona ha bisogno.
Metriche fondamentali dell’helpdesk: definizioni, formule e benchmark
Ecco la scheda di riferimento. Definisci esplicitamente ogni metrica, segmentala secondo queste linee guida e stabilisci gli obiettivi sulla base dei tuoi impegni di servizio e della baseline storica.
Il tempo di prima risposta (FRT) misura il tempo trascorso tra la creazione di un ticket e la prima risposta umana sostanziale. Quando possibile, comunica sia la mediana sia un percentile più alto ed escludi le conferme automatiche. Segmenta per canale e priorità, perché i clienti hanno aspettative diverse per email, chat e telefono.
Il tempo di risoluzione, spesso riassunto come tempo medio di risoluzione (MTTR), misura il ciclo di vita dalla creazione del ticket alla sua risoluzione o chiusura. Comunica la mediana insieme alla media o al posto della media quando un numero ridotto di ticket complessi potrebbe distorcere il risultato. Segmenta per priorità e tipo di problema e definisci in che modo l’attesa della risposta del cliente influisce sul conteggio del tempo.
La risoluzione al primo contatto (FCR) misura la percentuale di ticket risolti senza un’interazione successiva. Definisci chiaramente cosa si intende per “primo contatto”, quindi segmenta per categoria e anzianità dell’utente affinché i cambiamenti nella composizione dei ticket non vengano scambiati per cambiamenti nelle prestazioni.
La soddisfazione del cliente (CSAT) misura la percentuale di risposte positive ai sondaggi. Riporta il numero di risposte e il tasso di risposta accanto al punteggio, perché un campione ridotto o composto da persone che si sono autoselezionate può risultare fuorviante. Segmenta per categoria del problema prima di confrontare gli utenti.
La conformità agli SLA misura la percentuale di ticket che rispettano gli impegni definiti sui tempi di risposta e risoluzione. Segmenta per livello di SLA e tipo di contratto del cliente; unire gli SLA dei clienti enterprise e quelli dei piani gratuiti in un unico numero nasconde il quadro reale.
Il volume dei ticket e l’arretrato misurano la domanda in arrivo e la coda di attività non risolte. Monitora l’arretrato sia come conteggio assoluto sia come rapporto (ticket aperti divisi per la capacità media giornaliera di risoluzione), così puoi capire se la coda sta crescendo più velocemente di quanto il team riesca a smaltirla.
Il tasso di riapertura misura la percentuale di ticket risolti che vengono riaperti entro una finestra definita, in genere da 48 a 72 ore. Segmenta per utente e categoria. Questa è la metrica che mantiene onesto l’FCR.
Il costo per ticket misura il costo operativo totale dell’assistenza diviso per il volume dei ticket in un determinato periodo. Segmenta per canale, poiché l’assistenza telefonica in genere costa molto di più per ticket rispetto a email o chat.
| Metrica | Formula | Segmenta per | Punto di partenza per il benchmark |
|---|---|---|---|
| Tempo di prima risposta | Tempo fino alla prima risposta umana | Canale, priorità | Stabilito in base al canale e agli orari di assistenza |
| MTTR (mediana) | Tempo dall’apertura alla chiusura | Livello di priorità | Stabilito in base alla priorità e al tipo di problema |
| Risoluzione al primo contatto | Chiusure al primo contatto ÷ ticket totali | Categoria, anzianità dell’utente | Utilizza una baseline storica |
| CSAT | Risposte positive ÷ risposte totali | Utente, categoria | Mostra punteggio, risposte e tasso di risposta |
| Conformità agli SLA | Ticket conformi ÷ ticket totali | Livello SLA, tipo di contratto | Stabilisci il valore per ogni contratto |
| Tasso di riapertura | Ticket riaperti ÷ ticket risolti | Utente, categoria | Abbinalo all’FCR |
Due metriche hanno senso soltanto se considerate insieme: la risoluzione al primo contatto e il tasso di riapertura entro 48 ore. Un FCR elevato abbinato a un tasso di riapertura in aumento significa che gli utenti stanno chiudendo i ticket per raggiungere un obiettivo, non perché il problema sia stato davvero risolto.
Come misurare correttamente ed evitare gli errori più comuni
La precisione con cui calcoli una metrica conta più della metrica che scegli. Utilizza la mediana anziché la media per qualsiasi metrica basata sul tempo e caratterizzata da una coda lunga, il che nella pratica significa quasi tutti i valori relativi ai tempi di risoluzione che comunichi. Un singolo ticket che richiede tre settimane per essere chiuso perché è bloccato in attesa di un fornitore farà aumentare il tempo medio di risoluzione in modo tale da rappresentare erroneamente le prestazioni dell’intero team.
Considera come FRT la prima risposta umana, non la conferma automatica “abbiamo ricevuto il tuo messaggio”. Se il tuo sistema registra la risposta automatica come primo contatto, i valori FRT appariranno artificialmente rapidi e nasconderanno un reale problema di organico. Definisci esplicitamente la finestra di riapertura, che sia di 24, 48 o 72 ore, e applicala con coerenza a ogni categoria, così da confrontare elementi omogenei. Allinea l’orologio della reportistica agli effettivi orari di assistenza; un ticket inviato alle 23 di venerdì e a cui si risponde alle 9 di lunedì non dovrebbe essere considerato alla pari di un ritardo di tre giorni durante l’orario lavorativo se il tuo team non lavora nei fine settimana.
Un errore comune consiste nel calcolare la media di una metrica tra canali che si comportano in modo diverso. Unire l’FRT delle email a quello delle chat produce un dato che non descrive bene nessuno dei due canali. Un altro errore consiste nel comunicare la risoluzione al primo contatto senza il tasso di riapertura, premiando così le chiusure premature. Anche il CSAT deve includere la dimensione del campione e il tasso di risposta, non soltanto il punteggio principale.
Consiglio: Esegui un rapido controllo di coerenza prima di presentare un report. Seleziona alcuni ticket contrassegnati come “entro lo SLA” e confronta i relativi timestamp con il report. Qualsiasi discrepanza merita un’indagine prima che il numero venga utilizzato per prendere una decisione.
Visualizza l’FRT accanto al CSAT e il rapporto di arretrato accanto al numero di violazioni degli SLA. Questi abbinamenti individuano problemi che un singolo numero nasconde. Un team può raggiungere sulla carta tutti gli obiettivi SLA mentre l’arretrato triplica silenziosamente, perché la conformità agli SLA misura i ticket gestiti, non quelli che si accumulano alle loro spalle.
Progetta le dashboard in base al pubblico: visualizzazioni per dirigenti, manager e utenti
Pubblici diversi hanno bisogno di visualizzazioni diverse. Una dashboard progettata per il carico di lavoro attuale di un utente è troppo dettagliata per un dirigente che valuta i trend trimestrali, mentre una visualizzazione strategica per dirigenti cambia troppo lentamente per aiutare qualcuno a gestire la coda di oggi.
I dirigenti hanno bisogno di linee di tendenza, non di contatori aggiornati in tempo reale. Nella loro visualizzazione inserisci il trend del CSAT nel tempo, il costo per ticket su base mensile, il volume dei ticket rapportato all’organico, il trend trimestrale dell’MTTR, il trend del rispetto degli SLA e l’andamento generale dell’arretrato. La controlleranno ogni mese, talvolta ogni settimana, per capire se la funzione di assistenza sta crescendo in modo sostenibile insieme all’azienda.
I manager hanno bisogno di dettagli operativi aggiornati quotidianamente. La loro dashboard dovrebbe mostrare in tempo reale i ticket aperti per priorità, la conformità agli SLA suddivisa per categoria, la distribuzione del carico di lavoro degli utenti, il volume dei ticket di oggi rispetto alla media giornaliera, la distribuzione dell’età dell’arretrato e il tasso di riapertura per utente. È questa la visualizzazione che guida le decisioni sull’organico e le riunioni quotidiane di triage.
Gli utenti hanno bisogno di una visualizzazione ristretta, personale e in tempo reale: i propri ticket aperti con i timer del conto alla rovescia degli SLA, il proprio punteggio CSAT, il proprio tasso FCR e una coda di ticket in attesa di risposta ordinata per urgenza. Qualsiasi informazione al di fuori del proprio carico di lavoro è rumore che li rallenta.
| Tipo di dashboard | Frequenza di aggiornamento | Orizzonte temporale | Metriche principali | Pubblico principale |
|---|---|---|---|---|
| Operativa in tempo reale | Da live a oraria | Oggi | Ticket aperti, timer SLA, profondità della coda | Utenti, manager |
| Tattica settimanale | Da giornaliera a settimanale | Questa settimana rispetto alla precedente | Volume, rapporto di arretrato, carico di lavoro degli utenti | Manager |
| Trend strategico | Da settimanale a mensile | Mese/trimestre/anno | Trend CSAT, costo per ticket, MTTR | Dirigenti |
Le visualizzazioni operative in tempo reale aiutano i manager a ridistribuire il lavoro prima che una coda superi i propri obiettivi. I report storici hanno uno scopo diverso: mostrano se il carico di lavoro, la qualità e i modelli di risposta stanno migliorando nel tempo.
La maggior parte dei team piccoli e di medie dimensioni non ha bisogno fin da subito di una completa integrazione con strumenti di business intelligence. La reportistica integrata dell’helpdesk può coprire le revisioni operative e settimanali. Aggiungi uno strumento come Looker Studio o Power BI quando devi combinare i dati dell’assistenza con ricavi, organico o altri sistemi aziendali. Per molti team, una dashboard focalizzata sull’assistenza clienti è sufficiente per una revisione settimanale.
La checklist KPI di una pagina per la revisione settimanale dovrebbe stare tutta in una schermata, senza scorrere: FRT, MTTR (mediana), FCR, CSAT, conformità agli SLA, rapporto di arretrato, tasso di riapertura e costo per ticket. Otto numeri, una schermata, nessuna ricerca.
Cadenza della reportistica e modelli di report di esempio
La cadenza dovrebbe corrispondere alla rapidità con cui una metrica può cambiare in modo significativo e alla rapidità con cui qualcuno deve intervenire. Ecco una struttura che puoi copiare direttamente.
-
Avvisi giornalieri. Imposta trigger per i ticket prossimi alla scadenza di uno SLA, variazioni insolite dei volumi e crescita della coda con priorità critica. Scegli le soglie sulla base della tua baseline operativa e invia gli avvisi attraverso i canali che il team controlla attivamente.
-
Report manageriale settimanale. Strutturalo come confronto tra questa settimana, la settimana scorsa e la stessa settimana dell’anno scorso, con una descrizione di due frasi in apertura che spieghi il cambiamento più importante. Prosegui con le cinque principali categorie di ticket per volume, una visualizzazione del carico di lavoro degli utenti che mostri dove la capacità è limitata e l’insieme dei KPI fondamentali (FRT, tempo di risoluzione, FCR, CSAT, conformità agli SLA, rapporto di arretrato). Invialo prima della revisione settimanale del team.
-
Report aziendale mensile. Pensato per direttori e dirigenti, copre i trend mese su mese e anno su anno delle stesse metriche fondamentali, il costo per ticket per canale, un’analisi dell’organico che confronta il numero di dipendenti con la crescita dei volumi e una breve nota sui rischi futuri, come il lancio imminente di un prodotto che dovrebbe far aumentare il volume dei ticket. È il report che giustifica (o mette in discussione) le richieste di nuove assunzioni.
Molte piattaforme per helpdesk offrono visualizzazioni operative predefinite. Usale come punto di partenza, poi rimuovi i campi su cui nessuno interviene e definisci ogni calcolo prima di utilizzarlo come KPI.
Trasformare i segnali delle metriche in azioni
Un report che resta semplicemente in una casella di posta è uno spreco di lavoro. Ogni metrica che si muove nella direzione sbagliata dovrebbe generare una risposta specifica e assegnata, non una conversazione vaga sul “tenere la situazione sotto controllo”.
Arretrato in aumento. Verifica innanzitutto se si tratta di un problema di volume o di capacità di elaborazione. Se il volume è aumentato, crea un team temporaneo di triage oppure attiva un percorso di deflessione self-service tramite un chatbot AI per le domande più comuni. Se la capacità di elaborazione è diminuita, verifica la presenza di lacune nella formazione o di una regola di instradamento non funzionante. Responsabile: manager dell’assistenza. Controlla quotidianamente il rapporto di arretrato per una settimana dopo aver applicato la correzione.
FCR in calo. Individua le categorie che trascinano il dato verso il basso e verifica se esiste una lacuna nelle conoscenze. Spesso si tratta di uno o due tipi di problemi che rimbalzano ripetutamente tra gli utenti. Aggiorna la knowledge base interna con un percorso di risoluzione chiaro per quella categoria e forma nuovamente il team. Responsabile: team lead. Ricontrolla l’FCR per categoria dopo due settimane, non immediatamente, perché gli utenti hanno bisogno di tempo per assimilare le nuove indicazioni.
CSAT in calo. Confronta il cambiamento con l’FRT e il tempo di risoluzione dello stesso periodo per verificare se un servizio più lento contribuisce al risultato. Se la velocità è stabile, leggi i ticket con risposte negative e raggruppa le motivazioni. Responsabile: manager. Esamina il punteggio insieme al numero di risposte e al tasso di risposta.
Tasso di riapertura in aumento. Confrontalo con l’FCR. La combinazione potrebbe indicare che i ticket vengono chiusi prima che il problema sia completamente risolto. Esamina le categorie e i ticket interessati prima di modificare il coaching o gli incentivi. Responsabile: manager. Controlla il dato ogni settimana.
Costo per ticket in aumento. Controlla innanzitutto la distribuzione dei canali, perché telefono, email e chat hanno strutture di costo diverse. Se la distribuzione è stabile, esamina organico, straordinari, strumenti e complessità dei casi. Responsabile: direttore. Effettua una revisione mensile, perché questa metrica generalmente cambia più lentamente rispetto agli indicatori relativi alle code.
Consiglio: Scegli una finestra di valutazione prima di apportare una modifica. Deve essere abbastanza lunga da includere un volume rappresentativo di ticket e almeno un normale ciclo di reportistica.
Le modifiche all’instradamento e alla documentazione possono influire sulle metriche operative prima di un’assunzione o di una revisione completa della formazione. Adatta la finestra di revisione all’intervento e al volume dei ticket invece di dichiarare il successo sulla base di una sola giornata positiva.
Governance dei dati: assicurarsi che i numeri siano affidabili
Niente di tutto questo funziona se i dati sottostanti sono errati, e di solito lo sono almeno in qualche punto. Ogni metrica fondamentale deve avere un responsabile nominativo incaricato della sua definizione, un metodo di calcolo documentato che non cambi senza preavviso, una cadenza di aggiornamento definita e una regola per gestire i dati mancanti o non corretti.
Crea una breve checklist di governance e rivedila ogni trimestre:
- Assegna un responsabile per ogni metrica, che approvi qualsiasi modifica alla relativa definizione.
- Documenta la formula di calcolo esatta in un luogo visibile a tutto il team, non soltanto nella mente di un manager.
- Stabilisci una cadenza fissa per l’aggiornamento dei dati e attiva un avviso per qualsiasi interruzione, poiché una pipeline di dati guasta senza segnalazioni è peggiore dell’assenza totale di un report.
- Stabilisci un numero o un tasso minimo di risposte prima di pubblicare il CSAT, sulla base del volume dei ticket e del livello di affidabilità desiderato.
- Esegui audit periodici su campioni di ticket, selezionando ogni mese da 10 a 15 ticket casuali e verificando manualmente timestamp e categorizzazione rispetto al report.
- Indaga sui cambiamenti improvvisi che non corrispondono ad alcun evento operativo, perché potrebbero indicare un problema di definizione, tagging o integrazione.
Per i benchmark, prediligi le fonti che pubblicano la propria metodologia e il campione utilizzato. Usa i dati esterni soltanto come contesto, quindi stabilisci gli obiettivi sulla base dei tuoi impegni di servizio, della composizione dei ticket, degli orari di assistenza e della baseline storica.
Una nota pratica per farlo bene
La maggior parte dei team fallisce nella reportistica dell’helpdesk non perché scelga le metriche sbagliate, ma perché cerca di monitorarne venti fin dal primo giorno e abbandona l’intero progetto nel giro di un mese. Otto metriche monitorate con costanza e su cui si interviene ogni settimana ti insegneranno di più sulla tua attività di assistenza rispetto a trenta metriche osservate occasionalmente.
Inizia dalla dashboard manageriale settimanale di una pagina. Perfezionala nell’arco di un mese prima di occuparti della reportistica per i dirigenti o di sviluppare i widget per i singoli utenti. È allettante costruire l’intero sistema già dal primo giorno perché gli strumenti lo rendono semplice, ma la disciplina di osservare attentamente otto numeri supera l’illusione di monitorarne trenta.
Per un team piccolo o di medie dimensioni senza una persona dedicata all’analisi, Deskhero offre visualizzazioni Statistics predefinite per trend, tempi di risposta, SLA, attività del team, AI e automazione, canali e argomenti.
Avviare questi report senza lavoro manuale
Gran parte degli attriti nella reportistica dell’helpdesk deriva da conversazioni frammentate, campi dei ticket incoerenti e attività ripetitive sui fogli di calcolo. Deskhero collega le caselle email Gmail o Microsoft 365 a un helpdesk condiviso. La sua area Statistics fornisce report sui trend dei ticket, sui tempi di risposta, sul rispetto degli SLA, sull’attività del team, sui canali, sull’AI e sull’automazione e sui pattern degli argomenti.
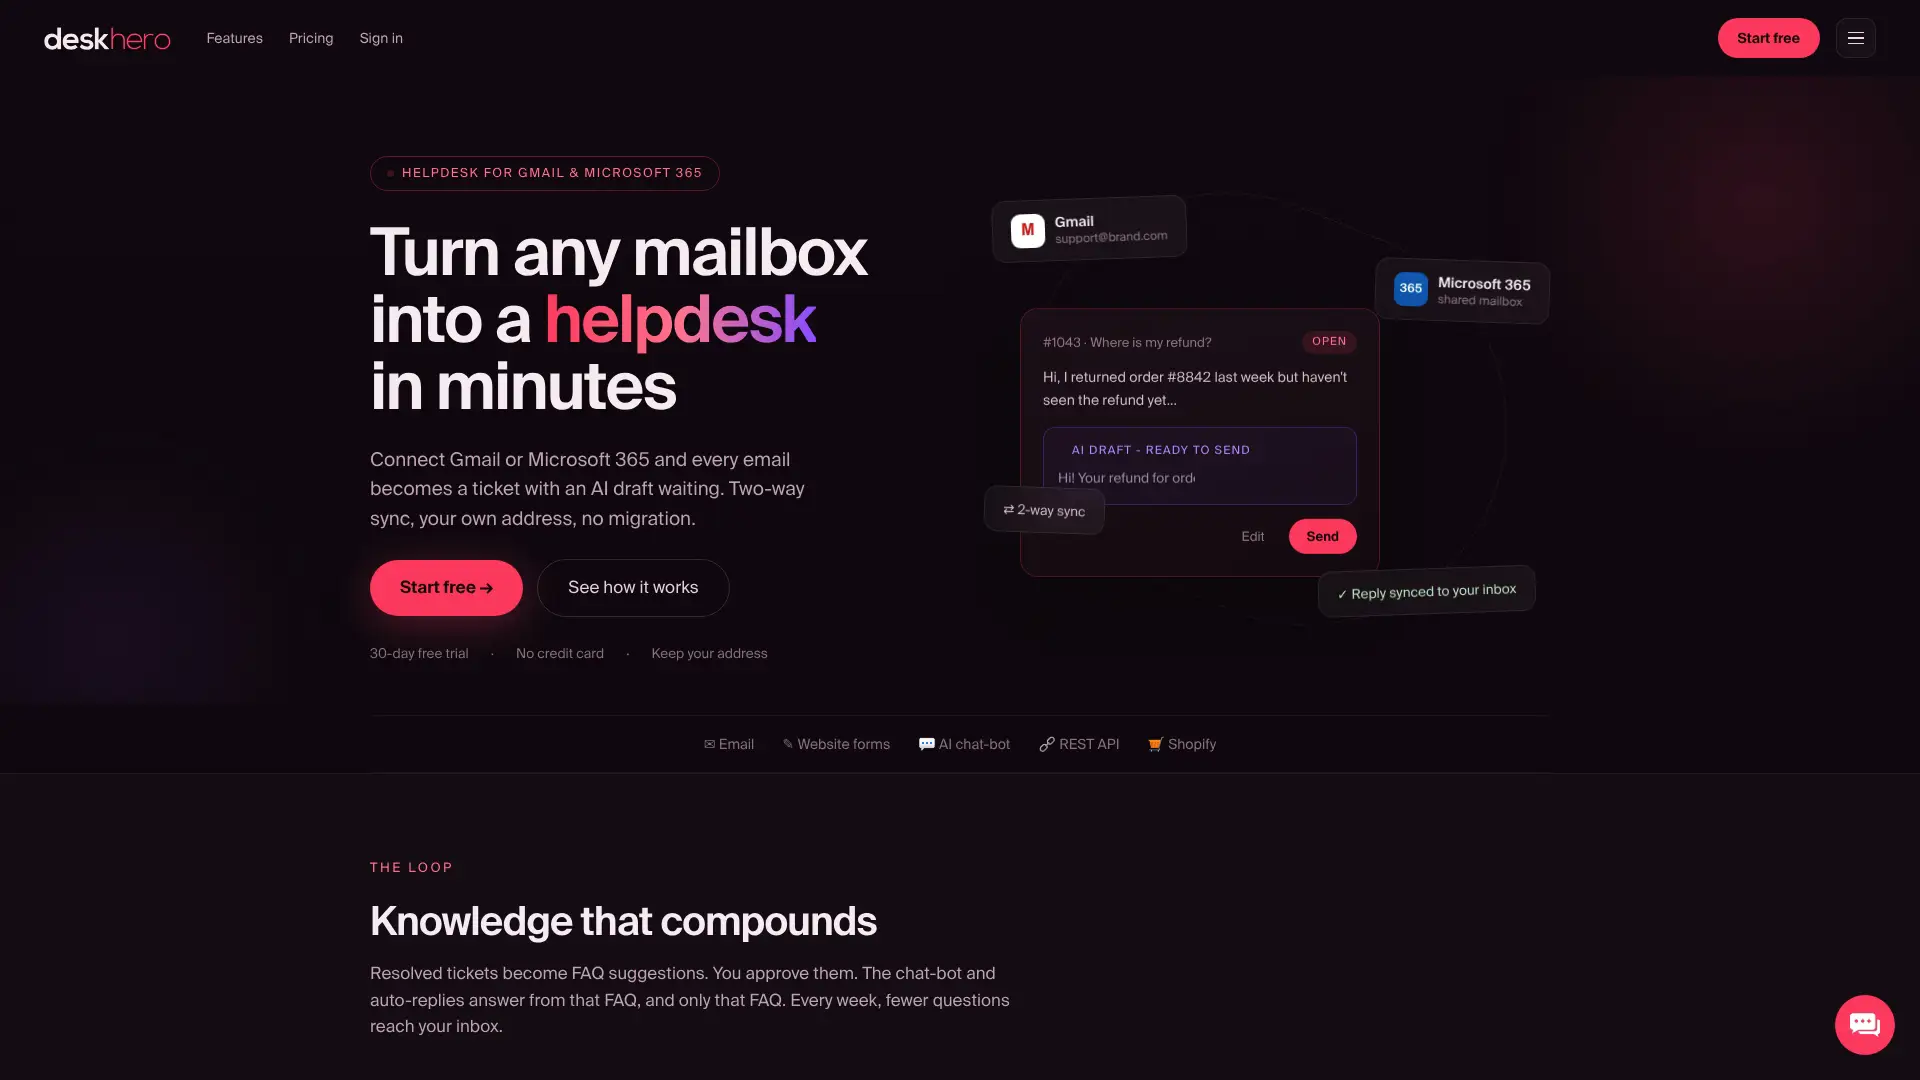
La sincronizzazione bidirezionale delle email conserva i messaggi in arrivo e le risposte nella cronologia del ticket utilizzata per la reportistica sui tempi di risposta. Le bozze di risposta dell’AI attingono alle conoscenze dell’area di lavoro, inclusi ticket a cui è già stata data risposta, knowledge base interna, FAQ pubbliche approvate, pagine del sito web acquisite e dati dei prodotti Shopify collegati. L’area Statistics offre visualizzazioni predefinite sotto forma di grafici e tabelle, con esportazione in Excel per ogni scheda. Per i team e-commerce, il pannello clienti Shopify mostra il contesto del cliente e dell’ordine nella barra laterale del ticket.
Se fai parte di un team piccolo o di medie dimensioni che sta passando da una casella di posta condivisa a una reportistica strutturata, puoi iniziare una prova gratuita di 30 giorni senza carta di credito e analizzare le visualizzazioni relative a volume dei ticket, tempi di risposta, tempi di risoluzione, SLA, canali e team senza dover prima creare un foglio di calcolo.
Fonti
- Guida alla reportistica e alle dashboard dell’helpdesk 2026 | HelpDeskFocus
- KPI e metriche dell’helpdesk: 10 benchmark essenziali | Softabase
Questi riferimenti forniscono ulteriori definizioni ed esempi. Verifica la metodologia di ogni fonte e adatta qualsiasi benchmark alla tua attività.
FAQ
Quali sono le metriche principali per la reportistica del service desk?
L’insieme fondamentale comprende tempo di prima risposta, MTTR, risoluzione al primo contatto, CSAT, conformità agli SLA, volume dei ticket e arretrato, tasso di riapertura e costo per ticket, segmentati per canale, priorità e categoria per garantire l’accuratezza.
Quali sono le 5 metriche chiave della CX?
Le definizioni variano in base all’organizzazione, ma una selezione pratica include CSAT, risoluzione al primo contatto, tempo di prima risposta, conformità agli SLA e una misura della relazione come il Net Promoter Score. Scegli misure con definizioni e responsabili chiari.
Quali sono alcuni esempi di KPI per un helpdesk IT?
Tra i KPI più efficaci per un helpdesk IT rientrano la conformità agli SLA per livello di ticket, l’MTTR per priorità, il rapporto di arretrato, il costo per ticket e il tasso di riapertura entro 48 ore, poiché questi indicatori sono direttamente collegati sia alla qualità del servizio sia ai costi operativi.
Quali sono buoni KPI per un reparto IT?
Oltre ai dati specifici dell’helpdesk, i reparti IT monitorano spesso il tempo di attività dei sistemi, il tempo medio di rilevamento e risoluzione degli incidenti e il tasso di fallimento delle modifiche, insieme alle metriche standard dell’assistenza come FRT e CSAT, per rilevare sia la qualità dell’erogazione del servizio sia l’affidabilità dell’infrastruttura.
Con quale frequenza dovrebbero essere revisionati i report dell’helpdesk?
Imposta avvisi giornalieri per le soglie di violazione degli SLA e i picchi di volume, esamina ogni settimana un report strutturato insieme al team e prepara un report aziendale mensile per i direttori che monitori i trend mese su mese e anno su anno.
Il software per helpdesk può calcolare automaticamente queste metriche?
Sì. Deskhero offre report predefiniti su trend dei ticket, tempi di risposta, rispetto degli SLA, attività del team, AI e automazione, canali e argomenti. CSAT, FCR, tasso di riapertura e costo per ticket richiedono una misurazione separata, a meno che la piattaforma scelta non li supporti esplicitamente.