Quais métricas de relatórios do helpdesk realmente importam
Se você construir apenas uma coisa esta semana, construa um painel de gestão semanal de uma página que coloque os oito indicadores diante da sua equipe toda segunda-feira de manhã. Todo o resto, incluindo widgets de usuários por hora e apresentações executivas trimestrais, pode esperar até que esse único relatório seja confiável.
Veja o que cada métrica realmente informa:
- Tempo até a primeira resposta responde: quanto tempo os clientes esperam para ouvir de uma pessoa?
- MTTR responde: quanto tempo um problema realmente leva para ser encerrado, do início ao fim?
- Resolução no primeiro contato responde: os usuários resolvem os problemas na primeira tentativa ou ficam transferindo os tickets?
- CSAT responde: os clientes estão satisfeitos com a forma como o problema foi tratado?
- Conformidade com o SLA responde: você está cumprindo as promessas de resposta e resolução que fez?
- Volume de tickets e backlog respondem: a demanda recebida está crescendo mais rápido do que a capacidade da sua equipe?
- Taxa de reabertura responde: os tickets “resolvidos” continuam realmente resolvidos?
- Custo por ticket responde: quanto cada interação de suporte custa para a empresa?
Nenhum desses números significa muita coisa isoladamente. Um FRT rápido acompanhado de um FCR baixo significa apenas que você está respondendo rapidamente e errando. A verdadeira habilidade nas métricas de relatórios de helpdesk está em escolher as combinações certas, segmentá-las corretamente e encaminhar a visualização certa para a pessoa certa.
Principais conclusões
Relatórios confiáveis de helpdesk dependem do acompanhamento consistente de oito métricas essenciais, da segmentação correta e do encaminhamento da visualização certa ao público certo em uma frequência fixa.
| Ponto | Detalhes |
|---|---|
| Comece com oito métricas | Acompanhe FRT, MTTR, FCR, CSAT, conformidade com o SLA, índice de backlog, taxa de reabertura e custo por ticket. |
| Crie primeiro o painel semanal | Um relatório gerencial de uma página é melhor do que um sistema extenso com várias abas que ninguém consulta. |
| Adapte os painéis ao público | Executivos precisam de tendências, gestores precisam de visões operacionais diárias e usuários precisam de filas pessoais em tempo real. |
| Combine métricas para identificar manipulações | Acompanhe o FCR junto com a taxa de reabertura e o FRT junto com o CSAT para ter uma visão completa. |
| Deskhero oferece visualizações fixas de relatórios | A área Statistics abrange tendências de tickets, tempos de resposta, SLA, atividade da equipe, IA e automação, canais e tópicos. |
Índice
- Métricas de relatórios de helpdesk vs. KPIs: qual é a diferença?
- Métricas essenciais de help desk: definições, fórmulas e referências
- Como medir corretamente e evitar armadilhas comuns
- Crie painéis por público: visões executivas, gerenciais e de usuários
- Frequência de relatórios e modelos de relatório
- Transformando sinais das métricas em ações
- Governança de dados: garantindo a confiabilidade dos números
- Colocando esses relatórios em funcionamento sem trabalho manual
- Fontes
- Perguntas frequentes
Métricas de relatórios de helpdesk vs. KPIs: qual é a diferença?
Uma métrica é qualquer número que você pode medir. Um KPI é uma métrica que a sua organização decidiu que é importante o suficiente para receber uma meta e ser usada regularmente em ações. O volume de tickets é uma métrica. “Manter o volume médio de tickets abaixo de 40 por usuário por dia” é um KPI. Uma referência, por sua vez, é um ponto de comparação externo, como uma média do setor, que informa se a sua meta de KPI é realista em primeiro lugar.
Essa distinção é importante porque as equipes de suporte podem coletar muitas métricas sem decidir quais merecem uma meta e uma resposta regular. Um conjunto básico compacto é mais fácil de revisar de forma consistente. Adicione uma medida somente quando alguém for responsável por ela e souber qual ação uma mudança deve desencadear.
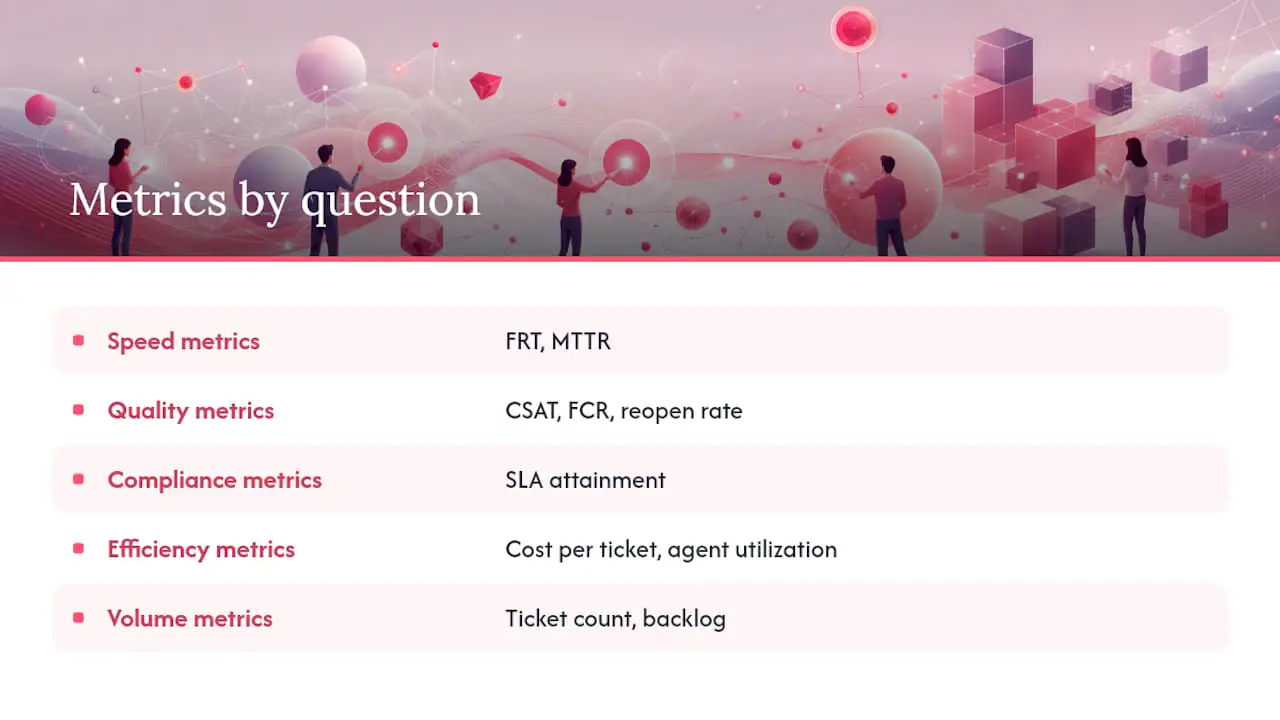
Agrupe suas métricas de acordo com a pergunta que respondem, e o design dos relatórios ficará muito mais simples:
Métricas de velocidade (FRT, MTTR) informam com que rapidez a equipe está trabalhando. Métricas de qualidade (CSAT, FCR, taxa de reabertura) informam se essa velocidade está gerando bons resultados. Métricas de conformidade (cumprimento do SLA) informam se você está cumprindo promessas contratuais ou internas. Métricas de eficiência (custo por ticket, utilização da equipe) informam quanto custa operar o serviço. Métricas de volume (quantidade de tickets, backlog) informam sobre a demanda.
Os executivos geralmente se preocupam com as tendências de eficiência e qualidade ao longo dos meses. Os gestores precisam consultar diariamente ou semanalmente as visões de conformidade e volume. Os usuários precisam de métricas de velocidade e qualidade relacionadas à própria fila. Misturar todos os públicos em um único painel pode ocultar as informações de que cada pessoa precisa.
Métricas essenciais de help desk: definições, fórmulas e referências
Veja a ficha de referência. Defina cada métrica explicitamente, segmente-a seguindo estas orientações e estabeleça metas com base nos seus próprios compromissos de serviço e na linha de base histórica.
Tempo até a primeira resposta (FRT) mede o tempo decorrido entre a criação de um ticket e a primeira resposta humana relevante. Sempre que possível, informe tanto a mediana quanto um percentil mais alto e exclua confirmações automáticas. Segmente por canal e prioridade, pois os clientes têm expectativas diferentes para e-mail, chat e telefone.
Tempo de resolução, frequentemente resumido como tempo médio até a resolução (MTTR), mede o ciclo desde a criação do ticket até sua resolução ou encerramento. Informe a mediana junto com a média ou em vez dela quando um pequeno número de tickets complexos puder distorcer o resultado. Segmente por prioridade e tipo de problema e defina como a espera pelo cliente afeta a contagem do tempo.
Resolução no primeiro contato (FCR) mede a parcela de tickets resolvidos sem uma interação de acompanhamento. Defina claramente o que significa “primeiro contato” e segmente por categoria e tempo de permanência do usuário para que mudanças no conjunto de tickets não sejam confundidas com mudanças de desempenho.
Satisfação do cliente (CSAT) mede a parcela de respostas positivas às pesquisas. Informe a quantidade e a taxa de respostas ao lado da pontuação, pois uma amostra pequena ou autoselecionada pode induzir ao erro. Segmente por categoria do problema antes de comparar usuários.
Conformidade com o SLA mede a porcentagem de tickets que cumprem os compromissos definidos de tempo de resposta e resolução. Segmente por nível de SLA e tipo de contrato do cliente; combinar SLAs empresariais e de planos gratuitos em um único número oculta a realidade.
Volume de tickets e backlog medem a demanda recebida e a fila de trabalho não resolvido. Acompanhe o backlog tanto como contagem absoluta quanto como índice (tickets abertos divididos pela capacidade média diária de resolução) para verificar se a fila está crescendo mais rápido do que a equipe consegue reduzi-la.
Taxa de reabertura mede a porcentagem de tickets resolvidos que são reabertos dentro de uma janela definida, normalmente de 48 a 72 horas. Segmente por usuário e categoria. Essa é a métrica que mantém o FCR honesto.
Custo por ticket mede o custo operacional total do suporte dividido pelo volume de tickets em determinado período. Segmente por canal, pois o suporte por telefone normalmente custa muito mais por ticket do que o suporte por e-mail ou chat.
| Métrica | Fórmula | Segmentar por | Ponto de partida da referência |
|---|---|---|---|
| Tempo até a primeira resposta | Tempo até a primeira resposta humana | Canal, prioridade | Definido pelo canal e pelo horário de suporte |
| MTTR (mediana) | Tempo entre a abertura e o encerramento | Nível de prioridade | Definido pela prioridade e pelo tipo de problema |
| Resolução no primeiro contato | Encerramentos no primeiro contato ÷ total de tickets | Categoria, tempo de permanência do usuário | Use uma linha de base histórica |
| CSAT | Respostas positivas ÷ total de respostas | Usuário, categoria | Mostre a pontuação, as respostas e a taxa de respostas |
| Conformidade com o SLA | Tickets dentro do SLA ÷ total de tickets | Nível de SLA, tipo de contrato | Definida por contrato |
| Taxa de reabertura | Tickets reabertos ÷ tickets resolvidos | Usuário, categoria | Combine com o FCR |
Duas métricas só fazem sentido quando analisadas juntas: resolução no primeiro contato e taxa de reabertura em até 48 horas. Um FCR alto acompanhado de uma taxa de reabertura crescente significa que os usuários estão encerrando tickets para atingir uma meta, não porque o problema foi realmente resolvido.
Como medir corretamente e evitar armadilhas comuns
A precisão da forma como você calcula uma métrica é mais importante do que a métrica escolhida. Use a mediana em vez da média para qualquer métrica baseada em tempo com uma cauda longa, o que, na prática, significa quase todo número de tempo de resolução que você reportar. Um único ticket que leva três semanas para ser encerrado porque está aguardando um fornecedor fará o tempo médio de resolução subir de uma maneira que representa incorretamente o desempenho de toda a equipe.
Conte a primeira resposta humana como seu FRT, não a confirmação automática “recebemos sua mensagem”. Se o seu sistema registrar a resposta automática como o primeiro contato, os números de FRT parecerão artificialmente rápidos e mascararão um problema real de equipe. Defina explicitamente sua janela de reabertura, seja de 24, 48 ou 72 horas, e aplique-a de forma consistente em todas as categorias para comparar situações equivalentes. Alinhe o relógio dos seus relatórios ao horário real de suporte; um ticket enviado às 23h de sexta-feira e respondido às 9h de segunda-feira não deve ser contabilizado da mesma forma que um atraso de três dias durante o horário comercial se a sua equipe não trabalha nos fins de semana.
Uma armadilha comum é calcular a média de uma métrica entre canais que funcionam de maneiras diferentes. Misturar o FRT de e-mail com o FRT de chat produz um número que não descreve bem nenhum dos dois canais. Outra armadilha é informar a resolução no primeiro contato sem a taxa de reabertura, o que pode recompensar encerramentos prematuros. O CSAT também precisa do tamanho da amostra e da taxa de respostas, não apenas da pontuação principal.
Dica profissional: Faça uma verificação rápida de consistência antes de apresentar um relatório. Selecione alguns tickets marcados como “dentro do SLA” e compare os respectivos horários com o relatório. Qualquer divergência merece investigação antes que o número seja usado para uma decisão.
Veja o FRT ao lado do CSAT e o índice de backlog ao lado da quantidade de violações do SLA. Essas combinações identificam problemas que um único número oculta. Uma equipe pode atingir todas as metas de SLA no papel enquanto o backlog triplica silenciosamente, porque a conformidade com o SLA mede os tickets que você tratou, não os que estão se acumulando atrás deles.
Crie painéis por público: visões executivas, gerenciais e de usuários
Públicos diferentes precisam de visões diferentes. Um painel criado para a carga de trabalho atual de um usuário é detalhado demais para um executivo que avalia tendências trimestrais, enquanto uma visão executiva estratégica muda lentamente demais para ajudar alguém a gerenciar a fila de hoje.
Executivos precisam de linhas de tendência, não de contadores ao vivo. Inclua na visão a tendência do CSAT ao longo do tempo, o custo por ticket por mês, o volume de tickets em relação ao número de funcionários, a tendência trimestral do MTTR, a tendência de cumprimento do SLA e uma trajetória geral do backlog. Eles consultam essa visão mensalmente, às vezes semanalmente, para identificar se a função de suporte está crescendo de forma saudável junto com a empresa.
Gestores precisam de detalhes operacionais atualizados diariamente. O painel deve mostrar tickets abertos por prioridade em tempo real, conformidade com o SLA detalhada por categoria, distribuição da carga de trabalho dos usuários, o volume de tickets de hoje em comparação com a média diária, a distribuição da idade do backlog e a taxa de reabertura por usuário. Essa é a visão que orienta as decisões de alocação de equipe e as reuniões diárias de triagem.
Usuários precisam de uma visão pessoal, restrita e em tempo real: seus próprios tickets abertos com contadores regressivos do SLA, sua pontuação pessoal de CSAT, sua taxa de FCR e uma fila de tickets aguardando sua resposta, ordenada por urgência. Qualquer informação além da própria carga de trabalho é ruído que os torna mais lentos.
| Tipo de painel | Frequência de atualização | Horizonte temporal | Métricas principais | Público principal |
|---|---|---|---|---|
| Operacional em tempo real | Em tempo real a de hora em hora | Hoje | Tickets abertos, contadores do SLA, profundidade da fila | Usuários, gestores |
| Tático semanal | Diária a semanal | Esta semana vs. a anterior | Volume, índice de backlog, carga de trabalho dos usuários | Gestores |
| Tendência estratégica | Semanal a mensal | Mês/trimestre/ano | Tendência do CSAT, custo por ticket, MTTR | Executivos |
As visões operacionais em tempo real ajudam os gestores a redistribuir o trabalho antes que uma fila ultrapasse suas metas. Os relatórios históricos têm outra finalidade: mostram se a carga de trabalho, a qualidade e os padrões de resposta estão melhorando ao longo do tempo.
A maioria das equipes pequenas e médias não precisa de uma integração completa com uma ferramenta de BI logo de início. Os relatórios integrados do helpdesk podem atender às revisões operacionais e semanais. Adicione uma ferramenta como Looker Studio ou Power BI quando precisar combinar dados de suporte com receita, equipe ou outros sistemas empresariais. Para muitas equipes, um painel de suporte ao cliente focado é suficiente para uma revisão semanal.
Seu checklist de KPIs de uma página para uma revisão semanal deve caber sem rolagem: FRT, MTTR (mediana), FCR, CSAT, conformidade com o SLA, índice de backlog, taxa de reabertura e custo por ticket. Oito números, uma tela, sem precisar procurar.
Frequência de relatórios e modelos de relatório
A frequência deve corresponder à rapidez com que uma métrica pode mudar de forma relevante e à rapidez com que alguém precisa agir sobre ela. Veja uma estrutura que você pode copiar diretamente.
-
Alertas diários. Configure gatilhos para tickets que se aproximam do prazo do SLA, mudanças incomuns no volume e crescimento da fila de prioridade crítica. Escolha os limites com base na sua linha de base operacional e envie alertas pelos canais que sua equipe acompanha ativamente.
-
Relatório semanal do gestor. Estruture-o como esta semana versus a semana passada versus a mesma semana do ano passado, com uma narrativa de duas frases no início explicando a maior mudança. Em seguida, inclua as cinco principais categorias de tickets por volume, uma visão da carga de trabalho dos usuários mostrando onde a capacidade está apertada e o conjunto principal de KPIs (FRT, tempo de resolução, FCR, CSAT, conformidade com o SLA, índice de backlog). Envie-o antes da revisão semanal da equipe.
-
Relatório empresarial mensal. Criado para diretores e executivos, ele abrange as tendências mensais e anuais dos mesmos indicadores principais, o custo por ticket por canal, uma análise de equipe comparando o número de funcionários ao crescimento do volume e uma breve observação sobre riscos futuros, como um próximo lançamento de produto que deverá aumentar o volume de tickets. Este é o relatório que justifica — ou questiona — as solicitações de aumento da equipe.
Muitas plataformas de helpdesk oferecem visões operacionais predefinidas. Use-as como ponto de partida, depois remova os campos sobre os quais ninguém age e defina cada cálculo antes de usá-lo como KPI.
Transformando sinais das métricas em ações
Um relatório que simplesmente fica parado na caixa de entrada é esforço desperdiçado. Toda métrica que se move na direção errada deve desencadear uma resposta específica e atribuída a alguém, não uma conversa vaga sobre “ficar de olho nisso”.
Backlog crescente. Primeiro, verifique se é um problema de volume ou de capacidade de processamento. Se o volume aumentou, mobilize uma equipe temporária de triagem ou abra um caminho de autoatendimento por meio de um chatbot de IA para perguntas comuns. Se a capacidade de processamento caiu, verifique se há uma lacuna de treinamento ou uma regra de encaminhamento com problemas. Responsável: gestor de suporte. Acompanhe o índice de backlog diariamente durante uma semana após a correção.
FCR em queda. Identifique as categorias que estão reduzindo o número e verifique se existe uma lacuna de conhecimento. Muitas vezes, um ou dois tipos de problemas ficam sendo transferidos repetidamente entre usuários. Atualize a base de conhecimento interna com um caminho claro de resolução para essa categoria e treine novamente a equipe. Responsável: líder da equipe. Verifique novamente o FCR por categoria após duas semanas, não imediatamente, pois os usuários precisam de tempo para assimilar as novas orientações.
CSAT em queda. Compare a mudança com o FRT e o tempo de resolução do mesmo período para verificar se um serviço mais lento está contribuindo para o resultado. Se a velocidade estiver estável, leia os tickets com respostas negativas e agrupe os motivos. Responsável: gestor. Analise a pontuação junto com a quantidade e a taxa de respostas.
Taxa de reabertura crescente. Compare-a com o FCR. A combinação pode indicar que os tickets estão sendo encerrados antes de o problema ser totalmente resolvido. Analise as categorias e os tickets afetados antes de alterar treinamentos ou incentivos. Responsável: gestor. Acompanhe semanalmente.
Custo por ticket crescente. Verifique primeiro a composição dos canais, pois telefone, e-mail e chat têm estruturas de custo diferentes. Se a composição estiver estável, examine a equipe, as horas extras, as ferramentas e a complexidade dos casos. Responsável: diretor. Analise mensalmente, pois essa métrica normalmente muda mais devagar do que as métricas da fila.
Dica profissional: Escolha uma janela de avaliação antes de fazer uma mudança. Ela deve ser longa o suficiente para incluir um volume representativo de tickets e pelo menos um ciclo normal de relatórios.
Mudanças no encaminhamento e na documentação podem afetar as métricas operacionais mais rapidamente do que uma contratação ou uma reformulação de treinamento. Ajuste a janela de revisão à intervenção e ao volume de tickets, em vez de declarar sucesso com base em um único dia positivo.
Governança de dados: garantindo a confiabilidade dos números
Nada disso funciona se os dados subjacentes estiverem errados, e geralmente há algum problema em algum lugar. Toda métrica essencial precisa de um responsável identificado pela sua definição, de um método de cálculo documentado que não mude sem aviso, de uma frequência de atualização definida e de uma regra para lidar com dados ausentes ou malformados.
Crie um checklist curto de governança e revise-o trimestralmente:
- Atribua um responsável a cada métrica, que deverá aprovar qualquer mudança em sua definição.
- Documente a fórmula exata do cálculo em um local que toda a equipe possa consultar, não apenas na cabeça de um gestor.
- Defina uma frequência fixa de atualização dos dados e alerte sobre qualquer falha nessa frequência, pois um fluxo de dados quebrado silenciosamente é pior do que não ter relatório algum.
- Defina uma quantidade ou taxa mínima de respostas antes de publicar o CSAT, com base no volume de tickets e no nível de confiança desejado.
- Realize auditorias periódicas por amostragem dos tickets, selecionando aleatoriamente de 10 a 15 tickets por mês e verificando manualmente os horários e a categorização em comparação com o relatório.
- Investigue mudanças repentinas que não tenham um evento operacional correspondente, pois elas podem indicar um problema de definição, etiquetagem ou integração.
Para referências, prefira fontes que publiquem sua metodologia e amostra. Use números externos apenas como contexto e depois defina metas com base nos seus próprios compromissos de serviço, conjunto de tickets, horários de suporte e linha de base histórica.
Uma observação prática sobre como fazer isso bem
A maioria das equipes fracassa nos relatórios de helpdesk não porque escolhe as métricas erradas, mas porque tenta acompanhar vinte delas desde o primeiro dia e abandona todo o esforço dentro de um mês. O acompanhamento consistente de oito métricas, com ações tomadas toda semana, ensinará mais sobre sua operação de suporte do que trinta métricas consultadas ocasionalmente.
Comece pelo painel gerencial semanal de uma página. Faça-o funcionar corretamente durante um mês antes de mexer nos relatórios executivos ou criar widgets individuais para usuários. É tentador construir o sistema completo no primeiro dia porque as ferramentas facilitam isso, mas a disciplina de acompanhar oito números de perto é melhor do que a ilusão de acompanhar trinta.
Para uma equipe pequena ou média sem uma pessoa dedicada a análises, o Deskhero oferece visões fixas de Statistics para tendências, tempos de resposta, SLA, atividade da equipe, IA e automação, canais e tópicos.
Colocando esses relatórios em funcionamento sem trabalho manual
Grande parte da dificuldade dos relatórios de helpdesk vem de conversas dispersas, campos de tickets inconsistentes e trabalho repetido em planilhas. O Deskhero conecta caixas de entrada do Gmail ou Microsoft 365 a um helpdesk compartilhado. Sua área Statistics apresenta relatórios sobre tendências de tickets, tempos de resposta, cumprimento do SLA, atividade da equipe, canais, IA e automação e padrões de tópicos.
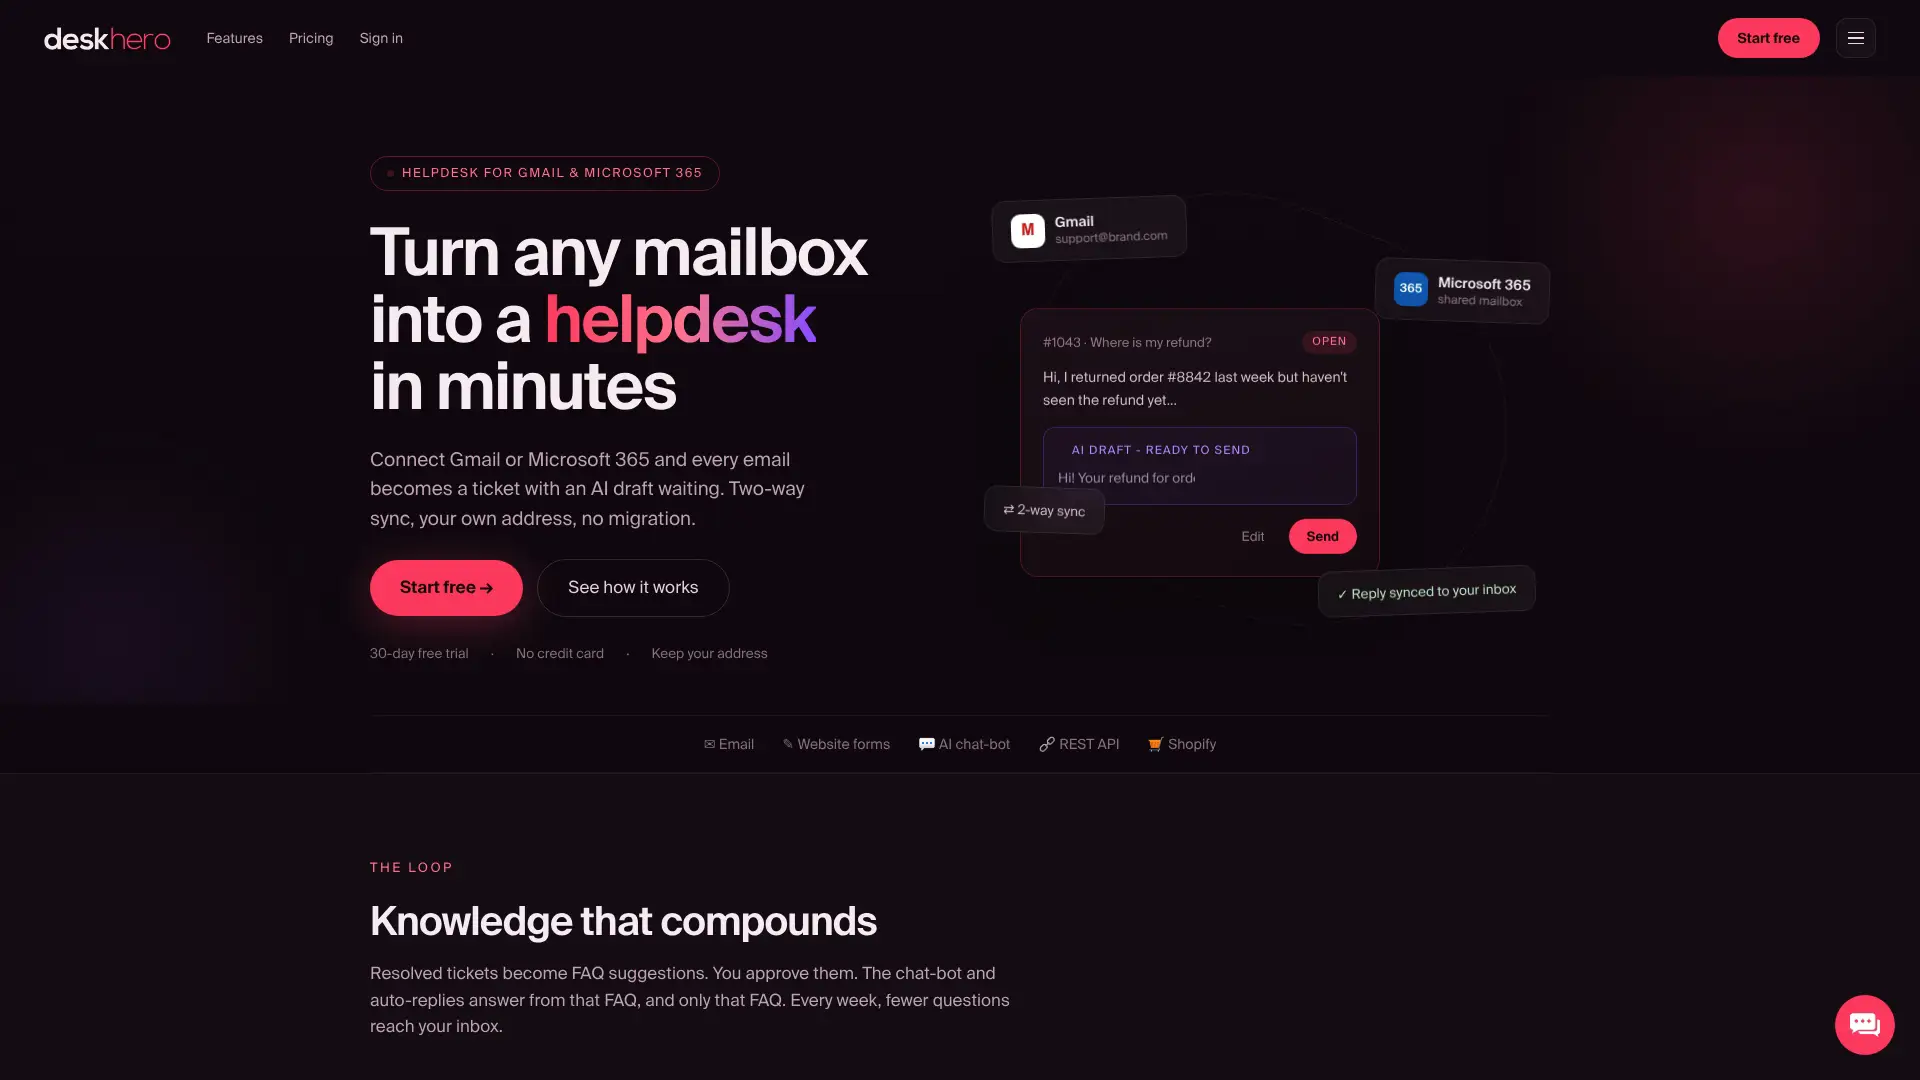
A sincronização bidirecional de e-mails mantém as mensagens recebidas e as respostas no histórico do ticket usado nos relatórios de tempo de resposta. Os rascunhos de respostas de IA usam o conhecimento do workspace, incluindo tickets respondidos, conhecimento interno, entradas aprovadas de FAQ pública, páginas coletadas do site e dados de produtos conectados do Shopify. A área Statistics oferece visualizações fixas de gráficos e tabelas, com exportação para Excel por aba. Para equipes de comércio eletrônico, o painel de clientes do Shopify coloca o contexto do cliente e do pedido na barra lateral do ticket.
Se você faz parte de uma equipe pequena ou média que está migrando de uma caixa de entrada compartilhada para relatórios estruturados, pode iniciar um teste gratuito de 30 dias sem cartão de crédito e revisar as visões de volume de tickets, tempo de resposta, tempo de resolução, SLA, canal e equipe sem precisar criar uma planilha primeiro.
Fontes
- Guia de relatórios e painéis de help desk 2026 | HelpDeskFocus
- KPIs e métricas de help desk: 10 referências essenciais | Softabase
Estas referências fornecem definições e exemplos adicionais. Verifique a metodologia de cada fonte e adapte qualquer referência à sua própria operação.
Perguntas frequentes
Quais são as principais métricas para relatórios de service desk?
O conjunto básico é composto por tempo até a primeira resposta, MTTR, resolução no primeiro contato, CSAT, conformidade com o SLA, volume de tickets e backlog, taxa de reabertura e custo por ticket, segmentados por canal, prioridade e categoria para garantir precisão.
Quais são as 5 principais métricas de CX?
As definições variam conforme a organização, mas uma lista prática inclui CSAT, resolução no primeiro contato, tempo até a primeira resposta, conformidade com o SLA e uma métrica de relacionamento, como o Net Promoter Score. Escolha medidas que tenham definições e responsáveis claros.
Quais são alguns exemplos de KPIs para um help desk de TI?
Entre os KPIs sólidos de um help desk de TI estão a conformidade com o SLA por nível de ticket, o MTTR por prioridade, o índice de backlog, o custo por ticket e a taxa de reabertura em até 48 horas, pois eles se relacionam diretamente tanto com a qualidade do serviço quanto com o custo operacional.
Quais são bons KPIs para um departamento de TI?
Além dos números específicos do helpdesk, os departamentos de TI geralmente acompanham a disponibilidade dos sistemas, o tempo médio para detectar e resolver incidentes e a taxa de falha de mudanças, junto com métricas padrão de suporte, como FRT e CSAT, para captar tanto a prestação do serviço quanto a confiabilidade da infraestrutura.
Com que frequência os relatórios de helpdesk devem ser revisados?
Defina alertas diários para limites de violação do SLA e picos de volume, revise semanalmente um relatório estruturado com sua equipe e produza um relatório empresarial mensal para os diretores, acompanhando as tendências mensais e anuais.
O software de helpdesk pode calcular essas métricas automaticamente?
Sim. O Deskhero oferece relatórios fixos de tendências de tickets, tempos de resposta, cumprimento do SLA, atividade da equipe, IA e automação, canais e tópicos. CSAT, FCR, taxa de reabertura e custo por ticket exigem uma medição separada, a menos que a plataforma escolhida ofereça suporte explícito a eles.