AI-klassifisering av supportsaker: En praktisk guide
AI-basert klassifisering av supportsaker leser innkommende supportsaker og forutsier etiketter som kategori, prioritet eller destinasjon. Det kan redusere repetitiv sortering, men usikre forutsigelser må fortsatt gjennomgås av mennesker. En praktisk pilot bruker representativ sakstekst, et tydelig definert etikettsett og konfidens terskler valgt ut fra valideringsresultater. Forskning som en komparativ studie fra 2025 kan hjelpe deg med å velge en referansemodell, mens denne introduksjonen til nøyaktighet, presisjon, gjenfinning og F1 forklarer de viktigste evalueringsmålingene.
Før du setter av budsjett til en modell, må du bekrefte det grunnleggende:
- Du har et representativt utvalg historiske supportsaker med brukbar tekst og pålitelige etiketter
- Den innledende taksonomien er liten nok til at saksbehandlere kan bruke den konsekvent
- Du kan sende forutsigelser med lav konfidens til en kø for menneskelig gjennomgang
- Noen i teamet ditt har ansvar for overvåking og korrigeringer etter lansering
Viktigste punkter
AI-basert klassifisering av supportsaker fungerer best når den kombinerer merkede eksempler, målbare akseptansekriterier, konfidens terskler og menneskelig gjennomgang, i stedet for full automatisering fra første dag.
| Punkt | Detaljer |
|---|---|
| Start med en begrenset pilot | Test én kø eller et lite sett med kategorier før du utvider klassifikatorens omfang. |
| Tilpass modellen til oppgaven | Studien fra 2025 viste at klassisk maskinlæring matchet eller overgikk de testede dyplæringsmodellene i flere scenarier for klassifisering av supportsaker. |
| Bruk konfidens terskler | Send usikre resultater til menneskelig gjennomgang i stedet for å tvinge frem en etikett. |
| Overvåk etter lansering | Følg med på feil per klasse og endringer i konfidensfordelingen, slik at du kan oppdage avdrift. |
| Skill klassifisering fra generering av svar | Saksruting og AI-genererte svar løser forskjellige problemer og bør evalueres uavhengig av hverandre. |
Innholdsfortegnelse
- Hva er AI-basert klassifisering av supportsaker?
- Hvordan behandler et AI-basert supportsystem en sak?
- Hvilken modelltilnærming passer for saksmengden din?
- Hvordan integrerer du en klassifikator i arbeidsflyten for supportsaker?
- Hvilke målinger viser at klassifikatoren din er klar?
- Hvordan holder du en klassifikator nøyaktig etter lansering?
- Hva går galt, og hvordan løser du det?
- Hvordan ser en fire ukers AI-klassifiseringspilot ut?
- Hvorfor passer Deskhero for team som piloterer AI-klassifisering?
- Start en pilot uten å vente på en migrering
- Kilder
- Vanlige spørsmål
Hva er AI-basert klassifisering av supportsaker?
AI-basert klassifisering av supportsaker er automatisk tildeling av forhåndsdefinerte etiketter til supportsaker basert på teksten og, i enkelte systemer, utvalgte metadata eller vedlegg. Disse etikettene kan brukes i rutingsregler, prioritetskøer, rapportering eller forslag til neste steg. Klassifikatoren reduserer bare behovet for manuell sortering når forutsigelsene oppfyller akseptansekriteriene dine. Den bør ikke i stillhet tvinge usikre saker inn i en kø.
De sannsynlige fordelene er raskere innledende sortering og mer konsekvente etiketter, men hvor stor forbedringen blir, avhenger av taksonomien, treningsdataene, arbeidsflyten og trafikken din. Mål resultatene opp mot den nåværende prosessen i stedet for å stole på en leverandørs fremhevede nøyaktighet.
Vanlige bruksområder omfatter å skille IT-forespørsler i kategoriene tilgang, maskinvare og programvare; sortere spørsmål fra netthandel i fakturering, levering og returer; og tildele saker etter språk. Klassifisering er også forskjellig fra generering av svar. En brukerstøtte kan for eksempel utarbeide et svar fra kunnskapskildene sine selv når en separat regel eller modell håndterer rutingen.
Hvordan behandler et AI-basert supportsystem en sak?
En typisk saksklassifikator bruker fem trinn. Detaljene varierer etter modell og integrasjon, men trinnene gir deg nyttige kontrollpunkter når noe går galt.
Arbeidsflyten, trinn for trinn:
- Innhenting. Systemet mottar sakstekst og relevante metadata fra brukerstøtten.
- Forbehandling. Det fjerner irrelevant markup eller signaturer og normaliserer inndataene. Noen implementeringer henter også ut tekst fra støttede vedlegg.
- Funksjonsuttrekking. En klassisk modell kan bruke TF-IDF-vektorer, mens en nevral modell kan bruke embedding-er eller token-er.
- Modellinferens. Klassifikatoren forutsier én eller flere etiketter og, når det er tilgjengelig, en konfidensskår.
- Etterbehandling og ruting. Regler godtar, avviser eller sender forutsigelsen til gjennomgang før saken oppdateres.
Flerspråklige saker kan oversettes før klassifisering eller behandles av en flerspråklig modell. Test begge tilnærmingene på din egen språkblanding, fordi oversettelse kan endre viktige termer. aiticketclassifier-prosjektet med åpen kildekode viser en TF-IDF-klassifiseringspipeline med kategoriforutsigelser, konfidensskårer, et kontrollpanel, anbefalinger og Slack-varsler. Sanntidsbehandling passer for arbeidsflyter der etiketten må påvirke en aktiv kø. Batchbehandling er nyttig for tilbakefylling og evaluering.
Hvilken modelltilnærming passer for saksmengden din?
Det finnes tre brede nivåer å vurdere. Det riktige valget avhenger av hvor tvetydige etikettene dine er, mengden og kvaliteten på dataene, kravene til forsinkelse og driftskostnadene.
Regel- og mønsterbaserte systemer kobler nøkkelord, adresser, domener eller regulære uttrykk til handlinger. De er raske og enkle å forklare, men et voksende regelsett kan bli vanskelig å vedlikeholde. De fungerer godt for smale tilfeller med høy presisjon, for eksempel kjente faktureringsadresser eller produktkoder.
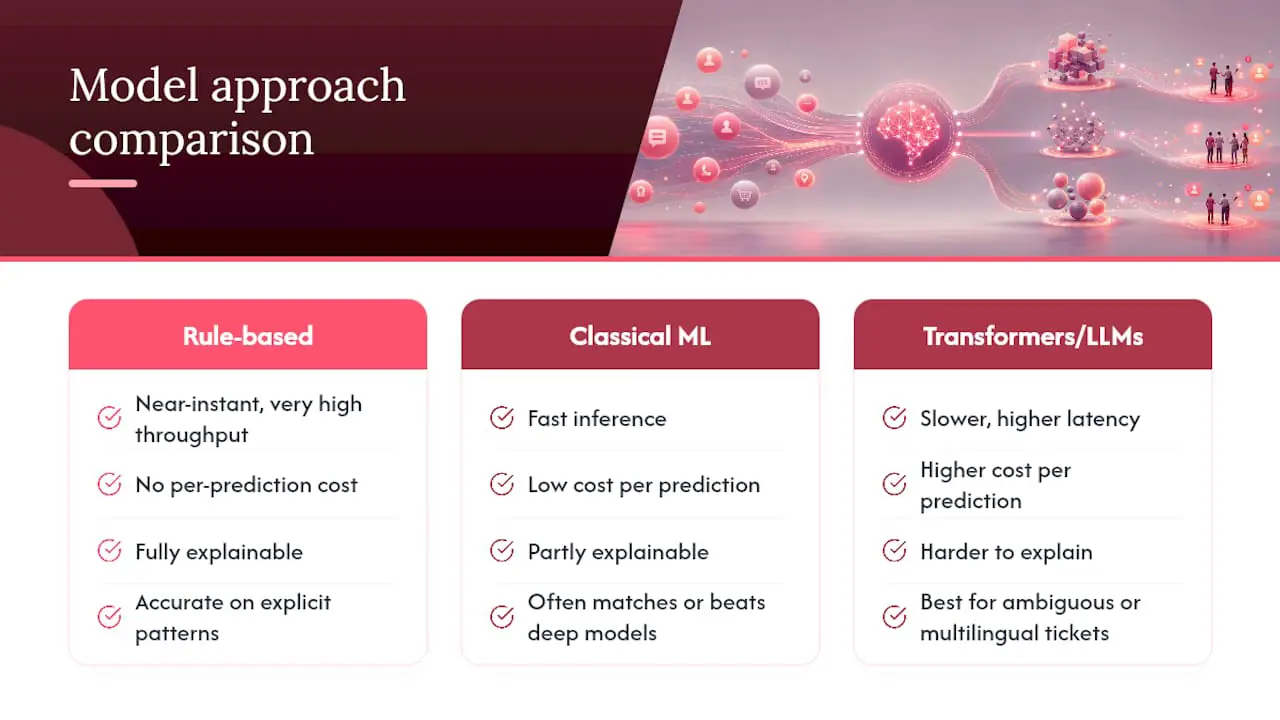
Klassiske maskinlæringsmetoder som logistisk regresjon, SVM og XGBoost trenes på merkede eksempler. Den komparative studien fra 2025 evaluerte åtte algoritmer på offentlige datasett og bedriftsdatasett. Den viste at kombinasjonen av sakstittel og beskrivelse forbedret ytelsen i alle testede scenarier, og at klassiske modeller matchet eller overgikk de testede dyplæringsmodellene i flere tilfeller.
Transformer- og LLM-tilnærminger kan være nyttige når saker er tvetydige, flerspråklige eller avhengige av bredere kontekst. De kan også medføre høyere kostnader, større forsinkelse og mer kompleks evaluering. Sammenlign dem med en enklere referansemodell i stedet for å anta at den større modellen vil prestere bedre.
Proff tips: Start med den minst komplekse tilnærmingen som oppfyller akseptansekriteriene dine. Studien fra 2025 rapporterte nøyaktighet og F1 over 0,95 for prioritetsklassifisering i de testede scenariene, mens kategoriklassifisering var vanskeligere på bedriftsdata.
Hvordan integrerer du en klassifikator i arbeidsflyten for supportsaker?
Integrasjonen lykkes når hver forutsigelse har en tydelig og reverserbar handling. Gå gjennom disse trinnene i rekkefølge:
- Revider dataene dine. Ta et utvalg fra en representativ periode og kontroller hvor konsekvent sakene ble merket.
- Utform taksonomien. Begynn med kategorier som saksbehandlerne kan skille på en pålitelig måte.
- Merk et startdatasett. Bruk brukerstøttespesialister som kjenner køen, og registrer uenigheter.
- Bygg en referansemodell. Sammenlign et enkelt regelsett eller en klassisk modell med den nåværende manuelle prosessen.
- Test hele integrasjonen. Bekreft hvordan forutsigelser, feil, nye forsøk og feltoppdateringer fungerer i en sandkasse.
- Rull ut i faser. Start med én kø eller en liten gruppe etiketter med høy konfidens.
En ekstern klassifikator leser vanligvis nye saker gjennom brukerstøttens støttede integrasjonsmetode og skriver den godkjente etiketten tilbake til felt som gruppe, prioritet eller tagger. Kontroller om brukerstøtten støtter utgående hendelser eller krever polling. Deskheroes REST API støtter visning og oppdatering av saker, men tilbyr ikke utgående webhooks, så en ekstern klassifikator må polle API-et. Se Deskheroes arbeidsflyt for e-post til sak for oppsett av postkasse og oppretting av saker.
Hvilke målinger viser at klassifikatoren din er klar?
Fire målinger er spesielt nyttige: presisjon (hvor mange av de forutsagte etikettene som var riktige), gjenfinning (hvor mange sanne forekomster som ble funnet), F1 (det harmoniske gjennomsnittet av presisjon og gjenfinning) og konfidenskalibrering (om de forutsagte sannsynlighetene samsvarer med observerte resultater).
For problemer med flere klasser bør du undersøke både makrogjennomsnittlig F1, som gir hver klasse lik vekt, og mikrogjennomsnittlig F1, som domineres av klasser med høyt volum. Se også på en forvekslingsmatrise samt presisjon og gjenfinning per klasse. En enkelt samlet skår kan skjule alvorlige feil i sjeldne, men viktige kategorier.
Evaluer på et avholdt sett med reelle saker som gjenspeiler trafikken i produksjon. Definer akseptansekriterier ut fra kostnaden ved hver feil. En feilaktig hasteetikett sløser med kapasitet, mens en oversett hastesak kan føre til brudd på en SLA.
Proff tips: En konfidens terskel er en beslutningsregel, ikke en universell prosentandel. Velg den ut fra valideringsdata, og send deretter forutsigelser under terskelen til menneskelig gjennomgang.
Hvordan holder du en klassifikator nøyaktig etter lansering?
Lansering er ikke målstreken. Følg med på forutsigelsesvolum per kategori, feil per klasse, konfidensfordelingen, volumet i gjennomgangskøen og den operative virkningen av feildirigerte saker.
- Samle inn korrigeringer som tilbakemeldinger med etiketter, og kontroller dem for konsekvens
- Kjør nye modellversjoner i skyggemodus før de kan endre saker
- Rull ut oppdateringer kø for kø, og behold en mulighet for tilbakerulling
- Behold menneskelig gjennomgang for forutsigelser under den valgte terskelen
Hvor ofte modellen bør trenes på nytt, bør følge observert avdrift, ikke en tilfeldig kalender. En produktlansering, endring i taksonomien eller et nytt kundesegment kan gjøre det nødvendig å trene modellen på nytt tidligere. Deskheroes veiledning for kontrollpaneler for kundestøtte tilbyr et bredere rammeverk for valg av støttemålinger, men klassifikatorspesifikke målinger trenger fortsatt egen overvåking.
Hva går galt, og hvordan løser du det?
Inkonsistente etiketter er en vanlig feilkilde. Hvis brukerstøttespesialister tildeler ulike kategorier til lignende saker, lærer modellen denne uenigheten. Skriv retningslinjer for merking, gå gjennom omstridte eksempler og mål enigheten før du skalerer. Ubalanse mellom klassene skaper en annen risiko, fordi en samlet skår kan se sterk ut mens en kategori med lavt volum presterer dårlig. Bruk målinger per klasse og samle inn flere representative eksempler der det er nødvendig.
Tvetydige saker trenger en tydelig reserveprosess. Send usikre forutsigelser til en gjennomgangskø, behold det opprinnelige modellresultatet for analyse, og la korrigeringer inngå i det neste evalueringssettet. For LLM-baserte systemer må du kontrollere at resultatet er en av de tillatte etikettene før en arbeidsflythandling kjøres.
Personvern fortjener et eget punkt. Ikke send saker som inneholder personopplysninger til en tredjepartsmodell med mindre de juridiske kravene og sikkerhetskravene dine er oppfylt, inkludert en passende databehandleravtale der det kreves.
Proff tips: Begrens feltene som sendes til klassifikatoren. Hvis modellen bare trenger et emne og en melding, skal du ikke inkludere irrelevante kundedata.
Hvordan ser en fire ukers AI-klassifiseringspilot ut?
En tidsplan på fire uker kan fungere som en planleggingsmal, selv om datamengden og tiden som brukes på gjennomgang, bør avgjøre den faktiske fremdriften:
- Uke 0, avgrensning. Velg én kø, definer taksonomien, velg referansemålinger og dokumenter uakseptable feil.
- Uke 1, merking og referansemodell. Merk et representativt utvalg, løs uenigheter og tren eller konfigurer den enkleste gjennomførbare referansemodellen.
- Uke 2, integrasjon og skygg testing. Kjør forutsigelser på aktive saker uten å endre feltene deres.
- Uke 3 til 4, begrenset utrulling og evaluering. Aktiver handlinger bare for validerte tilfeller med høy konfidens, og mål deretter modellkvalitet, belastning i gjennomgangskøen, rutingskorrigeringer og resultater for brukerstøtten.
Ikke betrakt fire uker som en garanti. Forleng skygg testingen hvis sjeldne kategorier mangler, merkekvaliteten er inkonsekvent eller integrasjonen ikke kan feile på en trygg måte.
Hvorfor passer Deskhero for team som piloterer AI-klassifisering?
Deskhero gjør en Gmail-, Google Workspace- eller Microsoft 365-postkasse om til en brukerstøtte uten å endre e-postadressen som kundene ser. Nye saker kan også komme inn gjennom innebygde skjemaer og AI-chatboten. Dette gir piloten en konsekvent sakspost, samtidig som brukere fortsetter å arbeide i en delt innboks.
Deskheroes automatiseringer for nye saker kan evaluere AI-betingelser i vanlig språk og angi saksbehandler, gruppe, status, prioritet, tagger eller rullegardinfelt. Dette støtter praktisk AI-assistert sortering uten at du må bygge en tilpasset modell. For en separat klassifikator kan REST API-et vise og oppdatere saker, men integrasjonen må polle fordi Deskhero ikke har utgående webhooks. AI-forslag til svar er en separat funksjon basert på kunnskap i arbeidsområdet, mens AI-genererte autosvar rettet mot kunder og chatboten bare svarer fra den godkjente offentlige FAQ-en. Deskhero støtter også flerspråklige saker.
Implementeringsnotater
Hold den første taksonomien smal, loggfør alle korrigeringer og skill mellom modelevaluering og evaluering av arbeidsflyten. En klassifikator kan ha en sterk F1-skår og likevel skape operative problemer hvis den tildeler feil gruppe eller overskriver et felt brukere trenger. Start med skyggeforutsigelser, og aktiver deretter reverserbare handlinger for de tydeligste tilfellene.
Start en pilot uten å vente på en migrering
Deskhero kan kobles til en eksisterende Gmail-, Google Workspace- eller Microsoft 365-postkasse, inkludert delte Microsoft-postkasser. Du kan først teste innebygde automatiseringer for nye saker som angir rutingsfelt ut fra eksplisitte betingelser eller en AI-evaluert betingelse. Hvis du trenger en separat opplært klassifikator, kan du bruke REST API-et til å polle etter saker og oppdatere godkjente etiketter.
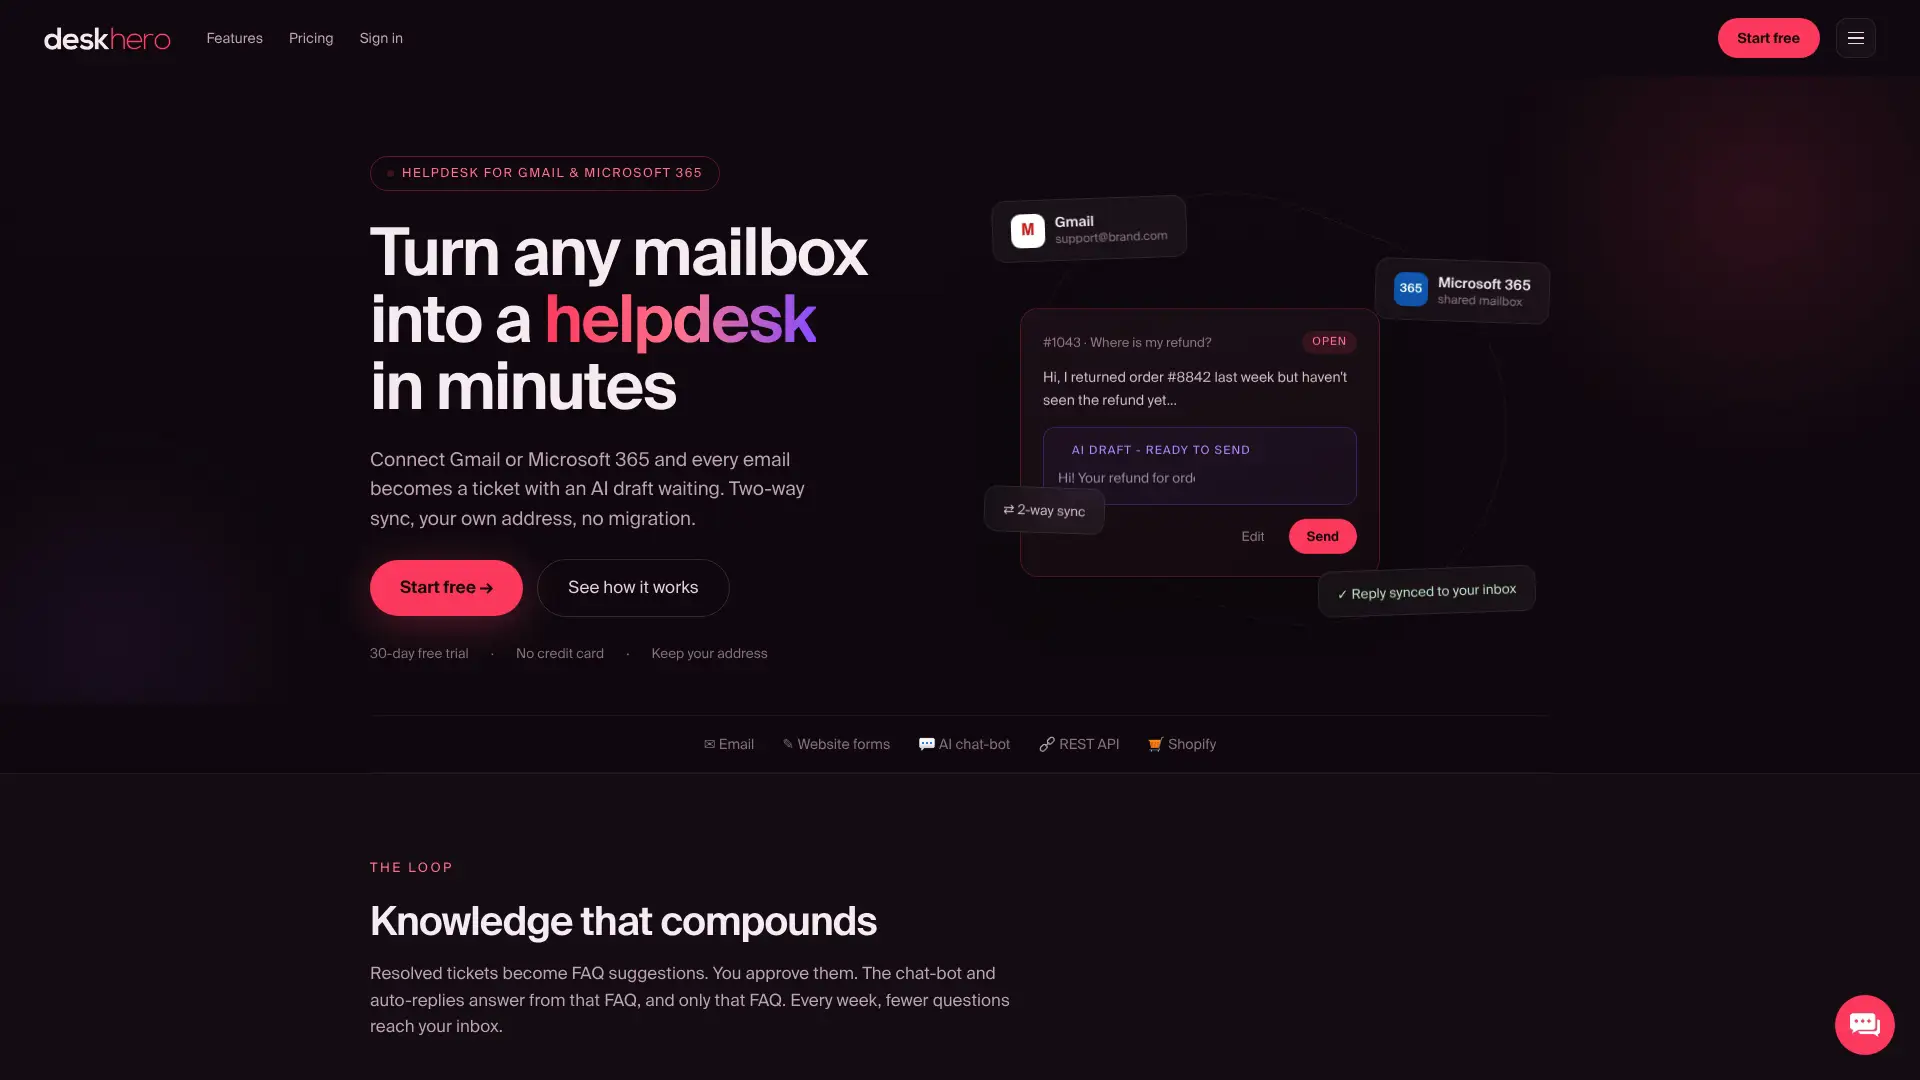
Hold klassifisering, ruting og generering av svar som separate kontroller. Deskheroes foreslåtte svar bruker kunnskap fra arbeidsområdet og er fortsatt tilgjengelige for at en bruker skal kunne godta, redigere eller avvise dem. AI-autosvarene og chatboten bruker bare godkjente offentlige FAQ-elementer, og chatboten krever minst 100 godkjente FAQ-elementer før aktivering. Deskhero tilbyr en gratis prøveperiode på 30 dager uten krav om kredittkort.
Kilder
Følgende ressurser gir en forskningssammenligning, en fungerende referanseimplementering og definisjoner av de viktigste evalueringsmålingene:
- Komparativ studie av maskinlærings- og dyplæringsalgoritmer for klassifisering av kundestøttesaker
- aiticketclassifier (GitHub)
- Hva er nøyaktighet, presisjon, gjenfinning og F1-skår?
Vanlige spørsmål
Hva er et AI-basert supportsystem?
Et AI-basert supportsystem er en brukerstøtte eller tilkoblet tjeneste som bruker maskinlæring eller språkmodeller til oppgaver som klassifisering, prioritering, ruting, utforming av svar eller automatiserte svar. De nøyaktige funksjonene varierer fra produkt til produkt.
Hva er klassifiseringsmodeller i AI?
Klassifiseringsmodeller tildeler én eller flere forhåndsdefinerte etiketter til nye inndata basert på regler eller mønstre som er lært fra merkede eksempler. I supportsystemer kan etiketten være en kategori, prioritet, språk eller destinasjonsgruppe.
Hva er AI-saksmetoden?
Det finnes ingen standardisert «AI-saksmetode». En typisk pipeline henter inn sakstekst, klargjør inndataene, forutsier en etikett, validerer resultatet mot regler og konfidenskriterier og oppdaterer eller legger deretter saken i kø.
Hvordan klassifiserer AI supportsaker nøyaktig?
Nøyaktigheten avhenger av konsekvente etiketter, representative eksempler, passende inndatafelt og testing på avholdte saker. Den komparative studien fra 2025 viste at kombinasjonen av tittel og beskrivelse forbedret resultatene i alle scenariene som ble testet.
Kan en brukerstøtte som Deskhero håndtere klassifisering av supportsaker uten et datavitenskapsteam?
Deskhero kan utføre AI-assistert sortering av nye saker gjennom automatiseringsregler med AI-betingelser i vanlig språk. Disse reglene kan angi felt som gruppe, prioritet, saksbehandler, status og tagger. En separat opplært statistisk klassifikator krever en ekstern integrasjon som poller Deskheroes REST API.