Klasifikace tiketů pomocí AI pro týmy podpory: praktický průvodce
Klasifikace tiketů pomocí AI čte příchozí tikety podpory a předpovídá štítky, jako jsou kategorie, priorita nebo cílové umístění. Může omezit opakované třídění, nejisté předpovědi však stále vyžadují kontrolu člověkem. Praktický pilot využívá reprezentativní text tiketů, jasně definovanou sadu štítků a prahové hodnoty spolehlivosti zvolené na základě výsledků validace. Výzkum, například srovnávací studie z roku 2025, vám může pomoci zvolit výchozí řešení, zatímco tento úvod do metrik accuracy, precision, recall a F1 vysvětluje základní metriky hodnocení.
Než modelu vyčleníte rozpočet, ověřte základní předpoklady:
- Máte reprezentativní soubor historických tiketů s použitelným textem a spolehlivými štítky
- Vaše počáteční taxonomie je dostatečně malá na to, aby ji kontroloři používali konzistentně
- Můžete předpovědi s nízkou mírou spolehlivosti odesílat do fronty ke kontrole člověkem
- Někdo ve vašem týmu odpovídá po spuštění za monitorování a opravy
Hlavní závěry
Klasifikace tiketů pomocí AI funguje nejlépe, když kombinuje označené příklady, měřitelná kritéria přijatelnosti, prahové hodnoty spolehlivosti a kontrolu člověkem, místo aby od prvního dne spoléhala na úplnou automatizaci.
| Význam | Podrobnosti |
|---|---|
| Začněte omezeným pilotem | Před rozšířením záběru klasifikátoru otestujte jednu frontu nebo malou sadu kategorií. |
| Přizpůsobte model úloze | Studie z roku 2025 zjistila, že klasické metody strojového učení se v několika scénářích klasifikace tiketů vyrovnaly testovaným modelům hlubokého učení nebo je překonaly. |
| Používejte prahové hodnoty spolehlivosti | Nejisté výsledky směrujte ke kontrole člověkem, místo abyste vynucovali přiřazení štítku. |
| Po spuštění systém monitorujte | Sledujte chyby podle tříd a změny v rozložení spolehlivosti, abyste mohli odhalit posun. |
| Oddělte klasifikaci od generování odpovědí | Směrování tiketů a odpovědi vytvořené pomocí AI řeší odlišné problémy a měly by být hodnoceny nezávisle. |
Obsah
- Co je klasifikace tiketů pomocí AI?
- Jak systém pro správu tiketů s AI zpracovává tiket?
- Jaký přístup k modelu odpovídá objemu vašich tiketů?
- Jak začleníte klasifikátor do pracovního postupu správy tiketů?
- Které metriky dokazují, že je váš klasifikátor připraven?
- Jak udržíte přesnost klasifikátoru po spuštění?
- Co se může pokazit a jak to napravíte?
- Jak vypadá čtyřtýdenní pilot klasifikace pomocí AI?
- Proč je Deskhero vhodný pro týmy testující klasifikaci pomocí AI?
- Začněte pilot bez čekání na migraci
- Zdroje
- Časté dotazy
Co je klasifikace tiketů pomocí AI?
Klasifikace tiketů pomocí AI je automatické přiřazování předem definovaných štítků tiketům podpory na základě jejich textu a v některých systémech také vybraných metadat nebo příloh. Tyto štítky mohou sloužit jako podklad pro pravidla směrování, fronty podle priority, reportování nebo návrhy dalších kroků. Klasifikátor omezuje ruční třídění pouze u předpovědí, které splňují vaše kritéria přijatelnosti. Neměl by nejisté tikety bez upozornění násilně zařazovat do fronty.
Pravděpodobnými přínosy jsou rychlejší počáteční třídění a konzistentnější štítky, rozsah zlepšení však závisí na vaší taxonomii, trénovacích datech, pracovním postupu a objemu provozu. Výsledky měřte vůči současnému procesu, místo abyste se spoléhali na marketingovou hlavní metriku přesnosti dodavatele.
Mezi běžná použití patří rozdělení požadavků na IT do kategorií přístupu, hardwaru a softwaru; třídění dotazů v e-commerce do kategorií fakturace, dopravy a vratek; a přiřazování tiketů podle jazyka. Klasifikace se také liší od generování odpovědí. Například helpdesk může vytvořit návrh odpovědi ze svých znalostních zdrojů, i když směrování zajišťuje samostatné pravidlo nebo model.
Jak systém pro správu tiketů s AI zpracovává tiket?
Typický klasifikátor tiketů využívá pět fází. Podrobnosti se liší podle modelu a integrace, jednotlivé fáze vám však poskytnou užitečné kontrolní body, když se něco pokazí.
Proces krok za krokem:
- Příjem dat. Systém přijme text tiketu a relevantní metadata z helpdesku.
- Předzpracování. Odstraní irelevantní značky nebo podpisy a normalizuje vstup. Některé implementace také extrahují text z podporovaných příloh.
- Extrakce příznaků. Klasický model může používat vektory TF-IDF, zatímco neuronový model může využívat embeddingy nebo tokeny.
- Inference modelu. Klasifikátor předpoví jeden nebo více štítků a případně také skóre spolehlivosti.
- Dodatečné zpracování a směrování. Pravidla před aktualizací tiketu předpověď přijmou, odmítnou nebo odešlou ke kontrole.
Vícejazyčné tikety lze před klasifikací přeložit nebo je zpracovat vícejazyčným modelem. Otestujte oba přístupy na vlastní jazykové skladbě, protože překlad může změnit důležité pojmy. Open-source projekt aiticketclassifier ukazuje klasifikační proces s TF-IDF, předpověďmi kategorií, skóre spolehlivosti, dashboardem, doporučeními a upozorněními ve Slacku. Zpracování v reálném čase se hodí pro pracovní postupy, u nichž musí štítek ovlivnit aktivní frontu. Dávkové zpracování je užitečné pro zpětné doplnění dat a vyhodnocování.
Jaký přístup k modelu odpovídá objemu vašich tiketů?
Je třeba zvážit tři obecné úrovně. Správná volba závisí na nejednoznačnosti vašich štítků, množství a kvalitě dat, požadavcích na latenci a provozních nákladech.
Systémy založené na pravidlech a vzorcích přiřazují akce podle klíčových slov, adres, domén nebo regulárních výrazů. Jsou rychlé a snadno vysvětlitelné, rostoucí sada pravidel se však může stát obtížně udržovatelnou. Dobře fungují v úzkých případech s vysokou přesností, například u známých fakturačních adres nebo kódů produktů.
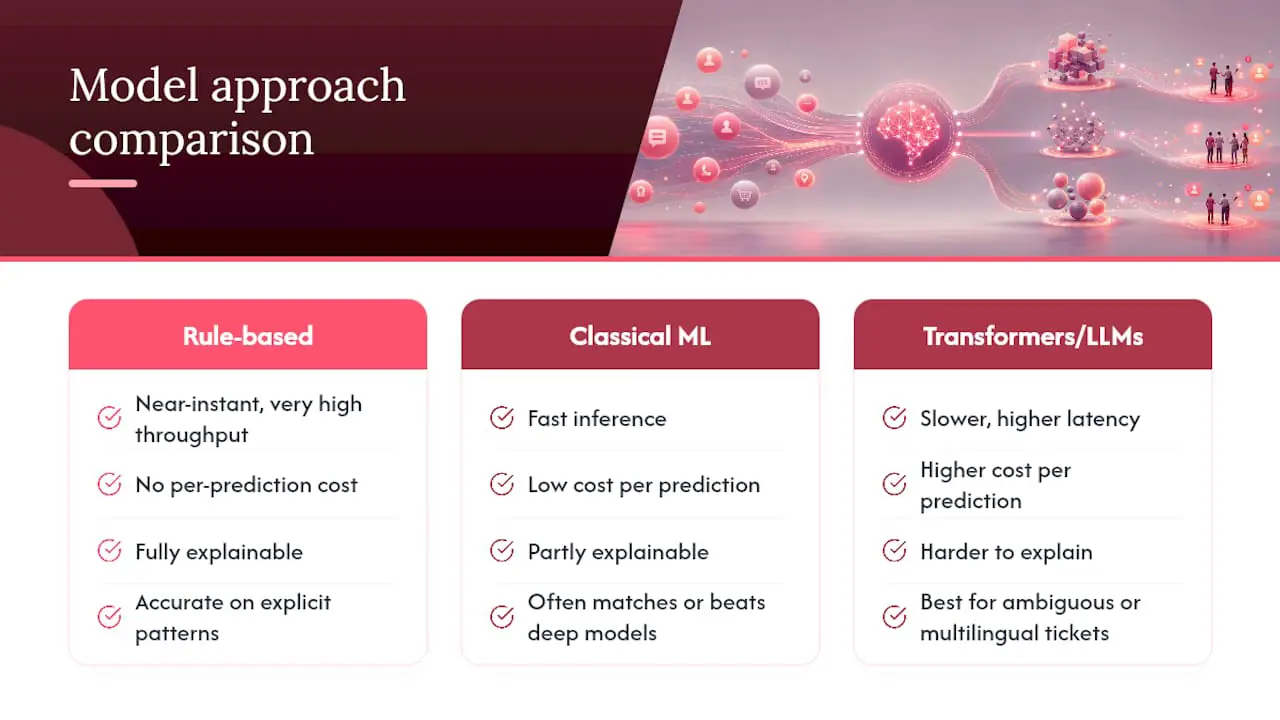
Klasické metody strojového učení, jako jsou logistická regrese, SVM a XGBoost, se trénují na označených příkladech. Srovnávací studie z roku 2025 hodnotila osm algoritmů na veřejných a podnikových datasetech. Zjistila, že kombinace názvu a popisu tiketu zlepšila výkon ve všech testovaných scénářích a že klasické modely se v několika případech vyrovnaly testovaným modelům hlubokého učení nebo je překonaly.
Přístupy založené na transformerech a LLM mohou být užitečné, když jsou tikety nejednoznačné, vícejazyčné nebo závislé na širším kontextu. Mohou však také zvýšit náklady, latenci a složitost hodnocení. Porovnejte je s jednodušší výchozí variantou, místo abyste předpokládali, že větší model bude fungovat lépe.
Tip: Začněte s nejméně složitým přístupem, který splňuje vaše kritéria přijatelnosti. Studie z roku 2025 uvádí přesnost a F1 vyšší než 0,95 při klasifikaci priority v testovaných scénářích, zatímco klasifikace kategorií byla na podnikových datech obtížnější.
Jak začleníte klasifikátor do pracovního postupu správy tiketů?
Integrace je úspěšná tehdy, když má každá předpověď jasnou a vratnou akci. Postupujte v těchto krocích:
- Proveďte audit dat. Vyberte reprezentativní období a ověřte, jak konzistentně byly tikety označovány.
- Navrhněte taxonomii. Začněte kategoriemi, které dokážou kontroloři spolehlivě rozlišit.
- Označte počáteční dataset. Využijte specialisty podpory, kteří frontě rozumějí, a zaznamenávejte neshody.
- Vytvořte výchozí variantu. Porovnejte jednoduchou sadu pravidel nebo klasický model se současným ručním procesem.
- Otestujte úplnou integraci. V sandboxu ověřte, jak se zpracovávají předpovědi, chyby, opakované pokusy a aktualizace polí.
- Spouštějte po etapách. Začněte jednou frontou nebo malou skupinou štítků s vysokou mírou spolehlivosti.
Externí klasifikátor obvykle načítá nové tikety prostřednictvím podporované integrační metody helpdesku a zapisuje přijatý štítek zpět do polí, jako jsou skupina, priorita nebo štítky. Ověřte, zda helpdesk podporuje odchozí události, nebo vyžaduje dotazování. REST API Deskhero podporuje výpis a aktualizaci tiketů, neposkytuje však odchozí webhooky, takže externí klasifikátor musí API pravidelně dotazovat. Informace o nastavení schránky a vytváření tiketů najdete v pracovním postupu převodu e-mailu na tiket v Deskhero.
Které metriky dokazují, že je váš klasifikátor připraven?
Obzvlášť užitečná jsou čtyři měření: precision (kolik předpovězených štítků bylo správných), recall (kolik skutečných případů bylo nalezeno), F1 (harmonický průměr precision a recall) a kalibrace spolehlivosti (zda předpovězené pravděpodobnosti odpovídají pozorovaným výsledkům).
U úloh s více třídami sledujte jak makroprůměrované F1, které dává každé třídě stejnou váhu, tak mikroprůměrované F1, kterému dominují třídy s vysokým objemem. Prozkoumejte také konfuzní matici a precision a recall pro jednotlivé třídy. Jediné souhrnné skóre může skrývat závažné chyby ve vzácných, ale důležitých kategoriích.
Vyhodnocujte na oddělené sadě skutečných tiketů, která odráží provoz v produkci. Kritéria přijatelnosti definujte podle nákladů jednotlivých chyb. Chybně označený urgentní tiket plýtvá kapacitou, zatímco přehlédnutý urgentní tiket může vést k porušení SLA.
Tip: Prahová hodnota spolehlivosti je rozhodovací pravidlo, nikoli univerzální procentní hodnota. Zvolte ji na základě validačních dat a předpovědi pod touto hodnotou směrujte ke kontrole člověkem.
Jak udržíte přesnost klasifikátoru po spuštění?
Nasazení není cílová rovinka. Sledujte objem předpovědí podle kategorií, chyby podle tříd, rozložení spolehlivosti, objem fronty ke kontrole a provozní dopad nesprávně směrovaných tiketů.
- Shromažďujte opravy jako označenou zpětnou vazbu a kontrolujte jejich konzistenci
- Nové verze modelu nejprve spouštějte ve stínovém režimu, než jim umožníte měnit tikety
- Aktualizace zavádějte po jednotlivých frontách a zachovejte možnost návratu k předchozí verzi
- U předpovědí pod zvolenou prahovou hodnotou zachovejte kontrolu člověkem
Četnost dalšího trénování by se měla řídit pozorovaným posunem, nikoli libovolným kalendářem. Uvedení produktu na trh, změna taxonomie nebo nový zákaznický segment mohou být důvodem k dřívějšímu trénování. Průvodce dashboardy zákaznické podpory v Deskhero nabízí širší rámec pro výběr metrik podpory, měření specifická pro klasifikátor však stále vyžadují vlastní monitorování.
Co se může pokazit a jak to napravíte?
Nekonzistentní štítky jsou častým zdrojem problémů. Pokud specialisté podpory přiřazují podobným tiketům různé kategorie, model se naučí tuto neshodu. Sepište pokyny pro označování, kontrolujte sporné příklady a před rozšířením měřte míru shody. Nerovnováha tříd představuje další riziko, protože souhrnné skóre může vypadat dobře, zatímco kategorie s nízkým objemem si vede špatně. Používejte metriky pro jednotlivé třídy a podle potřeby shromažďujte reprezentativnější příklady.
Nejednoznačné tikety potřebují jasně definovaný záložní postup. Nejisté předpovědi odesílejte do fronty ke kontrole, původní výstup modelu si ponechte pro analýzu a nechte opravy ovlivnit další vyhodnocovací sadu. U systémů založených na LLM ověřte, že výstup patří mezi povolené štítky, ještě než se spustí jakákoli akce pracovního postupu.
Soukromí si zaslouží vlastní položku. Tikety obsahující osobní údaje neposílejte modelu třetí strany, pokud nejsou splněny vaše právní a bezpečnostní požadavky, včetně odpovídající dohody o zpracování údajů, pokud je vyžadována.
Tip: Omezte množství polí odesílaných klasifikátoru. Pokud model potřebuje pouze předmět a zprávu, neposílejte nesouvisející údaje o zákazníkovi.
Jak vypadá čtyřtýdenní pilot klasifikace pomocí AI?
Čtyřtýdenní harmonogram může sloužit jako plánovací šablona, skutečné tempo by však mělo určovat množství dat a čas dostupný pro kontrolu:
- Týden 0, vymezení. Vyberte jednu frontu, definujte taxonomii, zvolte základní metriky a zdokumentujte nepřijatelné chyby.
- Týden 1, označování a výchozí varianta. Označte reprezentativní vzorek, vyřešte neshody a natrénujte nebo nakonfigurujte nejjednodušší použitelnou výchozí variantu.
- Týden 2, integrace a stínové testování. Spouštějte předpovědi na živých tiketech, aniž byste měnili jejich pole.
- Týdny 3 až 4, omezené spuštění a vyhodnocení. Akce povolte pouze u ověřených případů s vysokou mírou spolehlivosti a poté měřte kvalitu modelu, zatížení kontrolní fronty, opravy směrování a výsledky podpory.
Čtyři týdny nepovažujte za záruku. Stínové testování prodlužte, pokud chybí vzácné kategorie, kvalita štítků je nekonzistentní nebo integrace nedokáže bezpečně selhat.
Proč je Deskhero vhodný pro týmy testující klasifikaci pomocí AI?
Deskhero promění schránku Gmailu, Google Workspace nebo Microsoft 365 v helpdesk, aniž by změnil e-mailovou adresu, kterou používají zákazníci. Nové tikety mohou přicházet také prostřednictvím vložených formulářů a chatbota s AI. Pilot tak získá konzistentní záznam tiketu, zatímco Uživatelé mohou nadále pracovat ve sdílené schránce.
Automatizace nových tiketů v Deskhero může vyhodnocovat podmínky AI formulované běžným jazykem a nastavit přiřazeného řešitele, skupinu, stav, prioritu, štítky nebo pole s rozbalovacím seznamem. To podporuje praktické třídění s pomocí AI bez nutnosti vytvářet vlastní model. U samostatného klasifikátoru může REST API vypisovat a aktualizovat tikety, integrace však musí API dotazovat, protože Deskhero nemá odchozí webhooky. Odpovědi navržené pomocí AI jsou samostatnou funkcí založenou na znalostech pracovního prostoru, zatímco automatické odpovědi AI určené zákazníkům a chatbot odpovídají pouze z veřejných FAQ, které byly schváleny. Deskhero také podporuje vícejazyčné tikety.
Poznámky k implementaci
První taxonomii udržujte úzkou, zaznamenávejte každou opravu a rozlišujte mezi hodnocením modelu a hodnocením pracovního postupu. Klasifikátor může mít vysoké skóre F1 a přesto způsobovat provozní problémy, pokud přiřazuje nesprávnou skupinu nebo přepisuje pole, které Uživatelé potřebují. Začněte stínovými předpověďmi a poté povolte vratné akce u nejjasnějších případů.
Začněte pilot bez čekání na migraci
Deskhero se může připojit k existující schránce Gmailu, Google Workspace nebo Microsoft 365, včetně sdílených schránek Microsoft. Nejprve můžete otestovat vestavěné automatizace nových tiketů, které nastavují směrovací pole na základě explicitních podmínek nebo podmínky vyhodnocené AI. Pokud potřebujete samostatně natrénovaný klasifikátor, pomocí REST API pravidelně načítejte tikety a aktualizujte přijaté štítky.
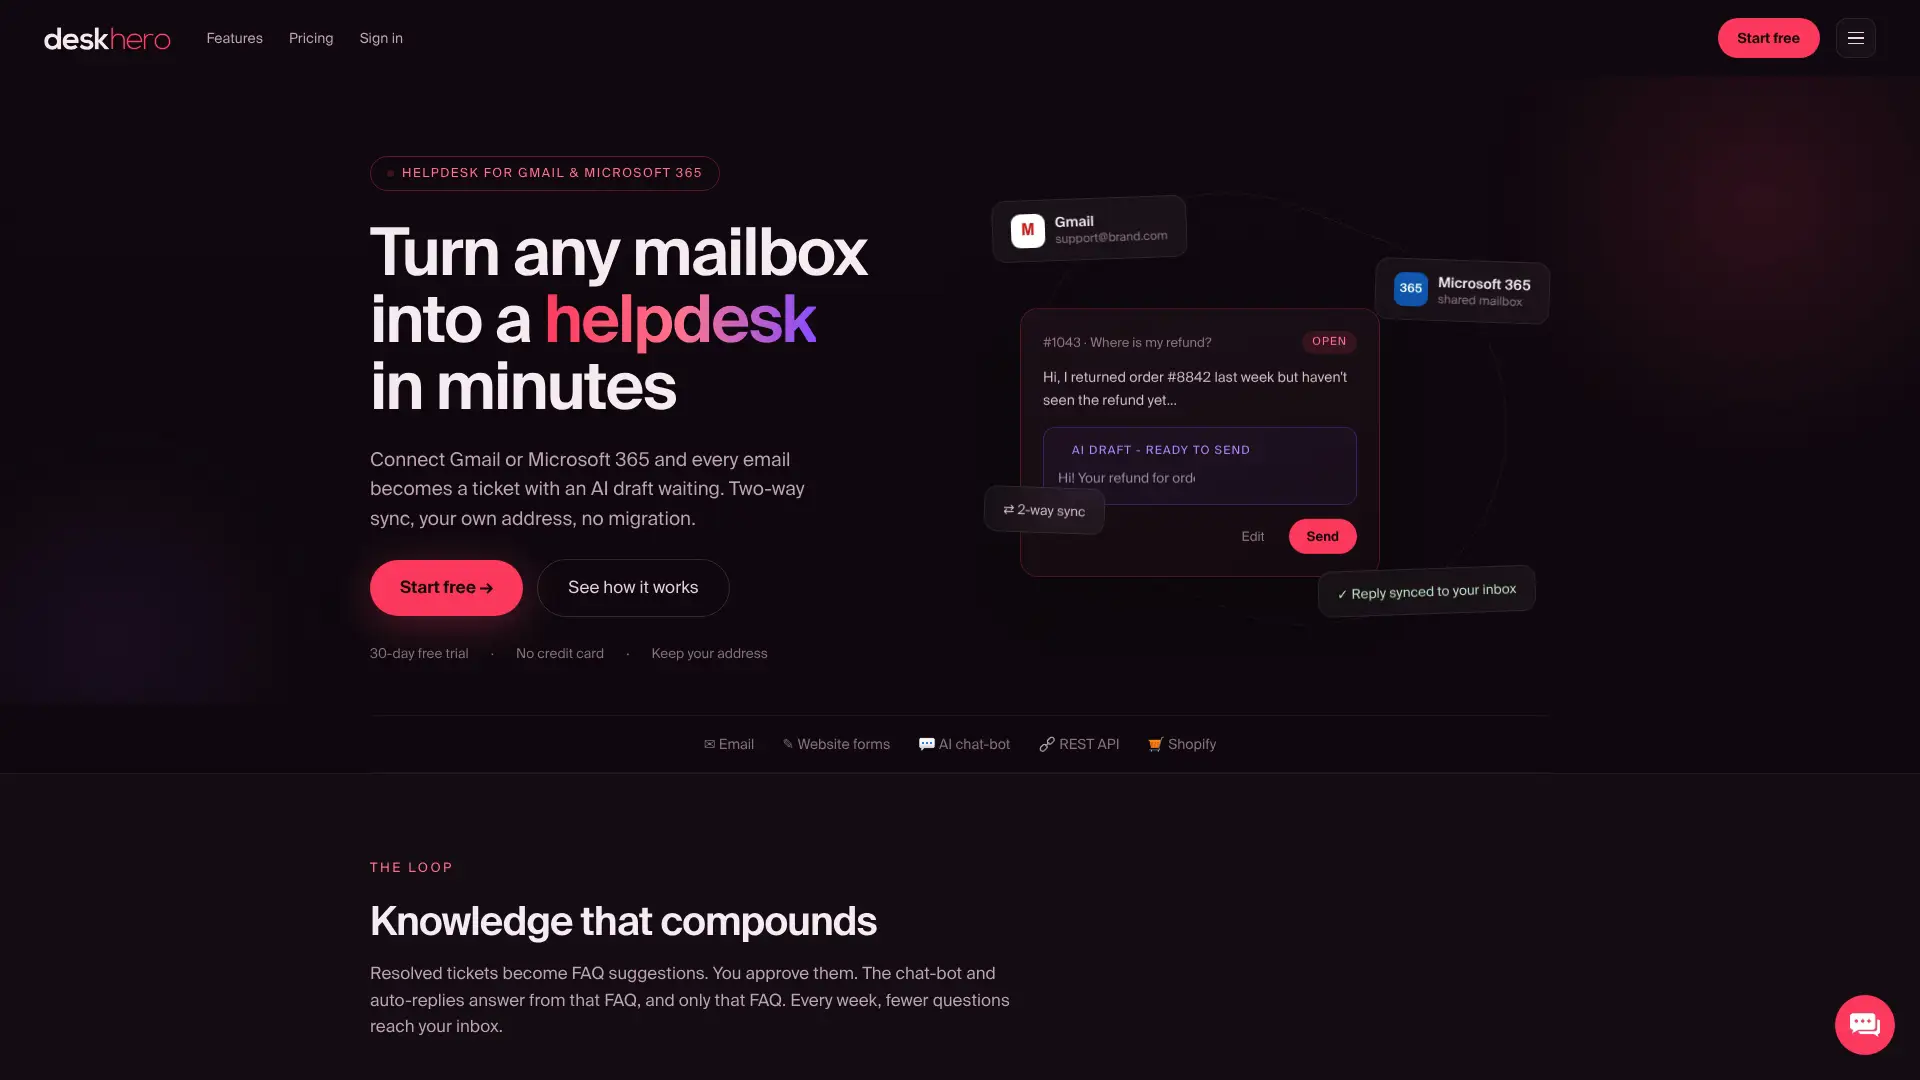
Klasifikaci, směrování a generování odpovědí udržujte jako samostatné ovládací prvky. Navrhované odpovědi v Deskhero využívají znalosti pracovního prostoru a Uživatel je může přijmout, upravit nebo odmítnout. Automatické odpovědi AI a chatbot používají pouze schválené položky veřejných FAQ a chatbot vyžaduje před aktivací nejméně 100 schválených položek FAQ. Deskhero nabízí 30denní bezplatnou zkušební verzi bez nutnosti platební karty.
Zdroje
Následující zdroje poskytují srovnání z výzkumu, funkční referenční implementaci a definice hlavních metrik hodnocení:
- Srovnávací studie algoritmů strojového a hlubokého učení pro klasifikaci tiketů zákaznické podpory
- aiticketclassifier (GitHub)
- Co jsou accuracy, precision, recall a F1 skóre?
Časté dotazy
Co je systém pro správu tiketů s AI?
Systém pro správu tiketů s AI je helpdesk nebo připojená služba, která využívá strojové učení či jazykové modely k úkolům, jako jsou klasifikace, stanovení priority, směrování, tvorba návrhů odpovědí nebo automatické odpovědi. Konkrétní možnosti se liší podle produktu.
Co jsou klasifikační modely v AI?
Klasifikační modely přiřazují novému vstupu jeden nebo více předem definovaných štítků na základě pravidel nebo vzorců naučených z označených příkladů. V prostředí správy tiketů může být štítkem kategorie, priorita, jazyk nebo cílová skupina.
Co je metoda AI ticket?
Neexistuje žádná standardizovaná „metoda AI ticket“. Typický proces načte text tiketu, připraví vstup, předpoví štítek, ověří výsledek podle pravidel a kritérií spolehlivosti a poté tiket aktualizuje nebo zařadí do fronty.
Jak AI přesně klasifikuje tikety podpory?
Přesnost závisí na konzistentních štítcích, reprezentativních příkladech, vhodných vstupních polích a testování na oddělených tiketech. Srovnávací studie z roku 2025 zjistila, že kombinace názvu a popisu zlepšila výsledky ve všech testovaných scénářích.
Dokáže helpdesk, jako je Deskhero, zvládnout klasifikaci tiketů bez týmu datových vědců?
Deskhero může provádět třídění nových tiketů s pomocí AI prostřednictvím automatizačních pravidel s podmínkami AI formulovanými běžným jazykem. Tato pravidla mohou nastavit například skupinu, prioritu, přiřazeného řešitele, stav a štítky. Samostatně natrénovaný statistický klasifikátor vyžaduje externí integraci, která pravidelně dotazuje REST API Deskhero.