AI-klassificering av supportärenden: En praktisk guide
AI-baserad ärendeklassificering läser inkommande supportärenden och förutsäger etiketter som kategori, prioritet eller destination. Det kan minska den repetitiva sorteringen, men osäkra förutsägelser behöver fortfarande granskas av människor. En praktisk pilot använder representativ ärendetext, en tydligt definierad uppsättning etiketter och konfidensgränser som valts utifrån valideringsresultat. Forskning som en jämförande studie från 2025 kan hjälpa dig att välja en baslinje, medan denna introduktion till accuracy, precision, recall och F1 förklarar de viktigaste utvärderingsmåtten.
Innan du avsätter budget för en modell bör du bekräfta grunderna:
- Du har en representativ uppsättning historiska ärenden med användbar text och tillförlitliga etiketter
- Din inledande taxonomi är tillräckligt liten för att granskare ska kunna tillämpa den konsekvent
- Du kan skicka förutsägelser med låg konfidens till en kö för mänsklig granskning
- Någon i ditt team ansvarar för övervakning och korrigeringar efter lanseringen
Viktigaste slutsatserna
AI-baserad ärendeklassificering fungerar bäst när den kombinerar märkta exempel, mätbara acceptanskriterier, konfidensgränser och mänsklig granskning, i stället för full automatisering från dag ett.
| Punkt | Detaljer |
|---|---|
| Börja med en begränsad pilot | Testa en kö eller en liten uppsättning kategorier innan du utökar klassificerarens omfattning. |
| Matcha modellen med uppgiften | Studien från 2025 visade att traditionell maskininlärning matchade eller överträffade de testade djupinlärningsmodellerna i flera scenarier för ärendeklassificering. |
| Använd konfidensgränser | Skicka osäkra resultat till mänsklig granskning i stället för att tvinga fram en etikett. |
| Övervaka efter lanseringen | Följ fel per klass och förändringar i konfidensfördelningen så att du kan upptäcka drift. |
| Håll isär klassificering och svarsgenerering | Äendestyrning och AI-genererade svarsutkast löser olika problem och bör utvärderas separat. |
Innehållsförteckning
- Vad är AI-baserad ärendeklassificering?
- Hur behandlar ett AI-baserat ärendesystem ett ärende?
- Vilket modellupplägg passar din ärendevolym?
- Hur integrerar du en klassificerare i ditt ärendeflöde?
- Vilka mätvärden visar att din klassificerare är redo?
- Hur håller du en klassificerare korrekt efter lanseringen?
- Vad kan gå fel och hur åtgärdar du det?
- Hur ser en fyra veckor lång AI-klassificeringspilot ut?
- Varför passar Deskhero team som testar AI-baserad klassificering?
- Starta en pilot utan att vänta på en migrering
- Källor
- Vanliga frågor
Vad är AI-baserad ärendeklassificering?
AI-baserad ärendeklassificering innebär att fördefinierade etiketter automatiskt tilldelas supportärenden utifrån deras text och, i vissa system, utvalda metadata eller bilagor. Etiketterna kan användas för styrningsregler, prioritetsköer, rapportering eller föreslagna nästa steg. Klassificeraren minskar den manuella triageringen endast för förutsägelser som uppfyller dina acceptanskriterier. Den bör inte i tysthet tvinga osäkra ärenden till en kö.
De sannolika fördelarna är snabbare inledande sortering och mer konsekventa etiketter, men förbättringens omfattning beror på din taxonomi, träningsdata, ditt arbetsflöde och din trafik. Mät resultaten mot din nuvarande process i stället för att förlita dig på en leverantörs marknadsförda träffsäkerhet.
Vanliga användningsområden är att dela upp IT-förfrågningar i kategorierna åtkomst, maskinvara och programvara, sortera e-handelsfrågor i fakturering, leverans och returer samt tilldela ärenden efter språk. Klassificering skiljer sig också från svarsgenerering. En helpdesk kan till exempel skapa ett svarsutkast från sina kunskapskällor även när en separat regel eller modell hanterar styrningen.
Hur behandlar ett AI-baserat ärendesystem ett ärende?
En typisk ärendeklassificerare använder fem steg. Detaljerna varierar beroende på modell och integration, men stegen ger dig användbara kontrollpunkter när något går fel.
Arbetsflödet, steg för steg:
- Inläsning. Systemet tar emot ärendetext och relevanta metadata från helpdesken.
- Förbehandling. Det tar bort irrelevant markup eller signaturer och normaliserar indata. Vissa implementationer extraherar även text från bilagor som stöds.
- Funktionsextraktion. En traditionell modell kan använda TF-IDF-vektorer, medan en neural modell kan använda inbäddningar eller token.
- Modellinferens. Klassificeraren förutsäger en eller flera etiketter och, när det är tillgängligt, ett konfidensvärde.
- Efterbehandling och styrning. Regler godkänner, avvisar eller skickar förutsägelsen till granskning innan ärendet uppdateras.
Flerspråkiga ärenden kan översättas före klassificeringen eller behandlas av en flerspråkig modell. Testa båda metoderna med din egen språkblandning eftersom översättning kan förändra viktiga termer. Projektet aiticketclassifier med öppen källkod visar ett TF-IDF-baserat klassificeringsflöde med kategoriförutsägelser, konfidensvärden, en instrumentpanel, rekommendationer och Slack-aviseringar. Bearbetning i realtid passar arbetsflöden där etiketten måste påverka en aktiv kö. Batchbearbetning är användbar för historisk efterbehandling och utvärdering.
Vilket modellupplägg passar din ärendevolym?
Det finns tre breda nivåer att överväga. Den rätta beror på hur tvetydiga dina etiketter är, mängden och kvaliteten på dina data, kraven på svarstid och driftskostnaden.
Regel- och mönsterbaserade system matchar nyckelord, adresser, domäner eller reguljära uttryck mot åtgärder. De är snabba och enkla att förklara, men en växande uppsättning regler kan bli svår att underhålla. De fungerar bra för snäva fall med höga precisionskrav, till exempel kända faktureringsadresser eller produktkoder.
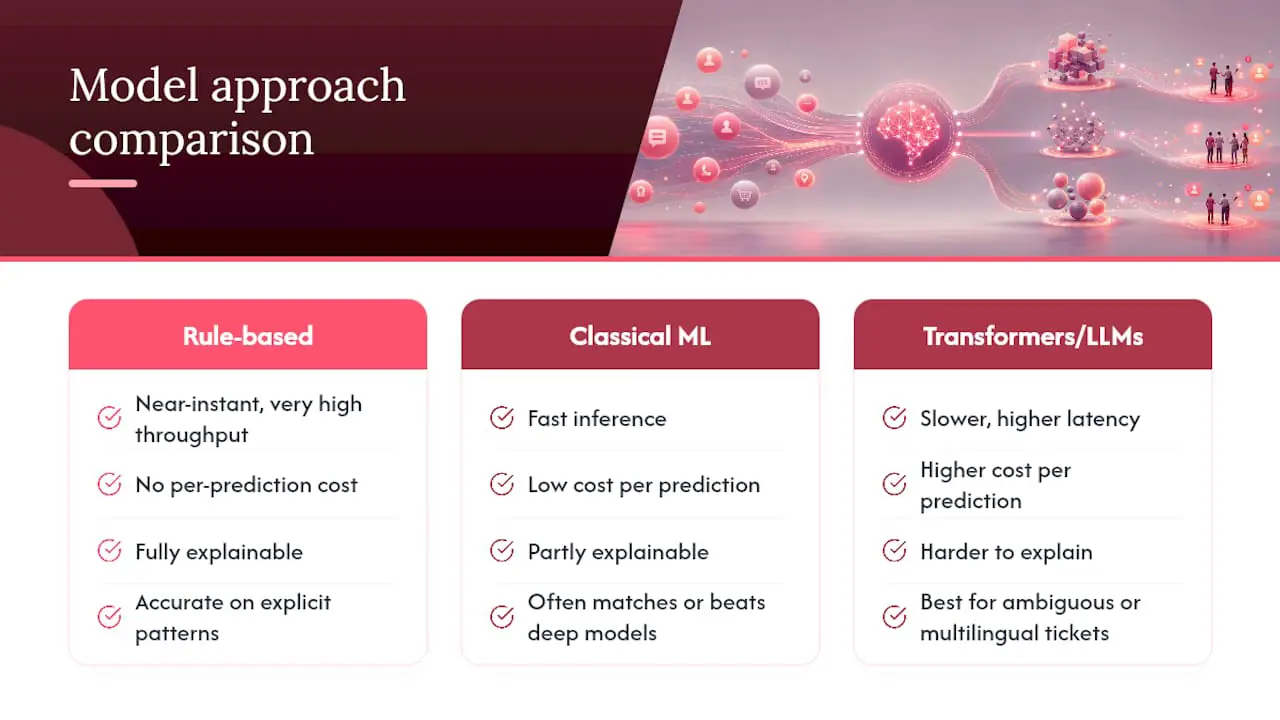
Traditionella metoder inom maskininlärning, som Logistic Regression, SVM och XGBoost, tränas på märkta exempel. Den jämförande studien från 2025 utvärderade åtta algoritmer på offentliga datauppsättningar och företagsdata. Den visade att kombinationen av ärenderubrik och beskrivning förbättrade resultaten i alla testade scenarier, och att traditionella modeller matchade eller överträffade de testade djupinlärningsmodellerna i flera fall.
Transformer- och LLM-metoder kan vara användbara när ärenden är tvetydiga, flerspråkiga eller beroende av ett bredare sammanhang. De kan också medföra högre kostnader, längre svarstider och större komplexitet vid utvärderingen. Jämför dem med en enklare baslinje i stället för att anta att den större modellen presterar bättre.
Proffstips: Börja med det minst komplexa upplägg som uppfyller dina acceptanskriterier. Studien från 2025 rapporterade accuracy och F1 över 0,95 för prioritetsklassificering i de testade scenarierna, medan kategoriklassificering var svårare i företagsdata.
Hur integrerar du en klassificerare i ditt ärendeflöde?
Integrationen lyckas när varje förutsägelse har en tydlig och reversibel åtgärd. Gå igenom dessa steg i ordning:
- Granska dina data. Ta ett stickprov från en representativ period och kontrollera hur konsekvent ärendena märktes.
- Utforma din taxonomi. Börja med kategorier som granskare kan skilja åt på ett tillförlitligt sätt.
- Märk en startdatauppsättning. Använd supportspecialister som förstår kön och registrera oenigheter.
- Bygg en baslinje. Jämför en enkel uppsättning regler eller en traditionell modell med din nuvarande manuella process.
- Testa hela integrationen. Bekräfta hur förutsägelser, fel, nya försök och fältuppdateringar fungerar i en sandlådemiljö.
- Lansera i faser. Börja med en kö eller en liten grupp etiketter med hög konfidens.
En extern klassificerare läser vanligtvis nya ärenden via helpdeskens integreringsmetod och skriver tillbaka den godkända etiketten till fält som grupp, prioritet eller taggar. Kontrollera om helpdesken stöder utgående händelser eller kräver polling. Deskheroes REST API stöder listning och uppdatering av ärenden, men tillhandahåller inte utgående webhooks, så en extern klassificerare måste polla API:et. Information om konfigurering av brevlådor och skapande av ärenden finns i Deskheroes arbetsflöde för e-post till ärende.
Vilka mätvärden visar att din klassificerare är redo?
Fyra mätningar är särskilt användbara: precision (hur många förutsagda etiketter som var korrekta), recall (hur många sanna förekomster som hittades), F1 (det harmoniska medelvärdet av precision och recall) samt konfidenskalibrering (om de förutsagda sannolikheterna motsvarar observerade resultat).
För problem med flera klasser bör du granska både makroberäknad F1, som ger varje klass samma vikt, och mikroberäknad F1, som domineras av klasser med hög volym. Granska även en förväxlingsmatris samt precision och recall per klass. Ett enda samlat värde kan dölja allvarliga fel i sällsynta men viktiga kategorier.
Utvärdera på en undanhållen uppsättning verkliga ärenden som speglar produktionstrafiken. Definiera acceptanskriterier utifrån kostnaden för varje fel. En felaktigt markerad brådskande etikett slösar med kapacitet, medan ett missat brådskande ärende kan leda till att ett SLA bryts.
Proffstips: En konfidensgräns är en beslutsregel, inte en universell procentsats. Välj den utifrån valideringsdata och skicka sedan förutsägelser under gränsen till mänsklig granskning.
Hur håller du en klassificerare korrekt efter lanseringen?
Driftsättningen är inte mållinjen. Följ förutsägelsevolymen per kategori, fel per klass, konfidensfördelningen, volymen i granskningskön och den operativa påverkan av felstyrda ärenden.
- Samla in korrigeringar som märkta återkopplingsdata och granska dem för konsekvens
- Kör nya modellversioner i skuggläge innan de får ändra ärenden
- Rulla ut uppdateringar kö för kö och behåll en möjlighet att återställa
- Behåll mänsklig granskning för förutsägelser under den valda gränsen
Hur ofta modellen ska tränas om bör styras av observerad drift, inte av en godtycklig kalender. En produktlansering, en taxonomiförändring eller ett nytt kundsegment kan motivera tidigare omträning. Deskheroes guide till dashboards för kundsupport erbjuder ett bredare ramverk för att välja supportmått, men klassificeringsspecifika mätningar behöver fortfarande övervakas separat.
Vad kan gå fel och hur åtgärdar du det?
Inkonsekventa etiketter är ett vanligt problem. Om supportspecialister tilldelar olika kategorier till liknande ärenden lär sig modellen denna oenighet. Skriv riktlinjer för märkning, granska omtvistade exempel och mät överensstämmelsen innan du skalar upp. Obalanserade klasser innebär en annan risk eftersom ett samlat värde kan se starkt ut samtidigt som en kategori med låg volym presterar dåligt. Använd mått per klass och samla in fler representativa exempel där det behövs.
Tvetydiga ärenden behöver en uttrycklig reservlösning. Skicka osäkra förutsägelser till en granskningskö, behåll det ursprungliga modellresultatet för analys och låt korrigeringar ingå i nästa utvärderingsuppsättning. För LLM-baserade system ska du validera att resultatet är en av de tillåtna etiketterna innan någon arbetsflödesåtgärd körs.
Integritet förtjänar en egen punkt. Skicka inte ärenden som innehåller personuppgifter till en tredjepartsmodell om inte dina juridiska och säkerhetsmässiga krav är uppfyllda, inklusive ett lämpligt personuppgiftsbiträdesavtal där så krävs.
Proffstips: Minimera fälten som skickas till klassificeraren. Om modellen bara behöver ett ämne och ett meddelande ska du inte inkludera orelaterade kunduppgifter.
Hur ser en fyra veckor lång AI-klassificeringspilot ut?
Ett upplägg på fyra veckor kan fungera som planeringsmall, även om datamängden och granskningstiden bör avgöra den verkliga takten:
- Vecka 0, avgränsning. Välj en kö, definiera taxonomin, välj baslinjemått och dokumentera oacceptabla fel.
- Vecka 1, märkning och baslinje. Märk ett representativt stickprov, lös oenigheter och träna eller konfigurera den enklaste fungerande baslinjen.
- Vecka 2, integration och skuggtestning. Kör förutsägelser på aktiva ärenden utan att ändra deras fält.
- Vecka 3 till 4, begränsad lansering och utvärdering. Aktivera åtgärder endast för validerade fall med hög konfidens och mät sedan modellkvalitet, granskningsbelastning, routningskorrigeringar och supportresultat.
Betrakta inte fyra veckor som en garanti. Förläng skuggtestningen om sällsynta kategorier saknas, kvaliteten på märkningen är inkonsekvent eller integrationen inte kan fallera på ett säkert sätt.
Varför passar Deskhero team som testar AI-baserad klassificering?
Deskhero omvandlar en Gmail-, Google Workspace- eller Microsoft 365-brevlåda till en helpdesk utan att ändra den kundvända e-postadressen. Nya ärenden kan också komma in via inbäddade formulär och AI-chattboten. Det ger en pilot en konsekvent ärendepost samtidigt som användare fortsätter arbeta i en gemensam inkorg.
Deskheroes automatiseringar för nya ärenden kan utvärdera AI-villkor i vanligt språk och ange tilldelad handläggare, grupp, status, prioritet, taggar eller rullgardinsfält. Detta möjliggör praktisk AI-assisterad triage utan att bygga en anpassad modell. För en separat klassificerare kan REST API:et lista och uppdatera ärenden, men integrationen måste polla eftersom Deskhero saknar utgående webhooks. AI-föreslagna svar är en separat funktion som bygger på kunskap i arbetsytan, medan kundvända automatiska AI-svar och chattboten endast svarar utifrån den godkända offentliga FAQ:n. Deskhero stöder även flerspråkiga ärenden.
Implementeringsanteckningar
Håll den första taxonomin snäv, logga varje korrigering och skilj modellutvärdering från arbetsflödesutvärdering. En klassificerare kan ha ett starkt F1-värde och ändå skapa operativa problem om den tilldelar fel grupp eller skriver över ett fält som användare behöver. Börja med skuggförutsägelser och aktivera sedan reversibla åtgärder för de tydligaste fallen.
Starta en pilot utan att vänta på en migrering
Deskhero kan ansluta till en befintlig Gmail-, Google Workspace- eller Microsoft 365-brevlåda, inklusive delade Microsoft-brevlådor. Du kan först testa inbyggda automatiseringar för nya ärenden som anger routningsfält utifrån uttryckliga villkor eller ett AI-utvärderat villkor. Om du behöver en separat tränad klassificerare kan du använda REST API:et för att polla efter ärenden och uppdatera godkända etiketter.
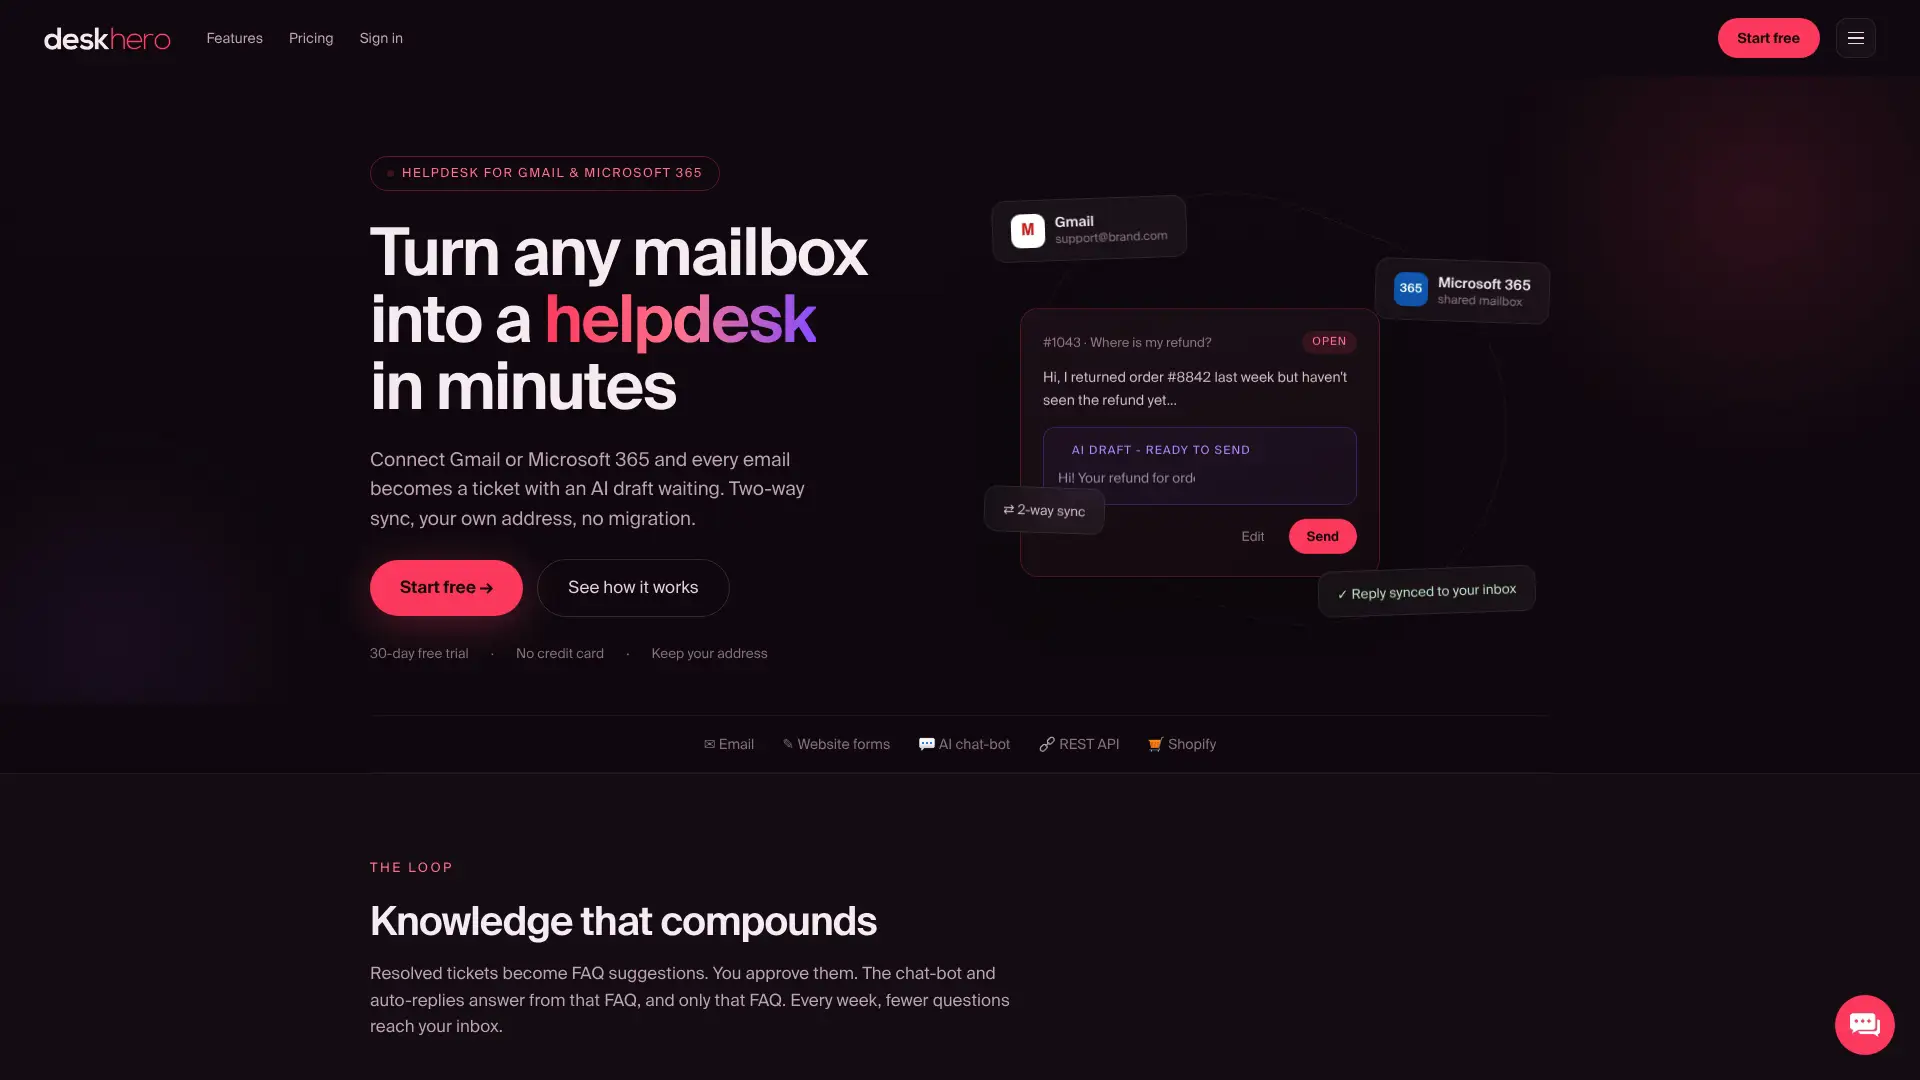
Håll klassificering, styrning och svarsgenerering som separata kontroller. Deskheroes föreslagna svar använder kunskap från arbetsytan och är fortfarande tillgängliga för att en användare ska kunna acceptera, redigera eller avfärda dem. Dess automatiska AI-svar och chattbot använder endast godkända offentliga FAQ-objekt, och chattboten kräver minst 100 godkända FAQ-poster innan den aktiveras. Deskhero erbjuder en kostnadsfri provperiod på 30 dagar utan krav på kreditkort.
Källor
Följande resurser innehåller en forskningsjämförelse, en fungerande referensimplementation och definitioner av de viktigaste utvärderingsmåtten:
- Jämförande studie av algoritmer inom maskininlärning och djupinlärning för klassificering av kundsupportärenden
- aiticketclassifier (GitHub)
- Vad är accuracy, precision, recall och F1 score?
Vanliga frågor
Vad är ett AI-baserat ärendesystem?
Ett AI-baserat ärendesystem är en helpdesk eller ansluten tjänst som använder maskininlärning eller språkmodeller för uppgifter som klassificering, prioritering, styrning, svarsutkast eller automatiska svar. De exakta funktionerna varierar mellan olika produkter.
Vad är klassificeringsmodeller inom AI?
Klassificeringsmodeller tilldelar en eller flera fördefinierade etiketter till nya indata utifrån regler eller mönster som lärts från märkta exempel. Inom ärendehantering kan etiketten vara en kategori, prioritet, ett språk eller en destinationsgrupp.
Vad är AI-ärendemetoden?
Det finns ingen standardiserad ”AI-ärendemetod”. Ett typiskt arbetsflöde läser in ärendetext, förbereder indata, förutsäger en etikett, validerar resultatet mot regler och konfidenskriterier och uppdaterar eller köar sedan ärendet.
Hur klassificerar AI supportärenden korrekt?
Träffsäkerheten beror på konsekventa etiketter, representativa exempel, lämpliga indatafält och testning på undanhållna ärenden. Den jämförande studien från 2025 visade att kombinationen av rubrik och beskrivning förbättrade resultaten i alla de testade scenarierna.
Kan en helpdesk som Deskhero hantera ärendeklassificering utan ett data science-team?
Deskhero kan utföra AI-assisterad triage av nya ärenden genom automatiseringsregler med AI-villkor i vanligt språk. Dessa regler kan ange fält som grupp, prioritet, tilldelad handläggare, status och taggar. En separat tränad statistisk klassificerare kräver en extern integration som pollar Deskheroes REST API.