KI-Ticket-Klassifizierung für Support-Teams: Ein praxisnaher Leitfaden
Die KI-Ticketklassifizierung liest eingehende Support-Tickets und prognostiziert Labels wie Kategorie, Priorität oder Ziel. Sie kann das wiederholte Sortieren reduzieren, aber unsichere Prognosen müssen weiterhin von Menschen geprüft werden. Für einen praxisnahen Pilotversuch benötigen Sie repräsentative Tickettexte, eine klar definierte Menge an Labels und Konfidenzschwellen, die anhand von Validierungsergebnissen festgelegt wurden. Eine Untersuchung wie eine vergleichende Studie aus dem Jahr 2025 kann Ihnen bei der Auswahl einer Baseline helfen, während dieser Leitfaden zu Accuracy, Precision, Recall und F1 die wichtigsten Bewertungsmetriken erklärt.
Bevor Sie Budget für ein Modell freigeben, sollten Sie die Grundlagen bestätigen:
- Sie verfügen über eine repräsentative Menge historischer Tickets mit nutzbarem Text und zuverlässigen Labels
- Ihre anfängliche Taxonomie ist klein genug, damit Prüfer sie konsistent anwenden können
- Sie können Prognosen mit niedriger Konfidenz an eine menschliche Prüfwarteschlange weiterleiten
- Jemand in Ihrem Team ist nach dem Start für Überwachung und Korrekturen verantwortlich
Die wichtigsten Erkenntnisse
Die KI-Ticketklassifizierung funktioniert am besten, wenn sie gelabelte Beispiele, messbare Akzeptanzkriterien, Konfidenzschwellen und menschliche Prüfung kombiniert, statt von Anfang an vollständig automatisiert zu werden.
| Punkt | Details |
|---|---|
| Mit einem begrenzten Pilotversuch beginnen | Testen Sie eine Warteschlange oder eine kleine Gruppe von Kategorien, bevor Sie den Umfang des Klassifizierers erweitern. |
| Modell und Aufgabe aufeinander abstimmen | Die Studie aus dem Jahr 2025 ergab, dass klassische Verfahren des maschinellen Lernens in mehreren getesteten Szenarien der Ticketklassifizierung mit den getesteten Deep-Learning-Modellen gleichzogen oder diese übertrafen. |
| Konfidenzschwellen verwenden | Leiten Sie unsichere Ergebnisse an eine menschliche Prüfung weiter, statt ein Label zu erzwingen. |
| Nach dem Start überwachen | Verfolgen Sie Fehler nach Klasse und Veränderungen in der Konfidenzverteilung, damit Sie Drift erkennen können. |
| Klassifizierung und Antwortgenerierung trennen | Ticketweiterleitung und KI-generierte Antwortentwürfe lösen unterschiedliche Probleme und sollten unabhängig voneinander bewertet werden. |
Inhaltsverzeichnis
- Was ist KI-Ticketklassifizierung?
- Wie verarbeitet ein KI-Ticketingsystem ein Ticket?
- Welcher Modellansatz passt zu Ihrem Ticketvolumen?
- Wie integrieren Sie einen Klassifizierer in Ihren Ticketing-Workflow?
- Welche Metriken zeigen, dass Ihr Klassifizierer bereit ist?
- Wie halten Sie einen Klassifizierer nach dem Start präzise?
- Was kann schiefgehen und wie beheben Sie es?
- Wie sieht ein vierwöchiger Pilotversuch zur KI-Klassifizierung aus?
- Warum Deskhero zu Teams passt, die KI-Klassifizierung pilotieren
- Starten Sie einen Pilotversuch, ohne auf eine Migration zu warten
- Quellen
- FAQ
Was ist KI-Ticketklassifizierung?
KI-Ticketklassifizierung bezeichnet die automatische Zuordnung vordefinierter Labels zu Support-Tickets auf Grundlage ihres Textes und in manchen Systemen ausgewählter Metadaten oder Anhänge. Diese Labels können Routing-Regeln, Prioritätswarteschlangen, Berichte oder vorgeschlagene nächste Schritte speisen. Der Klassifizierer reduziert die manuelle Triage nur bei Prognosen, die Ihre Akzeptanzkriterien erfüllen. Unsichere Tickets sollte er nicht unbemerkt einer Warteschlange zuweisen.
Zu den erwartbaren Vorteilen gehören eine schnellere erste Sortierung und konsistentere Labels. Wie groß die Verbesserung ausfällt, hängt jedoch von Ihrer Taxonomie, Ihren Trainingsdaten, Ihrem Workflow und Ihrem Ticketaufkommen ab. Messen Sie die Ergebnisse im Vergleich zu Ihrem aktuellen Prozess, statt sich auf die beworbene Genauigkeit eines Anbieters zu verlassen.
Zu den üblichen Einsatzbereichen gehören die Aufteilung von IT-Anfragen in Kategorien wie Zugriff, Hardware und Software, die Sortierung von E-Commerce-Fragen in Abrechnung, Versand und Rücksendungen sowie die Zuweisung von Tickets nach Sprache. Klassifizierung unterscheidet sich außerdem von der Antwortgenerierung. Ein Helpdesk kann beispielsweise eine Antwort aus seinen Wissensquellen entwerfen, während eine separate Regel oder ein separates Modell die Weiterleitung übernimmt.
Wie verarbeitet ein KI-Ticketingsystem ein Ticket?
Ein typischer Ticketklassifizierer verwendet fünf Phasen. Die Details unterscheiden sich je nach Modell und Integration, aber die Phasen bieten hilfreiche Kontrollpunkte, wenn etwas schiefläuft.
Die Pipeline, Phase für Phase:
- Aufnahme. Das System empfängt Tickettext und relevante Metadaten vom Helpdesk.
- Vorverarbeitung. Es entfernt irrelevantes Markup oder Signaturen und vereinheitlicht die Eingabe. Einige Implementierungen extrahieren außerdem Text aus unterstützten Anhängen.
- Merkmalsextraktion. Ein klassisches Modell kann TF-IDF-Vektoren verwenden, während ein neuronales Modell Embeddings oder Tokens nutzt.
- Modellinferenz. Der Klassifizierer prognostiziert ein oder mehrere Labels und, sofern verfügbar, einen Konfidenzwert.
- Nachbearbeitung und Weiterleitung. Regeln akzeptieren, verwerfen oder prüfen die Prognose, bevor das Ticket aktualisiert wird.
Mehrsprachige Tickets können vor der Klassifizierung übersetzt oder von einem mehrsprachigen Modell verarbeitet werden. Testen Sie beide Ansätze mit Ihrer eigenen Sprachverteilung, da eine Übersetzung wichtige Begriffe verändern kann. Das Open-Source-Projekt aiticketclassifier zeigt eine TF-IDF-Klassifizierungspipeline mit Kategorieprognosen, Konfidenzwerten, Dashboard, Empfehlungen und Slack-Benachrichtigungen. Die Verarbeitung in Echtzeit eignet sich für Workflows, bei denen das Label eine aktive Warteschlange beeinflussen muss. Die Stapelverarbeitung ist nützlich für Nachverarbeitungen und Bewertungen.
Welcher Modellansatz passt zu Ihrem Ticketvolumen?
Es gibt drei übergeordnete Stufen, die Sie berücksichtigen sollten. Die richtige Wahl hängt von der Mehrdeutigkeit Ihrer Labels, der Menge und Qualität Ihrer Daten, den Latenzanforderungen und den Betriebskosten ab.
Regel- und mustergestützte Systeme ordnen Schlüsselwörter, Adressen, Domains oder reguläre Ausdrücke bestimmten Aktionen zu. Sie sind schnell und einfach zu erklären, aber eine wachsende Menge an Regeln kann schwierig zu pflegen sein. Sie eignen sich gut für eng begrenzte Fälle mit hohen Präzisionsanforderungen, etwa bekannte Rechnungsadressen oder Produktcodes.
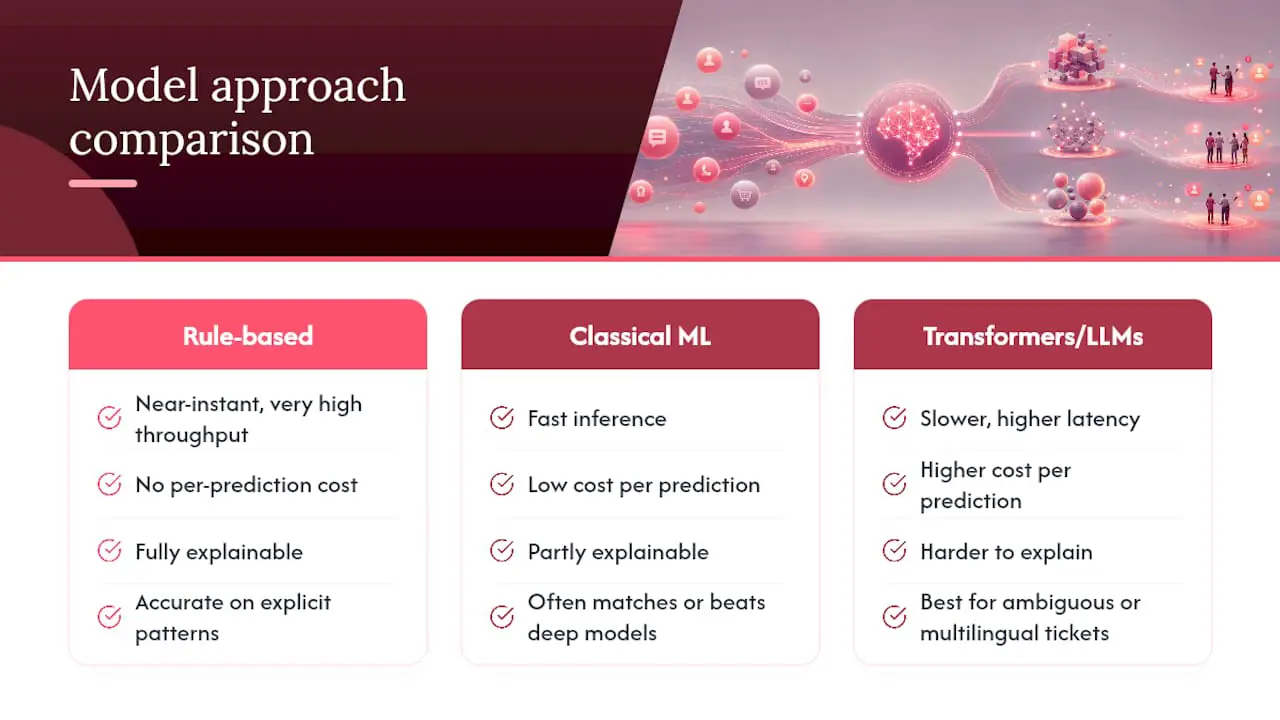
Klassische Verfahren des maschinellen Lernens wie Logistic Regression, SVM und XGBoost werden anhand gelabelter Beispiele trainiert. Die vergleichende Studie aus dem Jahr 2025 bewertete acht Algorithmen anhand öffentlicher und unternehmensinterner Datensätze. Sie ergab, dass die Kombination aus Tickettitel und Beschreibung die Leistung in allen getesteten Szenarien verbesserte und klassische Modelle in mehreren Fällen mit den getesteten Deep-Learning-Modellen gleichzogen oder diese übertrafen.
Transformer- und LLM-Ansätze können hilfreich sein, wenn Tickets mehrdeutig, mehrsprachig oder vom weiteren Kontext abhängig sind. Sie können jedoch auch Kosten, Latenz und die Komplexität der Bewertung erhöhen. Vergleichen Sie sie mit einer einfacheren Baseline, statt anzunehmen, dass das größere Modell besser abschneidet.
Profi-Tipp: Beginnen Sie mit dem am wenigsten komplexen Ansatz, der Ihre Akzeptanzkriterien erfüllt. Die Studie aus dem Jahr 2025 berichtete in den getesteten Szenarien über eine Accuracy und einen F1-Wert von über 0,95 bei der Prioritätsklassifizierung, während die Klassifizierung von Kategorien bei Unternehmensdaten schwieriger war.
Wie integrieren Sie einen Klassifizierer in Ihren Ticketing-Workflow?
Eine Integration gelingt, wenn jede Prognose eine klare und reversible Aktion auslöst. Gehen Sie diese Schritte der Reihe nach durch:
- Daten prüfen. Wählen Sie einen repräsentativen Zeitraum aus und prüfen Sie, wie konsistent die Tickets gelabelt wurden.
- Taxonomie entwerfen. Beginnen Sie mit Kategorien, die Prüfer zuverlässig unterscheiden können.
- Seed-Datensatz labeln. Arbeiten Sie mit Support-Spezialisten, die die Warteschlange kennen, und dokumentieren Sie Unstimmigkeiten.
- Eine Baseline erstellen. Vergleichen Sie ein einfaches Regelwerk oder ein klassisches Modell mit Ihrem aktuellen manuellen Prozess.
- Die vollständige Integration testen. Bestätigen Sie in einer Sandbox, wie sich Prognosen, Fehler, Wiederholungen und Feldaktualisierungen verhalten.
- Schrittweise ausrollen. Beginnen Sie mit einer Warteschlange oder einer kleinen Gruppe von Labels mit hoher Konfidenz.
Ein externer Klassifizierer liest neue Tickets typischerweise über die vom Helpdesk unterstützte Integrationsmethode und schreibt das akzeptierte Label zurück in Felder wie Gruppe, Priorität oder Tags. Prüfen Sie, ob der Helpdesk ausgehende Ereignisse unterstützt oder ob Abfragen erforderlich sind. Die REST-API von Deskhero unterstützt das Auflisten und Aktualisieren von Tickets, bietet jedoch keine ausgehenden Webhooks. Ein externer Klassifizierer muss daher die API regelmäßig abfragen. Informationen zur Einrichtung von Postfächern und zur Ticketerstellung finden Sie im E-Mail-zu-Ticket-Workflow von Deskhero.
Welche Metriken zeigen, dass Ihr Klassifizierer bereit ist?
Vier Messgrößen sind besonders nützlich: Precision (wie viele der prognostizierten Labels korrekt waren), Recall (wie viele tatsächliche Fälle gefunden wurden), F1 (das harmonische Mittel aus Precision und Recall) und Konfidenzkalibrierung (ob die prognostizierten Wahrscheinlichkeiten den beobachteten Ergebnissen entsprechen).
Bei Problemen mit mehreren Klassen sollten Sie sowohl den makro-gemittelten F1-Wert betrachten, bei dem jede Klasse gleich gewichtet wird, als auch den mikro-gemittelten F1-Wert, der von Klassen mit hohem Volumen dominiert wird. Prüfen Sie außerdem eine Konfusionsmatrix sowie Precision und Recall pro Klasse. Ein einzelner aggregierter Wert kann schwerwiegende Fehler in seltenen, aber wichtigen Kategorien verbergen.
Bewerten Sie das Modell anhand einer zurückgehaltenen Menge echter Tickets, die den Produktionsverkehr widerspiegelt. Legen Sie Akzeptanzkriterien anhand der Kosten jedes Fehlers fest. Ein fälschlich als dringend markiertes Ticket verschwendet Kapazitäten, während ein übersehenes dringendes Ticket eine SLA-Verletzung verursachen kann.
Profi-Tipp: Eine Konfidenzschwelle ist eine Entscheidungsregel und kein universeller Prozentsatz. Legen Sie sie anhand von Validierungsdaten fest und leiten Sie Prognosen darunter an eine menschliche Prüfung weiter.
Wie halten Sie einen Klassifizierer nach dem Start präzise?
Die Einführung ist nicht das Ziel. Verfolgen Sie das Prognosevolumen nach Kategorie, Fehler nach Klasse, die Konfidenzverteilung, das Volumen der Prüfwarteschlange und die operativen Auswirkungen falsch weitergeleiteter Tickets.
- Sammeln Sie Korrekturen als gelabeltes Feedback und prüfen Sie sie auf Konsistenz
- Führen Sie neue Modellversionen zunächst im Shadow-Modus aus, bevor sie Tickets ändern dürfen
- Rollen Sie Aktualisierungen Warteschlange für Warteschlange aus und behalten Sie eine Möglichkeit zum Zurücksetzen bei
- Behalten Sie die menschliche Prüfung für Prognosen unterhalb der ausgewählten Schwelle bei
Die Häufigkeit des Retrainings sollte sich am beobachteten Drift orientieren, nicht an einem beliebigen Kalender. Eine Produkteinführung, eine Änderung der Taxonomie oder ein neues Kundensegment kann ein früheres Retraining rechtfertigen. Der Leitfaden zu Customer-Support-Dashboards von Deskhero bietet einen umfassenderen Rahmen für die Auswahl von Supportmetriken, aber klassifiziererspezifische Messwerte müssen weiterhin separat überwacht werden.
Was kann schiefgehen und wie beheben Sie es?
Inkonsistente Labels sind eine häufige Fehlerquelle. Wenn Support-Spezialisten ähnliche Tickets unterschiedlichen Kategorien zuordnen, lernt das Modell diese Uneinigkeit. Erstellen Sie Richtlinien für die Labelvergabe, prüfen Sie strittige Beispiele und messen Sie die Übereinstimmung, bevor Sie skalieren. Ein unausgewogenes Klassenverhältnis birgt ein weiteres Risiko, da ein aggregierter Wert stark aussehen kann, während eine Klasse mit geringem Volumen schlecht abschneidet. Verwenden Sie klassenbezogene Metriken und sammeln Sie bei Bedarf repräsentativere Beispiele.
Mehrdeutige Tickets benötigen einen ausdrücklich definierten Fallback. Senden Sie unsichere Prognosen an eine Prüfwarteschlange, bewahren Sie die ursprüngliche Modellausgabe zur Analyse auf und lassen Sie Korrekturen in den nächsten Evaluierungsdatensatz einfließen. Bei LLM-basierten Systemen sollten Sie vor der Ausführung einer Workflow-Aktion validieren, dass die Ausgabe einem der zulässigen Labels entspricht.
Datenschutz verdient einen eigenen Punkt. Senden Sie Tickets mit personenbezogenen Daten nur dann an ein Drittanbieter-Modell, wenn Ihre rechtlichen und sicherheitsbezogenen Anforderungen erfüllt sind, einschließlich einer geeigneten Vereinbarung zur Auftragsverarbeitung, sofern erforderlich.
Profi-Tipp: Übermitteln Sie dem Klassifizierer so wenige Felder wie möglich. Wenn das Modell nur Betreff und Nachricht benötigt, sollten Sie keine nicht verwandten Kundendaten einbeziehen.
Wie sieht ein vierwöchiger Pilotversuch zur KI-Klassifizierung aus?
Ein Zeitplan über vier Wochen kann als Vorlage für die Planung dienen, auch wenn die Datenmenge und der Prüfaufwand das tatsächliche Tempo bestimmen sollten:
- Woche 0, Festlegung des Umfangs. Wählen Sie eine Warteschlange aus, definieren Sie die Taxonomie, legen Sie Baseline-Metriken fest und dokumentieren Sie unzulässige Fehler.
- Woche 1, Labeling und Baseline. Labeln Sie eine repräsentative Stichprobe, klären Sie Unstimmigkeiten und trainieren oder konfigurieren Sie die einfachste praktikable Baseline.
- Woche 2, Integration und Shadow-Tests. Führen Sie Prognosen für Live-Tickets aus, ohne deren Felder zu ändern.
- Wochen 3 bis 4, begrenzter Rollout und Bewertung. Aktivieren Sie Aktionen nur für validierte Fälle mit hoher Konfidenz und messen Sie anschließend Modellqualität, Prüfaufwand, Routing-Korrekturen und Supportergebnisse.
Betrachten Sie vier Wochen nicht als Garantie. Verlängern Sie die Shadow-Tests, wenn seltene Kategorien fehlen, die Labelqualität inkonsistent ist oder die Integration nicht sicher fehlschlagen kann.
Warum Deskhero zu Teams passt, die KI-Klassifizierung pilotieren
Deskhero verwandelt ein Gmail-, Google-Workspace- oder Microsoft-365-Postfach in einen Helpdesk, ohne die kundenorientierte E-Mail-Adresse zu ändern. Neue Tickets können auch über eingebettete Formulare und den KI-Chatbot eingehen. So erhält ein Pilotversuch einen einheitlichen Ticketeintrag, während Benutzer weiterhin in einem gemeinsamen Posteingang arbeiten.
Die Automatisierungen für neue Tickets von Deskhero können KI-Bedingungen in Alltagssprache auswerten und den Bearbeiter, die Gruppe, den Status, die Priorität, Tags oder Dropdown-Felder festlegen. Das ermöglicht eine praktische KI-gestützte Triage, ohne ein eigenes Modell entwickeln zu müssen. Bei einem separaten Klassifizierer kann die REST-API Tickets auflisten und aktualisieren, die Integration muss jedoch Abfragen durchführen, da Deskhero keine ausgehenden Webhooks besitzt. KI-generierte Antwortvorschläge sind eine separate Funktion, die auf dem Wissen des Arbeitsbereichs basiert, während kundenorientierte automatische KI-Antworten und der Chatbot ausschließlich aus der freigegebenen öffentlichen FAQ antworten. Deskhero unterstützt außerdem mehrsprachige Tickets.
Implementierungshinweise
Halten Sie die erste Taxonomie eng gefasst, protokollieren Sie jede Korrektur und unterscheiden Sie zwischen Modellbewertung und Workflow-Bewertung. Ein Klassifizierer kann einen starken F1-Wert erreichen und dennoch operative Probleme verursachen, wenn er die falsche Gruppe zuweist oder ein Feld überschreibt, das Benutzer benötigen. Beginnen Sie mit Shadow-Prognosen und aktivieren Sie anschließend reversible Aktionen für die eindeutigsten Fälle.
Starten Sie einen Pilotversuch, ohne auf eine Migration zu warten
Deskhero kann eine vorhandene Gmail-, Google-Workspace- oder Microsoft-365-Mailbox verbinden, einschließlich gemeinsam genutzter Microsoft-Postfächer. Sie können zunächst die integrierten Automatisierungen für neue Tickets testen, die Routing-Felder anhand expliziter Bedingungen oder einer von der KI bewerteten Bedingung festlegen. Wenn Sie einen separat trainierten Klassifizierer benötigen, können Sie die REST-API verwenden, um Tickets abzufragen und akzeptierte Labels zu aktualisieren.
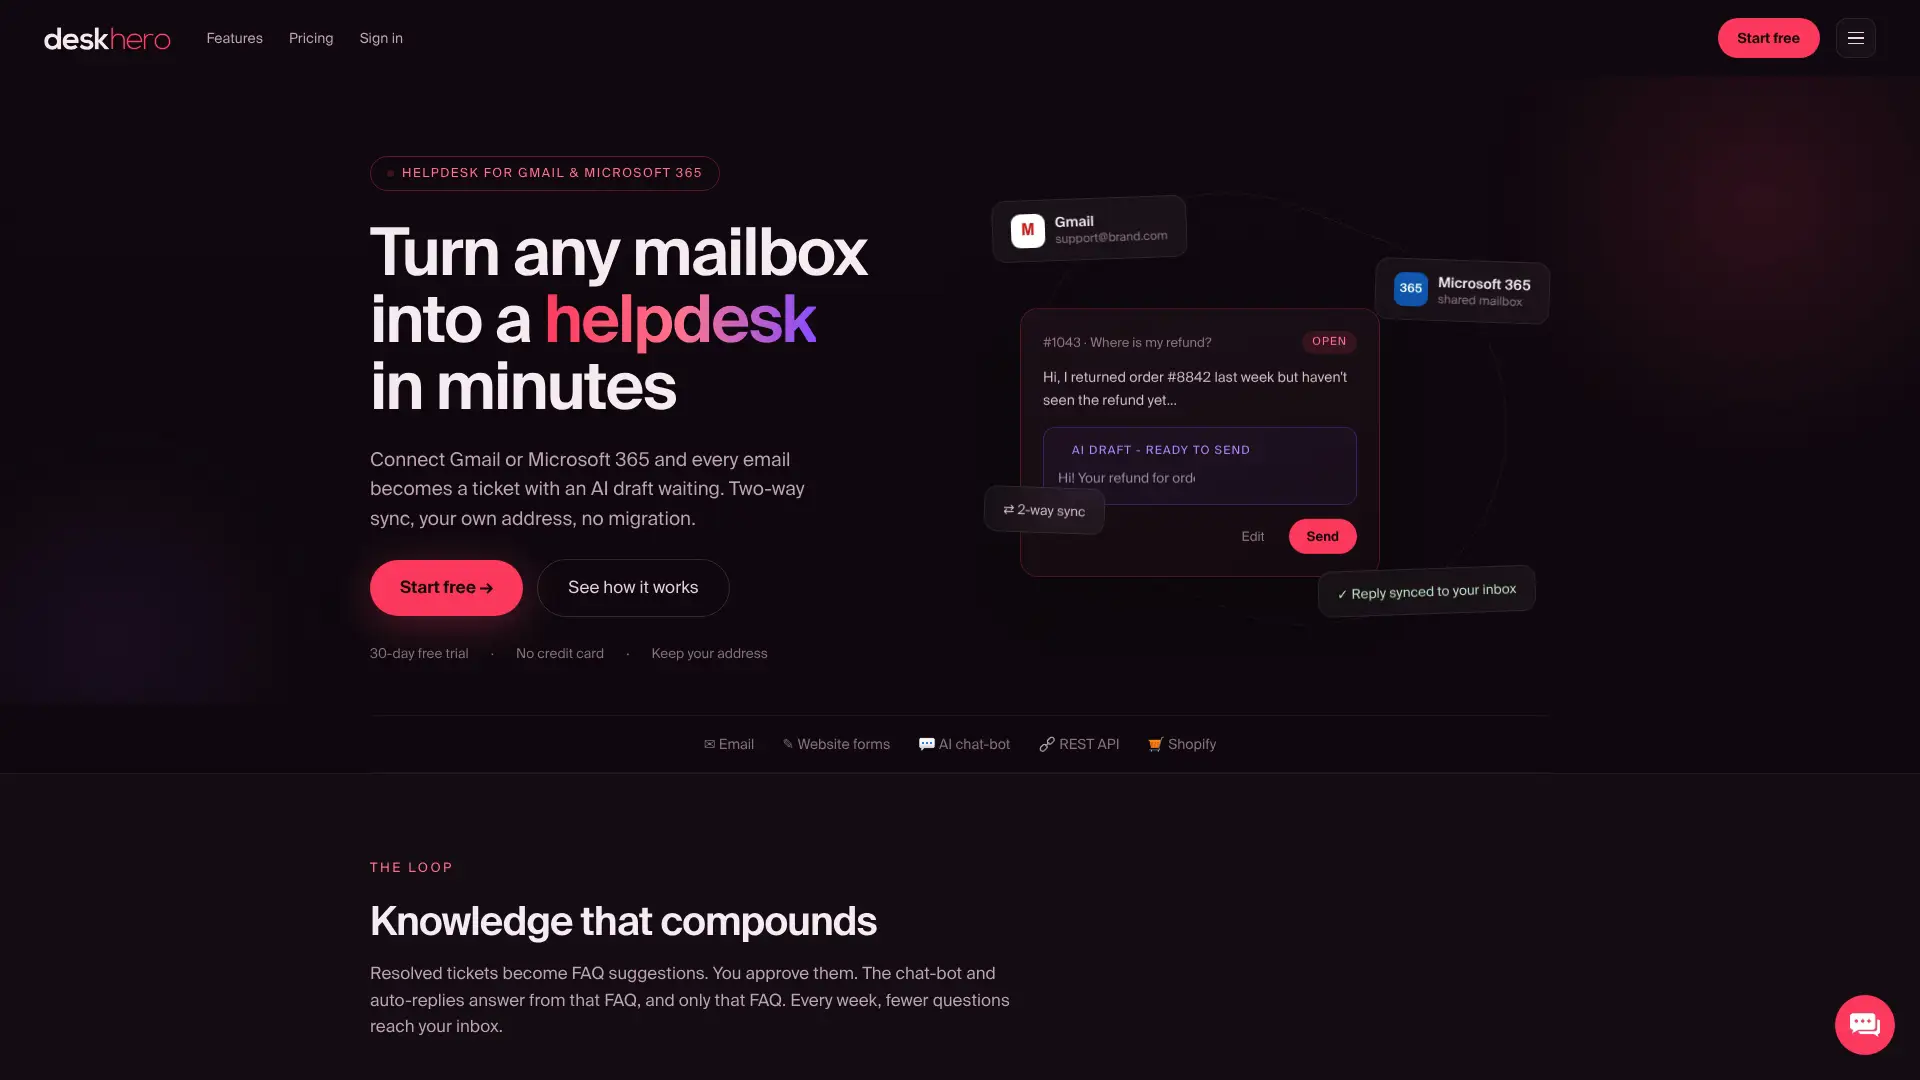
Halten Sie Klassifizierung, Weiterleitung und Antwortgenerierung als separate Steuerungen. Die vorgeschlagenen Antworten von Deskhero verwenden Wissen aus dem Arbeitsbereich und bleiben zur Annahme, Bearbeitung oder Ablehnung durch einen Benutzer verfügbar. Die automatischen KI-Antworten und der Chatbot von Deskhero verwenden ausschließlich freigegebene öffentliche FAQ-Einträge, und der Chatbot benötigt vor der Aktivierung mindestens 100 freigegebene FAQ-Einträge. Deskhero bietet eine 30-tägige kostenlose Testversion ohne erforderliche Kreditkarte.
Quellen
Die folgenden Ressourcen bieten einen Forschungsvergleich, eine funktionierende Referenzimplementierung und Definitionen für die wichtigsten Bewertungsmetriken:
- Vergleichende Studie zu Algorithmen des maschinellen Lernens und Deep Learnings für die Klassifizierung von Kundensupport-Tickets
- aiticketclassifier (GitHub)
- Was sind Accuracy, Precision, Recall und der F1-Wert?
FAQ
Was ist ein KI-Ticketingsystem?
Ein KI-Ticketingsystem ist ein Helpdesk oder verbundener Dienst, der maschinelles Lernen oder Sprachmodelle für Aufgaben wie Klassifizierung, Priorisierung, Weiterleitung, Antwortentwürfe oder automatisierte Antworten verwendet. Die genauen Funktionen unterscheiden sich je nach Produkt.
Was sind Klassifizierungsmodelle in der KI?
Klassifizierungsmodelle weisen neuen Eingaben auf Grundlage von Regeln oder Mustern, die aus gelabelten Beispielen gelernt wurden, ein oder mehrere vordefinierte Labels zu. Beim Ticketing kann das Label eine Kategorie, Priorität, Sprache oder Zielgruppe sein.
Was ist die KI-Ticket-Methode?
Es gibt keine standardisierte „KI-Ticket-Methode“. Eine typische Pipeline nimmt Tickettext auf, bereitet die Eingabe vor, prognostiziert ein Label, validiert das Ergebnis anhand von Regeln und Konfidenzkriterien und aktualisiert oder sortiert anschließend das Ticket ein.
Wie klassifiziert KI Support-Tickets präzise?
Die Genauigkeit hängt von konsistenten Labels, repräsentativen Beispielen, geeigneten Eingabefeldern und Tests mit zurückgehaltenen Tickets ab. Die vergleichende Studie aus dem Jahr 2025 ergab, dass die Kombination aus Titel und Beschreibung die Ergebnisse in allen getesteten Szenarien verbesserte.
Kann ein Helpdesk wie Deskhero Ticketklassifizierung ohne ein Data-Science-Team übernehmen?
Deskhero kann mithilfe von Automatisierungsregeln mit KI-Bedingungen in Alltagssprache eine KI-gestützte Triage neuer Tickets durchführen. Diese Regeln können Felder wie Gruppe, Priorität, Bearbeiter, Status und Tags festlegen. Ein separat trainierter statistischer Klassifizierer benötigt eine externe Integration, die die REST-API von Deskhero abfragt.