Clasificación de tickets con IA para equipos de soporte: guía práctica
La clasificación de tickets mediante IA lee los tickets de soporte entrantes y predice etiquetas como categoría, prioridad o destino. Puede reducir la clasificación repetitiva, pero las predicciones inciertas aún requieren revisión humana. Un piloto práctico utiliza texto representativo de los tickets, un conjunto de etiquetas claramente definido y umbrales de confianza elegidos a partir de los resultados de validación. Investigaciones como un estudio comparativo de 2025 pueden ayudarte a elegir una línea base, mientras que este manual sobre exactitud, precisión, exhaustividad y F1 explica las métricas de evaluación fundamentales.
Antes de asignar presupuesto a un modelo, confirma lo básico:
- Dispones de un conjunto representativo de tickets históricos con texto utilizable y etiquetas confiables
- Tu taxonomía inicial es lo suficientemente pequeña como para que los revisores la apliquen de forma coherente
- Puedes enviar las predicciones de baja confianza a una cola de revisión humana
- Alguien de tu equipo se encarga de la supervisión y las correcciones después del lanzamiento
Conclusiones clave
La clasificación de tickets mediante IA funciona mejor cuando combina ejemplos etiquetados, criterios de aceptación medibles, umbrales de confianza y revisión humana, en lugar de apostar por la automatización total desde el primer día.
| Punto | Detalles |
|---|---|
| Comienza con un piloto limitado | Prueba una cola o un conjunto pequeño de categorías antes de ampliar el alcance del clasificador. |
| Adapta el modelo a la tarea | El estudio de 2025 descubrió que el aprendizaje automático clásico igualó o superó a los modelos de aprendizaje profundo probados en varios escenarios de clasificación de tickets. |
| Usa umbrales de confianza | Envía los resultados inciertos a revisión humana en lugar de imponer una etiqueta. |
| Supervisa después del lanzamiento | Registra los errores por clase y los cambios en la distribución de confianza para poder detectar cambios en los datos. |
| Separa la clasificación de la generación de respuestas | El enrutamiento de tickets y las respuestas redactadas por IA resuelven problemas diferentes y deben evaluarse de forma independiente. |
Índice
- ¿Qué es la clasificación de tickets mediante IA?
- ¿Cómo procesa un ticket un sistema de gestión de tickets con IA?
- ¿Qué enfoque de modelo se adapta al volumen de tus tickets?
- ¿Cómo integras un clasificador en tu flujo de trabajo de gestión de tickets?
- ¿Qué métricas demuestran que tu clasificador está listo?
- ¿Cómo mantienes la precisión de un clasificador después del lanzamiento?
- ¿Qué puede salir mal y cómo lo solucionas?
- ¿Cómo es un piloto de clasificación mediante IA de 4 semanas?
- Por qué Deskhero es adecuado para los equipos que prueban la clasificación mediante IA
- Inicia un piloto sin esperar a una migración
- Fuentes
- Preguntas frecuentes
¿Qué es la clasificación de tickets mediante IA?
La clasificación de tickets mediante IA consiste en asignar automáticamente etiquetas predefinidas a los tickets de soporte basándose en su texto y, en algunos sistemas, en determinados metadatos o archivos adjuntos. Esas etiquetas pueden alimentar reglas de enrutamiento, colas de prioridad, informes o sugerencias de próximos pasos. El clasificador reduce el triaje manual únicamente en el caso de las predicciones que cumplen tus criterios de aceptación. No debe enviar silenciosamente los tickets inciertos a una cola.
Los beneficios más probables son una clasificación inicial más rápida y etiquetas más coherentes, pero el nivel de mejora depende de tu taxonomía, datos de entrenamiento, flujo de trabajo y tráfico. Mide los resultados frente a tu proceso actual en lugar de confiar en la exactitud destacada por un proveedor.
Entre los usos habituales se incluyen separar las solicitudes de TI en categorías de acceso, hardware y software; clasificar las consultas de comercio electrónico en facturación, envíos y devoluciones; y asignar tickets por idioma. La clasificación también es diferente de la generación de respuestas. Por ejemplo, un servicio de asistencia puede redactar una respuesta a partir de sus fuentes de conocimiento mientras una regla o modelo independiente se encarga del enrutamiento.
¿Cómo procesa un ticket un sistema de gestión de tickets con IA?
Un clasificador de tickets típico utiliza cinco etapas. Los detalles varían según el modelo y la integración, pero estas etapas ofrecen puntos de comprobación útiles cuando algo sale mal.
El proceso, etapa por etapa:
- Ingesta. El sistema recibe del servicio de asistencia el texto del ticket y los metadatos relevantes.
- Preprocesamiento. Elimina el marcado o las firmas irrelevantes y normaliza la entrada. Algunas implementaciones también extraen texto de los archivos adjuntos compatibles.
- Extracción de características. Un modelo clásico puede utilizar vectores TF-IDF, mientras que un modelo neuronal puede utilizar embeddings o tokens.
- Inferencia del modelo. El clasificador predice una o más etiquetas y, cuando está disponible, una puntuación de confianza.
- Posprocesamiento y enrutamiento. Las reglas aceptan, rechazan o envían a revisión la predicción antes de actualizar el ticket.
Los tickets multilingües pueden traducirse antes de la clasificación o procesarse mediante un modelo multilingüe. Prueba ambos enfoques con tu propia combinación de idiomas, ya que la traducción puede alterar términos importantes. El proyecto aiticketclassifier de código abierto muestra un proceso de clasificación TF-IDF con predicciones de categorías, puntuaciones de confianza, un panel, recomendaciones y alertas de Slack. El procesamiento en tiempo real se adapta a los flujos de trabajo en los que la etiqueta debe afectar a una cola activa. El procesamiento por lotes es útil para completar datos anteriores y realizar evaluaciones.
¿Qué enfoque de modelo se adapta al volumen de tus tickets?
Hay tres niveles generales que debes considerar. La opción adecuada depende de la ambigüedad de tus etiquetas, la cantidad y calidad de tus datos, los requisitos de latencia y el coste operativo.
Los sistemas basados en reglas y patrones relacionan palabras clave, direcciones, dominios o expresiones regulares con acciones. Son rápidos y fáciles de explicar, pero un conjunto de reglas cada vez mayor puede resultar difícil de mantener. Funcionan bien en casos limitados y de alta precisión, como direcciones de facturación o códigos de producto conocidos.
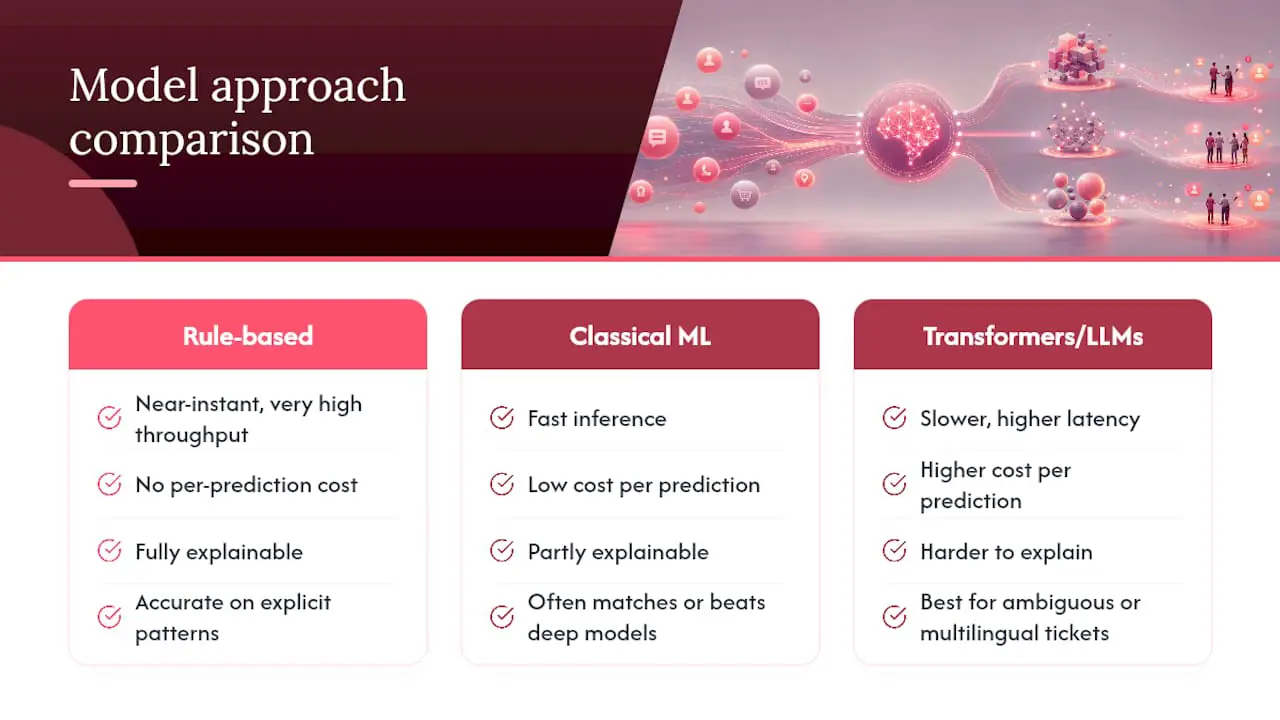
Los métodos de aprendizaje automático clásico, como Logistic Regression, SVM y XGBoost, se entrenan con ejemplos etiquetados. El estudio comparativo de 2025 evaluó ocho algoritmos en conjuntos de datos públicos y empresariales. Descubrió que combinar el título y la descripción del ticket mejoraba el rendimiento en todos los escenarios probados, y que los modelos clásicos igualaban o superaban a los modelos de aprendizaje profundo probados en varios casos.
Los enfoques basados en Transformers y LLM pueden ser útiles cuando los tickets son ambiguos, multilingües o dependen de un contexto más amplio. También pueden añadir costes, latencia y complejidad de evaluación. Compáralos con una línea base más sencilla en lugar de asumir que el modelo más grande tendrá un mejor rendimiento.
Consejo profesional: Comienza con el enfoque menos complejo que cumpla tus criterios de aceptación. El estudio de 2025 informó de una exactitud y una puntuación F1 superiores a 0,95 para la clasificación de prioridades en sus escenarios probados, mientras que la clasificación por categorías resultó más difícil en los datos empresariales.
¿Cómo integras un clasificador en tu flujo de trabajo de gestión de tickets?
La integración funciona cuando cada predicción tiene una acción clara y reversible. Sigue estos pasos en orden:
- Audita tus datos. Selecciona un periodo representativo y comprueba con qué coherencia se etiquetaron los tickets.
- Diseña tu taxonomía. Comienza con categorías que los revisores puedan distinguir de forma confiable.
- Etiqueta un conjunto de datos inicial. Trabaja con especialistas de soporte que conozcan la cola y registra las discrepancias.
- Crea una línea base. Compara un conjunto de reglas sencillo o un modelo clásico con tu proceso manual actual.
- Prueba la integración completa. Confirma en un entorno de pruebas cómo se comportan las predicciones, los errores, los reintentos y las actualizaciones de campos.
- Implementa por fases. Comienza con una cola o con un grupo pequeño de etiquetas de alta confianza.
Normalmente, un clasificador externo lee los tickets nuevos mediante el método de integración compatible con el servicio de asistencia y escribe la etiqueta aceptada en campos como grupo, prioridad o etiquetas. Comprueba si el servicio de asistencia admite eventos salientes o requiere consultas periódicas. La API REST de Deskhero permite listar y actualizar tickets, pero no ofrece webhooks salientes, por lo que un clasificador externo debe consultar la API. Para configurar el buzón y crear tickets, consulta el flujo de trabajo de correo electrónico a ticket de Deskhero.
¿Qué métricas demuestran que tu clasificador está listo?
Cuatro mediciones son especialmente útiles: precisión (cuántas de las etiquetas predichas eran correctas), exhaustividad (cuántas instancias reales se encontraron), F1 (la media armónica de precisión y exhaustividad) y calibración de confianza (si las probabilidades predichas coinciden con los resultados observados).
En los problemas multiclase, examina tanto la F1 macro, que asigna el mismo peso a cada clase, como la F1 micro, que está dominada por las clases de mayor volumen. Inspecciona también una matriz de confusión y la precisión y exhaustividad de cada clase. Una única puntuación agregada puede ocultar errores graves en categorías poco frecuentes pero importantes.
Evalúa el modelo con un conjunto reservado de tickets reales que refleje el tráfico de producción. Define los criterios de aceptación a partir del coste de cada error. Una etiqueta de urgencia falsa desperdicia capacidad, mientras que no detectar un ticket urgente puede provocar el incumplimiento de un SLA.
Consejo profesional: Un umbral de confianza es una regla de decisión, no un porcentaje universal. Elígelo a partir de los datos de validación y envía las predicciones que estén por debajo a revisión humana.
¿Cómo mantienes la precisión de un clasificador después del lanzamiento?
La implementación no es la meta final. Registra el volumen de predicciones por categoría, los errores por clase, la distribución de confianza, el volumen de la cola de revisión y el impacto operativo de los tickets mal dirigidos.
- Recopila las correcciones como comentarios etiquetados y revísalas para comprobar su coherencia
- Ejecuta las nuevas versiones del modelo en modo paralelo antes de que puedan modificar tickets
- Implementa las actualizaciones cola por cola y conserva una vía de reversión
- Mantén la revisión humana para las predicciones que estén por debajo del umbral seleccionado
La frecuencia del reentrenamiento debe seguir los cambios observados en los datos, no un calendario arbitrario. El lanzamiento de un producto, un cambio en la taxonomía o un nuevo segmento de clientes pueden justificar un reentrenamiento más temprano. La guía de paneles de atención al cliente de Deskhero ofrece un marco más amplio para seleccionar métricas de soporte, pero las mediciones específicas del clasificador también necesitan su propia supervisión.
¿Qué puede salir mal y cómo lo solucionas?
Las etiquetas incoherentes son un modo de fallo habitual. Si los especialistas de soporte asignan categorías diferentes a tickets similares, el modelo aprende ese desacuerdo. Redacta directrices de etiquetado, revisa los ejemplos controvertidos y mide el nivel de acuerdo antes de ampliar la escala. El desequilibrio entre clases crea otro riesgo, ya que una puntuación agregada puede parecer sólida mientras una categoría de bajo volumen obtiene un rendimiento deficiente. Utiliza métricas por clase y recopila más ejemplos representativos cuando sea necesario.
Los tickets ambiguos necesitan una alternativa definida explícitamente. Envía las predicciones inciertas a una cola de revisión, conserva el resultado original del modelo para analizarlo y permite que las correcciones alimenten el siguiente conjunto de evaluación. En los sistemas basados en LLM, valida que el resultado sea una de las etiquetas permitidas antes de ejecutar cualquier acción del flujo de trabajo.
La privacidad merece su propio apartado. No envíes tickets que contengan datos personales a un modelo de terceros a menos que cumplas tus requisitos legales y de seguridad, incluido un acuerdo adecuado de tratamiento de datos cuando sea necesario.
Consejo profesional: Minimiza los campos que envías al clasificador. Si el modelo solo necesita un asunto y un mensaje, no incluyas datos de clientes que no estén relacionados.
¿Cómo es un piloto de clasificación mediante IA de 4 semanas?
Un calendario de cuatro semanas puede servir como plantilla de planificación, aunque la cantidad de datos y el tiempo de revisión deben determinar el ritmo real:
- Semana 0, definición del alcance. Selecciona una cola, define la taxonomía, elige las métricas de referencia y documenta los errores inaceptables.
- Semana 1, etiquetado y línea base. Etiqueta una muestra representativa, resuelve las discrepancias y entrena o configura la línea base viable más sencilla.
- Semana 2, integración y pruebas en paralelo. Ejecuta predicciones sobre tickets activos sin modificar sus campos.
- Semanas 3 y 4, implementación y evaluación limitadas. Activa acciones únicamente para casos validados de alta confianza y, después, mide la calidad del modelo, la carga de revisión, las correcciones de enrutamiento y los resultados del soporte.
No consideres las cuatro semanas como una garantía. Amplía las pruebas en paralelo si faltan categorías poco frecuentes, la calidad del etiquetado es incoherente o la integración no puede fallar de forma segura.
Por qué Deskhero es adecuado para los equipos que prueban la clasificación mediante IA
Deskhero convierte un buzón de Gmail, Google Workspace o Microsoft 365 en un servicio de asistencia sin cambiar la dirección de correo electrónico visible para los clientes. Los tickets nuevos también pueden llegar a través de formularios integrados y del chatbot de IA. Esto proporciona al piloto un registro de tickets coherente mientras los Usuarios siguen trabajando en una bandeja de entrada compartida.
Sistema de gestión de tickets con IA
Las automatizaciones de nuevos tickets de Deskhero pueden evaluar condiciones de IA expresadas en lenguaje sencillo y establecer el responsable, grupo, estado, prioridad, etiquetas o campos desplegables. Esto permite realizar un triaje práctico asistido por IA sin crear un modelo personalizado. Para un clasificador independiente, la API REST puede listar y actualizar tickets, pero la integración debe consultar periódicamente la API porque Deskhero no dispone de webhooks salientes. Las respuestas sugeridas por IA son una función independiente basada en el conocimiento del espacio de trabajo, mientras que las respuestas automáticas de IA visibles para los clientes y el chatbot solo responden a partir de las preguntas frecuentes públicas aprobadas. Deskhero también admite tickets multilingües.
Notas de implementación
Mantén limitada la primera taxonomía, registra cada corrección y diferencia la evaluación del modelo de la evaluación del flujo de trabajo. Un clasificador puede tener una puntuación F1 sólida y aun así crear problemas operativos si asigna el grupo equivocado o sobrescribe un campo que los Usuarios necesitan. Comienza con predicciones en paralelo y, después, activa acciones reversibles para los casos más claros.
Inicia un piloto sin esperar a una migración
Deskhero puede conectarse a un buzón existente de Gmail, Google Workspace o Microsoft 365, incluidos los buzones compartidos de Microsoft. Primero puedes probar las automatizaciones integradas de nuevos tickets, que establecen campos de enrutamiento a partir de condiciones explícitas o de una condición evaluada por IA. Si necesitas un clasificador entrenado por separado, utiliza la API REST para consultar los tickets y actualizar las etiquetas aceptadas.
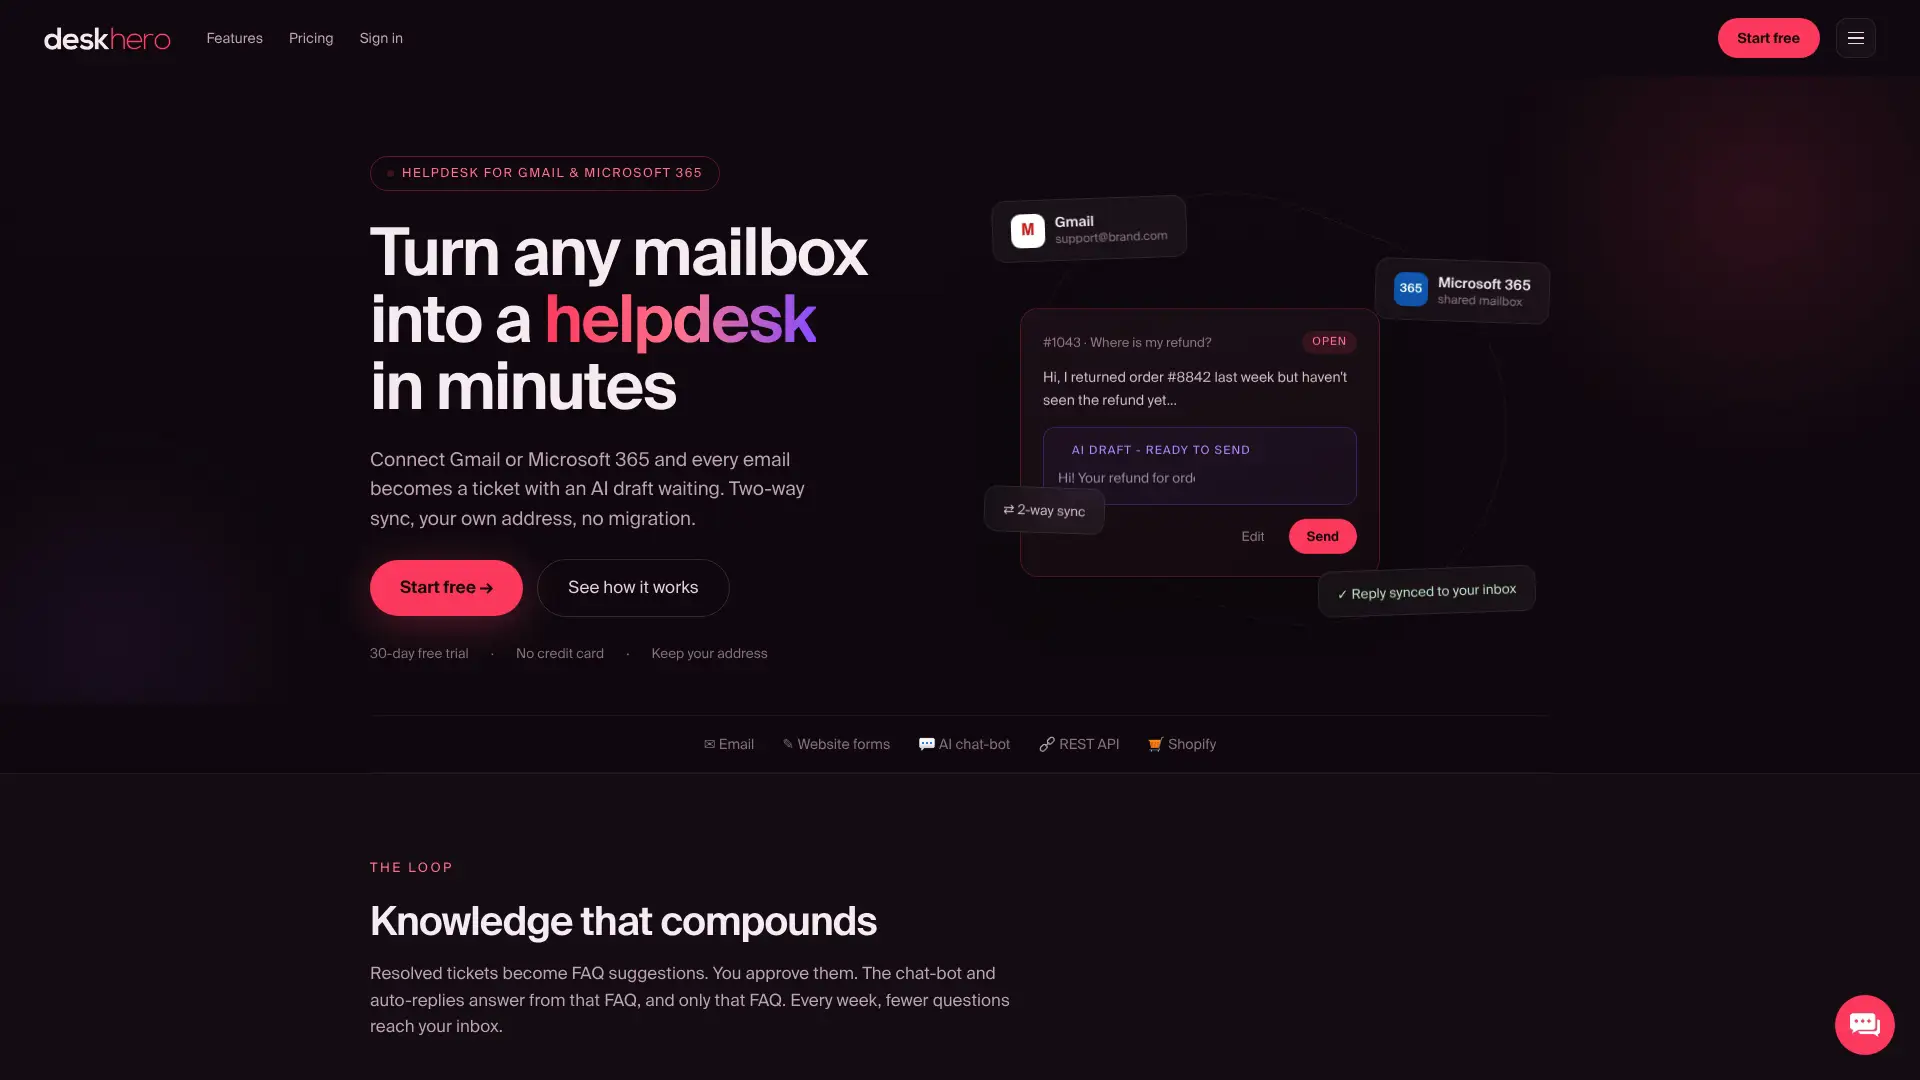
Mantén la clasificación, el enrutamiento y la generación de respuestas como controles independientes. Las respuestas sugeridas de Deskhero utilizan el conocimiento del espacio de trabajo y siguen disponibles para que un Usuario las acepte, edite o descarte. Sus respuestas automáticas de IA y su chatbot utilizan únicamente elementos aprobados de las preguntas frecuentes públicas, y el chatbot requiere al menos 100 entradas de preguntas frecuentes aprobadas antes de activarse. Deskhero ofrece una prueba gratuita de 30 días sin necesidad de tarjeta de crédito.
Fuentes
Los siguientes recursos ofrecen una comparación de investigaciones, una implementación de referencia funcional y definiciones de las principales métricas de evaluación:
- Estudio comparativo de algoritmos de aprendizaje automático y aprendizaje profundo para la clasificación de tickets de atención al cliente
- aiticketclassifier (GitHub)
- ¿Qué son la exactitud, la precisión, la exhaustividad y la puntuación F1?
Preguntas frecuentes
¿Qué es un sistema de gestión de tickets con IA?
Un sistema de gestión de tickets con IA es un servicio de asistencia o servicio conectado que utiliza aprendizaje automático o modelos de lenguaje para tareas como clasificación, priorización, enrutamiento, redacción de respuestas o respuestas automatizadas. Las capacidades exactas varían según el producto.
¿Qué son los modelos de clasificación en IA?
Los modelos de clasificación asignan una o más etiquetas predefinidas a una entrada nueva basándose en reglas o patrones aprendidos a partir de ejemplos etiquetados. En la gestión de tickets, la etiqueta puede ser una categoría, prioridad, idioma o grupo de destino.
¿Qué es el método de tickets mediante IA?
No existe un «método de tickets mediante IA» estandarizado. Un proceso típico incorpora el texto del ticket, prepara la entrada, predice una etiqueta, valida el resultado según reglas y criterios de confianza y, después, actualiza o pone el ticket en una cola.
¿Cómo clasifica la IA los tickets de soporte con precisión?
La precisión depende de etiquetas coherentes, ejemplos representativos, campos de entrada adecuados y pruebas con tickets reservados. El estudio comparativo de 2025 descubrió que combinar el título y la descripción mejoraba los resultados en todos los escenarios que probó.
¿Puede un servicio de asistencia como Deskhero gestionar la clasificación de tickets sin un equipo de ciencia de datos?
Deskhero puede realizar un triaje asistido por IA de nuevos tickets mediante reglas de automatización con condiciones de IA expresadas en lenguaje sencillo. Estas reglas pueden establecer campos como grupo, prioridad, responsable, estado y etiquetas. Un clasificador estadístico entrenado por separado requiere una integración externa que consulte la API REST de Deskhero.