Класифікація заявок за допомогою ШІ для команд підтримки: практичний посібник
Класифікація заявок за допомогою ШІ читає вхідні заявки до служби підтримки та прогнозує такі мітки, як категорія, пріоритет або призначення. Вона може зменшити обсяг повторюваного сортування, але невпевнені прогнози все одно потребують перевірки людиною. Практичний пілотний проєкт використовує репрезентативний текст заявок, чітко визначений набір міток і пороги впевненості, обрані на основі результатів валідації. Дослідження, як-от порівняльне дослідження 2025 року, може допомогти вибрати базову модель, а цей вступ до точності, повноти, запам’ятовуваності та F1-оцінки пояснює основні метрики оцінювання.
Перш ніж виділяти бюджет на модель, переконайтеся, що виконано базові умови:
- У вас є репрезентативний набір історичних заявок із придатним для використання текстом і надійними мітками
- Початкова таксономія достатньо мала, щоб рецензенти могли застосовувати її узгоджено
- Ви можете надсилати прогнози з низькою впевненістю до черги на перевірку людиною
- Хтось у вашій команді відповідає за моніторинг і виправлення після запуску
Основні висновки
Класифікація заявок за допомогою ШІ працює найкраще, коли поєднує марковані приклади, вимірювані критерії прийнятності, пороги впевненості та перевірку людиною, а не передбачає повну автоматизацію від самого початку.
| Пункт | Деталі |
|---|---|
| Почніть з обмеженого пілотного проєкту | Перевірте одну чергу або невеликий набір категорій, перш ніж розширювати сферу застосування класифікатора. |
| Відповідність моделі завданню | Дослідження 2025 року показало, що класичне машинне навчання в кількох сценаріях класифікації заявок відповідало протестованим моделям глибокого навчання або перевершувало їх. |
| Використовуйте пороги впевненості | Передавайте невпевнені результати на перевірку людині, не змушуючи систему призначати мітку. |
| Відстежуйте показники після запуску | Відстежуйте помилки за класами та зміни в розподілі впевненості, щоб вчасно виявляти дрейф. |
| Відокремлюйте класифікацію від генерації відповідей | Маршрутизація заявок і відповіді, створені ШІ, вирішують різні завдання, тому їх слід оцінювати незалежно. |
Зміст
- Що таке класифікація заявок за допомогою ШІ?
- Як система обробки заявок зі ШІ обробляє заявку?
- Який підхід до моделі відповідає вашому обсягу заявок?
- Як інтегрувати класифікатор у робочий процес обробки заявок?
- Які метрики доводять готовність вашого класифікатора?
- Як підтримувати точність класифікатора після запуску?
- Що може піти не так і як це виправити?
- Як виглядає чотиритижневий пілотний проєкт із класифікації за допомогою ШІ?
- Чому Deskhero підходить командам, які тестують класифікацію за допомогою ШІ
- Почніть пілотний проєкт, не очікуючи на міграцію
- Джерела
- FAQ
Що таке класифікація заявок за допомогою ШІ?
Класифікація заявок за допомогою ШІ — це автоматичне призначення заздалегідь визначених міток заявкам до служби підтримки на основі їхнього тексту, а в деяких системах — також вибраних метаданих або вкладень. Ці мітки можуть використовуватися для правил маршрутизації, черг за пріоритетом, звітності або запропонованих наступних кроків. Класифікатор зменшує обсяг ручного сортування лише для прогнозів, які відповідають вашим критеріям прийнятності. Він не повинен непомітно примусово спрямовувати невпевнені заявки до певної черги.
Імовірні переваги включають швидше початкове сортування та більш узгоджені мітки, але масштаб покращення залежить від вашої таксономії, навчальних даних, робочого процесу та потоку заявок. Вимірюйте результати порівняно з поточним процесом, а не покладайтеся на гучні показники точності постачальника.
Серед поширених випадків використання — розподіл ІТ-запитів за категоріями доступу, обладнання та програмного забезпечення; сортування запитань в електронній торгівлі за категоріями оплати, доставки та повернення; а також призначення заявок за мовою. Класифікація також відрізняється від генерації відповідей. Наприклад, служба підтримки може створювати чернетку відповіді на основі своїх джерел знань, тоді як окреме правило або модель відповідає за маршрутизацію.
Як система обробки заявок зі ШІ обробляє заявку?
Типовий класифікатор заявок використовує п’ять етапів. Деталі залежать від моделі та інтеграції, але ці етапи дають корисні контрольні точки, коли щось працює неправильно.
Конвеєр поетапно:
- Отримання даних. Система отримує текст заявки та відповідні метадані з helpdesk-системи.
- Попередня обробка. Вона видаляє нерелевантну розмітку або підписи та нормалізує вхідні дані. Деякі реалізації також витягують текст із підтримуваних вкладень.
- Виділення ознак. Класична модель може використовувати TF-IDF-вектори, тоді як нейронна модель може використовувати ембеддинги або токени.
- Інференс моделі. Класифікатор прогнозує одну або кілька міток і, якщо це доступно, показник упевненості.
- Постобробка та маршрутизація. Правила приймають, відхиляють або передають прогноз на перевірку, перш ніж оновити заявку.
Багатомовні заявки можна перекладати перед класифікацією або обробляти багатомовною моделлю. Перевірте обидва підходи на власному мовному наборі, оскільки переклад може змінити важливі терміни. Проєкт із відкритим кодом aiticketclassifier демонструє конвеєр класифікації TF-IDF із прогнозами категорій, показниками впевненості, інформаційною панеллю, рекомендаціями та сповіщеннями Slack. Обробка в реальному часі підходить для робочих процесів, у яких мітка має впливати на активну чергу. Пакетна обробка корисна для ретроспективного заповнення даних та оцінювання.
Який підхід до моделі відповідає вашому обсягу заявок?
Існує три основні рівні, які варто розглянути. Правильний вибір залежить від неоднозначності ваших міток, кількості та якості даних, вимог до затримки й операційних витрат.
Системи на основі правил і шаблонів зіставляють ключові слова, адреси, домени або регулярні вирази з певними діями. Вони швидкі та зрозумілі, але набір правил, що постійно зростає, може стати складним у підтримці. Вони добре працюють для вузьких випадків із високою точністю, як-от відомі платіжні адреси або коди продуктів.
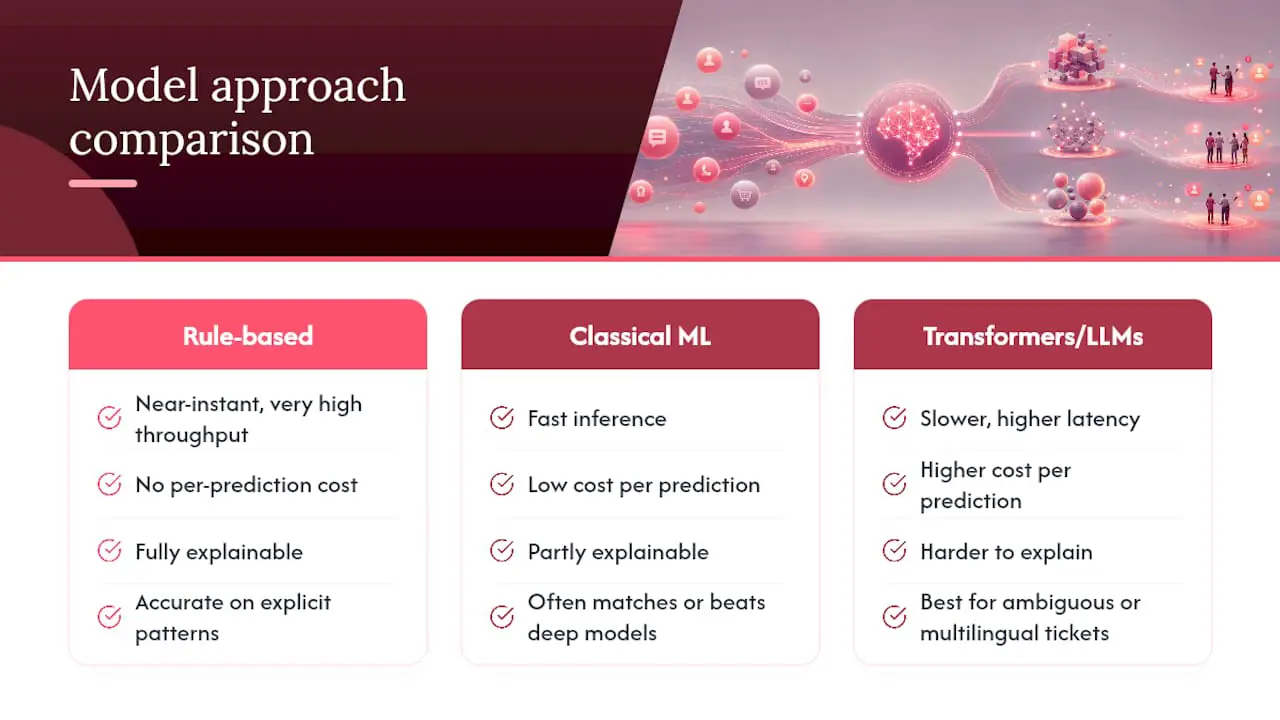
Методи класичного машинного навчання, як-от Logistic Regression, SVM і XGBoost, навчаються на маркованих прикладах. Порівняльне дослідження 2025 року оцінило вісім алгоритмів на загальнодоступних і корпоративних наборах даних. Воно показало, що поєднання заголовка заявки та опису покращило результати в усіх протестованих сценаріях, а класичні моделі в кількох випадках відповідали протестованим моделям глибокого навчання або перевершували їх.
Підходи на основі трансформерів і LLM можуть бути корисними, коли заявки неоднозначні, багатомовні або залежать від ширшого контексту. Водночас вони можуть збільшувати витрати, затримку та складність оцінювання. Порівнюйте їх із простішою базовою моделлю, а не припускайте, що більша модель працюватиме краще.
Порада: Почніть із найменш складного підходу, який відповідає вашим критеріям прийнятності. У дослідженні 2025 року в протестованих сценаріях для класифікації пріоритетів було зафіксовано точність і F1 вище за 0,95, тоді як класифікація категорій на корпоративних даних виявилася складнішою.
Як інтегрувати класифікатор у робочий процес обробки заявок?
Інтеграція буде успішною, якщо для кожного прогнозу передбачено чітку дію, яку можна скасувати. Виконайте ці кроки по порядку:
- Перевірте свої дані. Виберіть репрезентативний період і перевірте, наскільки узгоджено маркувалися заявки.
- Розробіть таксономію. Почніть із категорій, які рецензенти можуть надійно розрізняти.
- Створіть початковий набір даних. Залучіть спеціалістів служби підтримки, які добре розуміють чергу, і фіксуйте розбіжності.
- Створіть базову модель. Порівняйте простий набір правил або класичну модель із поточним ручним процесом.
- Перевірте повну інтеграцію. У тестовому середовищі переконайтеся, як обробляються прогнози, помилки, повторні спроби та оновлення полів.
- Запускайте поетапно. Почніть з однієї черги або невеликої групи міток із високою впевненістю.
Зовнішній класифікатор зазвичай читає нові заявки через підтримуваний helpdesk-системою метод інтеграції та записує прийняту мітку назад у такі поля, як група, пріоритет або теги. Перевірте, чи підтримує helpdesk вихідні події, чи потребує опитування. REST API Deskhero підтримує отримання списку заявок та їх оновлення, але не надає вихідних вебхуків, тому зовнішній класифікатор повинен опитувати API. Інформацію про налаштування поштової скриньки та створення заявок дивіться в робочому процесі перетворення електронних листів на заявки Deskhero.
Які метрики доводять готовність вашого класифікатора?
Особливо корисними є чотири показники: точність (скільки спрогнозованих міток були правильними), повнота (скільки справжніх екземплярів було знайдено), F1 (гармонійне середнє точності та повноти) і калібрування впевненості (чи відповідають прогнозовані ймовірності фактично спостережуваним результатам).
Для багатокласових завдань аналізуйте як макроусереднену F1, яка надає кожному класу однакову вагу, так і мікроусереднену F1, на яку найбільше впливають класи з великим обсягом даних. Також перевіряйте матрицю помилок, точність і повноту для кожного класу. Один сукупний показник може приховувати серйозні помилки в рідкісних, але важливих категоріях.
Оцінюйте модель на відкладеному наборі реальних заявок, який відображає виробничий трафік. Визначайте критерії прийнятності на основі вартості кожної помилки. Хибна мітка «терміново» марнує ресурси, тоді як пропущена термінова заявка може призвести до порушення SLA.
Порада: Поріг упевненості — це правило прийняття рішень, а не універсальний відсоток. Визначте його на основі даних валідації, а потім передавайте прогнози нижче цього порога на перевірку людині.
Як підтримувати точність класифікатора після запуску?
Розгортання — не фінішна лінія. Відстежуйте кількість прогнозів за категоріями, помилки за класами, розподіл упевненості, обсяг черги на перевірку та операційний вплив неправильно перенаправлених заявок.
- Збирайте виправлення як маркований зворотний зв’язок і перевіряйте їх на узгодженість
- Запускайте нові версії моделі в тіньовому режимі, перш ніж вони зможуть змінювати заявки
- Розгортайте оновлення по черзі та зберігайте можливість відкату
- Залишайте перевірку людиною для прогнозів нижче вибраного порога
Частота перенавчання має визначатися виявленим дрейфом, а не довільним календарем. Запуск продукту, зміна таксономії або поява нового сегмента клієнтів можуть вимагати раннішого перенавчання. Посібник із інформаційних панелей служби підтримки клієнтів Deskhero пропонує ширшу структуру для вибору показників підтримки, але специфічні вимірювання класифікатора все одно потребують окремого моніторингу.
Що може піти не так і як це виправити?
Непослідовне маркування — поширена причина невдач. Якщо спеціалісти служби підтримки призначають різні категорії подібним заявкам, модель навчається на цих розбіжностях. Напишіть правила маркування, перевірте спірні приклади та виміряйте узгодженість перед масштабуванням. Дисбаланс класів створює ще один ризик, оскільки сукупний показник може виглядати високим, тоді як категорія з малим обсягом даних працює погано. Використовуйте метрики для кожного класу та за потреби збирайте більше репрезентативних прикладів.
Для неоднозначних заявок потрібен чітко визначений запасний сценарій. Надсилайте невпевнені прогнози до черги на перевірку, зберігайте початковий результат моделі для аналізу та використовуйте виправлення в наступному наборі для оцінювання. Для систем на основі LLM перевіряйте, чи є результат однією з дозволених міток, перш ніж запускати будь-яку дію робочого процесу.
Питання конфіденційності заслуговує на окремий пункт. Не надсилайте заявки, що містять персональні дані, сторонній моделі, якщо це не відповідає вашим юридичним вимогам і вимогам безпеки, зокрема вимозі укласти відповідну угоду про обробку даних, якщо це необхідно.
Порада: Мінімізуйте поля, які надсилаються класифікатору. Якщо моделі потрібні лише тема та повідомлення, не додавайте нерелевантні дані клієнта.
Як виглядає чотиритижневий пілотний проєкт із класифікації за допомогою ШІ?
Чотиритижневий графік може слугувати шаблоном для планування, хоча реальний темп має визначатися обсягом даних і часом на перевірку:
- Тиждень 0, визначення обсягу. Виберіть одну чергу, визначте таксономію, оберіть базові метрики та задокументуйте неприйнятні помилки.
- Тиждень 1, маркування та базова модель. Промаркуйте репрезентативну вибірку, усуньте розбіжності та навчіть або налаштуйте найпростішу прийнятну базову модель.
- Тиждень 2, інтеграція та тіньове тестування. Запускайте прогнози на реальних заявках, не змінюючи їхніх полів.
- Тижні 3–4, обмежене розгортання та оцінювання. Увімкніть дії лише для перевірених випадків із високою впевненістю, а потім виміряйте якість моделі, навантаження на перевірку, виправлення маршрутизації та результати роботи служби підтримки.
Не сприймайте чотири тижні як гарантію. Продовжте тіньове тестування, якщо відсутні рідкісні категорії, якість маркування непослідовна або інтеграція не може безпечно обробити збій.
Чому Deskhero підходить командам, які тестують класифікацію за допомогою ШІ
Deskhero перетворює поштову скриньку Gmail, Google Workspace або Microsoft 365 на helpdesk, не змінюючи адресу електронної пошти, яку бачать клієнти. Нові заявки також можуть надходити через вбудовані форми та чат-бот зі ШІ. Це забезпечує пілотному проєкту узгоджений запис заявки, водночас Користувачі продовжують працювати зі спільною поштовою скринькою.
Автоматизації нових заявок Deskhero можуть оцінювати умови ШІ, сформульовані звичайною мовою, і встановлювати виконавця, групу, статус, пріоритет, теги або поля зі спадними списками. Це дає змогу виконувати практичне сортування за допомогою ШІ без створення власної моделі. Для окремого класифікатора REST API може отримувати список заявок і оновлювати їх, але інтеграція повинна опитувати API, оскільки Deskhero не має вихідних вебхуків. Запропоновані ШІ відповіді — це окрема функція, що ґрунтується на знаннях робочого простору, тоді як автоматичні відповіді ШІ для клієнтів і чат-бот відповідають лише на основі схвалених загальнодоступних FAQ. Deskhero також підтримує багатомовні заявки.
Примітки щодо реалізації
Зробіть першу таксономію вузькою, фіксуйте кожне виправлення та розрізняйте оцінювання моделі й оцінювання робочого процесу. Класифікатор може мати високий показник F1 і водночас створювати операційні проблеми, якщо призначає неправильну групу або перезаписує поле, потрібне Користувачам. Почніть із тіньових прогнозів, а потім увімкніть дії, які можна скасувати, для найочевидніших випадків.
Почніть пілотний проєкт, не очікуючи на міграцію
Deskhero може підключатися до наявної поштової скриньки Gmail, Google Workspace або Microsoft 365, зокрема до спільних поштових скриньок Microsoft. Спочатку можна перевірити вбудовані автоматизації нових заявок, які встановлюють поля маршрутизації на основі чітких умов або умови, оціненої ШІ. Якщо вам потрібен окремо навчений класифікатор, використовуйте REST API для опитування заявок і оновлення прийнятих міток.
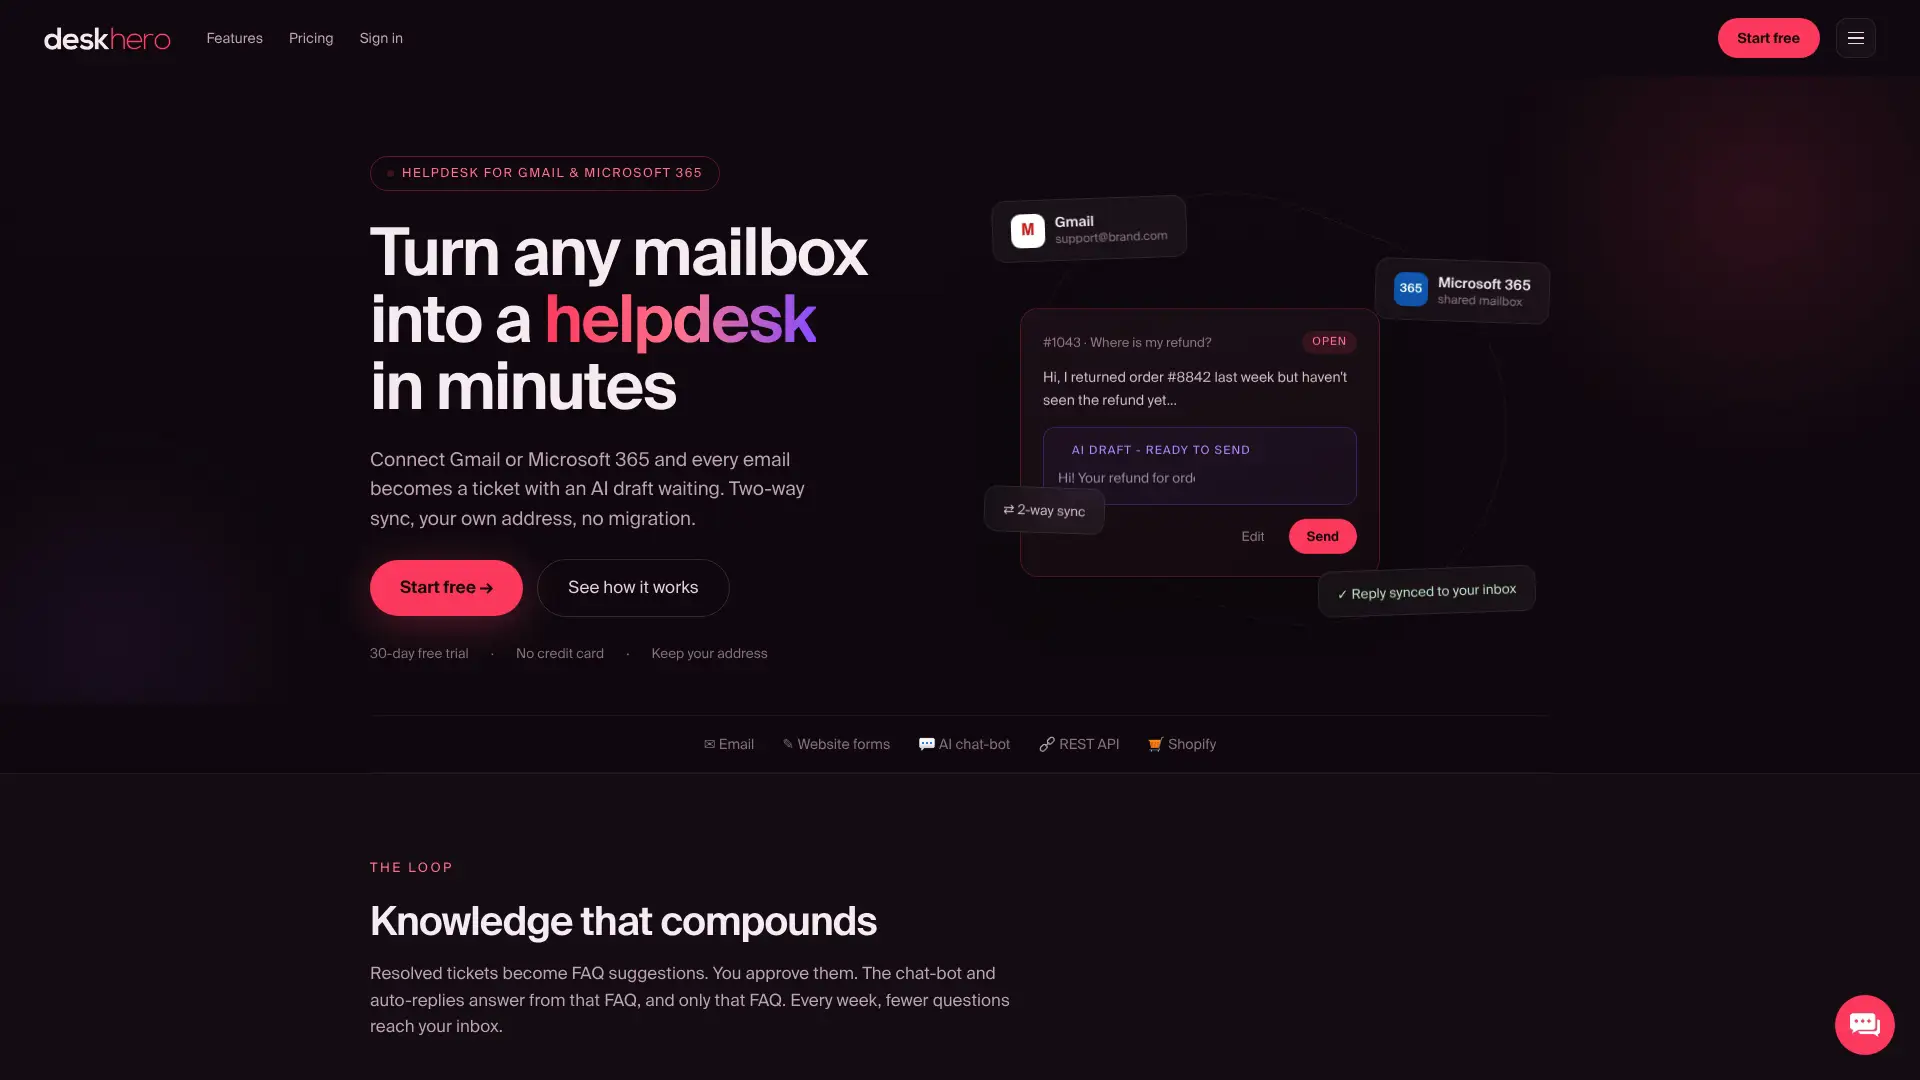
Зберігайте класифікацію, маршрутизацію та генерацію відповідей як окремі елементи керування. Запропоновані відповіді Deskhero використовують знання робочого простору й залишаються доступними Користувачу для прийняття, редагування або відхилення. Його автоматичні відповіді ШІ та чат-бот використовують лише схвалені загальнодоступні записи FAQ, а для активації чат-бота потрібно щонайменше 100 схвалених записів FAQ. Deskhero пропонує 30-денний безплатний пробний період без потреби вказувати кредитну картку.
Джерела
Наведені нижче ресурси містять порівняння досліджень, робочу еталонну реалізацію та визначення основних метрик оцінювання:
- Порівняльне дослідження алгоритмів машинного та глибокого навчання для класифікації заявок клієнтської підтримки
- aiticketclassifier (GitHub)
- Що таке точність, повнота, запам’ятовуваність і F1-оцінка?
FAQ
Що таке система обробки заявок зі ШІ?
Система обробки заявок зі ШІ — це helpdesk або підключений сервіс, який використовує машинне навчання чи мовні моделі для таких завдань, як класифікація, визначення пріоритету, маршрутизація, створення чернеток відповідей або автоматичні відповіді. Точні можливості залежать від продукту.
Що таке моделі класифікації у ШІ?
Моделі класифікації призначають один або кілька заздалегідь визначених міток новим вхідним даним на основі правил або шаблонів, вивчених із маркованих прикладів. У системі обробки заявок міткою може бути категорія, пріоритет, мова або група призначення.
Що таке метод обробки заявок за допомогою ШІ?
Стандартизованого «методу обробки заявок за допомогою ШІ» не існує. Типовий конвеєр отримує текст заявки, готує вхідні дані, прогнозує мітку, перевіряє результат за правилами та критеріями впевненості, а потім оновлює заявку або додає її до черги.
Як ШІ точно класифікує заявки служби підтримки?
Точність залежить від узгоджених міток, репрезентативних прикладів, відповідних вхідних полів і тестування на відкладених заявках. Порівняльне дослідження 2025 року показало, що поєднання заголовка й опису покращило результати в усіх протестованих сценаріях.
Чи може helpdesk на кшталт Deskhero виконувати класифікацію заявок без команди фахівців із обробки даних?
Deskhero може виконувати сортування нових заявок за допомогою ШІ через правила автоматизації зі сформульованими звичайною мовою умовами ШІ. Такі правила можуть встановлювати поля, як-от група, пріоритет, виконавець, статус і теги. Окремо навчений статистичний класифікатор потребує зовнішньої інтеграції, яка опитує REST API Deskhero.