AI-klassificering af supportsager for supportteams: En praktisk guide
AI-baseret billetklassificering læser indkommende supportsager og forudsiger etiketter som kategori, prioritet eller destination. Det kan reducere gentagen sortering, men usikre forudsigelser kræver stadig menneskelig gennemgang. Et praktisk pilotprojekt bruger repræsentativ sagstekst, et klart defineret etiketsæt og konfidensgrænser valgt ud fra valideringsresultater. Forskning som et sammenlignende studie fra 2025 kan hjælpe dig med at vælge en baseline, mens denne introduktion til accuracy, precision, recall og F1 forklarer de vigtigste evalueringsmålinger.
Før du afsætter budget til en model, skal du bekræfte det grundlæggende:
- Du har et repræsentativt sæt historiske supportsager med brugbar tekst og pålidelige etiketter
- Din indledende taksonomi er lille nok til, at sagsbehandlere kan anvende den konsekvent
- Du kan sende forudsigelser med lav konfidens til en kø til menneskelig gennemgang
- En person i dit team har ansvaret for overvågning og rettelser efter lanceringen
Vigtigste pointer
AI-baseret billetklassificering fungerer bedst, når den kombinerer mærkede eksempler, målbare acceptkriterier, konfidensgrænser og menneskelig gennemgang i stedet for fuld automatisering fra dag ét.
| Punkt | Detaljer |
|---|---|
| Start med et begrænset pilotprojekt | Test én kø eller et lille sæt kategorier, før du udvider klassifikatorens anvendelsesområde. |
| Tilpas modellen til opgaven | Studiet fra 2025 viste, at klassiske maskinlæringsmodeller matchede eller overgik de testede deep learning-modeller i flere scenarier for billetklassificering. |
| Brug konfidensgrænser | Send usikre resultater til menneskelig gennemgang i stedet for at tvinge en etiket igennem. |
| Overvåg efter lanceringen | Følg fejl pr. klasse og ændringer i konfidensfordelingen, så du kan opdage drift. |
| Adskil klassificering fra generering af svar | Routning af supportsager og AI-genererede svar løser forskellige problemer og bør evalueres uafhængigt af hinanden. |
Indholdsfortegnelse
- Hvad er AI-baseret billetklassificering?
- Hvordan behandler et AI-baseret ticketsystem en supportsag?
- Hvilken modeltilgang passer til din mængde af supportsager?
- Hvordan integrerer du en klassifikator i din ticketworkflow?
- Hvilke målinger viser, at din klassifikator er klar?
- Hvordan holder du en klassifikator præcis efter lanceringen?
- Hvad går galt, og hvordan løser du det?
- Hvordan ser et fire ugers pilotprojekt for AI-klassificering ud?
- Hvorfor passer Deskhero til teams, der afprøver AI-klassificering?
- Start et pilotprojekt uden at vente på en migrering
- Kilder
- Ofte stillede spørgsmål
Hvad er AI-baseret billetklassificering?
AI-baseret billetklassificering er automatisk tildeling af foruddefinerede etiketter til supportsager baseret på deres tekst og i nogle systemer udvalgte metadata eller vedhæftede filer. Etiketterne kan bruges af routningsregler, prioritetskøer, rapportering eller forslag til næste skridt. Klassifikatoren reducerer kun manuel triage for de forudsigelser, der opfylder dine acceptkriterier. Den bør ikke uden videre tvinge usikre supportsager ind i en kø.
De sandsynlige fordele er hurtigere indledende sortering og mere ensartede etiketter, men forbedringens størrelse afhænger af din taksonomi, dine træningsdata, din arbejdsgang og din trafik. Mål resultaterne i forhold til din nuværende proces i stedet for at stole på en leverandørs fremhævede nøjagtighed.
Almindelige anvendelser omfatter at opdele IT-anmodninger i kategorierne adgang, hardware og software, sortere spørgsmål fra e-handelskunder i fakturering, levering og returnering samt tildele supportsager efter sprog. Klassificering adskiller sig også fra generering af svar. Et helpdesk-system kan for eksempel udarbejde et svar ud fra sine videnskilder, selv om en separat regel eller model håndterer routningen.
Hvordan behandler et AI-baseret ticketsystem en supportsag?
En typisk billetklassifikator bruger fem trin. Detaljerne varierer efter model og integration, men trinnene giver dig nyttige kontrolpunkter, når noget går galt.
Processen trin for trin:
- Indlæsning. Systemet modtager sagstekst og relevante metadata fra helpdesk-systemet.
- Forbehandling. Det fjerner irrelevant markup eller signaturer og normaliserer inputtet. Nogle implementeringer udtrækker også tekst fra understøttede vedhæftede filer.
- Feature-ekstraktion. En klassisk model kan bruge TF-IDF-vektorer, mens en neural model kan bruge embeddings eller tokens.
- Modelinferens. Klassifikatoren forudsiger én eller flere etiketter og, når det er muligt, en konfidensscore.
- Efterbehandling og routning. Regler accepterer, afviser eller sender forudsigelsen til gennemgang, før supportsagen opdateres.
Flersprogede supportsager kan oversættes før klassificering eller behandles af en flersproget model. Test begge tilgange på din egen sprogblanding, fordi oversættelse kan ændre vigtige begreber. Open source-projektet aiticketclassifier viser en TF-IDF-klassificeringspipeline med kategoriforudsigelser, konfidensscorer, et dashboard, anbefalinger og Slack-advarsler. Realtidsbehandling passer til arbejdsgange, hvor etiketten skal påvirke en aktiv kø. Batchbehandling er nyttig til tilbageudfyldning og evaluering.
Hvilken modeltilgang passer til din mængde af supportsager?
Der er tre overordnede niveauer at overveje. Det rigtige valg afhænger af tvetydigheden i dine etiketter, mængden og kvaliteten af dine data, kravene til svartid og driftsomkostningerne.
Regel- og mønsterbaserede systemer matcher søgeord, adresser, domæner eller regulære udtryk med handlinger. De er hurtige og nemme at forklare, men et voksende regelsæt kan blive vanskeligt at vedligeholde. De fungerer godt i snævre situationer med høje krav til præcision, såsom kendte faktureringsadresser eller produktkoder.
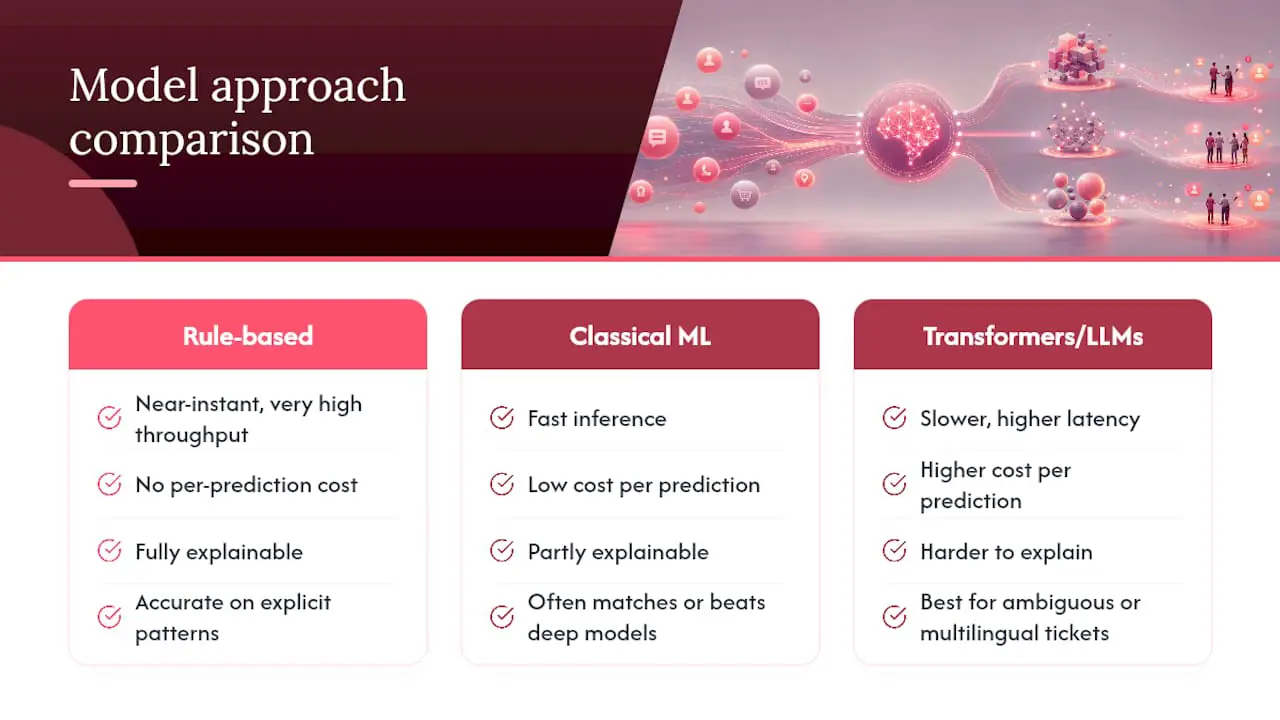
Klassiske maskinlæringsmetoder som Logistic Regression, SVM og XGBoost trænes på mærkede eksempler. Det sammenlignende studie fra 2025 evaluerede otte algoritmer på offentlige datasæt og virksomhedsdata. Det viste, at en kombination af supportsagens titel og beskrivelse forbedrede ydeevnen i alle testede scenarier, og at klassiske modeller matchede eller overgik de testede deep learning-modeller i flere tilfælde.
Transformer- og LLM-tilgange kan være nyttige, når supportsager er tvetydige, flersprogede eller afhænger af en bredere kontekst. De kan også medføre større omkostninger, længere svartid og mere kompleks evaluering. Sammenlign dem med en enklere baseline i stedet for at antage, at den større model vil præstere bedre.
Professionelt tip: Start med den mindst komplekse tilgang, der opfylder dine acceptkriterier. Studiet fra 2025 rapporterede en accuracy og F1 på over 0,95 for prioritetsklassificering i de testede scenarier, mens kategoriklassificering var vanskeligere på virksomhedsdata.
Hvordan integrerer du en klassifikator i din ticketworkflow?
Integration lykkes, når hver forudsigelse har en klar handling, der kan rulles tilbage. Gå gennem disse trin i rækkefølge:
- Gennemgå dine data. Udtag en repræsentativ periode, og kontrollér, hvor konsekvent supportsagerne blev mærket.
- Design din taksonomi. Begynd med kategorier, som sagsbehandlerne pålideligt kan skelne mellem.
- Mærk et startsæt af data. Brug supportspecialister, der forstår køen, og registrér uenigheder.
- Opbyg en baseline. Sammenlign et enkelt regelsæt eller en klassisk model med din nuværende manuelle proces.
- Test den fulde integration. Bekræft, hvordan forudsigelser, fejl, gentagelser og feltopdateringer fungerer i et sandkassemiljø.
- Udrul i faser. Start med én kø eller en lille gruppe etiketter med høj konfidens.
En ekstern klassifikator læser typisk nye supportsager via helpdesk-systemets understøttede integrationsmetode og skriver den accepterede etiket tilbage til felter som gruppe, prioritet eller tags. Undersøg, om helpdesk-systemet understøtter udgående hændelser eller kræver polling. Deskheroes REST API understøtter visning og opdatering af supportsager, men tilbyder ikke udgående webhooks, så en ekstern klassifikator skal hente data via polling fra API'et. Se Deskheroes workflow fra e-mail til supportsag for opsætning af postkasse og oprettelse af supportsager.
Hvilke målinger viser, at din klassifikator er klar?
Fire målinger er særligt nyttige: precision (hvor mange af de forudsagte etiketter der var korrekte), recall (hvor mange sande forekomster der blev fundet), F1 (det harmoniske gennemsnit af precision og recall) og konfidenskalibrering (om de forudsagte sandsynligheder stemmer overens med de observerede resultater).
Ved problemer med flere klasser bør du undersøge både makro-gennemsnitlig F1, som giver alle klasser samme vægt, og mikro-gennemsnitlig F1, som domineres af klasser med stor volumen. Undersøg også en forvekslingsmatrix samt precision og recall pr. klasse. En enkelt samlet score kan skjule alvorlige fejl i sjældne, men vigtige kategorier.
Evaluer på et separat sæt af ægte supportsager, der afspejler produktionstrafikken. Definér acceptkriterier ud fra omkostningen ved hver fejl. En fejlagtigt markeret hastesag spilder kapacitet, mens en overset hastesag kan medføre brud på en SLA.
Professionelt tip: En konfidensgrænse er en beslutningsregel, ikke en universel procentdel. Vælg den ud fra valideringsdata, og send derefter forudsigelser under grænsen til menneskelig gennemgang.
Hvordan holder du en klassifikator præcis efter lanceringen?
Implementeringen er ikke målstregen. Følg antallet af forudsigelser pr. kategori, fejl pr. klasse, konfidensfordelingen, mængden i gennemgangskøen og den operationelle effekt af fejlroutede supportsager.
- Indsaml rettelser som mærkede tilbagemeldinger, og gennemgå dem for konsistens
- Kør nye modelversioner i skyggetilstand, før de kan ændre supportsager
- Udrul opdateringer kø for kø, og bevar en mulighed for tilbagerulning
- Bevar menneskelig gennemgang af forudsigelser under den valgte grænse
Hyppigheden af genoptræning bør følge den observerede drift og ikke en vilkårlig kalender. En produktlancering, ændring af taksonomien eller et nyt kundesegment kan være grund til at genoptræne tidligere. Deskheroes guide til dashboards for kundesupport giver en bredere ramme for valg af supportmålinger, men klassifikatorspecifikke målinger kræver stadig deres egen overvågning.
Hvad går galt, og hvordan løser du det?
Uensartede etiketter er en almindelig fejltilstand. Hvis supportspecialister tildeler forskellige kategorier til lignende supportsager, lærer modellen denne uenighed. Skriv retningslinjer for mærkning, gennemgå omstridte eksempler, og mål enigheden, før du skalerer. Ubalancerede klasser skaber en anden risiko, fordi en samlet score kan se stærk ud, mens en kategori med lav volumen præsterer dårligt. Brug målinger pr. klasse, og indsaml flere repræsentative eksempler efter behov.
Tvetydige supportsager kræver en eksplicit fallback. Send usikre forudsigelser til en gennemgangskø, behold det oprindelige modeloutput til analyse, og lad rettelser indgå i det næste evalueringssæt. For LLM-baserede systemer skal du validere, at outputtet er en af de tilladte etiketter, før en workflowhandling udføres.
Privatliv fortjener sin egen post. Send ikke supportsager, der indeholder personoplysninger, til en tredjepartsmodel, medmindre dine juridiske krav og sikkerhedskrav er opfyldt, herunder en passende databehandleraftale, hvor det er påkrævet.
Professionelt tip: Minimér de felter, der sendes til klassifikatoren. Hvis modellen kun har brug for et emne og en besked, skal du ikke inkludere uvedkommende kundedata.
Hvordan ser et fire ugers pilotprojekt for AI-klassificering ud?
En tidsplan på fire uger kan fungere som planlægningsskabelon, selv om datamængden og tiden til gennemgang bør bestemme det reelle tempo:
- Uge 0, afgrænsning. Vælg én kø, definér taksonomien, vælg baselinemålinger, og dokumentér uacceptable fejl.
- Uge 1, mærkning og baseline. Mærk et repræsentativt udsnit, løs uenigheder, og træn eller konfigurér den enklest mulige fungerende baseline.
- Uge 2, integration og skyggetest. Kør forudsigelser på live-supportsager uden at ændre deres felter.
- Uge 3 til 4, begrænset udrulning og evaluering. Aktivér kun handlinger for validerede tilfælde med høj konfidens, og mål derefter modelkvalitet, belastningen på gennemgangskøen, routningsrettelser og supportresultater.
Se ikke fire uger som en garanti. Forlæng skyggetesten, hvis sjældne kategorier mangler, kvaliteten af mærkningen er uensartet, eller integrationen ikke kan fejle sikkert.
Hvorfor passer Deskhero til teams, der afprøver AI-klassificering?
Deskhero omdanner en Gmail-, Google Workspace- eller Microsoft 365-postkasse til et helpdesk-system uden at ændre den kundeorienterede e-mailadresse. Nye supportsager kan også komme ind via indlejrede formularer og AI-chatbotten. Det giver et pilotprojekt en ensartet sagsregistrering, mens brugere fortsat arbejder i en fælles indbakke.
Deskheroes automatiseringer for nye supportsager kan evaluere AI-betingelser formuleret i almindeligt sprog og angive ansvarlig, gruppe, status, prioritet, tags eller dropdown-felter. Det understøtter praktisk AI-assisteret triage uden at bygge en specialtilpasset model. For en separat klassifikator kan REST API'et vise og opdatere supportsager, men integrationen skal bruge polling, fordi Deskhero ikke har udgående webhooks. AI-forslag til svar er en separat funktion, der bygger på viden fra arbejdsområdet, mens AI-autosvar rettet mod kunder og chatbotten kun svarer ud fra den godkendte offentlige FAQ. Deskhero understøtter også flersprogede supportsager.
Implementeringsnoter
Hold den første taksonomi snæver, log alle rettelser, og adskil model-evaluering fra workflow-evaluering. En klassifikator kan have en stærk F1-score og stadig skabe operationelle problemer, hvis den tildeler den forkerte gruppe eller overskriver et felt, som brugere har brug for. Start med skyggeforudsigelser, og aktivér derefter handlinger, der kan rulles tilbage, for de tydeligste tilfælde.
Start et pilotprojekt uden at vente på en migrering
Deskhero kan oprette forbindelse til en eksisterende Gmail-, Google Workspace- eller Microsoft 365-postkasse, herunder delte Microsoft-postkasser. Du kan først teste indbyggede automatiseringer for nye supportsager, som angiver routningsfelter ud fra eksplicitte betingelser eller en AI-evalueret betingelse. Hvis du har brug for en separat trænet klassifikator, kan du bruge REST API'et til at hente supportsager via polling og opdatere accepterede etiketter.
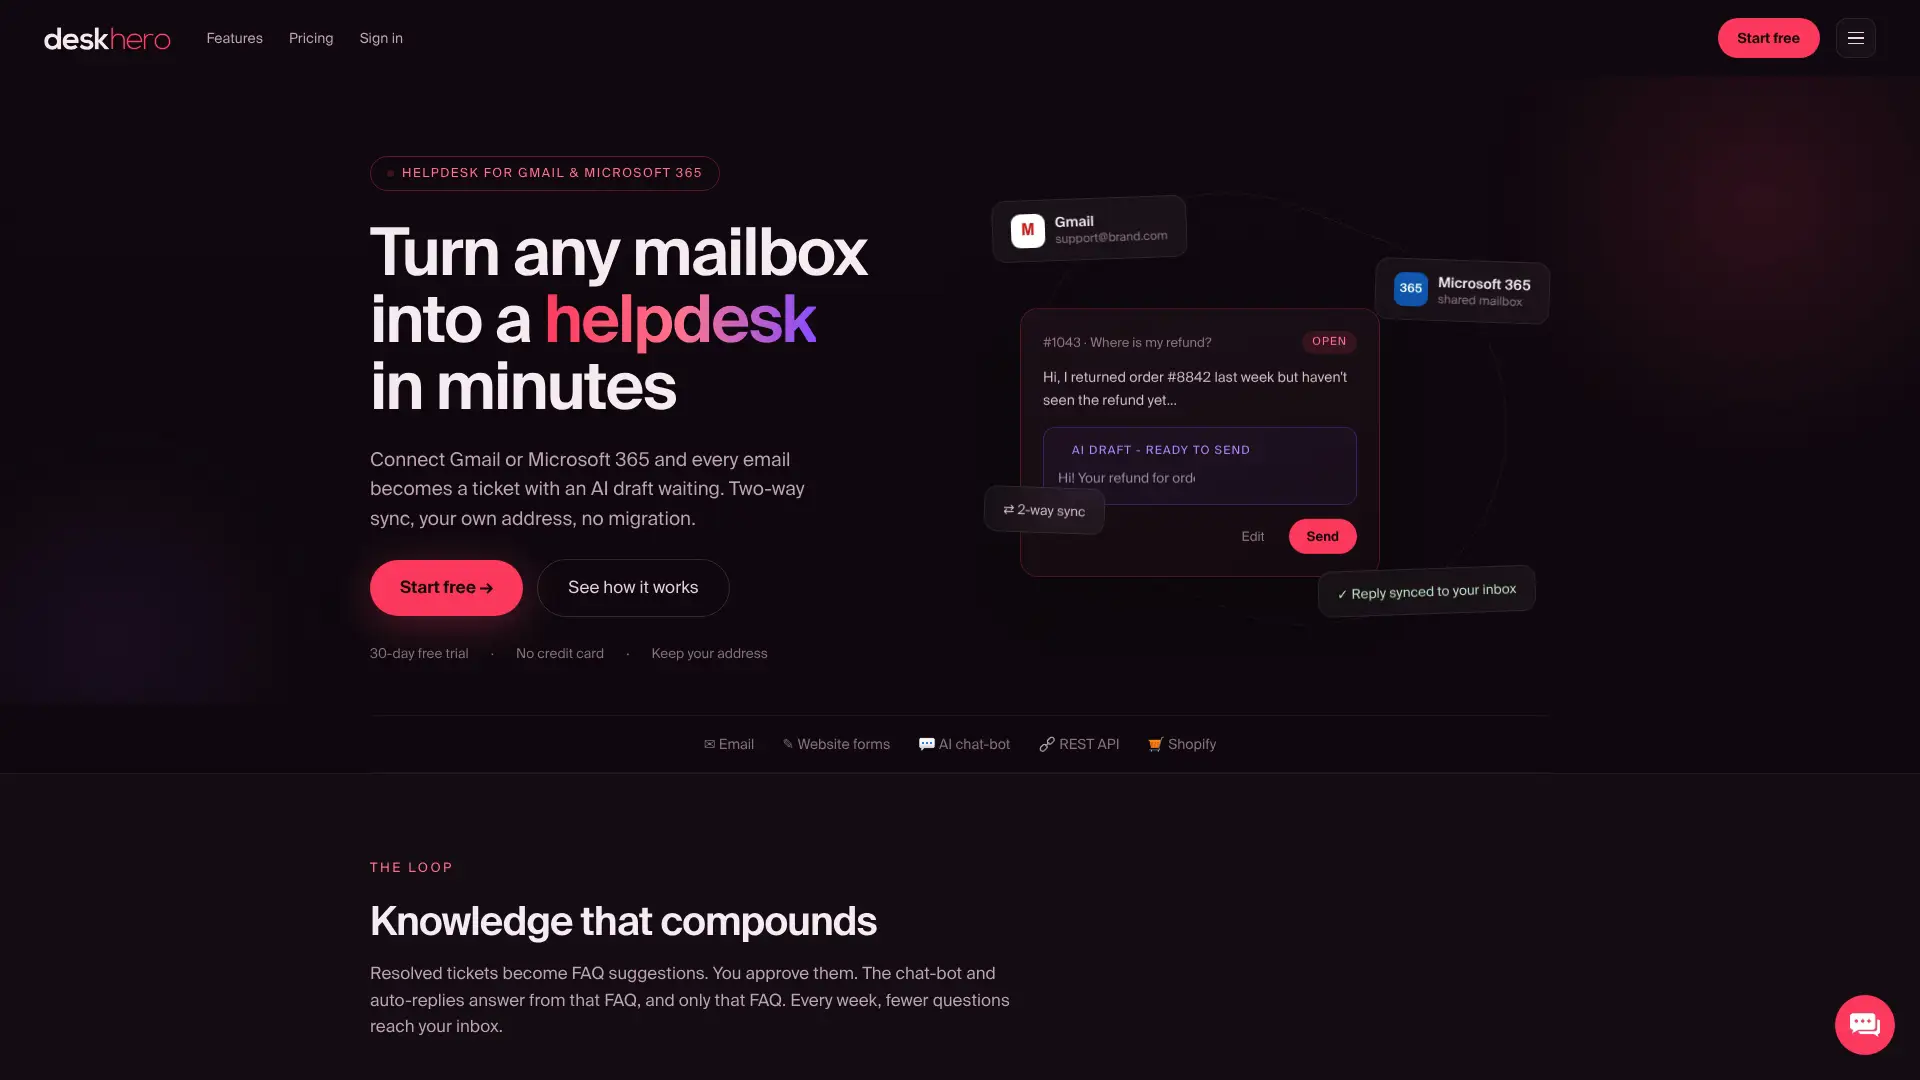
Hold klassificering, routning og generering af svar som separate kontroller. Deskheroes foreslåede svar bruger viden fra arbejdsområdet og er fortsat tilgængelige, så en bruger kan acceptere, redigere eller afvise dem. AI-autosvar og chatbotten bruger kun godkendte offentlige FAQ-punkter, og chatbotten kræver mindst 100 godkendte FAQ-punkter, før den kan aktiveres. Deskhero tilbyder en gratis prøveperiode på 30 dage uden krav om kreditkort.
Kilder
Følgende ressourcer indeholder en forskningssammenligning, en fungerende referenceimplementering og definitioner af de vigtigste evalueringsmålinger:
- Sammenlignende studie af maskinlærings- og deep learning-algoritmer til klassificering af kundesupportsager
- aiticketclassifier (GitHub)
- Hvad er accuracy, precision, recall og F1-score?
Ofte stillede spørgsmål
Hvad er et AI-baseret ticketsystem?
Et AI-baseret ticketsystem er et helpdesk-system eller en tilknyttet tjeneste, der bruger maskinlæring eller sprogmodeller til opgaver som klassificering, prioritering, routning, udarbejdelse af svar eller automatiske svar. De præcise funktioner varierer fra produkt til produkt.
Hvad er klassificeringsmodeller inden for AI?
Klassificeringsmodeller tildeler én eller flere foruddefinerede etiketter til nye input baseret på regler eller mønstre, der er lært fra mærkede eksempler. I et ticketsystem kan etiketten være en kategori, prioritet, sprog eller destinationsgruppe.
Hvad er AI-ticketmetoden?
Der findes ingen standardiseret "AI-ticketmetode". En typisk pipeline indlæser sagstekst, forbereder inputtet, forudsiger en etiket, validerer resultatet mod regler og konfidenskriterier og opdaterer eller køsætter derefter supportsagen.
Hvordan klassificerer AI supportsager præcist?
Nøjagtigheden afhænger af ensartede etiketter, repræsentative eksempler, passende inputfelter og test på separate supportsager. Det sammenlignende studie fra 2025 viste, at en kombination af titel og beskrivelse forbedrede resultaterne i alle de testede scenarier.
Kan et helpdesk-system som Deskhero håndtere billetklassificering uden et data science-team?
Deskhero kan udføre AI-assisteret triage af nye supportsager gennem automatiseringsregler med AI-betingelser formuleret i almindeligt sprog. Reglerne kan angive felter som gruppe, prioritet, ansvarlig, status og tags. En separat trænet statistisk klassifikator kræver en ekstern integration, der bruger polling mod Deskheroes REST API.