AI-ticketclassificatie voor supportteams: een praktische gids
AI-ticketclassificatie leest binnenkomende supporttickets en voorspelt labels zoals categorie, prioriteit of bestemming. Dit kan repetitief sorteerwerk verminderen, maar onzekere voorspellingen moeten nog steeds door een mens worden gecontroleerd. Een praktische pilot gebruikt representatieve tickettekst, een duidelijk gedefinieerde labelsset en betrouwbaarheidsdrempels die op basis van validatieresultaten zijn gekozen. Onderzoek zoals een vergelijkende studie uit 2025 kan je helpen een baseline te kiezen, terwijl deze uitleg over accuracy, precision, recall en F1 de belangrijkste evaluatiemetrieken toelicht.
Controleer de basis voordat je budget voor een model reserveert:
- Je beschikt over een representatieve set historische tickets met bruikbare tekst en betrouwbare labels
- Je eerste taxonomie is klein genoeg om door beoordelaars consequent te worden toegepast
- Je kunt voorspellingen met een lage betrouwbaarheid naar een menselijke beoordelingswachtrij sturen
- Iemand in je team is na de lancering verantwoordelijk voor monitoring en correcties
Belangrijkste punten
AI-ticketclassificatie werkt het best wanneer gelabelde voorbeelden, meetbare acceptatiecriteria, betrouwbaarheidsdrempels en menselijke controle worden gecombineerd, in plaats van vanaf dag één volledig op automatisering te vertrouwen.
| Punt | Details |
|---|---|
| Begin met een beperkte pilot | Test één wachtrij of een kleine set categorieën voordat je het bereik van de classifier uitbreidt. |
| Stem het model af op de taak | Uit de studie uit 2025 bleek dat klassieke machinelearningmodellen in verschillende geteste ticketclassificatiescenario's even goed of beter presteerden dan de geteste deep-learningmodellen. |
| Gebruik betrouwbaarheidsdrempels | Stuur onzekere resultaten naar menselijke controle in plaats van een label te forceren. |
| Monitor na de lancering | Houd fouten per klasse en veranderingen in de betrouwbaarheidsverdeling bij, zodat je drift kunt detecteren. |
| Scheid classificatie van het genereren van antwoorden | Ticketroutering en door AI opgestelde antwoorden lossen verschillende problemen op en moeten onafhankelijk van elkaar worden geëvalueerd. |
Inhoudsopgave
- Wat is AI-ticketclassificatie?
- Hoe verwerkt een AI-ticketsysteem een ticket?
- Welke modelaanpak past bij jouw ticketvolume?
- Hoe integreer je een classifier in je ticketworkflow?
- Welke metrieken bewijzen dat je classifier klaar is?
- Hoe houd je een classifier na de lancering accuraat?
- Wat gaat er mis en hoe los je dat op?
- Hoe ziet een AI-classificatiepilot van vier weken eruit?
- Waarom Deskhero geschikt is voor teams die AI-classificatie testen
- Start een pilot zonder op een migratie te wachten
- Bronnen
- Veelgestelde vragen
Wat is AI-ticketclassificatie?
AI-ticketclassificatie is het automatisch toewijzen van vooraf gedefinieerde labels aan supporttickets op basis van hun tekst en, in sommige systemen, geselecteerde metadata of bijlagen. Deze labels kunnen routeringsregels, prioriteitswachtrijen, rapportages of voorgestelde vervolgstappen aansturen. De classifier vermindert handmatige triage alleen voor voorspellingen die aan jouw acceptatiecriteria voldoen. Onzekere tickets mogen niet stilzwijgend in een wachtrij worden geplaatst.
De waarschijnlijke voordelen zijn sneller sorteren in eerste instantie en consistentere labels, maar de omvang van de verbetering hangt af van je taxonomie, trainingsdata, workflow en verkeersvolume. Meet resultaten af tegen je huidige proces in plaats van te vertrouwen op de opvallende accuracyclaims van een leverancier.
Veelvoorkomende toepassingen zijn het scheiden van IT-verzoeken in categorieën zoals toegang, hardware en software; het sorteren van e-commercevragen in facturering, verzending en retouren; en het toewijzen van tickets op basis van taal. Classificatie verschilt ook van het genereren van antwoorden. Zo kan een helpdesk een antwoord opstellen vanuit zijn kennisbronnen, terwijl een aparte regel of een apart model de routering afhandelt.
Hoe verwerkt een AI-ticketsysteem een ticket?
Een typische ticketclassifier gebruikt vijf fasen. De details verschillen per model en integratie, maar de fasen bieden nuttige controlepunten wanneer er iets misgaat.
De pipeline, fase voor fase:
- Inname. Het systeem ontvangt tickettekst en relevante metadata uit de helpdesk.
- Voorbewerking. Het verwijdert irrelevante opmaak of handtekeningen en normaliseert de invoer. Sommige implementaties halen ook tekst uit ondersteunde bijlagen.
- Feature-extractie. Een klassiek model kan TF-IDF-vectoren gebruiken, terwijl een neuraal model embeddings of tokens kan gebruiken.
- Modelinferentie. De classifier voorspelt een of meer labels en, indien beschikbaar, een betrouwbaarheidsscore.
- Nabewerking en routering. Regels accepteren, weigeren of beoordelen de voorspelling voordat het ticket wordt bijgewerkt.
Meertalige tickets kunnen vóór de classificatie worden vertaald of door een meertalig model worden verwerkt. Test beide aanpakken op je eigen talenmix, omdat vertaling belangrijke termen kan veranderen. Het opensourceproject aiticketclassifier toont een TF-IDF-classificatiepipeline met categor Voorspellingen, betrouwbaarheidsscores, een dashboard, aanbevelingen en Slack-meldingen. Realtimeverwerking past bij workflows waarin het label invloed moet hebben op een actieve wachtrij. Batchverwerking is nuttig voor het aanvullen van historische gegevens en evaluatie.
Welke modelaanpak past bij jouw ticketvolume?
Er zijn drie brede niveaus om te overwegen. Het juiste niveau hangt af van de ambiguïteit van je labels, de hoeveelheid en kwaliteit van je data, latencyvereisten en operationele kosten.
Regel- en patroon gebaseerde systemen koppelen trefwoorden, adressen, domeinen of reguliere expressies aan acties. Ze zijn snel en eenvoudig uit te leggen, maar een groeiende verzameling regels kan moeilijk te onderhouden worden. Ze werken goed voor beperkte situaties met hoge precisie, zoals bekende factuuradressen of productcodes.
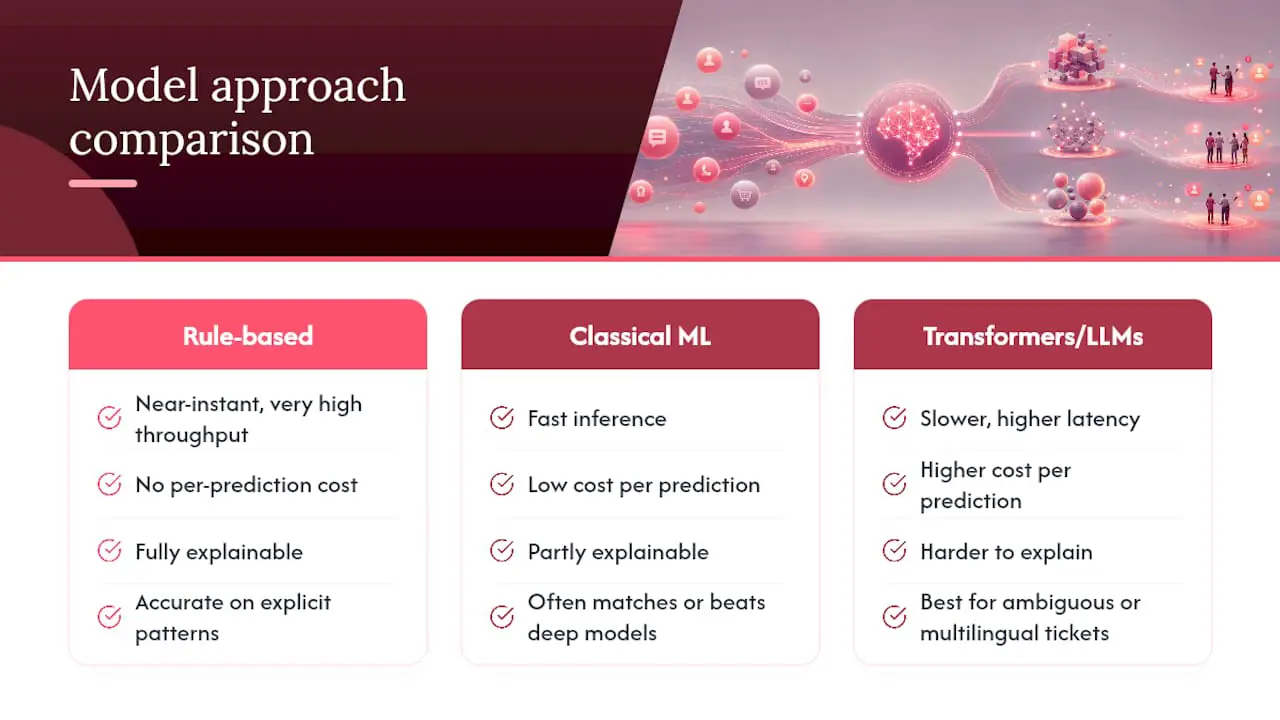
Klassieke machinelearningmethoden zoals Logistic Regression, SVM en XGBoost worden getraind op gelabelde voorbeelden. De vergelijkende studie uit 2025 evalueerde acht algoritmen op openbare en bedrijfsdatasets. Daaruit bleek dat het combineren van de titel en beschrijving van het ticket de prestaties in alle geteste scenario's verbeterde, en dat klassieke modellen in verschillende gevallen even goed of beter presteerden dan de geteste deep-learningmodellen.
Transformer- en LLM-aanpakken kunnen nuttig zijn wanneer tickets ambigu, meertalig of afhankelijk van bredere context zijn. Ze kunnen ook extra kosten, latency en evaluatiecomplexiteit met zich meebrengen. Vergelijk ze met een eenvoudigere baseline in plaats van ervan uit te gaan dat het grotere model beter zal presteren.
Pro-tip: Begin met de minst complexe aanpak die aan je acceptatiecriteria voldoet. De studie uit 2025 rapporteerde in de geteste scenario's een accuracy en F1 van meer dan 0,95 voor prioriteitsclassificatie, terwijl categorieclassificatie moeilijker was op bedrijfsdata.
Hoe integreer je een classifier in je ticketworkflow?
Een integratie slaagt wanneer elke voorspelling een duidelijke, omkeerbare actie heeft. Doorloop deze stappen in de aangegeven volgorde:
- Controleer je data. Neem een representatieve periode als steekproef en controleer hoe consistent tickets zijn gelabeld.
- Ontwerp je taxonomie. Begin met categorieën die beoordelaars betrouwbaar van elkaar kunnen onderscheiden.
- Label een startdataset. Gebruik supportspecialisten die de wachtrij begrijpen en leg meningsverschillen vast.
- Bouw een baseline. Vergelijk een eenvoudige regelset of een klassiek model met je huidige handmatige proces.
- Test de volledige integratie. Controleer in een sandbox hoe voorspellingen, fouten, nieuwe pogingen en veldupdates zich gedragen.
- Rol gefaseerd uit. Begin met één wachtrij of een kleine groep labels met hoge betrouwbaarheid.
Een externe classifier leest nieuwe tickets doorgaans via de door de helpdesk ondersteunde integratiemethode en schrijft het geaccepteerde label terug naar velden zoals groep, prioriteit of tags. Controleer of de helpdesk uitgaande gebeurtenissen ondersteunt of dat polling vereist is. De REST API van Deskhero ondersteunt het ophalen en bijwerken van tickets, maar biedt geen uitgaande webhooks. Een externe classifier moet daarom de API pollen. Raadpleeg voor het instellen van mailboxen en het aanmaken van tickets de workflow voor e-mail-naar-ticket van Deskhero.
Welke metrieken bewijzen dat je classifier klaar is?
Vier metingen zijn bijzonder nuttig: precision (hoeveel van de voorspelde labels correct waren), recall (hoeveel werkelijke gevallen werden gevonden), F1 (het harmonische gemiddelde van precision en recall) en betrouwbaarheidskalibratie (of voorspelde waarschijnlijkheden overeenkomen met waargenomen uitkomsten).
Bekijk bij multiclassproblemen zowel macro-gemiddelde F1, waarbij elke klasse hetzelfde gewicht krijgt, als micro-gemiddelde F1, dat wordt gedomineerd door klassen met een hoog volume. Bekijk ook een confusion matrix en precision en recall per klasse. Eén geaggregeerde score kan ernstige fouten in zeldzame maar belangrijke categorieën verbergen.
Evalueer met een apart gehouden set echte tickets die het productievolume weerspiegelt. Definieer acceptatiecriteria op basis van de kosten van elke fout. Een onjuist label voor urgentie verspilt capaciteit, terwijl een gemist urgent ticket een SLA kan schenden.
Pro-tip: Een betrouwbaarheidsdrempel is een beslisregel, geen universeel percentage. Kies deze op basis van validatiedata en stuur voorspellingen die eronder vallen naar menselijke controle.
Hoe houd je een classifier na de lancering accuraat?
De implementatie is niet de eindstreep. Houd het aantal voorspellingen per categorie, fouten per klasse, de betrouwbaarheidsverdeling, het volume van de beoordelingswachtrij en de operationele impact van verkeerd gerouteerde tickets bij.
- Verzamel correcties als gelabelde feedback en controleer deze op consistentie
- Voer nieuwe modelversies eerst in schaduwmodus uit voordat ze tickets kunnen wijzigen
- Rol updates wachtrij voor wachtrij uit en houd een manier voor terugdraaien beschikbaar
- Behoud menselijke controle voor voorspellingen onder de gekozen drempel
De frequentie van hertraining moet afhangen van waargenomen drift, niet van een willekeurige kalender. Een productlancering, wijziging van de taxonomie of nieuwe klantgroep kan reden zijn om eerder opnieuw te trainen. De gids voor klantenservicedashboards van Deskhero biedt een breder kader voor het selecteren van supportmetrieken, maar classifierspecifieke metingen moeten nog steeds afzonderlijk worden gemonitord.
Wat gaat er mis en hoe los je dat op?
Inconsistente labels zijn een veelvoorkomende faalmodus. Als supportspecialisten verschillende categorieën toewijzen aan vergelijkbare tickets, leert het model die onenigheid. Stel richtlijnen voor labeling op, beoordeel betwiste voorbeelden en meet de overeenstemming voordat je opschaalt. Een ongelijke verdeling van klassen vormt een ander risico, omdat een geaggregeerde score er sterk uit kan zien terwijl een categorie met een laag volume slecht presteert. Gebruik metrieken per klasse en verzamel waar nodig meer representatieve voorbeelden.
Ambigue tickets hebben een expliciete terugvaloptie nodig. Stuur onzekere voorspellingen naar een beoordelingswachtrij, bewaar de oorspronkelijke modeluitvoer voor analyse en laat correcties deel uitmaken van de volgende evaluatieset. Valideer bij systemen op basis van LLM's dat de uitvoer een van de toegestane labels is voordat er een workflowactie wordt uitgevoerd.
Privacy verdient een afzonderlijke post. Stuur geen tickets met persoonsgegevens naar een model van een derde partij tenzij aan je wettelijke en beveiligingsvereisten is voldaan, inclusief een passende overeenkomst voor gegevensverwerking waar dat nodig is.
Pro-tip: Beperk de velden die naar de classifier worden gestuurd. Als het model alleen een onderwerp en bericht nodig heeft, voeg dan geen niet-gerelateerde klantgegevens toe.
Hoe ziet een AI-classificatiepilot van vier weken eruit?
Een planning van vier weken kan als sjabloon voor de planning dienen, hoewel de hoeveelheid data en beoordelingstijd het werkelijke tempo moeten bepalen:
- Week 0, afbakening. Selecteer één wachtrij, definieer de taxonomie, kies baselinemetrieken en leg onaanvaardbare fouten vast.
- Week 1, labeling en baseline. Label een representatieve steekproef, los meningsverschillen op en train of configureer de eenvoudigste haalbare baseline.
- Week 2, integratie en schaduwtests. Voer voorspellingen uit op live tickets zonder hun velden te wijzigen.
- Week 3 tot en met 4, beperkte uitrol en evaluatie. Schakel acties alleen in voor gevalideerde gevallen met hoge betrouwbaarheid en meet vervolgens modelkwaliteit, beoordelingsbelasting, routeringscorrecties en supportresultaten.
Beschouw vier weken niet als een garantie. Breid de schaduwtests uit als zeldzame categorieën ontbreken, de labelkwaliteit inconsistent is of de integratie niet veilig kan falen.
Waarom Deskhero geschikt is voor teams die AI-classificatie testen
Deskhero verandert een Gmail-, Google Workspace- of Microsoft 365-mailbox in een helpdesk zonder het e-mailadres voor klanten te wijzigen. Nieuwe tickets kunnen ook binnenkomen via ingesloten formulieren en de AI-chatbot. Hierdoor heeft een pilot een consistent ticketrecord, terwijl Gebruikers in een gedeelde inbox blijven werken.
De automatiseringen voor nieuwe tickets van Deskhero kunnen AI-voorwaarden in gewone taal evalueren en de toegewezen persoon, groep, status, prioriteit, tags of dropdownvelden instellen. Dit ondersteunt praktische AI-ondersteunde triage zonder dat je een aangepast model hoeft te bouwen. Voor een afzonderlijke classifier kan de REST API tickets ophalen en bijwerken, maar de integratie moet pollen omdat Deskhero geen uitgaande webhooks heeft. Door AI voorgestelde antwoorden zijn een afzonderlijke functie die is gebaseerd op kennis uit de workspace, terwijl klantgerichte automatische AI-antwoorden en de chatbot uitsluitend antwoorden uit de goedgekeurde openbare FAQ. Deskhero ondersteunt ook meertalige tickets.
Implementatienotities
Houd de eerste taxonomie beperkt, leg elke correctie vast en maak onderscheid tussen modelevaluatie en workflowevaluatie. Een classifier kan een sterke F1-score hebben en toch operationele problemen veroorzaken als hij de verkeerde groep toewijst of een veld overschrijft dat Gebruikers nodig hebben. Begin met schaduwvoorspellingen en schakel vervolgens omkeerbare acties in voor de duidelijkste gevallen.
Start een pilot zonder op een migratie te wachten
Deskhero kan verbinding maken met een bestaande Gmail-, Google Workspace- of Microsoft 365-mailbox, inclusief gedeelde Microsoft-mailboxen. Je kunt eerst de ingebouwde automatiseringen voor nieuwe tickets testen, die routeringsvelden instellen op basis van expliciete voorwaarden of een door AI geëvalueerde voorwaarde. Als je een afzonderlijk getrainde classifier nodig hebt, gebruik je de REST API om tickets op te halen en geaccepteerde labels bij te werken.
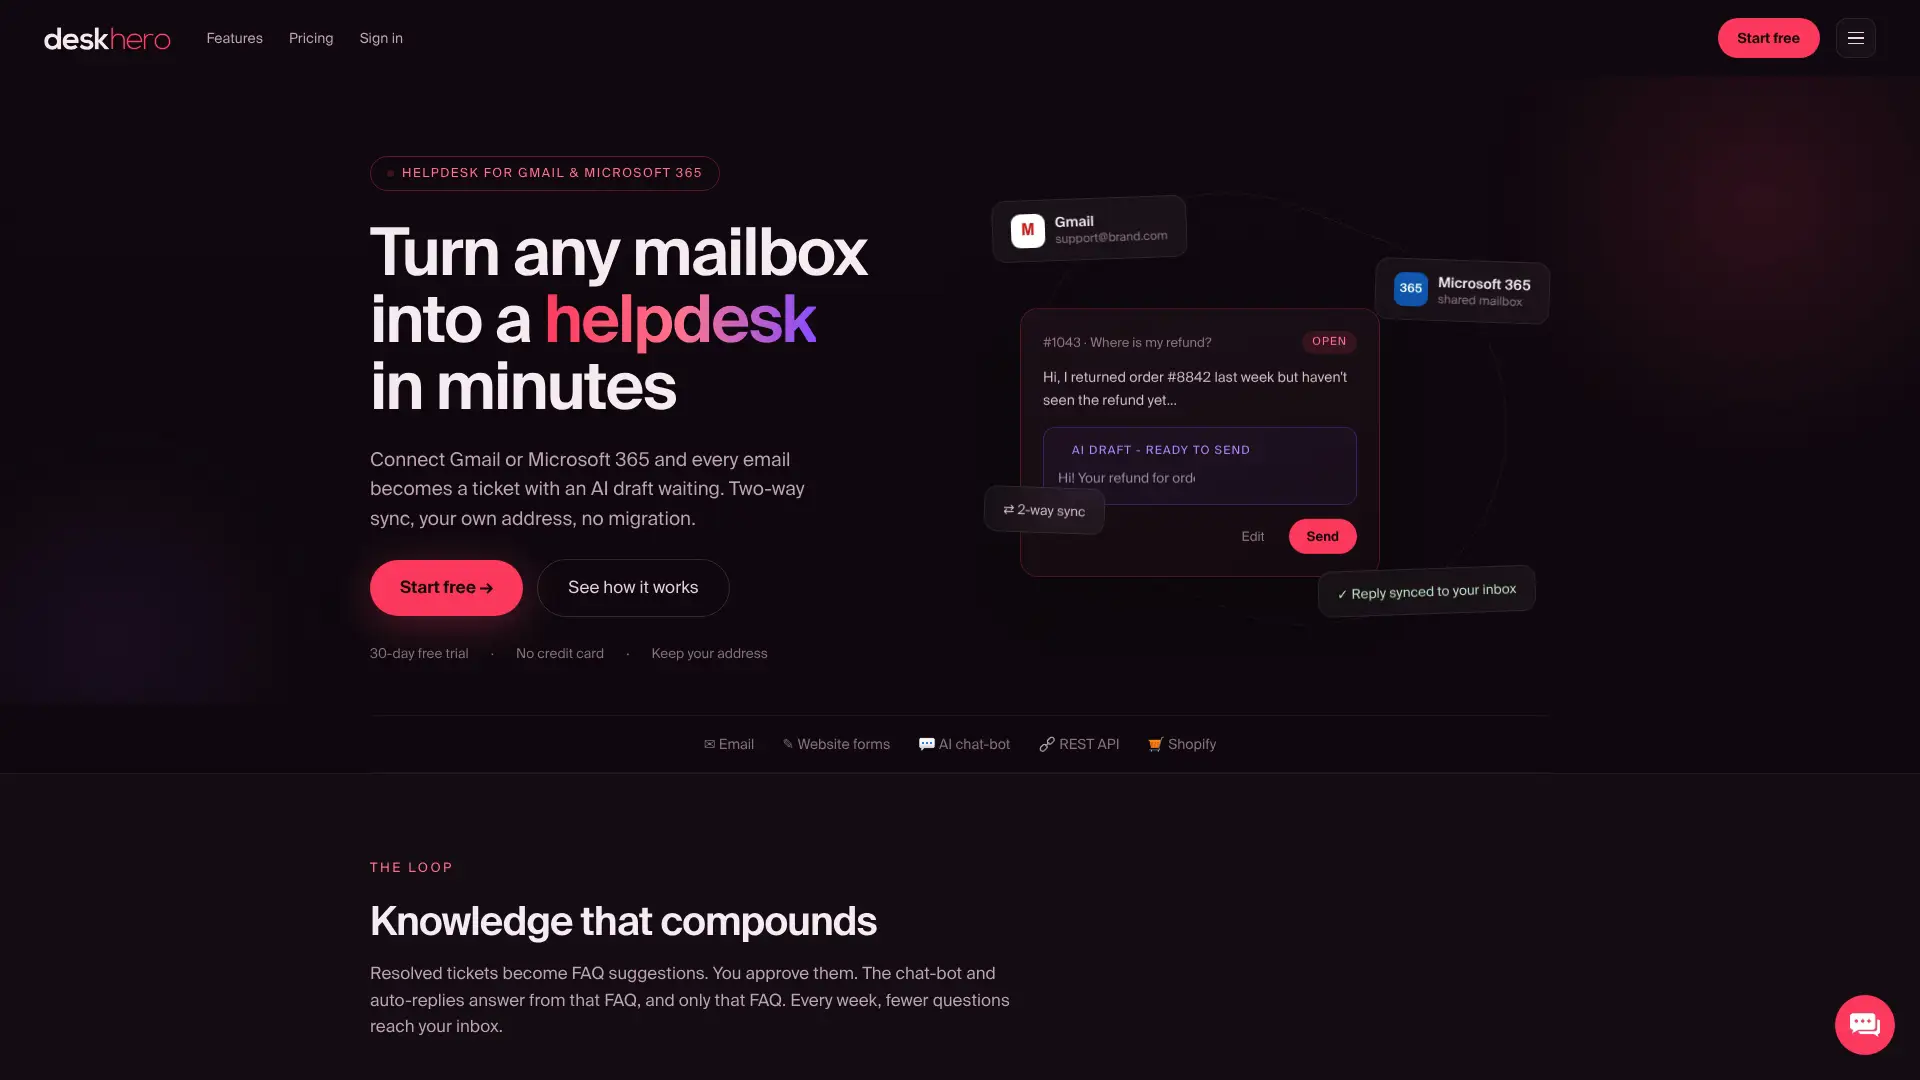
Houd classificatie, routering en het genereren van antwoorden als afzonderlijke besturingselementen. De voorgestelde antwoorden van Deskhero gebruiken kennis uit de workspace en blijven beschikbaar zodat een Gebruiker ze kan accepteren, bewerken of negeren. De automatische AI-antwoorden en chatbot gebruiken uitsluitend goedgekeurde openbare FAQ-items, en voor activering van de chatbot zijn minimaal 100 goedgekeurde FAQ-items vereist. Deskhero biedt een gratis proefperiode van 30 dagen waarvoor geen creditcard nodig is.
Bronnen
De volgende bronnen bieden een onderzoeksvergelijking, een werkende referentie-implementatie en definities van de belangrijkste evaluatiemetrieken:
- Vergelijkende studie van machinelearning- en deep-learningalgoritmen voor classificatie van klantenservicetickets
- aiticketclassifier (GitHub)
- Wat zijn accuracy, precision, recall en F1-score?
Veelgestelde vragen
Wat is een AI-ticketsysteem?
Een AI-ticketsysteem is een helpdesk of verbonden dienst die machinelearning- of taalmodellen gebruikt voor taken zoals classificatie, prioritering, routering, het opstellen van antwoorden of geautomatiseerde antwoorden. De exacte mogelijkheden verschillen per product.
Wat zijn classificatiemodellen in AI?
Classificatiemodellen wijzen op basis van regels of patronen die uit gelabelde voorbeelden zijn geleerd een of meer vooraf gedefinieerde labels toe aan nieuwe invoer. In ticketing kan het label een categorie, prioriteit, taal of bestemmingsgroep zijn.
Wat is de AI-ticketmethode?
Er bestaat geen gestandaardiseerde "AI-ticketmethode". Een typische pipeline neemt tickettekst in, bereidt de invoer voor, voorspelt een label, valideert het resultaat aan de hand van regels en betrouwbaarheidscriteria en werkt vervolgens het ticket bij of plaatst het in een wachtrij.
Hoe classificeert AI supporttickets nauwkeurig?
Accuraatheid hangt af van consistente labels, representatieve voorbeelden, geschikte invoervelden en tests met apart gehouden tickets. Uit de vergelijkende studie uit 2025 bleek dat het combineren van de titel en beschrijving de resultaten in alle geteste scenario's verbeterde.
Kan een helpdesk zoals Deskhero ticketclassificatie uitvoeren zonder een data-scienceteam?
Deskhero kan AI-ondersteunde triage van nieuwe tickets uitvoeren via automatiseringsregels met AI-voorwaarden in gewone taal. Deze regels kunnen velden instellen zoals groep, prioriteit, toegewezen persoon, status en tags. Voor een afzonderlijk getrainde statistische classifier is een externe integratie nodig die de REST API van Deskhero pollt.