Classificação de Tickets com IA para Equipes de Suporte: Guia Prático
A classificação de tickets por IA lê os tickets de suporte recebidos e prevê rótulos como categoria, prioridade ou destino. Ela pode reduzir a triagem repetitiva, mas previsões incertas ainda precisam de revisão humana. Um piloto prático usa textos de tickets representativos, um conjunto de rótulos claramente definido e limites de confiança escolhidos com base nos resultados de validação. Pesquisas como um estudo comparativo de 2025 podem ajudar você a escolher uma linha de base, enquanto este guia introdutório sobre acurácia, precisão, revocação e pontuação F1 explica as principais métricas de avaliação.
Antes de comprometer seu orçamento com um modelo, confirme o básico:
- Você tem um conjunto representativo de tickets históricos com texto utilizável e rótulos confiáveis
- Sua taxonomia inicial é pequena o suficiente para que os revisores a apliquem de forma consistente
- Você pode enviar previsões de baixa confiança para uma fila de revisão humana
- Alguém da sua equipe é responsável pelo monitoramento e pelas correções após o lançamento
Principais conclusões
A classificação de tickets por IA funciona melhor quando combina exemplos rotulados, critérios de aceitação mensuráveis, limites de confiança e revisão humana, em vez de buscar a automação completa desde o primeiro dia.
| Ponto | Detalhes |
|---|---|
| Comece com um piloto limitado | Teste uma fila ou um pequeno conjunto de categorias antes de ampliar o escopo do classificador. |
| Associe o modelo à tarefa | O estudo de 2025 constatou que o aprendizado de máquina clássico igualou ou superou os modelos de aprendizado profundo testados em vários cenários de classificação de tickets. |
| Use limites de confiança | Encaminhe resultados incertos para revisão humana em vez de forçar um rótulo. |
| Monitore após o lançamento | Acompanhe os erros por classe e as mudanças na distribuição de confiança para detectar desvios. |
| Separe a classificação da geração de respostas | O roteamento de tickets e as respostas redigidas por IA resolvem problemas diferentes e devem ser avaliados de forma independente. |
Índice
- O que é a classificação de tickets por IA?
- Como um sistema de tickets com IA processa um ticket?
- Qual abordagem de modelo é adequada ao volume dos seus tickets?
- Como integrar um classificador ao seu fluxo de trabalho de tickets?
- Quais métricas comprovam que seu classificador está pronto?
- Como manter a precisão de um classificador após o lançamento?
- O que pode dar errado e como corrigir?
- Como é um piloto de classificação por IA de 4 semanas?
- Por que o Deskhero é adequado para equipes que testam a classificação por IA?
- Inicie um piloto sem esperar por uma migração
- Fontes
- Perguntas frequentes
O que é a classificação de tickets por IA?
A classificação de tickets por IA é a atribuição automática de rótulos predefinidos a tickets de suporte com base no texto e, em alguns sistemas, em metadados ou anexos selecionados. Esses rótulos podem alimentar regras de roteamento, filas de prioridade, relatórios ou próximas etapas sugeridas. O classificador reduz a triagem manual apenas para previsões que atendem aos seus critérios de aceitação. Ele não deve encaminhar silenciosamente tickets incertos para uma fila.
Os benefícios mais prováveis são uma triagem inicial mais rápida e rótulos mais consistentes, mas o tamanho da melhoria depende da sua taxonomia, dos dados de treinamento, do fluxo de trabalho e do tráfego. Meça os resultados em relação ao seu processo atual, em vez de confiar na acurácia anunciada pelo fornecedor.
Os usos comuns incluem separar solicitações de TI em categorias de acesso, hardware e software; organizar dúvidas de comércio eletrônico em faturamento, envio e devoluções; e atribuir tickets por idioma. A classificação também é diferente da geração de respostas. Por exemplo, uma central de suporte pode redigir uma resposta a partir de suas fontes de conhecimento enquanto uma regra ou um modelo separado gerencia o roteamento.
Como um sistema de tickets com IA processa um ticket?
Um classificador de tickets típico usa cinco etapas. Os detalhes variam conforme o modelo e a integração, mas essas etapas oferecem pontos de verificação úteis quando algo dá errado.
O fluxo, etapa por etapa:
- Ingestão. O sistema recebe o texto do ticket e os metadados relevantes da central de suporte.
- Pré-processamento. Ele remove marcações ou assinaturas irrelevantes e normaliza a entrada. Algumas implementações também extraem texto de anexos compatíveis.
- Extração de características. Um modelo clássico pode usar vetores TF-IDF, enquanto um modelo neural pode usar embeddings ou tokens.
- Inferência do modelo. O classificador prevê um ou mais rótulos e, quando disponível, uma pontuação de confiança.
- Pós-processamento e roteamento. As regras aceitam, rejeitam ou encaminham a previsão para revisão antes de atualizar o ticket.
Tickets multilíngues podem ser traduzidos antes da classificação ou processados por um modelo multilíngue. Teste as duas abordagens com sua própria combinação de idiomas, pois a tradução pode alterar termos importantes. O projeto aiticketclassifier, de código aberto, mostra um fluxo de classificação TF-IDF com previsões de categoria, pontuações de confiança, um painel, recomendações e alertas do Slack. O processamento em tempo real é adequado a fluxos nos quais o rótulo precisa afetar uma fila ativa. O processamento em lote é útil para preenchimentos retroativos e avaliações.
Qual abordagem de modelo é adequada ao volume dos seus tickets?
Há três níveis amplos a considerar. A escolha certa depende da ambiguidade dos seus rótulos, da quantidade e da qualidade dos seus dados, dos requisitos de latência e do custo operacional.
Sistemas baseados em regras e padrões associam palavras-chave, endereços, domínios ou expressões regulares a ações. Eles são rápidos e fáceis de explicar, mas um conjunto crescente de regras pode se tornar difícil de manter. Funcionam bem para casos restritos e de alta precisão, como endereços de cobrança ou códigos de produtos conhecidos.
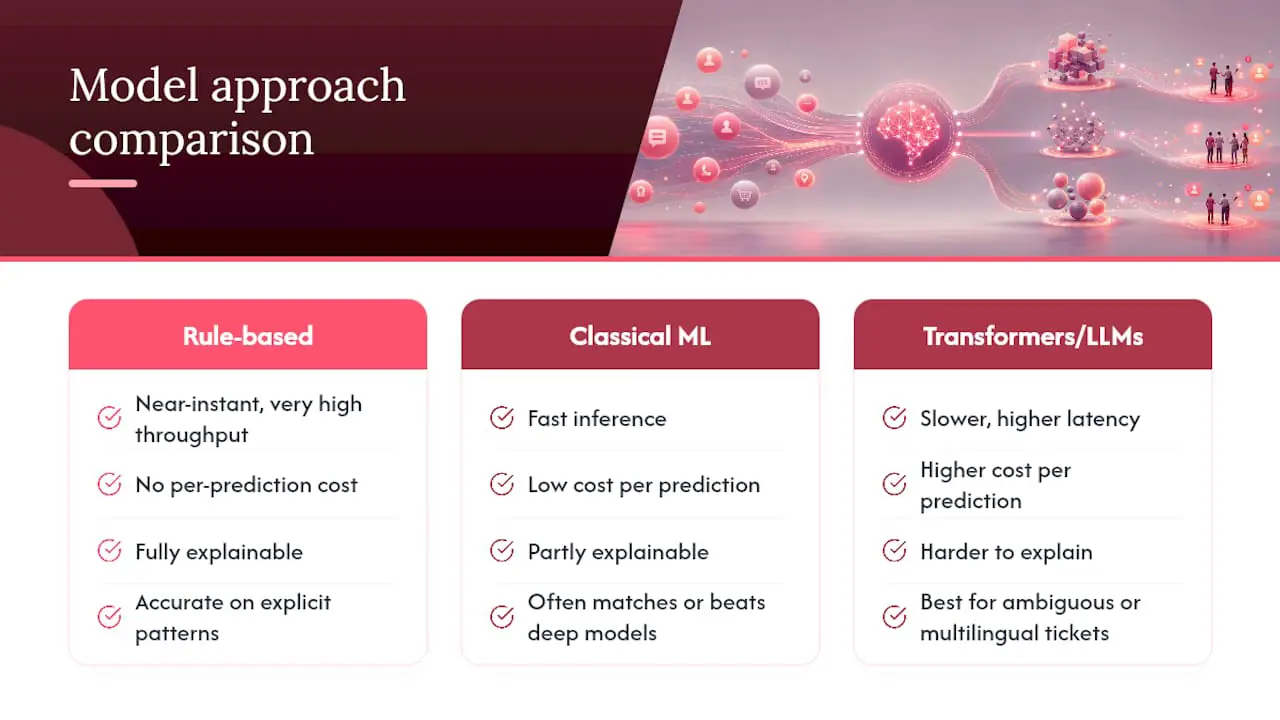
Os métodos de aprendizado de máquina clássico, como Regressão Logística, SVM e XGBoost, são treinados com exemplos rotulados. O estudo comparativo de 2025 avaliou oito algoritmos em conjuntos de dados públicos e empresariais. O estudo constatou que combinar o título e a descrição do ticket melhorou o desempenho em todos os cenários testados, e que os modelos clássicos igualaram ou superaram os modelos de aprendizado profundo testados em vários casos.
As abordagens com transformers e LLMs podem ser úteis quando os tickets são ambíguos, multilíngues ou dependem de um contexto mais amplo. Elas também podem aumentar o custo, a latência e a complexidade da avaliação. Compare-as com uma linha de base mais simples em vez de presumir que o modelo maior terá um desempenho melhor.
Dica profissional: Comece com a abordagem menos complexa que atenda aos seus critérios de aceitação. O estudo de 2025 relatou acurácia e F1 acima de 0,95 para a classificação de prioridade nos cenários testados, enquanto a classificação de categorias foi mais difícil em dados empresariais.
Como integrar um classificador ao seu fluxo de trabalho de tickets?
A integração é bem-sucedida quando cada previsão tem uma ação clara e reversível. Siga estas etapas na ordem:
- Audite seus dados. Selecione um período representativo e verifique com que consistência os tickets foram rotulados.
- Crie sua taxonomia. Comece com categorias que os revisores consigam distinguir de forma confiável.
- Rotule um conjunto de dados inicial. Use especialistas de suporte que conheçam a fila e registre as divergências.
- Crie uma linha de base. Compare um conjunto simples de regras ou um modelo clássico com seu processo manual atual.
- Teste a integração completa. Confirme como as previsões, os erros, as novas tentativas e as atualizações de campos se comportam em um ambiente de testes.
- Faça a implementação em fases. Comece com uma fila ou um pequeno grupo de rótulos de alta confiança.
Um classificador externo normalmente lê novos tickets por meio do método de integração compatível com a central de suporte e grava o rótulo aceito de volta em campos como grupo, prioridade ou tags. Verifique se a central de suporte é compatível com eventos de saída ou se exige consulta periódica. A API REST do Deskhero permite listar e atualizar tickets, mas não oferece webhooks de saída; portanto, um classificador externo precisa consultar a API periodicamente. Para configurar a caixa de entrada e criar tickets, consulte o fluxo de e-mail para ticket do Deskhero.
Quais métricas comprovam que seu classificador está pronto?
Quatro medidas são especialmente úteis: precisão (quantos rótulos previstos estavam corretos), revocação (quantas instâncias verdadeiras foram encontradas), F1 (a média harmônica entre precisão e revocação) e calibração da confiança (se as probabilidades previstas correspondem aos resultados observados).
Para problemas multiclasses, examine tanto a F1 média macro, que atribui o mesmo peso a todas as classes, quanto a F1 média micro, que é dominada pelas classes de maior volume. Inspecione também uma matriz de confusão e a precisão e a revocação por classe. Uma única pontuação agregada pode esconder erros graves em categorias raras, mas importantes.
Avalie usando um conjunto separado de tickets reais que reflita o tráfego de produção. Defina os critérios de aceitação com base no custo de cada erro. Um rótulo urgente incorreto desperdiça capacidade, enquanto um ticket urgente não identificado pode violar um SLA.
Dica profissional: Um limite de confiança é uma regra de decisão, não uma porcentagem universal. Escolha-o com base nos dados de validação e encaminhe as previsões abaixo dele para revisão humana.
Como manter a precisão de um classificador após o lançamento?
A implementação não é a linha de chegada. Acompanhe o volume de previsões por categoria, os erros por classe, a distribuição de confiança, o volume da fila de revisão e o impacto operacional dos tickets roteados incorretamente.
- Reúna as correções como feedback rotulado e revise-as quanto à consistência
- Execute novas versões do modelo em modo sombra antes que elas possam alterar tickets
- Implemente as atualizações fila por fila e mantenha um caminho para reversão
- Mantenha a revisão humana para previsões abaixo do limite selecionado
A frequência de retreinamento deve seguir os desvios observados, não um calendário arbitrário. O lançamento de um produto, uma mudança na taxonomia ou um novo segmento de clientes pode justificar um retreinamento antecipado. O guia de painéis de suporte ao cliente do Deskhero oferece uma estrutura mais ampla para selecionar métricas de suporte, mas as medições específicas do classificador ainda precisam de seu próprio monitoramento.
O que pode dar errado e como corrigir?
Rótulos inconsistentes são um modo comum de falha. Se os especialistas de suporte atribuem categorias diferentes a tickets semelhantes, o modelo aprende essa divergência. Escreva diretrizes de rotulagem, revise exemplos controversos e meça a concordância antes de ampliar a escala. O desequilíbrio entre classes cria outro risco, pois uma pontuação agregada pode parecer forte enquanto uma categoria de baixo volume apresenta desempenho ruim. Use métricas por classe e reúna mais exemplos representativos quando necessário.
Tickets ambíguos precisam de um fallback explícito. Envie previsões incertas para uma fila de revisão, mantenha a saída original do modelo para análise e faça com que as correções alimentem o próximo conjunto de avaliação. Para sistemas baseados em LLMs, valide se a saída é um dos rótulos permitidos antes que qualquer ação do fluxo de trabalho seja executada.
A privacidade merece uma consideração própria. Não envie tickets que contenham dados pessoais para um modelo de terceiros, a menos que seus requisitos legais e de segurança sejam atendidos, incluindo um acordo adequado de processamento de dados quando necessário.
Dica profissional: Minimize os campos enviados ao classificador. Se o modelo precisa apenas de um assunto e de uma mensagem, não inclua dados do cliente que não tenham relação.
Como é um piloto de classificação por IA de 4 semanas?
Um cronograma de quatro semanas pode funcionar como modelo de planejamento, embora a quantidade de dados e o tempo de revisão devam determinar o ritmo real:
- Semana 0, definição do escopo. Selecione uma fila, defina a taxonomia, escolha as métricas de base e documente os erros inaceitáveis.
- Semana 1, rotulagem e linha de base. Rotule uma amostra representativa, resolva as divergências e treine ou configure a linha de base viável mais simples.
- Semana 2, integração e testes em modo sombra. Execute previsões em tickets ativos sem alterar seus campos.
- Semanas 3 a 4, implementação limitada e avaliação. Ative ações apenas para casos de alta confiança validados e, em seguida, meça a qualidade do modelo, a carga da fila de revisão, as correções de roteamento e os resultados do suporte.
Não trate quatro semanas como uma garantia. Estenda os testes em modo sombra se faltarem categorias raras, se a qualidade dos rótulos for inconsistente ou se a integração não puder falhar com segurança.
Por que o Deskhero é adequado para equipes que testam a classificação por IA?
O Deskhero transforma uma caixa de entrada do Gmail, do Google Workspace ou do Microsoft 365 em uma central de suporte sem alterar o endereço de e-mail usado pelos clientes. Novos tickets também podem chegar por meio de formulários incorporados e do chatbot de IA. Isso oferece ao piloto um registro de ticket consistente, enquanto os usuários continuam trabalhando em uma caixa de entrada compartilhada.
As automações de novos tickets do Deskhero podem avaliar condições de IA em linguagem simples e definir o responsável, o grupo, o status, a prioridade, as tags ou os campos suspensos. Isso permite uma triagem prática assistida por IA sem criar um modelo personalizado. Para um classificador separado, a API REST pode listar e atualizar tickets, mas a integração precisa consultar a API periodicamente porque o Deskhero não possui webhooks de saída. As respostas sugeridas por IA são um recurso separado, baseado no conhecimento do workspace, enquanto as respostas automáticas de IA voltadas ao cliente e o chatbot respondem apenas a partir da FAQ pública aprovada. O Deskhero também é compatível com tickets multilíngues.
Notas de implementação
Mantenha a primeira taxonomia restrita, registre cada correção e diferencie a avaliação do modelo da avaliação do fluxo de trabalho. Um classificador pode ter uma pontuação F1 forte e ainda assim criar problemas operacionais se atribuir o grupo errado ou substituir um campo de que os usuários precisam. Comece com previsões em modo sombra e depois habilite ações reversíveis para os casos mais claros.
Inicie um piloto sem esperar por uma migração
O Deskhero pode se conectar a uma caixa de entrada existente do Gmail, do Google Workspace ou do Microsoft 365, incluindo caixas de entrada compartilhadas da Microsoft. Primeiro, você pode testar as automações integradas de novos tickets, que definem campos de roteamento a partir de condições explícitas ou de uma condição avaliada por IA. Se precisar de um classificador treinado separadamente, use a API REST para consultar tickets periodicamente e atualizar os rótulos aceitos.
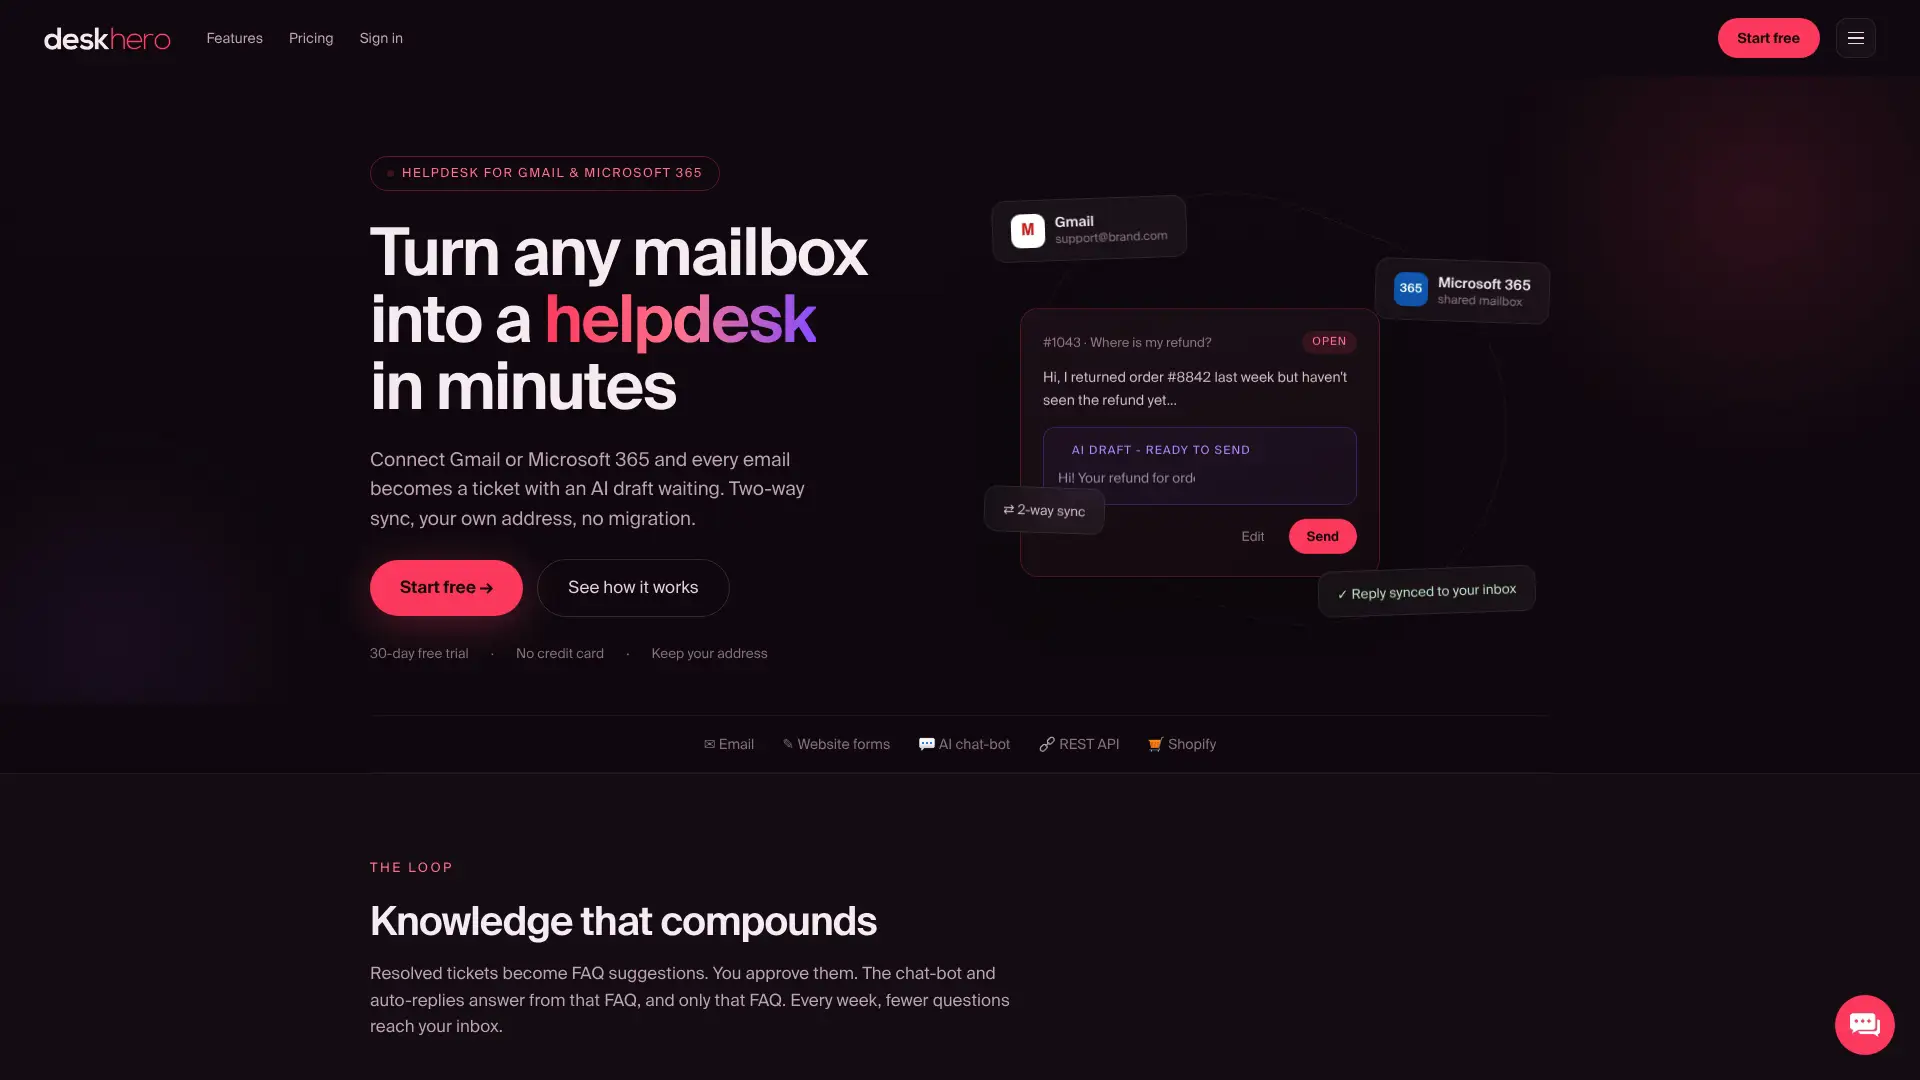
Mantenha a classificação, o roteamento e a geração de respostas como controles separados. As respostas sugeridas do Deskhero usam o conhecimento do workspace e continuam disponíveis para que um usuário as aceite, edite ou descarte. As respostas automáticas de IA e o chatbot usam apenas itens aprovados da FAQ pública, e o chatbot exige pelo menos 100 entradas de FAQ aprovadas antes da ativação. O Deskhero oferece um teste gratuito de 30 dias sem necessidade de cartão de crédito.
Fontes
Os recursos a seguir oferecem uma comparação de pesquisas, uma implementação de referência funcional e definições para as principais métricas de avaliação:
- Estudo comparativo de algoritmos de aprendizado de máquina e aprendizado profundo para classificação de tickets de suporte ao cliente
- aiticketclassifier (GitHub)
- O que são acurácia, precisão, revocação e pontuação F1?
Perguntas frequentes
O que é um sistema de tickets com IA?
Um sistema de tickets com IA é uma central de suporte ou um serviço conectado que usa aprendizado de máquina ou modelos de linguagem para tarefas como classificação, definição de prioridade, roteamento, redação de respostas ou respostas automatizadas. Os recursos exatos variam conforme o produto.
O que são modelos de classificação em IA?
Os modelos de classificação atribuem um ou mais rótulos predefinidos a uma nova entrada com base em regras ou padrões aprendidos a partir de exemplos rotulados. Em sistemas de tickets, o rótulo pode ser uma categoria, prioridade, idioma ou grupo de destino.
O que é o método de ticket por IA?
Não existe um “método de ticket por IA” padronizado. Um fluxo típico ingere o texto do ticket, prepara a entrada, prevê um rótulo, valida o resultado de acordo com regras e critérios de confiança e, em seguida, atualiza ou coloca o ticket em uma fila.
Como a IA classifica tickets de suporte com precisão?
A precisão depende de rótulos consistentes, exemplos representativos, campos de entrada adequados e testes com tickets separados. O estudo comparativo de 2025 constatou que combinar o título e a descrição melhorou os resultados em todos os cenários testados.
Uma central de suporte como o Deskhero consegue lidar com a classificação de tickets sem uma equipe de ciência de dados?
O Deskhero pode realizar a triagem assistida por IA de novos tickets por meio de regras de automação com condições de IA em linguagem simples. Essas regras podem definir campos como grupo, prioridade, responsável, status e tags. Um classificador estatístico treinado separadamente exige uma integração externa que consulte periodicamente a API REST do Deskhero.